
TL;DR
DeepSeek V4.1 Pro è un futuro successore di V4 Pro menzionato come riferimento, senza una data di rilascio stabilita dalle fonti ufficiali esaminate al 14 ottobre 2026. L’annuncio del 10 settembre su Flash fornisce l’indizio più chiaro sul rilascio. Le specifiche e le valutazioni disponibili di Flash aiutano gli sviluppatori a prepararsi, ma non definiscono le capacità della versione Pro. DeepSeek ha chiarito che V4 Pro rimane disponibile in risposta alla domanda degli utenti. Le cifre dei benchmark sottostanti descrivono il rilascio originale di Flash, non l’aggiornamento Flash-1017 del 17 ottobre; le integrazioni dovrebbero verificare le versioni modello specifiche del provider prima della distribuzione.
Punti chiave
- Stato del rilascio: V4.1 Pro è stato menzionato ufficialmente, ma non è stata confermata alcuna data specifica di lancio.
- Indizio più importante: L’annuncio di V4.1 Flash ha collegato un futuro V4.1 Pro a un piano di transizione dell’API.
- Stato dell’API: DeepSeek ha confermato la continuazione del servizio V4 Pro con tariffazione invariata in risposta alla domanda degli utenti; il precedente piano di reindirizzare le richieste Pro verso Flash è superato.
- Fondamento tecnico: V4.1 Flash rivela un backbone da 552B parametri, elaborazione asimmetrica e un contesto da 1M token.
- Preparazione: Eseguire benchmark sui modelli esistenti e mantenere configurabili gli identificatori di modello dell’API.
Quando verrà rilasciato DeepSeek V4.1 Pro?
Al 14 ottobre 2026, le fonti ufficiali esaminate per questo articolo non stabiliscono una data di rilascio per DeepSeek V4.1 Pro. Il suo nome compare nelle comunicazioni di prodotto di DeepSeek, ma un riferimento a un prodotto futuro non è un calendario di lancio.
Il 10 settembre 2026, DeepSeek ha presentato V4.1 Flash come il membro più piccolo di una nuova famiglia architetturale. Il suo annuncio ufficiale di lancio descriveva un piano iniziale per reindirizzare l’API del vecchio V4 Pro a V4.1 Flash fino al futuro rilascio di V4.1 Pro. La dichiarazione lega il successore a una politica di migrazione concreta, ma non stabilisce una data di lancio, lo stato dell’addestramento o specifiche finali.
Timeline di rilascio di DeepSeek V4.1 Pro
| Data | Sviluppo | Implicazione |
|---|---|---|
| 24 aprile 2026 | Rilascio della famiglia V4 preview | Baseline della generazione precedente |
| 13 agosto 2026 | Aggiornamento V4 Pro a disponibilità GA | Baseline del flagship conosciuta |
| 10 settembre 2026 | Annuncio V4.1 Flash; riferimento a V4.1 Pro | Nuova famiglia architetturale introdotta, con un futuro successore Pro menzionato ma senza data di rilascio confermata |
| 14 settembre 2026 | Target di migrazione per l’originario V4 Pro | Successivamente rivisto |
| Rilascio V4.1 Pro | Nessuna data annunciata | Tempistiche non confermate |
L’archivio notizie ufficiale data il rilascio della V4 preview al 24 aprile e il rilascio generale di V4 Pro al 13 agosto. La data di settembre era un target di transizione del servizio, non una data di rilascio di V4.1 Pro.
L’annuncio di settembre proponeva di reindirizzare le richieste V4 Pro a Flash a partire dal 14 settembre fino a un futuro rilascio Pro. Tuttavia, la documentazione API corrente elenca V4 Pro come un modello separato con proprie tariffe. DeepSeek ha successivamente chiarito nella voce di changelog ufficiale del 10 settembre che avrebbe continuato a fornire il servizio API V4 Pro dopo il 14 settembre in risposta alla domanda degli utenti, con la fatturazione invariata. Il precedente proposito di reindirizzamento va quindi considerato un piano superato, non la politica attuale di instradamento di V4 Pro. La tabella modelli corrente elenca deepseek-v4-pro come V4-Pro-0813 e deepseek-flash come V4.1-Flash-1017; verificare il mapping dei modelli specifico di ciascun provider prima della distribuzione.
Una conferma futura dovrebbe arrivare da un annuncio dedicato di DeepSeek, da un identificatore API supportato e da valutazioni e prezzi pubblicati per la versione Pro.
Cosa ha confermato ufficialmente DeepSeek su V4.1 Pro?
Informazioni confermate
Distinguere tra dichiarazioni ufficiali e speculazioni tecniche è essenziale prima del lancio. Le informazioni divulgate su V4.1 Flash forniscono prove sostanziali sulla famiglia architetturale, ma non diventano automaticamente specifiche di V4.1 Pro.
DeepSeek ha menzionato V4.1 Pro come un futuro membro della famiglia V4.1, ma le fonti esaminate non ne stabiliscono la data di rilascio, l’identificatore di modello pubblico, il numero di parametri, la finestra di contesto, il supporto visivo, i controlli del ragionamento, i risultati dei benchmark o il prezzo dell’API. Le specifiche disponibili di V4.1 Flash forniscono contesto per la famiglia architetturale, non specifiche confermate di V4.1 Pro.
DeepSeek descrive V4.1 Flash come il membro più piccolo di una nuova famiglia progettata per scalare. Questo supporta un’architettura futura più grande ma non prova che V4.1 Pro sarà semplicemente una copia più ampia. Addestramento, budget di parametri attivi, schemi di attenzione e metodi di post-training restano non confermati.
Report della community / Leak
In un post su X del 27 settembre 2026, @NFT_Chen ha affermato che DeepSeek V4.1 Pro fosse comparso nei test interni con accesso anticipato limitato per account.
Il post di @NFT_Chen è un report della community non verificato, non un annuncio ufficiale di DeepSeek. Lo screenshot mostra visibilmente il nome V4.1 Pro, un’etichetta di Early access e diversi campi di configurazione, ma non stabilisce l’origine dello screenshot, l’ambiente di distribuzione, il collegamento a un modello live, la disponibilità dell’API pubblica o le specifiche finali del prodotto. Consideratelo un indizio da verificare ulteriormente, non una prova di un rilascio confermato.
Lo screenshot di configurazione allegato mostra il nome DeepSeek V4.1 Pro, un tagline Early access, high reasoning effort e flag per l’uso dei dati di training, accesso non premium e assenza di supporto multimodale. Contiene inoltre un identificatore FREEBUFF_AI_TRAINING_NOTICE.
Se autentico e collegato a un’integrazione attiva, la voce potrebbe essere un indizio di accesso anticipato. Un flag di disponibilità non è una garanzia di servizio e la previsione di lancio imminente dell’autore non è una finestra di rilascio confermata. Considerate lo screenshot come un indizio per ulteriori verifiche, non come una specifica della versione Pro.
Cosa si sa di DeepSeek V4.1 Pro?
V4.1 Flash offre il fondamento tecnico più chiaro per la famiglia in arrivo. V4.1 Flash utilizza un’architettura Encoder-Decoder causale con percorsi di calcolo differenti per prefill e decoding.
Secondo la scheda tecnica del modello, il modello rilasciato contiene 40 layer Transformer suddivisi tra un encoder a 20 layer e un decoder a 20 layer.
| Specifica | DeepSeek V4 Pro | V4.1 Flash | V4.1 Pro |
|---|---|---|---|
| Parametri del backbone | 1.6T | 552B | Non annunciato |
| Parametri attivati | 49B | 8B input / 16B output | Non annunciato |
| Architettura | MoE | Encoder-Decoder causale MoE | Non annunciato |
| Finestra di contesto | 1M | 1M | Non annunciato |
| Output massimo | 384K | 384K | Non annunciato |
| Input immagine nativo | Non nella configurazione elencata | Supportato | Non annunciato |
| Impronta cache KV | Non direttamente comparabile | ~890 byte/token | Non annunciato |
| Controllo del ragionamento | Basso / alto / max | Continuo 1–100 | Non annunciato |
| Disponibilità | API | API e pesi aperti | Non annunciata |
Sebbene V4.1 Flash contenga 552B di parametri nel backbone, solo circa 8B parametri sono attivati per token in input e 16B durante l’output.
Potenziale di scaling dell’Encoder-Decoder causale
La separazione tra prefill e decoding può rendere possibile, per i futuri membri della famiglia, aumentare la capacità di rappresentazione gestendo al contempo i costi di inferenza. V4.1 Flash presenta inoltre Compressed Sparse Attention 2 e cache KV in FP4. Resta sconosciuto se e come V4.1 Pro erediterà queste caratteristiche.
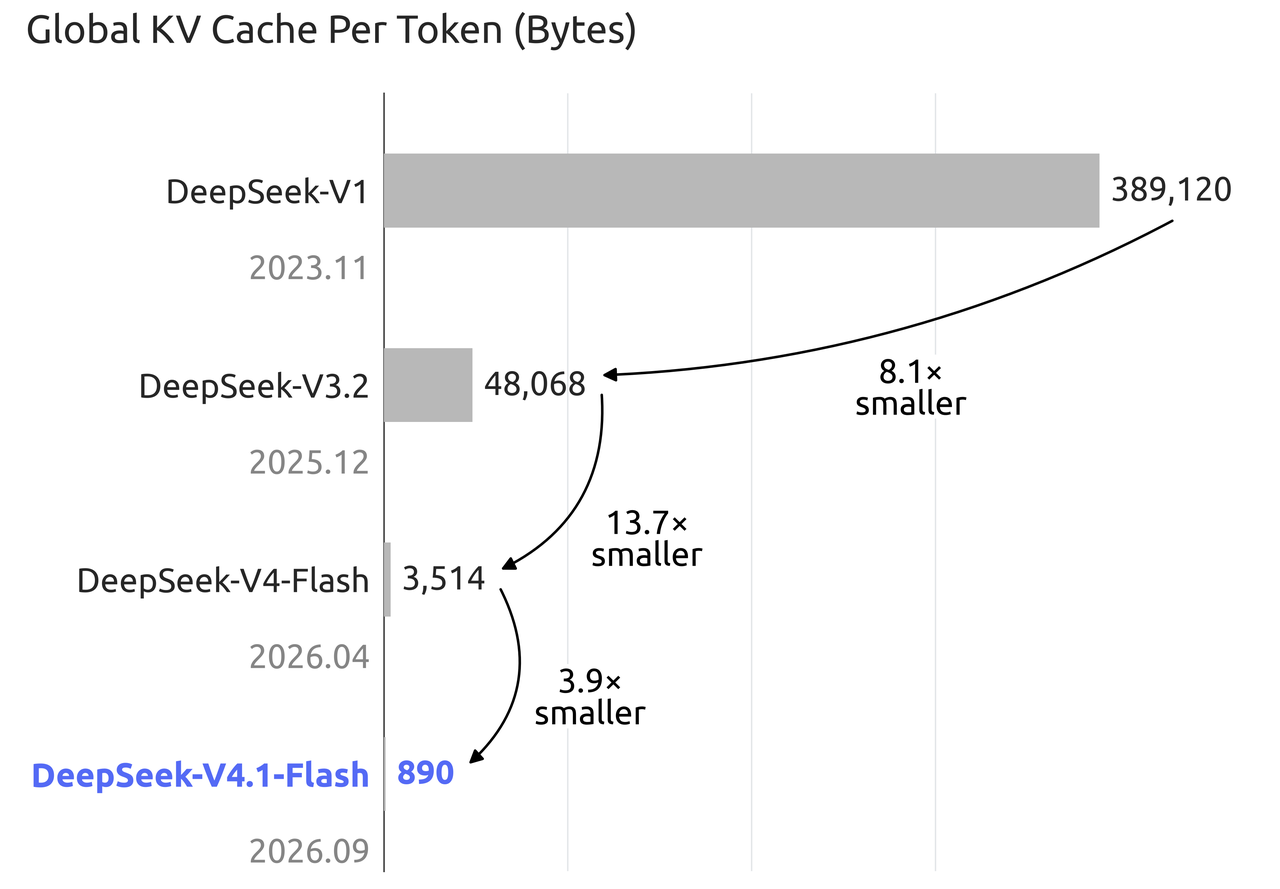
DeepSeek riporta un’impronta globale della cache KV di circa 890 byte per token per V4.1 Flash, rispetto a 3.514 byte per V4 Flash. Questa è una comparazione della cache KV globale, non una misura della memoria totale di serving.
I due grafici originali riprodotti in questo articolo sono pubblicati nella scheda modello ufficiale di DeepSeek; nessuno dei due è un risultato di V4.1 Pro.
DeepSeek V4.1 Pro vs V4 Pro vs V4.1 Flash
Un punto di partenza utile è la differenza osservata tra i modelli esistenti, non un benchmark Pro inventato. La tabella seguente confronta il modello V4 Pro 0813 rilasciato con il rilascio iniziale di V4.1 Flash di settembre.
Confronto benchmark DeepSeek
| Benchmark (metrica) | V4 Pro 0813 | V4.1 Flash | Flash − Pro (punti percentuali) |
|---|---|---|---|
| GPQA Diamond (Pass@1) | 92.4 | 90.9 | −1.5 |
| HLE, solo testo (Pass@1) | 42.7 | 39.1 | −3.6 |
| Terminal-Bench 2.1 (Pass@1) | 87.9 | 90.6 | +2.7 |
| Terminal-Bench 3.0 (Pass@1) | 11.8 | 30.0 | +18.2 |
| DeepSWE v1.1 (Resolved) | 62.7 | 74.2 | +11.5 |
| CyberGym (Pass@1) | 83.3 | 88.1 | +4.8 |
| HLE con strumenti (Pass@1) | 60.0 | 63.9 | +3.9 |
| Agents’ Last Exam (Pass@1) | 25.7 | 31.8 | +6.1 |
Nota di versione (19 ottobre 2026):
Non sono risultati di V4.1-Flash-1017. L’
di DeepSeek conferma che il suo sito, la sua app e l’API sono passati a Flash-1017. La tabella è mantenuta come confronto storico con V4 Pro 0813. Non interpretare le differenze di punteggio come un confronto con l’ultima versione di Flash; rieseguire valutazioni allineate prima di decidere la selezione del modello corrente.
La tabella ufficiale di valutazione dei modelli instruct è la fonte dei risultati di benchmark riportati dal vendor sopra. Per un confronto coerente, i punteggi HLE sono basati sul sottoinsieme solo testo per entrambi i modelli. Tutte le differenze di punteggio sono espresse in punti percentuali anziché in incrementi percentuali relativi.
Condizioni e limiti dei benchmark
Le valutazioni instruct di Flash usano reasoning_effort=100, temperature=1.0 e top_p=0.95. Terminal-Bench utilizza DeepSeek Harness Minimal con un contesto da 1M token; DeepSWE v1.1 utilizza mini-SWE. Queste impostazioni descrivono le esecuzioni di Flash riportate e non devono essere considerate valide automaticamente per riprodurre la configurazione di ogni modello a confronto.
Lo studio cross-scaffold di accompagnamento specifica container Linux, max_steps=500, otto campioni per task per DeepSWE e tre per Terminal-Bench 2.1, senza accesso di rete per quest’ultimo. Questi dettagli appartengono a quello studio, non automaticamente a ogni riga della tabella principale. La scheda modello non fornisce una configurazione hardware condivisa per tutti i punteggi elencati; qui non viene avanzata alcuna pretesa di throughput normalizzato sull’hardware.
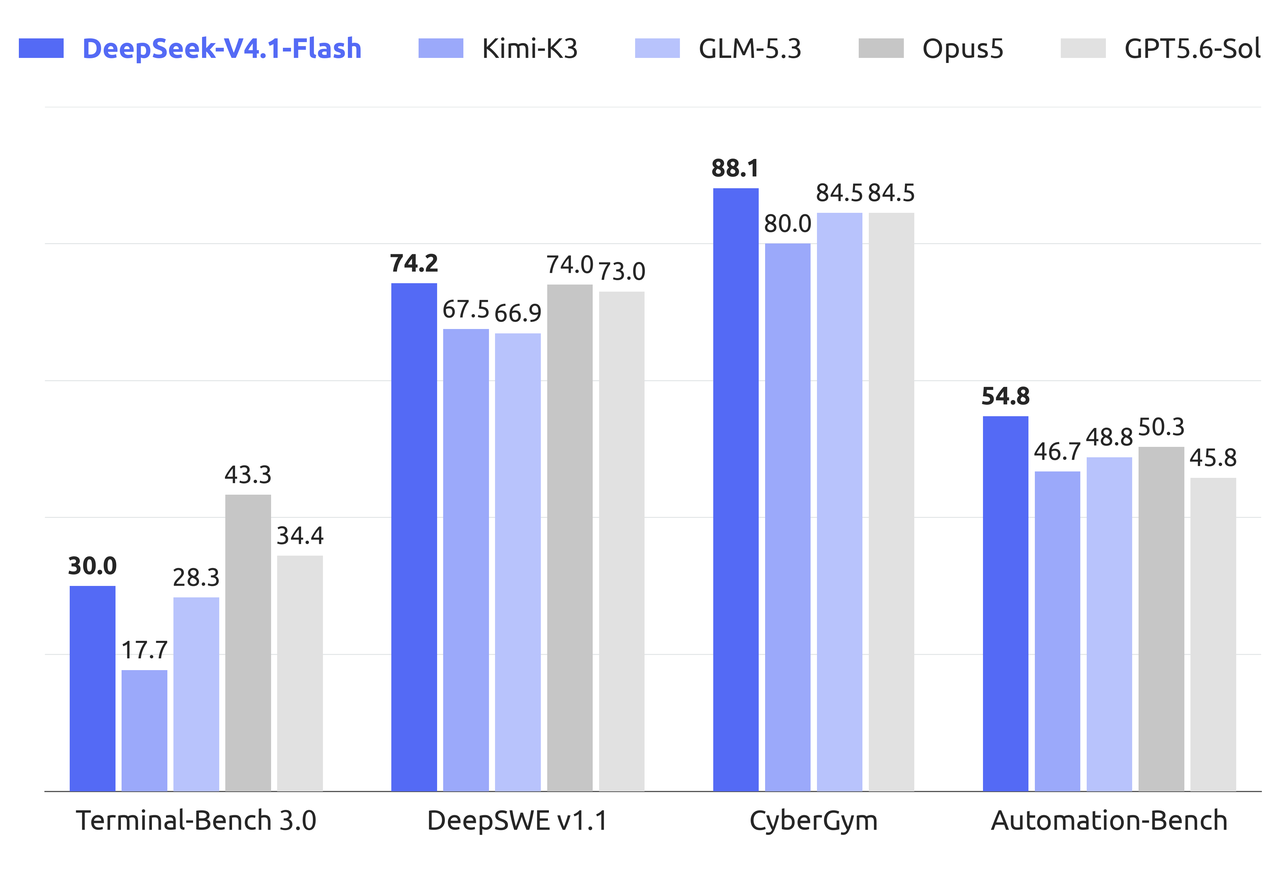
Il grafico originale delle prestazioni agentiche di DeepSeek confronta Flash con modelli frontier selezionati. Il valore di 17.7 per Terminal-Bench 3.0 appartiene a Kimi K3, non a V4 Pro. La tabella sopra fornisce il confronto separato con V4 Pro.
Questo confronto storico mostra perché un modello più piccolo non deve necessariamente essere peggiore in ogni task. Rispetto al rilascio originale di Flash di settembre, V4 Pro primeggiava in alcuni test di ragionamento mentre Flash guidava diversi benchmark di terminale, coding e strumenti. Queste classifiche non devono essere trasferite a Flash-1017 senza test aggiornati e comparabili.
Quanto potrebbe costare DeepSeek V4.1 Pro?
DeepSeek non ha annunciato il prezzo di V4.1 Pro. I prezzi attuali di prima parte forniscono un riferimento, non una previsione. Le tariffe distinguono tra periodi di punta e non, input con cache-hit e cache-miss e output generato.
Le seguenti cifre provengono dalla documentazione dei prezzi di DeepSeek; le tariffe possono cambiare.
Prezzi e limiti verificati al 14 ottobre 2026. I periodi di punta sono 01:00–04:00 e 06:00–10:00 UTC, da lunedì a venerdì, escluse le festività pubbliche cinesi. Tutti gli altri orari sono non di punta. Queste sono tariffe di prima parte DeepSeek, non un preventivo CometAPI; la fatturazione specifica del provider deve essere verificata separatamente.
| Prezzo per 1M token | Flash non di punta | Flash di punta | V4 Pro non di punta | V4 Pro di punta |
|---|---|---|---|---|
| Input cache-hit | $0.003 | $0.006 | $0.022 | $0.044 |
| Input cache-miss | $0.15 | $0.30 | $0.66 | $1.32 |
| Output | $0.60 | $1.20 | $1.98 | $3.96 |
Nello snapshot di prezzi e limiti del 14 ottobre, sia V4.1 Flash che V4 Pro supportano una finestra di contesto da 1M token. La concorrenza elencata è 2.500 per Flash e 500 per V4 Pro, con gli stessi limiti mostrati per i periodi di punta e non. Questi sono limiti di prima parte; confermare i limiti del provider scelto prima della distribuzione.
Ai tassi pubblicati non di punta, l’input non in cache di Flash costa circa il 77% in meno rispetto a V4 Pro e l’output generato circa il 70% in meno. Il prezzo inferiore può essere particolarmente rilevante per azioni agent ripetute e workflow ricchi di documenti.
Compromessi tra qualità e costo per V4.1 Pro
A scopo illustrativo, un modello che costa $0.01 per tentativo con un tasso di successo del 60% ha un costo API atteso di $0.0167 per task riuscita, mentre un modello da $0.03 con un tasso di successo del 95% costa circa $0.0316. Queste cifre non sono prestazioni misurate di DeepSeek; assumono tentativi indipendenti con probabilità di successo costante. Il modello a maggior successo può comunque essere preferibile se riduce revisione, rifacimenti o altri costi aziendali.
Come dovrebbero prepararsi gli sviluppatori per l’API DeepSeek V4.1 Pro?
Gli sviluppatori possono validare interfacce compatibili esistenti, modelli correnti e protocolli di test riutilizzabili senza assumere un identificatore V4.1 Pro. La chiave è separare la scelta del modello dalla logica applicativa.
Iniziare con un modello DeepSeek disponibile
Gli sviluppatori possono accedere alla API DeepSeek V4 Pro in CometAPI e alla API DeepSeek V4.1 Flash in CometAPI per costruire una baseline corrente. L’esempio utilizza l’identificatore di CometAPI deepseek-v4.1-flash. L’API di DeepSeek utilizza deepseek-flash; gli identificatori e le chiavi sono specifici del provider e non vanno interscambiati.
Installare il pacchetto openai e impostare COMETAPI_KEY prima di eseguire. Questo è un esempio minimo di integrazione; validatelo nel vostro account prima dell’uso in produzione.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

model = os.getenv("DEEPSEEK_MODEL", "deepseek-v4.1-flash")

response = client.chat.completions.create(
    model=model,
    messages=[
        {"role": "system", "content": "You are a careful coding assistant."},
        {"role": "user", "content": "Explain how to optimize Python API latency."}
    ]
)

print(response.choices[0].message.content)
L’identificatore del modello in questo esempio si riferisce a Flash, non a una variante Pro non annunciata. Un futuro identificatore di modello ufficiale può essere sostituito solo dopo che sarà confermato e testato.
Costruire una suite di valutazione DeepSeek ripetibile
| Area di test | Attività suggerita | Metrica primaria |
|---|---|---|
| Ragionamento | Domande scientifiche verificate | Accuratezza |
| Coding | Modifiche a repository multi-file | Test superati |
| Agent | Ricerca assistita da strumenti | Tasso di completamento |
| Output strutturato | JSON vincolato da schema | Validità |
| Lungo contesto | Recupero documenti | Recall |
| Visione | Comprensione di grafici/documenti | Accuratezza di estrazione |
| Latenza | Richieste ripetute controllate | P50 / P95 |
| Costo | Valutazione del workflow completo | Costo per successo |
Usare i risultati dei modelli esistenti per scegliere una baseline, non per prevedere le prestazioni di V4.1 Pro. Le evidenze di benchmark sopra sono precedenti a Flash-1017. Per i workflow di terminale e strumenti, testare anche completamenti a lungo orizzonte e chiamate strumentali ridondanti; misurare la latenza sotto carico controllato. Questi sono obiettivi di valutazione, non promesse ufficiali di V4.1 Pro.
Utilizzare prompt, strumenti, dati e budget di ragionamento coerenti ove possibile. Diverse impostazioni dell’harness possono produrre apparenti guadagni di modello non correlati al modello sottostante.
Preparare una strategia di distribuzione graduale
- Compatibilità: testare autenticazione, streaming, schemi, chiamate a strumenti e limiti di token.
- Valutazione in shadow: elaborare campioni di task reali senza cambiare gli output in produzione.
- Rollout controllato: instradare una piccola quota di richieste idonee al nuovo modello.
- Rollback: mantenere il percorso precedente verificato finché non vengono soddisfatti gli obiettivi di affidabilità e budget.
Dovreste aspettare DeepSeek V4.1 Pro o usare V4.1 Flash ora?
Se un modello disponibile soddisfa i vostri requisiti, iniziate con quello e mantenete configurabile l’instradamento del modello per una futura valutazione della versione Pro. Mantenete configurabile l’identificatore del modello e rivalutate quando verranno pubblicati una data di rilascio, un identificatore API supportato e risultati di valutazione.
| Requisito | Opzione pratica | Motivazione |
|---|---|---|
| Basso costo per token | Valutare V4.1 Flash | Tariffe pubblicate inferiori |
| Agent su larga scala | Testare prima Flash | Punteggi agent e concorrenza |
| Ragionamento difficile | Confrontare V4 Pro e Flash | Diversi punti di forza per task |
| Sistema V4 Pro esistente | Mantenere l’integrazione verificata | Evitare regressioni |
| Input visivo nativo | Testare Flash | Supporto visivo ufficiale |
| Workflow critici | Valutazione specifica per task | Accuratezza reale oltre le classifiche |
Mantenere configurabile l’identificatore del modello se prevedete di valutare V4.1 Pro in seguito.
Conclusione
DeepSeek V4.1 Pro è stato menzionato ufficialmente, ma la data di rilascio, l’identificatore API pubblico, i prezzi e i risultati dei benchmark rimangono non confermati nelle fonti esaminate. Gli sviluppatori possono utilizzare ora i percorsi disponibili V4 Pro e V4.1 Flash, mantenendo la selezione del modello configurabile e rieseguendo valutazioni allineate prima di adottare qualsiasi futuro rilascio Pro.