
TL;DR
Gemini 4 Argon non è incluso nel Gemini API Free tier, e un abbonamento Google AI Pro da solo non fornisce accesso API ad Argon. Google AI Ultra può offrire accesso tramite selezionati prodotti Gemini, mentre l’uso a pagamento dell’API è fatturato separatamente. CometAPI offre una via API indipendente senza richiedere che ogni utente finale disponga di un abbonamento Google AI Pro o Ultra. Le sue tariffe pubblicate non in cache per input e output sono $1.60 e $8 per milione di token, rispetto alle tariffe Standard introduttive di Google di $2 e $10.
Accesso e tariffe principali dei provider verificati il 16 ottobre 2026.
Key Takeaways
- Prezzo introduttivo: $2 / 1M token di input e $10 / 1M token di output; dal 1° dicembre, le tariffe raddoppiano.
- Input in cache: sconto del 95% con cache implicita sugli hit idonei; il minimo di cache è 4,096 token di prompt.
- La fatturazione dell’output include i token di ragionamento; input, ragionamento e output visibile condividono un budget di 1,048,576 token.
- Separa gli abbonamenti dell’app Gemini dalle abilitazioni di Antigravity e dall’accesso API a pagamento. L’assenza di un modello in un prodotto non dimostra che ogni via di accesso sia indisponibile.
- CometAPI fornisce una via API indipendente con tariffe pubblicate inferiori per input e output non in cache. Le applicazioni possono servire più utenti finali tramite un unico account CometAPI senza richiedere che ogni utente mantenga un abbonamento Google AI Pro o Ultra; si applicano comunque limiti di quota, saldo, tariffa e concorrenza a livello di account.
What Are Google’s Current Gemini 4 Argon Access Limits?
La prima decisione è dove ti serve Argon: un’app interattiva, un ambiente di coding locale o un’integrazione API. L’annuncio per gli sviluppatori distingue l’accesso a pagamento alla Gemini API dall’accesso per abbonati Ultra in AI Studio e Antigravity. Non interpretare una restrizione dell’abbonamento ad Antigravity come l’obbligo di acquistare Ultra per ogni flusso di lavoro API a pagamento.
Per un’applicazione API, CometAPI offre un percorso alternativo di account e fatturazione. Questo può essere utile quando vuoi valutare Argon insieme ad altri modelli senza acquistare un abbonamento consumer Google per tale scopo. Non modifica i diritti di accesso all’interno delle app Google e non dovrebbe essere descritto come uso illimitato.
How Much Does Gemini 4 Argon API Cost?
Le tariffe Standard di Gemini 4 Argon di Google si applicano fino al 30 novembre 2026, con tariffe più alte a partire dal 1° dicembre. Tutti gli importi sotto sono USD per milione di token salvo diversa indicazione. Batch, Flex e Priority hanno tariffe separate.
| Categoria di fatturazione (USD / 1M token) | Google Standard: fino al 30 novembre 2026 | Google Standard: dal 1° dicembre 2026 | Gemini 4 Argon API in CometAPI |
|---|---|---|---|
| Input | $2.00 | $4.00 | $1.60 |
| Input in cache | $0.10 | $0.20 | $0.16 |
| Output, incluso il ragionamento | $10.00 | $20.00 | $8.00 |
Le tariffe di CometAPI sono state verificate il 14 ottobre 2026. I suoi prezzi pubblicati per input e output sono inferiori del 20% rispetto alle tariffe Standard introduttive di Google. La cifra per l’input in cache proviene dal calcolatore dei costi di CometAPI; conferma la tariffa attiva dell’account e l’idoneità della cache prima di farvi affidamento. Il cambiamento di prezzo di Google a dicembre non determina le tariffe future di CometAPI; verifica le tariffe mostrate nel tuo account CometAPI quando fai budgeting.
A queste tariffe, 200,000 token di input non in cache più 60,000 token di output fatturabili costano $0.80 tramite CometAPI, rispetto a $1.00 tramite Google nel periodo introduttivo. Questo esempio calcolato esclude strumenti e retry.
What Does Gemini 4 Argon Cost Across Realistic Workloads?
Gli scenari seguenti sono esempi calcolati, non uso del modello misurato. L’input non è in cache; l’output include sia il ragionamento sia il testo visibile. Una richiesta di coding-agent con 200,000 token di input e 60,000 token di output fatturabili costa $1.00 durante il periodo introduttivo e $2.00 in seguito. Lo stesso carico ripetuto 1,000 volte costa $1,000 o $2,000 prima di retry, strumenti e imposte.
| Esempio di richiesta | Token di input non in cache | Token di output fatturabili | Prezzo introduttivo | Prezzo Standard |
|---|---|---|---|---|
| Risposta breve dell’assistente | 5K | 1K | $0.02 | $0.04 |
| Analisi di documento | 100K | 10K | $0.30 | $0.60 |
| Agente di coding complesso | 200K | 60K | $1.00 | $2.00 |
| Flusso di lavoro di ricerca | 500K | 100K | $2.00 | $4.00 |
| Richiesta con decodifica lunga | 100K | 500K | $5.20 | $10.40 |
Formula: Costo = (token di input non in cache × tariffa di input + token di input in cache × tariffa di cache + token di output fatturabili × tariffa di output) / 1,000,000. Gli esempi sopra sono illustrativi e assumono assenza di caching.
How Can You Reduce Gemini 4 Argon API Costs?
Implicit Caching and Reused Prompt Prefixes
Il caching riduce la spesa per l’input riutilizzato, non l’intero prezzo della richiesta. Per l’esempio 200K input / 60K output, un hit completo idoneo alla cache di input riduce il costo introduttivo dell’input da $0.40 a $0.02. Il costo totale in token diventa $0.62 anziché $1.00: una riduzione del 38%, pur con uno sconto dell’input del 95%. Se il 50% dei token di input è servito dalla cache, la stessa richiesta costa $0.81: 100,000 token di input in cache × $0.10 / 1M + 100,000 token di input non in cache × $2 / 1M + 60,000 token di output fatturabili × $10 / 1M = $0.01 + $0.20 + $0.60. Qui, 50% si riferisce specificamente al volume dei token di input. Tratta questi come scenari e usa l’uso osservato dei token in cache per la previsione.
Google abilita la cache implicita per prompt di almeno 4,096 token e non supporta la creazione esplicita della cache per Argon. Conserva prefissi di prompt riutilizzabili, ma fai budgeting per input non in cache finché gli hit osservati della cache non giustificano una stima inferiore.
Thinking Levels and Output Spending
Una risposta visibile breve può comunque comportare un costo di output sostanziale perché il ragionamento è fatturabile. Parti con ragionamento medio, quindi prova livelli più bassi e più alti su task rappresentativi. Traccia sia la qualità sia l’uso totale di output; scegli il livello di ragionamento più basso che soddisfi i tuoi criteri di accettazione.
Poiché ragionamento e output visibile condividono il limite di risposta, un valore basso di max_output_tokens può lasciare spazio insufficiente per la risposta finale. Confronta l’esecuzione riuscita del task a ciascun livello di ragionamento prima di ridurre il cap di output.
Operational Controls for Gemini 4 Argon Costs
- Usa limiti di output realistici ed evita generazioni inutilmente lunghe.
- Riutilizza prefissi di prompt condivisi quando idonei alla cache implicita.
- Instrada i task semplici verso modelli meno costosi, riservando Argon ai casi difficili.
- Registra il totale dei token fatturabili, i fallimenti, i retry e il costo per task riuscito.
- Valuta l’economia alle tariffe post-promozione prima di impegnarti in un’ampia distribuzione.
How Can You Access Gemini 4 Argon?
Scegli l’accesso all’app Gemini per lavoro interattivo personale e una via API a pagamento per applicazioni e agenti automatizzati. Argon è escluso dal Gemini API Free tier; un abbonamento Google AI Pro da solo non garantisce accesso API ad Argon. Le abilitazioni delle app Pro e Ultra sono separate dalla fatturazione dei token API, e Ultra non è richiesto per la Gemini API a pagamento.
| Via di accesso | Accesso ad Argon | Fatturazione / abilitazioni |
|---|---|---|
| Gemini app | Abbonati Pro e Ultra idonei | Abbonamento e limiti dell’app |
| Google AI Studio | Abbonati Ultra idonei o utenti dell’API a pagamento | Dipende dalla via di accesso |
| Gemini API | Progetti a pagamento idonei | Fatturazione API basata sull’uso |
| Google Antigravity | Abbonati Ultra idonei | Abilitazione specifica del prodotto |
| CometAPI | Account CometAPI supportati | Tariffe e condizioni CometAPI |
Direct Gemini 4 Argon API Integration
Gli sviluppatori possono integrare direttamente Gemini 4 Argon tramite un progetto Gemini API a pagamento idoneo. L’ID del modello è gemini-4-argon. Questa via è pensata per applicazioni, agenti automatizzati e flussi di lavoro di produzione che richiedono accesso diretto all’API di Google, fatturazione basata sull’uso e funzionalità API ufficiali.
Il Gemini API Free tier non include Argon. L’accesso all’app Google AI Pro inoltre non fornisce automaticamente l’accesso all’API o crediti API. Gli sviluppatori dovrebbero configurare fatturazione e idoneità per il progetto associato alle proprie credenziali API.
Errori di autenticazione, fatturazione o idoneità devono essere risolti per il progetto che possiede la chiave prima di riprovare; cambiare solo l’abbonamento consumer non configura la fatturazione dell’API.
CometAPI Access for Gemini 4 Argon
Gli sviluppatori possono accedere alla Gemini 4 Argon API in CometAPI tramite un account e una chiave API separati. I vantaggi pratici sono la fatturazione API indipendente, l’accesso a più modelli tramite un unico provider e le tariffe di input/output pubblicate confrontate sopra. Questa via non richiede l’acquisto di Google AI Pro o Ultra come abbonamento consumer.
L’accesso basato su account non è una promessa di capacità illimitata. Conferma disponibilità del modello, saldo, limiti di tariffa e concorrenza, regioni supportate, caching, controlli di ragionamento e reportistica d’uso per il tuo account CometAPI. L’accesso API inoltre non sblocca Argon all’interno dell’app Gemini o di Antigravity.
Inizia con una piccola richiesta tramite il provider scelto, verifica i campi del modello restituito e dell’uso, quindi imposta un limite di spesa prima di aumentare il traffico.
Is Gemini 4 Argon Worth the Cost?
Gemini 4 Argon è un candidato per ragionamento impegnativo, coding, ricerca e lavoro con contesto lungo. Il suo valore dipende dal fatto che migliori il completamento dei task o riduca i retry a sufficienza da giustificare la spesa in token. Usa le specifiche e i benchmark pubblicati sotto per identificare i carichi di lavoro da testare, quindi valuta qualità e costo con i tuoi prompt, strumenti e via di accesso.
Gemini 4 Argon Specifications
| Specifiche | Gemini 4 Argon |
|---|---|
| ID del modello | gemini-4-argon |
| Sviluppatore | Google DeepMind |
| Tipo di modello | Modello multimodale orientato al ragionamento |
| Finestra unificata input + ragionamento + output | Fino a 1,048,576 token complessivi |
| Livelli di ragionamento | Low / medium / high |
| Livello di ragionamento predefinito | Medium |
| Supporto per output lunghi | Esecuzione in background; massimo soggetto al budget condiviso |
| Cache di contesto | Implicita; prompt idonei ≥ 4,096 token |
| Cache esplicita | Non supportata |
Il limite di un milione di token è condiviso tra input, ragionamento e output generato. Sull’Interactions API, generare più di 65,536 token richiede sia background=True sia generation_config.max_output_tokens superiore a 65,536. Impostare background=True da solo non aumenta il limite di output predefinito. La GenerateContent API supporta anche la continuazione lato client per la decodifica lunga.
Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5: Published Benchmarks
I valori seguenti corrispondono ai risultati di valutazione pubblicati da Google. Sono risultati pubblicati dai vendor, compilati da più fonti di valutazione, non un nuovo confronto controllato eseguito per questo articolo.
| Benchmark pubblicato | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 67.0% |
| AutomationBench | 51.3% | 41.4% | 42.5% |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.6% |
| DeepSWE v1.1 | 77.9% | 74.1% | 74.2% |
| FrontierSWE v2 | 55.0% | 65.5% | 62.3% |
| Terminal-bench 4.0 | 57.4% | 58.2% | 66.4% |
| GraphWalks 256K–1M, BFS F1 | 84.2% | 71.8% | 66.8% |
| LVBench | 91.7% | 87.5% | 83.7% |
Evaluation Conditions and Comparability
La metodologia di valutazione di Google utilizza la Gemini API al livello di ragionamento più alto salvo diversa indicazione, generalmente con pass@1. DeepSWE usa mini-swe per Argon; le cifre dei competitor provengono da leaderboard o system card. GraphWalks 256K–1M usa 200 problemi. LVBench gira senza strumenti, con 1 FPS per Gemini, 800 frame per GPT-6 Astra e 600 per Opus 5.5. I risultati di Vals provengono da Vals AI; AutomationBench utilizza la leaderboard su set privato di Zapier. Queste differenze limitano la comparabilità diretta.
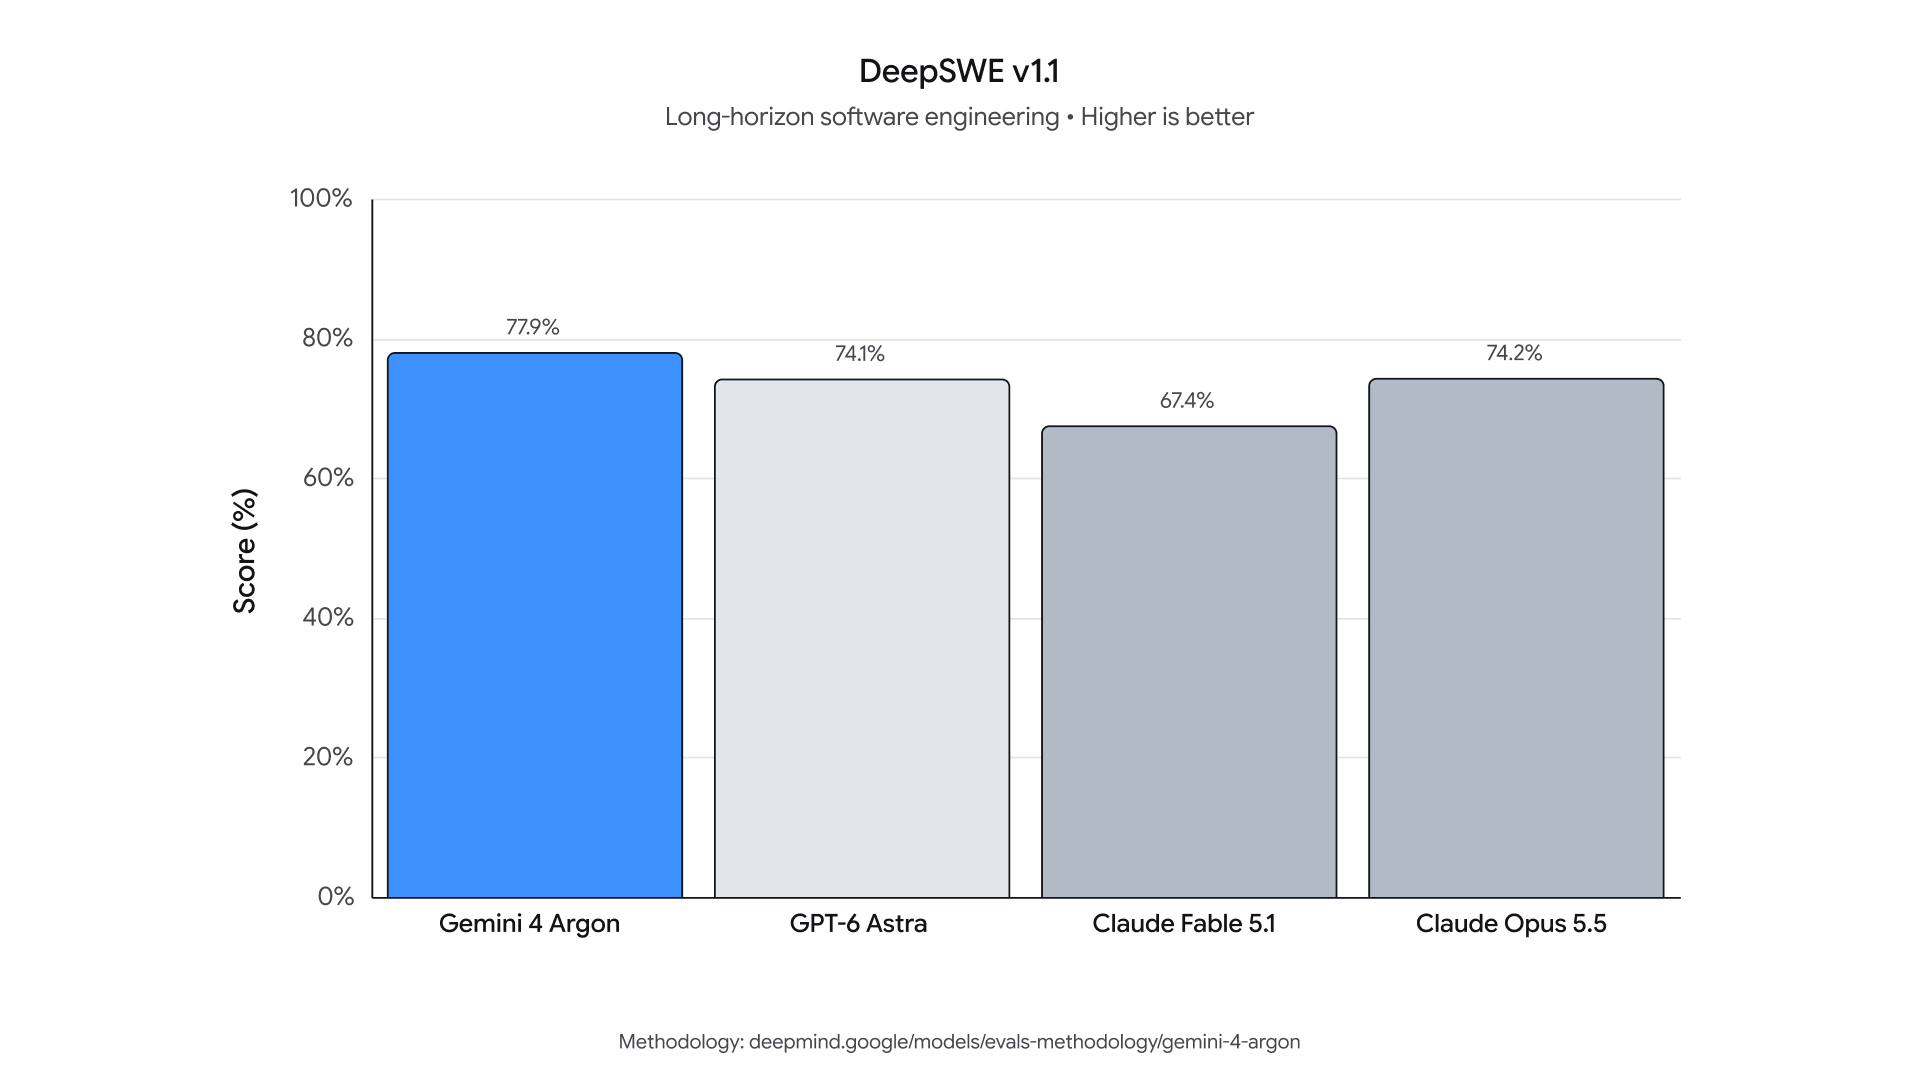
Il grafico DeepSWE v1.1 originale di Google mostra Gemini 4 Argon (77.9%), GPT-6 Astra (74.1%), Claude Fable 5.1 (67.4%) e Claude Opus 5.5 (74.2%), da sinistra a destra. La tabella sopra seleziona tre di questi modelli; l’immagine ufficiale li include tutti e quattro.
Performance Implications for Gemini 4 Argon Users
Interpretazione: Argon è in testa nelle righe selezionate Vals Index, AutomationBench, financial-agent e contesto lungo; non è in testa in FrontierSWE o Terminal-bench. Poiché harness di valutazione e prompt possono variare, usa questi risultati come indicazioni e esegui test specifici sui tuoi carichi di lavoro.
Per l’approvvigionamento, misura il costo di un task riuscito insieme ad accuratezza, latenza, retry e uso di token. Un punteggio pubblicato più alto non dimostra un costo di produzione più basso con i tuoi prompt, strumenti o via di accesso.
Choose Gemini 4 Argon or Cheaper Model
Testa Argon su task difficili di ragionamento, coding e contesto lungo in cui meno retry o un tasso di completamento più alto potrebbero giustificare una maggiore spesa in token. Per classificazione di routine, estrazione e sintesi ad alto volume, prova prima modelli a costo inferiore.
Confronta il costo totale per task riuscito, inclusi token di ragionamento, uso della cache, chiamate a strumenti e retry. Scegli il modello e la via di accesso che soddisfano i tuoi requisiti di qualità a un costo accettabile.
FAQ
Batch e Flex di Gemini 4 Argon sono più economici dello Standard?
Le tariffe token di Argon Batch e Flex di Google sono $1 per l’input e $5 per l’output per milione di token fino al 30 novembre 2026, salendo a $2 e $10 in seguito. L’input in cache è $0.05, salendo a $0.10. Queste sono opzioni di elaborazione separate, quindi valida i loro vincoli operativi rispetto al tuo carico di lavoro prima di sostituire un’integrazione Standard.
Stima separatamente l’uso di Standard, Batch e Flex usando le tariffe applicabili di ciascuna opzione, quindi somma i subtotali per un budget a carico misto.
Le stime dei token di Gemini 4 Argon includono i costi di ricerca?
No. La sola aritmetica dei token esclude i servizi fatturati separatamente. L’addebito per Search grounding è $14 per 1,000 query dopo la franchigia mensile condivisa di 5,000 richieste per i modelli Gemini 3 e successivi. Una richiesta inviata può emettere più di una query di ricerca, quindi traccia l’uso reale del grounding separatamente anziché presumere che un prompt utente equivalga a una query fatturabile.
Come dovrei pianificare il budget di Gemini 4 Argon attraverso il cambio di prezzo?
Dividi la previsione di uso dei token tra periodo introduttivo e periodo standard, quindi applica le tariffe di ciascun periodo. Per esempio, 10 milioni di token di input non in cache più 1 milione di token di output costano $30 alle tariffe Standard introduttive o $60 in seguito. Se metà di quel volume ricade in ciascun periodo, la stima in token è $45. Aggiungi separatamente i costi di strumenti e retry, e usa le tariffe post-promozione per un budget a regime.
Perché una risposta di Gemini 4 Argon può interrompersi prima di essere completa?
Il cap di output include il ragionamento oltre al testo visibile. Un prompt impegnativo può esaurire tale allowance prima che la risposta finale sia completa. Per risposte lunghe, l’esecuzione in background continua la generazione in più passaggi fino al completamento o al limite configurato; serve comunque un valore adeguato di max_output_tokens. Verifica lo stato di completamento e l’uso, quindi regola la profondità di ragionamento o il cap anziché inviare ripetutamente la stessa richiesta sotto-budget.
Conclusion
Scegli l’accesso a Gemini 4 Argon in base al flusso di lavoro, quindi confronta il costo di completare un task utile. Le abilitazioni dell’app di Google e di Antigravity differiscono dall’accesso API a pagamento. CometAPI offre una via API separata con prezzi pubblicati per input/output inferiori del 20% rispetto alle tariffe Standard introduttive di Google, rendendola un’opzione pratica per una valutazione piccola e con budget. Valida i limiti dell’account e le funzionalità richieste, traccia token di ragionamento e retry, e scala solo quando qualità e costo totale soddisfano le tue esigenze.