
TL;DR
GLM 5.4 è un nome utilizzato dalla community per un possibile successore nella famiglia GLM di Z.ai. Al 14 ottobre 2026, la documentazione ufficiale del modello e i registri di rilascio esaminati per questo articolo non attestano un lancio di GLM-5.4, una scheda delle specifiche o un identificatore API. Union Alpha è un indizio di rumor, mentre un lancio in ottobre è una possibilità basata sulla cadenza. La domanda utile è se una futura release migliori l’affidabilità nella programmazione e il costo per attività completata; i modelli GLM esistenti forniscono la base di riferimento per quella valutazione.
Punti chiave
- Stato del rilascio: Le fonti ufficiali esaminate il 14 ottobre 2026 non confermano GLM-5.4; non è stata stabilita alcuna data di lancio esatta.
- Evidenze dei rumor: L’associazione di Union Alpha con GLM-5.4 resta non verificata, e il riepilogo citato non identifica un post di attribuzione originale.
- Baseline di prestazioni: I risultati di GLM-5.3 esistenti sono un contesto utile, ma non sono misurazioni di GLM-5.4.
- Architettura: GLM-5.3-Flash dimostra una diversa direzione in termini di efficienza e multimodalità; l’eventuale ereditarietà in GLM-5.4 è una questione aperta.
- Azione per gli sviluppatori: Valutate subito i modelli disponibili e richiedete ID di modello verificati, compatibilità e misurazioni a livello di attività prima di effettuare l’upgrade.
GLM 5.4 è stato rilasciato?
GLM 5.4 è un nome non ufficiale per un potenziale successore di GLM. L’indice della documentazione ufficiale e i registri di rilascio esaminati il 14 ottobre 2026 identificano i modelli GLM esistenti ma non attestano un rilascio di prodotto GLM-5.4. Si tratta di una verifica con fonte datata, non della prova che non esista uno sviluppo privato.
Due percorsi di sviluppo documentati spiegano perché un possibile successore attiri attenzione.
Z.ai conferma che GLM-5.3 riutilizza il modello base GLM-5.2 e ottiene i suoi miglioramenti tramite post-training. GLM-5.3-Flash invece utilizza un nuovo base multimodale e un’architettura di attenzione ibrida. Questi fatti descrivono modelli esistenti, non un design GLM-5.4 divulgato.
In termini pratici, un percorso migliora un modello esistente tramite ulteriore training, mentre l’altro ridisegna l’architettura per ridurre i costi di calcolo e supportare nuove capacità.
Un futuro GLM-5.4 potrebbe basarsi su entrambe le direzioni, ma non vi sono ancora prove sufficienti per determinare quale approccio selezionerà Z.ai.
Quanto sono affidabili i rumor e le indiscrezioni su GLM-5.4?
Informazioni confermate
La base tecnica confermata proviene da GLM-5.3 e GLM-5.3-Flash, non da GLM-5.4. Il nome GLM-5.4, le specifiche finali, la data di rilascio e i risultati di benchmark restano non confermati nelle fonti ufficiali esaminate per questo articolo.
Segnalazioni della community / leak
Un post su X dell’8 ottobre 2026 di @NFT_Chen attribuisce una possibile direzione di sviluppo GLM-5.4/5.5 a commenti di Tang Jie. Il post descrive tre priorità di scaling: espandere il pre-training, rafforzare il post-training tramite SFT, RLHF e RLVR, ed estendere il reasoning e l’esecuzione agentica su compiti più difficili e più lunghi.
L’autore interpreta la prossima direzione come agenti autonomi più duraturi e auto-miglioramento ricorsivo (RSI). Si tratta di un resoconto della community su una talk, non di un annuncio di rilascio di Z.ai. I nomi di versione e le affermazioni di sviluppo rimangono attribuiti al post; non stabiliscono una data di lancio, un’architettura finale, un numero di parametri o una capacità dimostrata di auto-miglioramento per GLM-5.4.
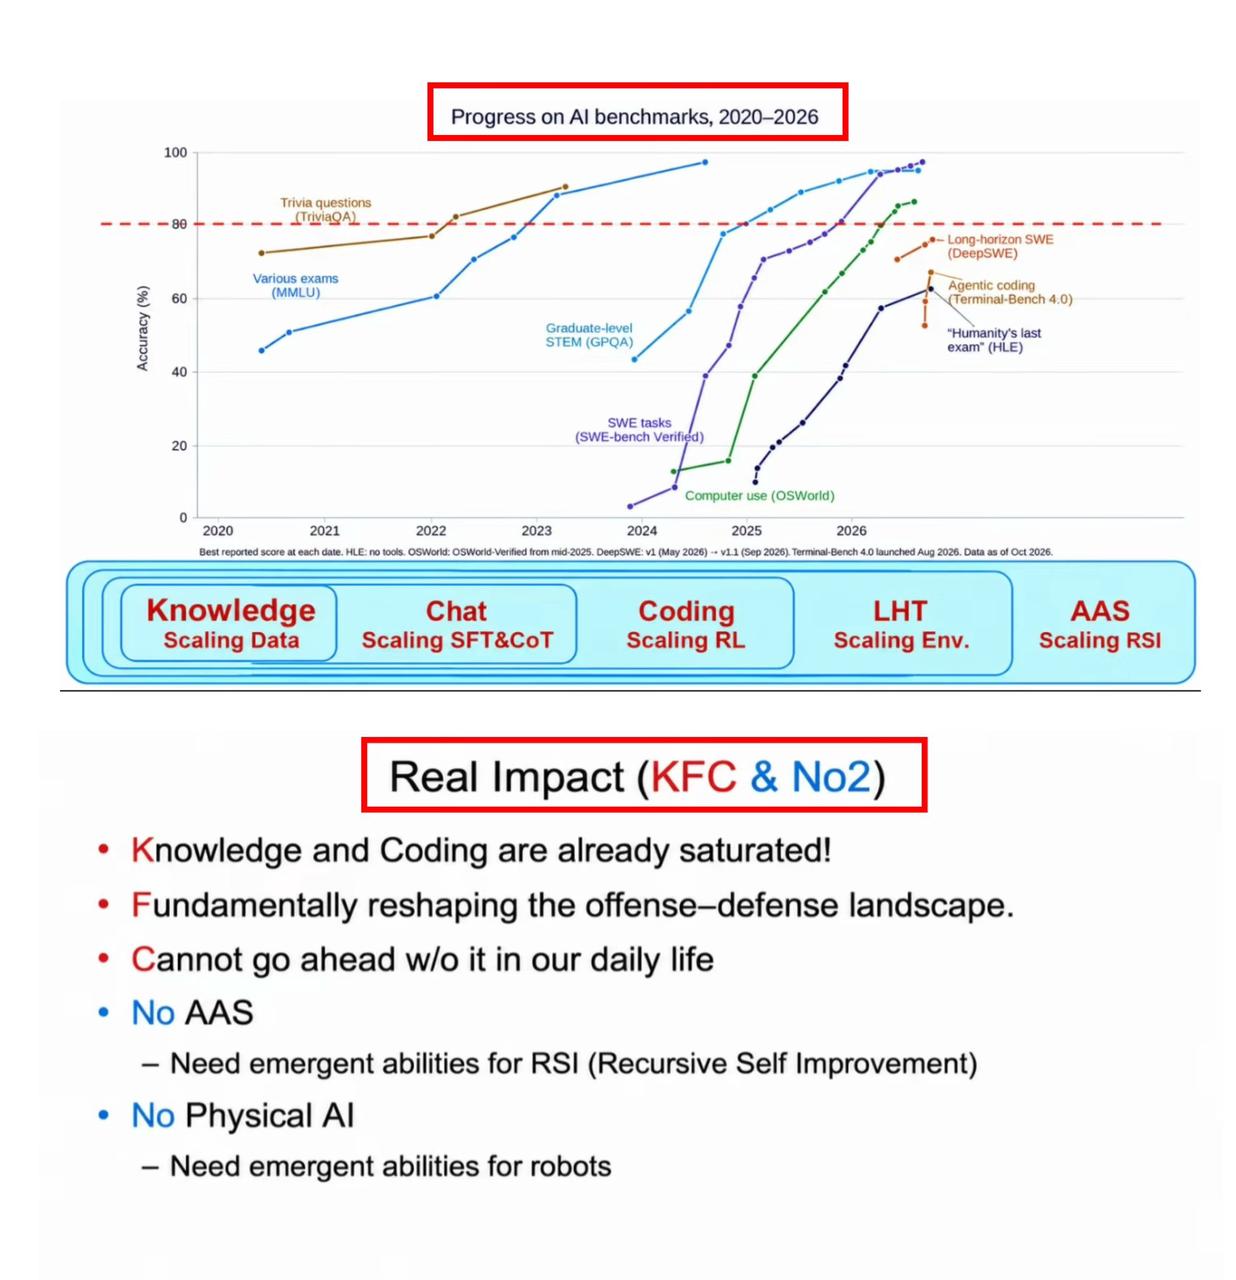
Immagine della slide di presentazione allegata al post originale su X di @NFT_Chen, 8 ottobre 2026. Discute i progressi sui benchmark e l’RSI come direzione futura; non è un report di benchmark su GLM-5.4.
Fotografia della talk allegata al post originale su X di @NFT_Chen, 8 ottobre 2026.
Analisi
Un’analisi utile dei rumor chiede quale osservazione cambierebbe la conclusione. Un identificatore di modello ufficiale, un annuncio di rilascio o una mappatura divulgata da un alias anonimo rafforzerebbero in modo sostanziale il caso. Un pattern di naming simile o il solo intervallo di rilascio non possono farlo. Speculazioni più vecchie su altri numeri di versione futuri di GLM non stabiliscono le specifiche per GLM-5.4.
Quando potrebbe essere rilasciato GLM 5.4?
La timeline delle note di rilascio di Z.ai registra GLM-5 il 12 febbraio, GLM-5.1 il 7 aprile, GLM-5.2 il 16 giugno, GLM-5.3 il 18 agosto e GLM-5.3-Flash il 26 agosto 2026. Queste sono date registrate nelle note di rilascio; non vanno confuse con ogni annuncio di ricerca o data di disponibilità presso i provider.
La progressione approssimativa di due mesi delle principali versioni rende ottobre una finestra analitica ragionevole da osservare. Non stabilisce un lancio in ottobre, un giorno specifico o nemmeno il nome della prossima versione. Senza una fonte di previsione tracciabile e la sua metodologia, una previsione precisa del 20 o del 23 ottobre implicherebbe più precisione di quanta le evidenze supportino.
È possibile un lancio più tardo, un nome diverso o una variante di prodotto separata. Gli sviluppatori dovrebbero pianificare in base alle API attualmente disponibili piuttosto che a una stima di calendario.
Quali sono le specifiche attese di GLM 5.4?
Non è disponibile una scheda di specifiche affidabile di GLM-5.4. Piuttosto che assegnare hardware e parametri di modello rumoreggiati a un prodotto non rilasciato, è più informativo confrontare gli ultimi modelli GLM documentati e identificare ciò che rimane sconosciuto.
| Specifiche | GLM-5.3 | GLM-5.3-Flash | GLM-5.4 |
|---|---|---|---|
| Rilascio | 18 agosto 2026 | 26 agosto 2026 | Non annunciato |
| Base del modello | Base GLM-5.2; ulteriore post-training | Nuova base multimodale | Sconosciuto |
| Architettura | Base MoE | MoE; attenzione ibrida sparsa-lineare | Sconosciuto |
| Supporto al contesto | 1M di contesto API documentato | 1M | Sconosciuto |
| Multimodalità nativa | Input solo testo | Input di testo, immagini, video e file | Sconosciuto |
| Enfasi principale | Programmazione, agenti, cybersicurezza | Efficienza, programmazione, multimodalità | Sconosciuto |
| Benchmark pubblicati | Disponibili | Disponibili | Non disponibili |
| Pesi del modello | Rilasciati | Rilasciati | Non disponibili |
La tabella riporta le capacità documentate dei modelli esistenti. Le voci su GLM-5.4 restano sconosciute, invece di ereditare valori da uno dei predecessori. Il contesto di valutazione di un modello, la finestra di contesto dell’API e la lunghezza massima dell’output sono limiti distinti.
La panoramica dell’architettura di GLM-5.3-Flash riporta 320B parametri totali, 18B parametri attivati e attenzione ibrida sparsa-lineare. Queste sono specifiche divulgate di Flash e non dovrebbero essere attribuite a GLM-5.4.
Coding agentico come possibile direzione di upgrade
Il coding agentico è una delle aree più credibili da osservare. GLM-5.3 ha già dimostrato che scalare il post-training può migliorare sostanzialmente le prestazioni su compiti ingegneristici multi-step. Gli sviluppatori hanno enfatizzato lavori su repository complessi, orizzonti di esecuzione più lunghi e una migliore risoluzione dei problemi basata su strumenti.
Un modello futuro potrebbe estendere queste capacità tramite una migliore interazione con l’ambiente, una pianificazione più affidabile e meno chiamate a strumenti fallite.
La valutazione più utile non misurerebbe semplicemente la percentuale di domande di coding risposte correttamente. Misurerebbe se un agente può completare compiti complicati end-to-end, includendo debugging, testing, revisione e recupero dopo fallimenti.
Architettura multimodale efficiente come possibile direzione
GLM-5.3-Flash fornisce un punto di riferimento architetturale per lo sviluppo futuro, mentre nessuna fonte ufficiale esaminata ne stabilisce l’uso in GLM-5.4.
Z.ai descrive un corpus di pre-training multimodale da 30T token come parte del design orientato all’efficienza di GLM-5.3-Flash. Questo descrive la scala dei dati di training di un modello esistente e non è un impegno di roadmap per GLM-5.4.
La panoramica ufficiale di Flash riporta 3.01× di riduzione del calcolo di attenzione e 4.44× di riduzione dei requisiti di KV-cache rispetto a GLM-5.3 nel confronto dichiarato. Si tratta di risultati di efficienza a livello di componente, non di una garanzia di velocità applicativa o di sconto API.
Sono miglioramenti ingegneristici significativi, ma non vi è conferma che GLM-5.4 ne erediterà la stessa architettura. Un modello di nuova generazione più grande potrebbe dare priorità alle massime prestazioni di reasoning, mentre una variante Flash separata potrebbe continuare a ottimizzare latenza e costo.
GLM 5.4 vs GLM-5.3 vs GLM-5.3-Flash
Baseline dei benchmark di GLM-5.3
I dati di benchmark disponibili supportano un’analisi della traiettoria di prestazioni di GLM-5.3, non una misurazione diretta di GLM-5.4. I valori di seguito sono le valutazioni riportate da Z.ai di modelli esistenti. Non sono stati riprodotti in modo indipendente per questo articolo e non misurano GLM-5.4. Ogni benchmark utilizza il proprio set di compiti e metodo di punteggio; le differenze di punteggio non devono essere interpretate come guadagni equivalenti tra i compiti.
| Benchmark e metodologia | GLM-5.2 | GLM-5.3 | GLM-5.3-Flash | Differenza GLM-5.3 vs GLM-5.2 |
|---|---|---|---|---|
| Terminal Bench 3.0 | 4.6 | 28.3 | Non riportato nel confronto Flash citato | +23.7 punti |
| DeepSWE v1.1 | 46.2 | 66.9 | 63.4 | +20.7 punti |
| AutomationBench v1.0.6 | 26.2 | 48.2 | 48.8 | +22.0 punti |
| CyberGym | 77.2 | 84.5 | Non riportato nel confronto Flash citato | +7.3 punti |
| ExploitBench | 24.4 | 54.4 | Non riportato nel confronto Flash citato | +30.0 punti |
| HLE with Tools | 54.7 | 62.5 | 55.3 | +7.8 punti |
| GDPval-AA v2 | 1508 | 1769 | Non riportato nel confronto Flash citato | +261 Elo |
| Toolathlon Verified | 59.9 | Non riportato nel confronto GLM-5.3 citato | 78.4 | Non disponibile |
La tabella combinata affianca i risultati dei modelli esistenti; non contiene misurazioni di GLM-5.4. Un valore non riportato non è un punteggio pari a zero. Tenete presenti le condizioni di valutazione di ciascun benchmark e trattate le differenze di GDPval-AA come Elo, non come punti percentuali.
Metodologia: DeepSWE v1.1 utilizza mini-swe-agent, temperature 0.95, top_p 1.0, timeout di sei ore e contesto da 400K. AutomationBench utilizza la v1.0.6. HLE with Tools utilizza temperature 1.0, top_p 0.95, un limite di generazione di 163.840 token e un limite di contesto di 300K con gestione del contesto. GDPval-AA v2 utilizza una scala Elo, quindi la differenza non è un guadagno in punti percentuali.
Per CyberGym ed ExploitBench, Z.ai riporta Claude Code 2.1.207 con max reasoning effort, nessun web tool, temperature 1.0, top_p 1.0 e un limite di output di 128.000 token. CyberGym riporta pass@1 in single-run su 1.507 compiti con timeout illimitato per compito. ExploitBench utilizza fino a 300 round di interazione e media la copertura su 41 compiti attraverso tre revisioni. Le note del model card forniscono i dettagli dell’ambiente specifici per i benchmark.
Metodologia Flash: DeepSWE utilizza mini-swe-agent, contesto da 400K e timeout di sei ore; AutomationBench utilizza la v1.0.6. Toolathlon Verified riporta pass@1 mediato su tre run indipendenti tramite il servizio di valutazione ufficiale. HLE utilizza le impostazioni di campionamento e di gestione del contesto descritte sopra. Vedere la metodologia del model card di Flash. Questi risultati di benchmark non stabiliscono latenza di produzione o costo.
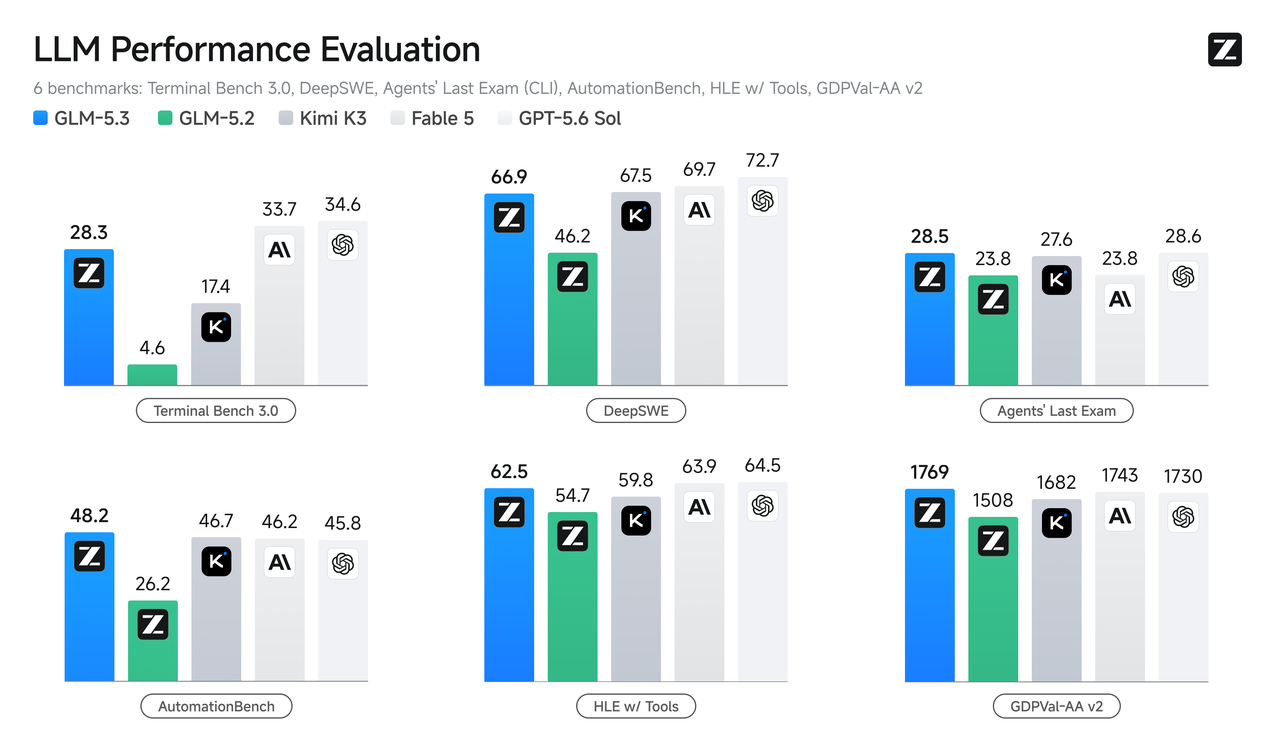
Grafico ufficiale delle prestazioni di GLM-5.3, riprodotto dall’annuncio dei benchmark di Z.ai. L’immagine mostra valutazioni dei modelli predecessori; non contiene risultati di GLM-5.4.
I maggiori miglioramenti compaiono in compiti che richiedono un’interazione prolungata con un ambiente. Terminal Bench 3.0 è aumentato da 4.6 a 28.3, mentre ExploitBench è migliorato da 24.4 a 54.4.
Questi guadagni suggeriscono che il post-training e gli ambienti orientati agli agenti possono alterare drasticamente le prestazioni di un modello senza cambiarne l’architettura di base. Tuttavia, non dovrebbero essere estrapolati in una previsione numerica per GLM-5.4.
Capacità e idoneità alla produzione
Per la produzione, GLM-5.3 è il riferimento più solido per coding complesso, ingegneria a lungo orizzonte e valutazione di cybersicurezza. GLM-5.3-Flash aggiunge input visivi nativi ed enfatizza l’uso efficiente degli strumenti. GLM-5.2, GLM-5.3 e le offerte Flash esistenti forniscono una base di riferimento; nelle fonti esaminate per questo articolo non è stabilita un’analoga capacità o disponibilità di GLM-5.4.
I modelli documentati supportano fino a 1M di contesto, ma tale limite non garantisce un contesto utilizzabile identico o prestazioni di compito su ogni endpoint. Sceglieteli usando carichi di lavoro rappresentativi e costo per attività completata con successo.
Un futuro GLM-5.4 dovrebbe offrire un miglioramento misurabile per giustificare la migrazione. Migliorare l’accuratezza dei benchmark raddoppiando i costi di completamento delle attività potrebbe non essere allettante per i deployment di produzione. Al contrario, un modesto guadagno di accuratezza e sostanzialmente meno chiamate a strumenti potrebbe essere prezioso su larga scala.
Confrontate tasso di successo dei compiti, token input e output, latenza, chiamate a strumenti fallite e costo per compito riuscito sotto lo stesso harness di valutazione. Le descrizioni qualitative del modello non sono un test controllato testa a testa.
Qual è lo stato attuale dell’API di GLM-5.4 su CometAPI?
CometAPI ha creato una pagina dedicata al modello GLM 5.4 con una voce di identificatore di modello stabile. Tuttavia, la pagina etichetta ancora il modello come “Coming soon” e lo descrive come un modello pre-lancio. Gli sviluppatori dovrebbero verificare l’effettivo ID del modello, l’accesso all’account, la disponibilità dell’endpoint, i parametri supportati, i limiti di contesto e il pricing prima di tentare l’uso in produzione.
Per un’integrazione attualmente documentata, utilizzate un modello GLM disponibile come GLM-5.2 o GLM-5.3. La pagina GLM-5.4 di CometAPI dovrebbe essere trattata come una voce di catalogo pre-lancio finché l’ID del modello e l’endpoint non saranno confermati come invocabili.
Preparazione all’integrazione dell’API GLM 5.4
La preparazione più pratica è evitare di accoppiare la logica applicativa a una singola versione di modello. Un identificatore di modello configurabile rende più semplice valutare gli upgrade senza riscrivere la pipeline di richieste.
Mantenete configurabile l’identificatore di modello e usate un modello GLM disponibile per stabilire una base di lavoro. Prima di passare a GLM-5.4, confermate un ID di modello invocabile, l’accesso all’account, i parametri di richiesta supportati, i limiti di contesto e di output, il comportamento di streaming e la compatibilità delle chiamate a strumenti. Tenete pronta un’opzione di rollback.
Quando GLM-5.4 diventerà ufficialmente disponibile, verificate l’ID del modello, i parametri supportati, i limiti di contesto e la compatibilità dell’endpoint. Eseguite il modello vecchio e quello nuovo sullo stesso dataset di valutazione, tracciando tasso di successo, latenza, token output, fallimenti nelle chiamate a strumenti e costo per esecuzione riuscita.
Come potrebbe essere il pricing dell’API GLM 5.4?
Non è stato annunciato alcun prezzo ufficiale dell’API GLM-5.4. Sarebbe quindi fuorviante pubblicare una tariffa specifica per token input o output come se fosse una vera indiscrezione.
L’attuale famiglia GLM illustra perché la sola dimensione del modello è insufficiente per prevedere il pricing. GLM-5.3-Flash ha introdotto ottimizzazioni architetturali progettate per fornire intelligence competitiva a costi di inferenza sostanzialmente inferiori.
Il confronto dell’Artificial Analysis Intelligence Index v4.1.1 di Z.ai riporta un punteggio di 57 a un costo stimato scontato di $0.045 per attività per GLM-5.3-Flash. Questo costo di valutazione non è una tariffa per token input/output e non predice il pricing di GLM-5.4.
Il pricing futuro di GLM-5.4 potrebbe dipendere da architettura, sforzo di reasoning, sconti sui token in cache, infrastruttura di hosting e varianti. Per la pianificazione in produzione, il costo per attività completata con successo è spesso più prezioso della tariffa più bassa per i token input.
Gli sviluppatori dovrebbero aspettare GLM 5.4?
Per la maggior parte degli sviluppatori, aspettare un modello non annunciato è superfluo. I modelli GLM esistenti offrono capacità di programmazione e agentiche documentate che possono essere testate in applicazioni reali.
I team che costruiscono assistenti di coding o agenti ingegneristici multi-step possono stabilire una baseline con GLM-5.3. Le applicazioni che enfatizzano comprensione visiva, contesto lungo e chiamate ripetute efficienti possono valutare GLM-5.3-Flash.
Costruite ora un harness di valutazione e riservate uno slot di confronto futuro per GLM-5.4. Quando disponibile, il suo rilascio conterà se migliora gli esiti che contano per una particolare applicazione.
I ricercatori dovrebbero monitorare nuove architetture di fondazione, cambiamenti nei benchmark a lungo orizzonte e affidabilità end-to-end. Le aziende dovrebbero dare priorità a disponibilità, costo, latenza, compatibilità e qualità su dati rappresentativi di produzione.
Conclusione
GLM 5.4 è un passo successivo plausibile nella famiglia di modelli in rapida evoluzione di Z.ai, ma la sua narrativa attuale rimane più speculativa che confermata.
Union Alpha è un indizio di identità non verificato, e la cadenza di rilascio supporta solo un’ipotesi temporale ampia. Nessuna delle due stabilisce una data di lancio. Le fonti ufficiali esaminate il 14 ottobre 2026 forniscono una base per i modelli esistenti piuttosto che un rilascio confermato di GLM-5.4.
Ciò che è verificabile è il progresso già compiuto da GLM-5.3 e GLM-5.3-Flash. Notevoli guadagni nel coding agentico, nella valutazione della cybersicurezza e nell’efficienza di inferenza stabiliscono una base impegnativa per qualsiasi successore.
La domanda chiave è se Z.ai riuscirà a fornire esecuzione autonoma affidabile, reasoning più forte e un costo competitivo per attività completata. Fino a quando non appariranno specifiche ufficiali e benchmark, GLM-5.4 dovrebbe essere trattato come un rilascio potenziale, non come un prodotto disponibile.
FAQ
Come posso verificare una scheda API di GLM 5.4?
Verificate che il provider fornisca un identificatore di modello invocabile, un endpoint supportato, condizioni di accesso e pricing corrente. Poi confrontate l’identità con un annuncio ufficiale di Z.ai o la documentazione. Una scheda del provider può stabilire l’offerta di quel provider, ma di per sé non autentica lo sviluppatore sottostante di un modello anonimo.
Quali verifiche di compatibilità contano prima di una migrazione a GLM 5.4?
Convalidate parametri di richiesta, impostazioni di reasoning, schema delle chiamate a strumenti, output strutturato, comportamento di streaming, limiti di contesto e output sul vostro endpoint effettivo. Includete test negativi per parametri non supportati e mantenete il modello esistente disponibile per il rollback. La compatibilità con OpenAI descrive un’interfaccia; non garantisce un comportamento di modello identico.
Come dovrei valutare GLM 5.4 per agenti di coding?
Usate un set fisso di compiti su repository rappresentativi con gli stessi strumenti, permessi, timeout e harness per entrambi i modelli. Contate modifiche testate con successo, recupero dai fallimenti degli strumenti, uso di token, latenza e costo totale. Registrate ogni run e ripetete i compiti a sufficienza per far emergere la variabilità, invece di promuovere un singolo esempio favorevole.
Cosa giustificherebbe l’attesa di GLM 5.4?
Aspettare è ragionevole solo quando una capacità documentata in arrivo risponde a un requisito che i modelli disponibili non possono soddisfare, e il ritardo si adatta alla vostra roadmap di consegna. Con solo un rumor, costruite su un modello disponibile e mantenete la selezione del modello configurabile. Definite le soglie di capacità e costo che una release successiva deve soddisfare prima di sostituire la vostra baseline.