
Aggiornamento sul rilascio di Grok 4.7: dalle previsioni alla disponibilità ufficiale
Informazioni verificate: 16 ottobre 2026.
Grok 4.7 è stato rilasciato ufficialmente il 21 settembre 2026. I riferimenti precedenti a un lancio il 12 settembre erano stime pre-release e non devono essere considerati la data effettiva di rilascio.
L’annuncio ufficiale di lancio descrive miglioramenti nel coding, nel lavoro di conoscenza, nei task di lunga durata e nella verifica dei risultati del modello. Conferma la disponibilità tramite Grok API, Cursor e Grok Build. Per l’ID esatto del modello API, le funzionalità supportate, i limiti di contesto e i prezzi attuali, consultare la documentazione ufficiale di Grok 4.7.
I risultati ufficiali mostrano progressi misurabili rispetto a Grok 4.6. Ad esempio, il confronto di lancio riporta un punteggio Terminal-Bench 4.0 del 37.6% per Grok 4.7 a livello di sforzo xhigh, rispetto al 20.3% di Grok 4.6 a livello di sforzo high. Si tratta di risultati dichiarati dal fornitore nelle impostazioni di valutazione indicate; le prestazioni applicative dipenderanno dai prompt, dagli strumenti, dal livello di ragionamento e dalla difficoltà del task.
Per gli sviluppatori, la domanda utile ora è se Grok 4.7 completi i loro carichi di lavoro in modo più affidabile ed economico. Provatelo su modifiche di repository, creazione di documenti e workflow multi-step con strumenti, misurando completamento con successo, latenza, retry e costo totale del task.
Fonte: Annuncio ufficiale di lancio di Grok 4.7.
Punti chiave
- La data prevista del 12 settembre è dedotta dal conto alla rovescia di dieci giorni di Musk, non da un annuncio separato del calendario xAI.
- Le affermazioni su scala 2,1T e sui dati SpaceX sono dichiarazioni pre-release; parametri attivi, routing, architettura e metodologia di training restano non pubblicati.
- Grok 4.6 mostra già risultati solidi nel lavoro di conoscenza e in capacità agentiche, inclusi il 61.3% su FrontierCode v1.1 (Extended), ma resta indietro rispetto al modello di confronto più forte in diverse valutazioni di coding difficili.
- Grok 4.7 va giudicato in base al tasso di task accettati, all’affidabilità su lungo orizzonte, all’efficienza dei token, alla latenza e al costo per risultato riuscito—non solo in base al numero di parametri.
- CometAPI integrerà Grok 4.7 non appena xAI rilascerà ufficialmente il modello e sarà disponibile l’accesso all’endpoint di produzione; gli sviluppatori dovrebbero comunque convalidare l’ID del modello live, il prezzo e il comportamento della risposta prima della migrazione.
Che cos’è Grok 4.7?
Grok 4.7 è il successore annunciato di Grok 4.6 e dovrebbe proseguire l’attenzione di xAI su coding, ingegneria, agenti di lunga durata e lavoro di conoscenza professionale. Le evidenze pubbliche attuali consistono in dichiarazioni dei fondatori e in un conto alla rovescia per il rilascio, piuttosto che in un pacchetto tecnico completo di lancio.
La distinzione più importante è tra tre oggetti: il modello Grok 4.7 annunciato, i segnali pre-release che descrivono la possibile scala e il training, e il baseline di produzione Grok 4.6 attualmente live. Gli sviluppatori dovrebbero trattare Grok 4.7 come un candidato alla valutazione in arrivo finché xAI non pubblica la documentazione finale e una richiesta di produzione non va a buon fine contro l’endpoint rilasciato.
Data di rilascio e cronologia di Grok 4.7
Quando si prevede il rilascio di Grok 4.7?
L’affermazione di Musk del 2 settembre secondo cui il modello sarebbe arrivato tra dieci giorni indica circa 12 settembre 2026
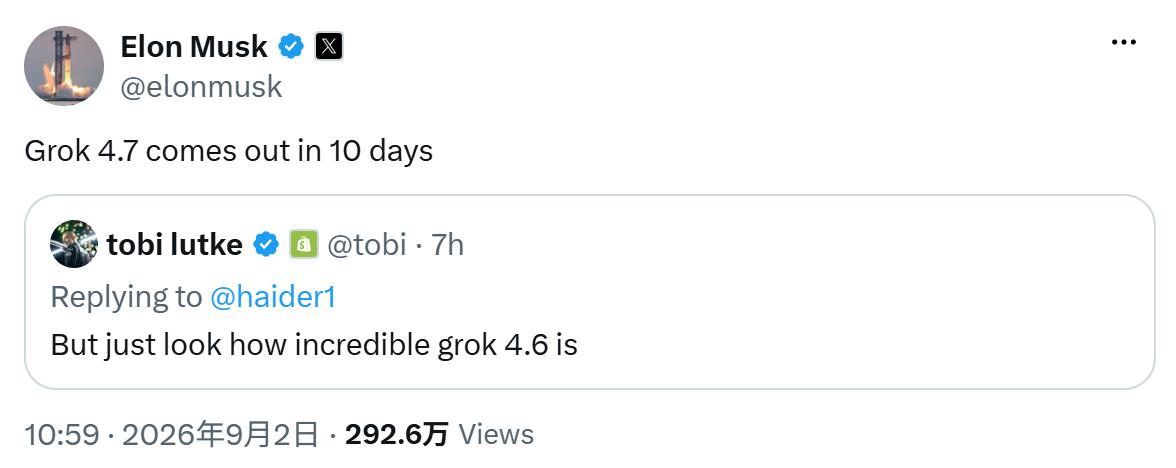
Fonte: Elon Musk su X, 2 settembre 2026
Cronologia del rilascio di Grok 4.7
| Data | Segnale pubblico | Interpretazione |
|---|---|---|
| Fine luglio 2026 | Musk ha descritto un modello di circa 2,1T, un’efficienza di token migliorata e un serving leggermente più lento. | Aspettative su scala del modello ed efficienza dichiarate dal fondatore. |
| 12 agosto 2026 | L’addestramento iniziale è stato descritto come completo; il training supplementare avrebbe incluso molti dati SpaceX. | Aggiornamento sul progresso del training, non una conferma del rilascio. |
| 2 settembre 2026 | “Grok 4.7 esce tra 10 giorni.” | Il più chiaro conto alla rovescia pubblico per il rilascio finora. |
| 12 settembre 2026 | Data di calendario derivata dal conto alla rovescia. | Target previsto; la disponibilità finale richiede un avviso di rilascio xAI e un endpoint attivo. |
Specifiche di Grok 4.7: informazioni confermate vs non confermate
Il modo più utile di leggere le informazioni attuali su Grok 4.7 è separare le dichiarazioni dirette dei fondatori dalle specifiche che xAI non ha pubblicato. Il nuovo post conferma solo il nome del modello e un conto alla rovescia; non aggiunge parametri tecnici o risultati di benchmark.
| Specifica | Stato attuale di Grok 4.7 | Livello di evidenza |
|---|---|---|
| Tempistiche di rilascio | Intorno al 12 settembre, dedotto dal conto alla rovescia di 10 giorni | Target annunciato dal fondatore |
| Scala del modello | Circa 2,1T parametri | Dichiarato dal fondatore |
| Training iniziale | Descritto come completo al 12 agosto | Dichiarato dal fondatore |
| Training supplementare | Include una quantità significativa di dati aziendali SpaceX | Dichiarato dal fondatore |
| Qualità relativa | Si afferma sia significativamente migliore di Grok 4.6 | Affermazione non verificata |
| Efficienza dei token | Si afferma un miglioramento rispetto a Grok 4.6 | Affermazione non verificata |
| Velocità di serving | Prevista leggermente più lenta | Dichiarato dal fondatore |
| Finestra di contesto | Non pubblicata da xAI | Sconosciuto |
| Modalità I/O | Non pubblicate da xAI | Sconosciuto |
| ID finale del modello API | Non confermato nella documentazione xAI | Sconosciuto |
| Prezzi ufficiali | Non pubblicati da xAI | Sconosciuto |
| Benchmark ufficiali | Nessuno pubblicato per Grok 4.7 | Sconosciuto |
L’affermazione sui circa 2,1T parametri non divulga parametri attivi, sparsità, routing degli esperti, costo di inferenza o compute effettivo di training. Il numero di parametri da solo non può stabilire la qualità in produzione.
Perché il segnale di training da SpaceX potrebbe contare più di 2,1T
La divulgazione più significativa potrebbe essere l’integrazione di dati aziendali SpaceX. Un corpus ingegneristico di alta qualità potrebbe migliorare ragionamento tecnico, design, debugging, ottimizzazione e lavoro agentico di lungo orizzonte, ambiti in cui la distribuzione dei task e la qualità del post-training spesso contano più della pura scala.
Questa direzione è coerente con la strategia dei modelli rilasciati da xAI. Il rapporto di training di Grok 4.6 descrive un run supplementare più lungo con dati ingegneristici di alta qualità, seguito da fine-tuning supervisionato e reinforcement learning su coding, STEM, sviluppo web, ottimizzazione del kernel e progettazione assistita dal computer.
Questo rende l’affermazione su Grok 4.7 tecnicamente plausibile, non provata. Un vantaggio reale dovrebbe diventare visibile dopo il rilascio in test ingegneristici riproducibili, tassi di completamento dei task, latenza e costo per risultato riuscito.
Grok 4.7 vs Grok 4.6: cosa mostra il baseline
Non esistono ancora punteggi ufficiali per Grok 4.7. Il punto di confronto responsabile è la valutazione del Grok 4.6 rilasciato da xAI. La panoramica completa del modello appare nell’approfondimento su Grok 4.6 di CometAPI; la tabella seguente mantiene solo le righe di benchmark più rilevanti per le decisioni.
| Valutazione ufficiale | Grok 4.6 High | Grok 4.5 High | GPT-5.6 Sol Max | Claude Fable 5 Max |
|---|---|---|---|---|
| AA Intelligence Index | 61 | 56 | 61 | 62 |
| GDPVal-AA v2 | 1753 | 1526 | 1728 | 1741 |
| CursorBench v3.2 | 69.9% | 66.7% | 67.2% | 70.5% |
| DeepSWE v1.1 | 65.9% | 54.0% | 73.0% | 70.0% |
| FrontierCode v1.1 (Extended) | 61.3% | 56.6% | 60.6% | 63.6% |
| Terminal-Bench v3.0 | 26.0% | 15.7% | 34.6% | 34.1% |
Risultato baseline: Grok 4.6 mostra un vantaggio reale su Grok 4.5 in ogni riga mostrata. Eguaglia GPT-5.6 Sol sull’indice di intelligenza complessivo, guida questo gruppo su GDPVal-AA v2 e supera leggermente GPT-5.6 Sol su FrontierCode. I suoi principali gap pubblicati restano DeepSWE e Terminal-Bench.
Questi risultati fissano uno standard concreto per Grok 4.7. Se il modello più grande e il training supplementare orientato all’ingegneria si trasferiscono alla produzione, l’avanzamento atteso sarebbe un coding a livello di repository e un completamento dei task da terminale più solidi, senza perdere la forza di Grok 4.6 nel lavoro di conoscenza. Un obiettivo ambizioso credibile è diventare competitivo con il Claude Fable 5.1 rilasciato su coding e workflow agentici di lunga durata. Si tratta di una previsione da testare, non di un claim di benchmark attuale.
Grok 4.7 vs Grok 4.6: progressi attesi e indicazioni per l’upgrade
I segnali trapelati e dichiarati dai fondatori suggeriscono cinque aree in cui Grok 4.7 potrebbe migliorare. Poiché xAI non ha pubblicato dati di valutazione finali, ciascuna aspettativa dovrebbe essere convertita in un test di accettazione misurabile.
Coding a livello di repository
Grok 4.6 è già forte su CursorBench e FrontierCode, ma i suoi risultati su DeepSWE e Terminal-Bench lasciano margine visibile di miglioramento. Grok 4.7 dovrebbe dimostrare maggiore accettazione delle patch, meno regressioni e migliore recupero da riga di comando sugli stessi repository prima di sostituire la 4.6.
Affidabilità degli agenti su lungo orizzonte
Il segnale sui dati SpaceX e la direzione di training agentico di xAI suggeriscono un focus sul lavoro ingegneristico multi-stadio. Misurate workflow completati, chiamate agli strumenti fallite, retry, interventi umani e recupero dopo errori—non solo la qualità del testo finale.
Lavoro di conoscenza e ragionamento tecnico
Grok 4.6 guida già il set di confronto su GDPVal-AA v2. Grok 4.7 dovrebbe preservare tale vantaggio migliorando al contempo il transfer a revisioni di design, sintesi di ricerca, debugging, ottimizzazione e altri compiti tecnici complessi.
Efficienza dei token
Un modello più grande può comunque essere più economico per task riuscito se raggiunge risultati corretti in meno passaggi. Confrontate token di input totali, input in cache, token di output, retry e costo per lo stesso risultato accettato.
Compromessi di serving
Se Grok 4.7 è più lento, i guadagni di qualità devono superare la latenza. Registrate time to first token, throughput sostenuto, wall time per completare il task, tasso di errore e costo sotto concorrenza realistica.
Benchmark di Grok 4.7: 5 test per verificare un reale miglioramento rispetto a Grok 4.6
- Successo nell’ingegneria del software: misurate issue risolte, test superati, tasso di regressione e accettazione delle patch su repository rappresentativi.
- Affidabilità degli agenti su lungo orizzonte: tracciate workflow completati, failure nelle chiamate agli strumenti, retry, recupero e interventi umani su run multi-step.
- Transfer ingegneristico nel mondo reale: testate design, debugging, ottimizzazione, ragionamento scientifico e task legati al CAD con criteri di valutazione dichiarati.
- Efficienza dei token per task riuscito: confrontate token e spesa totali necessari per raggiungere lo stesso esito accettato.
- Latenza e costo sotto carico di produzione: valutate time to first token, throughput, wall time, tasso di errore e costo a concorrenza realistica.
Cosa dovrebbero fare gli sviluppatori prima del 12 settembre — e come si inserisce CometAPI
Checklist per gli sviluppatori pre-lancio
- Costruite un set di valutazione fisso tratto da workflow reali di coding, ricerca, ingegneria e agenti.
- Eseguite il set contro Grok 4.6 e registrate tasso di successo, retry, chiamate agli strumenti, latenza, token e costo totale.
- Mantenete la selezione del modello configurabile ed evitate di hardcodare un identificatore provvisorio di Grok 4.7.
- Seguite le note di rilascio di xAI e la pagina modello di CometAPI per la disponibilità confermata.
- Dopo il lancio, verificate contesto, modalità, controlli di ragionamento, prezzi, rate limit e ambito del rollout.
- Rieseguite lo stesso set di valutazione prima di spostare il traffico di produzione.
CometAPI fornisce un livello API unificato per accedere a più provider di modelli AI tramite un unico account e pattern di integrazione. Una pagina di tracking di Grok 4.7 è già disponibile. CometAPI integrerà Grok 4.7 non appena xAI lo rilascerà ufficialmente e sarà disponibile l’accesso in produzione.
Fino a quel momento, trattate qualsiasi identificatore, prezzo o campo di funzionalità pre-release come provvisorio. Prima di inviare traffico di produzione, confermate che la rotta sia live, che una richiesta reale abbia successo, che il modello restituito sia la versione prevista e che i prezzi attuali siano visibili nella console.
Prospettive di pricing di Grok 4.7 vs Grok 4.6
La tariffa standard pubblicata di Grok 4.6 è di $2 per 1 milione di token di input e $6 per 1 milione di token di output al di sotto della soglia di contesto lungo. Le note di rilascio di xAI elencano tariffe più alte per richieste oltre 200.000 token di prompt. Il pricing di Grok 4.7 non è stato annunciato ufficialmente.
| Base tariffaria pubblicata | Input / 1M | Output / 1M | Stato |
|---|---|---|---|
| Grok 4.6, prompt < 200K | $2 | $6 | Pubblicata |
| Grok 4.6, prompt > 200K | $4 | $12 | Tier long-context pubblicato |
| Grok 4.7 | Non annunciato | Non annunciato | Confermare dopo il lancio ufficiale |
Restano plausibili tre direzioni di prezzo: parità con Grok 4.6 per accelerare l’adozione, una fascia premium se il costo di serving è materialmente più alto, o tariffe separate per lunghezza del contesto e velocità. Si tratta di scenari di pianificazione, non di una previsione xAI.
Checklist per gli sviluppatori pre-lancio
- Costruite un set di valutazione fisso tratto da workflow reali di coding, ricerca, ingegneria e agenti.
- Eseguite il set contro Grok 4.6 e registrate tasso di successo, retry, chiamate agli strumenti, latenza, token e costo totale.
- Mantenete la selezione del modello configurabile ed evitate di hardcodare un identificatore provvisorio di Grok 4.7.
- Seguite le note di rilascio di xAI e la pagina modello di CometAPI per la disponibilità confermata.
- Dopo il lancio, verificate contesto, modalità, controlli di ragionamento, prezzi, rate limit e ambito del rollout.
- Rieseguite lo stesso set di valutazione prima di spostare il traffico di produzione.
Grok 4.7: cosa osservare in seguito
Quattro eventi trasformerebbero l’attuale conto alla rovescia in un lancio di prodotto verificabile: un post ufficiale di rilascio xAI; documentazione del modello che copra contesto, modalità e controlli di ragionamento; pricing finale dell’API e identificatori del modello; e benchmark o valutazioni di produzione riproducibili.
La domanda più utile sul lancio non è se 2,1T sembri grande. È se Grok 4.7 completi compiti ingegneristici e agentici difficili in modo più affidabile—e a un costo per risultato riuscito migliore—rispetto al baseline rilasciato.
FAQ
Quando si prevede il rilascio di Grok 4.7?
Il conto alla rovescia di dieci giorni del 2 settembre di Musk indica circa il 12 settembre 2026. Si tratta di un target dedotto, non di una data di calendario separata pubblicata da xAI.
Grok 4.7 è già stato lanciato?
Grok 4.7 è stato anticipato/annunciato pubblicamente ma non ha ancora ricevuto un pacchetto completo di documentazione ufficiale per API/modello.
Grok 4.7 è un modello da 2,1 trilioni di parametri?
Musk lo ha descritto come circa 2,1T parametri. xAI non ha ancora pubblicato un documento di architettura che confermi parametri attivi o dettagli di routing.
Grok 4.7 sarà migliore di Grok 4.6?
Musk ha affermato un miglioramento sostanziale, ma non esiste una tabella ufficiale di benchmark di Grok 4.7. Trattate l’affermazione come non verificata finché non saranno disponibili risultati riproducibili.
Grok 4.7 sarà disponibile tramite CometAPI?
Esiste già una pagina di tracking su CometAPI, ma disponibilità finale, identificatore, pricing e formati supportati vanno confermati dopo il lancio ufficiale.
Conclusione
La storia di Grok 4.7 è passata da una stima generica per l’inizio di settembre a un conto alla rovescia concreto. L’ultima dichiarazione di Musk indica circa il 12 settembre 2026, mentre post precedenti descrivono un modello di circa 2,1T e un training supplementare con una quantità significativa di dati aziendali SpaceX.
Si tratta di segnali pre-release insolitamente specifici, ma non sono una model card, una suite di benchmark o un contratto API. Gli sviluppatori dovrebbero mantenere Grok 4.6 come baseline misurabile, preparare ora una valutazione controllata e attendere che xAI e CometAPI confermino l’accesso in produzione prima di prendere decisioni su migrazione o budget.