
TL;DR
Grok Voice 3.0 è il modello speech-to-speech in tempo reale di xAI, rilasciato il 14 ottobre 2026. Il nome del modello API è grok-voice-3.0; al 3 novembre 2026, grok-voice-latest points to this version. Il comunicato di lancio indica sessioni voce a $0.08 al minuto ($4.80 all’ora). Combina conversazione, gestione delle interruzioni e uso di tool per assistenti vocali e customer support. Con Python di base, una chiave API xAI e la libreria websockets, puoi inviare un prompt e salvare una risposta parlata. Inizia con l’esempio qui sotto, poi aggiungi audio registrato, streaming dal microfono e strumenti business man mano che la tua applicazione cresce.
Key Takeaways
- Grok Voice 3.0 scambia voce e testo in tempo reale. La tua applicazione invia e riceve eventi di sessione via WebSocket per tutta la conversazione.
- Il primo test può essere un singolo turno text-to-audio. Una risposta riproducibile conferma che autenticazione e generazione audio funzionano prima di aggiungere un microfono.
- L’input audio richiede un formato coerente e un chiaro confine di turno. La tua applicazione può inviare audio PCM registrato con completamento manuale del turno o eseguire streaming dal microfono con rilevamento vocale lato server.
- La tua applicazione controlla le azioni business. Valida gli argomenti delle funzioni e i permessi dell’utente, esegue l’azione approvata e restituisce il risultato in modo che l’agente vocale possa continuare.
- Il tuo server conserva la chiave API permanente ed emette token temporanei per le connessioni dei client.
What Is Grok Voice 3.0?
Grok Voice 3.0 è un modello conversazionale vocale in tempo reale sviluppato da xAI, operante con il marchio SpaceX Super Intelligence. Accetta input vocali o testuali e può restituire audio e testo all’interno di una sessione in corso. Il modello è ottimizzato per casi d’uso di voice agent, piuttosto che come sostituto diretto dei modelli Grok solo testo.
Gli assistenti vocali tradizionali spesso concatenano riconoscimento vocale, un modello linguistico e sintesi vocale. Grok Voice espone invece una sessione speech-to-speech con comportamento conversazionale integrato e supporto ai tool. Questa architettura può semplificare il livello di orchestrazione dello sviluppatore, sebbene le applicazioni debbano comunque gestire acquisizione audio, trasporto, autorizzazioni, integrazioni business e monitoraggio.
La definizione del modello Grok Voice 3.0 identifica testo e audio come modalità di input e output. In questo tutorial, il primo checkpoint utile è una risposta riproducibile da uno script Python lato server.
Key Features and Capabilities of Grok Voice 3.0
- Sostenere una conversazione live: scambia voce e testo via WebSocket per tutta la sessione.
- Gestire le interruzioni: usa il rilevamento vocale lato server e interrompi la riproduzione in coda quando l’utente inizia a parlare.
- Usare strumenti business: collega le tue funzioni per attività come consultazione ordini e pianificazione.
Grok Voice 3.0 Benchmark Performance
Il rapporto ufficiale di lancio cita questi risultati di Artificial Analysis, datati 13 ottobre 2026:
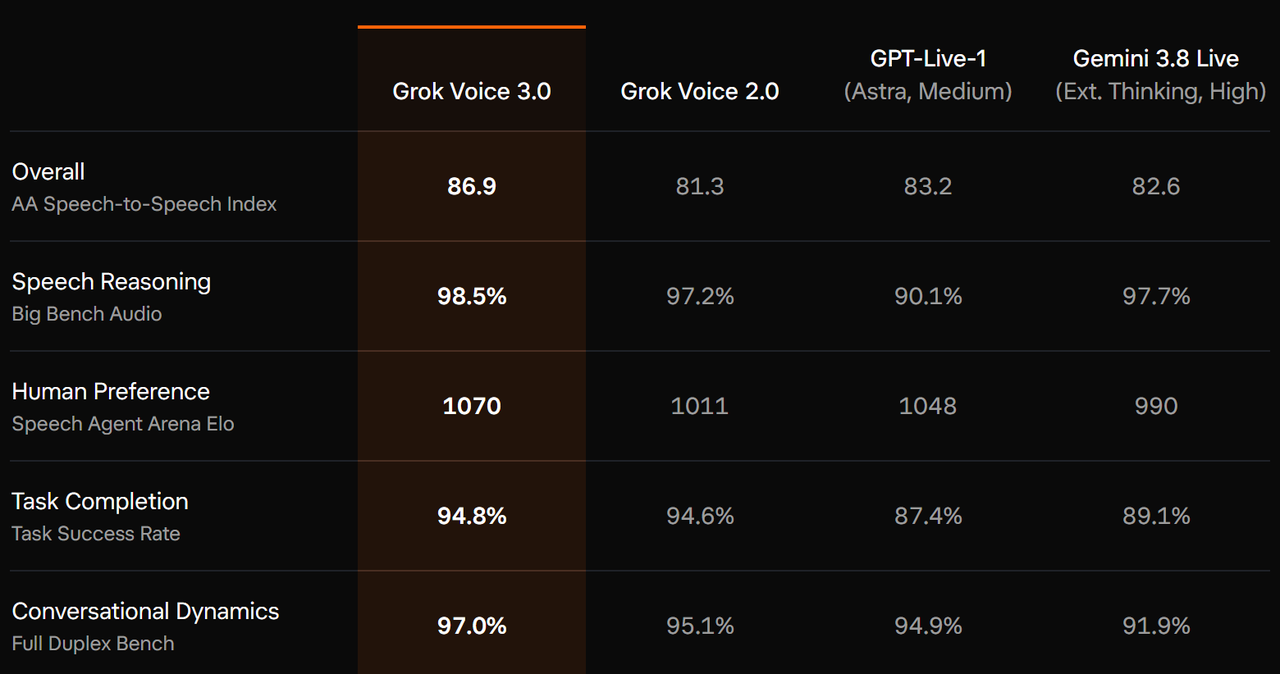
Si tratta di benchmark pubblicati, non di garanzie per il tuo deployment. Testa i tuoi accenti, le condizioni di rumore, i tool e i percorsi di escalation prima di usare l’agente con i clienti.
What Do You Need Before Calling the Grok Voice 3.0 API?
Crea o accedi a un account nella xAI Console, genera una chiave API e verifica che il tuo account abbia accesso e credito disponibile. Usa un terminale locale o un server affidabile per l’esempio in Python.
- Python 3.11 o successivo e pip disponibile nello stesso ambiente.
- Una chiave API xAI valida salvata come XAI_API_KEY.
- Una connessione di rete che consenta connessioni WebSocket sicure in uscita.
- Un media player per aprire il file WAV generato.
Genera una chiave nella xAI Console. Salvala in una variabile d’ambiente invece di inserirla hard-coded nell’applicazione.
Imposta la chiave API per il terminale Bash corrente.
export XAI_API_KEY="your_xai_api_key"
Su Windows PowerShell:
Imposta la chiave API per la sessione PowerShell corrente.
$env:XAI_API_KEY="your_xai_api_key"
Installa il client WebSocket nel tuo ambiente Python.
python -m pip install "websockets>=14,<18"
Esegui i comandi rimanenti nella stessa sessione di terminale. Se usi un ambiente virtuale, attivalo prima di installare il pacchetto.
How to Use the Grok Voice 3.0 API with Python
La Realtime API nativa usa una connessione WebSocket. Diversamente dalle comuni completions testuali, scambia eventi di sessione in corso e trasmette chunk audio mentre la conversazione è in progresso.
Step 1: Select a fixed model and configure the session
L’API accetta un nome modello versionato nell’URL del WebSocket. L’esempio usa grok-voice-3.0 così che la versione richiesta sia esplicita. Un evento session.update imposta la voce, il formato audio e la gestione manuale del turno; attendi session.updated prima di inviare il prompt.
Step 2: Send text and collect the spoken response
Salva il seguente script come grok_voice_demo.py. Invia un prompt testuale, raccoglie chunk audio codificati in base64 e scrive un file WAV mono, 24 kHz, PCM a 16 bit. Interrompe anche in caso di errori dell’API, completamento non riuscito o risposta che non produce audio.
Crea una risposta parlata da un prompt testuale e salvala come file WAV.
import asyncio, base64, json, os, wave
import websockets

SAMPLE_RATE = 24000

async def receive_event(ws):
    event = json.loads(await asyncio.wait_for(ws.recv(), 60))
    if event.get("type") == "error":
        raise RuntimeError(event)
    return event

async def main():
    url = "wss://api.x.ai/v1/realtime?model=grok-voice-3.0"
    headers = {"Authorization": f"Bearer {os.environ['XAI_API_KEY']}"}
    async with websockets.connect(url, additional_headers=headers) as ws:
        await ws.send(json.dumps({"type": "session.update", "session": {
            "voice": "eve", "turn_detection": {"type": None},
            "audio": {
                "input": {"format": {"type": "audio/pcm", "rate": SAMPLE_RATE}},
                "output": {"format": {"type": "audio/pcm", "rate": SAMPLE_RATE},
                           "transport": "json"}}}}))
        async with asyncio.timeout(30):
            while (await receive_event(ws)).get("type") != "session.updated":
                pass
        await ws.send(json.dumps({"type": "conversation.item.create", "item": {
            "type": "message", "role": "user",
            "content": [{"type": "input_text", "text": "Explain Grok Voice 3.0 briefly."}]}}))
        await ws.send(json.dumps({"type": "response.create"}))
        chunks = []
        async with asyncio.timeout(120):
            while True:
                event = await receive_event(ws)
                if event["type"] in ("response.output_audio.delta", "response.audio.delta"):
                    chunks.append(base64.b64decode(event["delta"]))
                elif event["type"] == "response.done":
                    if event.get("response", {}).get("status") != "completed":
                        raise RuntimeError(event)
                    break
    if not chunks:
        raise RuntimeError("The response contained no audio.")
    with wave.open("grok_response.wav", "wb") as wav:
        wav.setparams((1, 2, SAMPLE_RATE, 0, "NONE", "not compressed"))
        wav.writeframes(b"".join(chunks))
    print("Saved grok_response.wav")

asyncio.run(main())
Step 3: Run the script and check the result
Esegui l’esempio vocale in Python.
python grok_voice_demo.py
Dopo una risposta riuscita, il terminale stampa Saved grok_response.wav. Apri quel file in un media player e verifica di sentire una risposta completa a velocità normale. Un file mancante o non riproducibile è un motivo per ispezionare gli eventi restituiti e la configurazione audio prima di aggiungere altre funzionalità.
La reference degli eventi realtime descrive l’acknowledgement della sessione e il ciclo di vita della risposta usati qui. Lo script attende l’intero turno prima di scrivere il file; un’applicazione vocale interattiva dovrebbe riprodurre i chunk audio man mano che arrivano.
How Do You Send Audio to Grok Voice 3.0?
Recorded audio with manual turn completion
Questo esempio usa un file WAV mono, 24 kHz, PCM a 16 bit. Grok Voice 3.0 supporta anche altri sample rate PCM, μ-law, A-law e Opus. Il formato effettivo deve corrispondere alla configurazione in session.update. Sostituisci solo il blocco conversation.item.create nello script precedente con lo snippet qui sotto. Mantieni la successiva chiamata response.create e il loop di ricezione esistente.
Sostituisci il blocco del messaggio testuale con un upload audio registrato all’interno di main().
with wave.open("request.wav", "rb") as source:
    if (
        source.getnchannels() != 1
        or source.getsampwidth() != 2
        or source.getframerate() != SAMPLE_RATE
        or source.getcomptype() != "NONE"
    ):
        raise ValueError("Use mono, 24 kHz, 16-bit PCM WAV audio.")
    pcm = source.readframes(source.getnframes())

if len(pcm) < SAMPLE_RATE * 2 // 10:
    raise ValueError("Use a spoken recording longer than 100 ms.")

for offset in range(0, len(pcm), 4800):
    await ws.send(json.dumps({
        "type": "input_audio_buffer.append",
        "audio": base64.b64encode(pcm[offset:offset + 4800]).decode("ascii"),
    }))
await ws.send(json.dumps({"type": "input_audio_buffer.commit"}))
while (await receive_event(ws)).get("type") != "input_audio_buffer.committed":
    pass
Indenta questa sostituzione allo stesso livello del blocco di messaggi testuali originale, all’interno del contesto WebSocket. Invia campioni PCM grezzi dal file WAV, non l’header del contenitore WAV. Il primo script seleziona esplicitamente la gestione manuale del turno, quindi il commit del buffer e la richiesta della risposta sono azioni separate.
Live microphone capture and immediate playback
Per una conversazione interattiva, acquisisci audio in continuo, convertilo nel formato di input configurato e invia chunk brevi mentre un loop di ricezione separato gestisce le risposte. Seleziona server_vad per il rilevamento automatico del turno invece della modalità manuale usata nell’esempio con file registrato. Evita di aggiungere una seconda response.create quando il server sta già creando la risposta.
In caso di interruzione, interrompi prontamente la riproduzione audio in coda. La sola cancellazione di rete non rimuove l’audio già bufferizzato dalla tua applicazione. Mantieni la coda di riproduzione piccola e traccia quanta parte dell’audio l’ascoltatore ha effettivamente sentito, così la tua applicazione può mantenere coerente lo stato della conversazione.
How to Add Tools to a Grok Voice 3.0 Agent?
Le applicazioni possono esporre tool come consultazione ordini, pianificazione o verifica account. L’agente può interpretare una richiesta vocale complessa, chiamare una funzione autorizzata e usare il risultato per proseguire. Questo è particolarmente utile quando un cliente richiede più modifiche correlate in una sola chiamata.
L’API supporta funzioni personalizzate e tool gestiti dal server. Per una funzione personalizzata, la tua applicazione implementa l’azione; definire un tool non collega di per sé il modello al tuo database.
- Dichiara il nome della funzione, la descrizione e lo schema JSON degli argomenti in session.tools.
- Gestisci response.function_call_arguments.done, analizza gli argomenti e valida i permessi del chiamante prima di eseguire la funzione.
- Restituisci il risultato come evento conversation.item.create con item.type impostato a function_call_output e il call_id corrispondente.
- Invia response.create dopo che i risultati delle funzioni richieste sono stati inviati. Se più chiamate arrivano insieme, restituisci tutti i loro risultati prima di chiedere al modello di continuare.
Inizia con un tool in sola lettura, ad esempio il controllo dello stato di consegna di un ordine. Per azioni che modificano prenotazioni, emettono rimborsi o effettuano ordini, applica controlli d’identità, conferma e protezione da richieste duplicate nell’applicazione.
How to Use Grok Voice 3.0 in Browser and Mobile Apps
Usa credenziali effimere per le connessioni lato client. Il tuo server richiede un token di breve durata con la sua chiave API permanente e passa il token al client. Autentica le richieste al tuo endpoint di token e applica limiti d’uso così che non diventi un gateway senza restrizioni.
Mantieni visibili nell’interfaccia il consenso al microfono, i controlli di registrazione e lo stato della connessione. Gestisci esplicitamente la perdita di connessione: interrompi la riproduzione obsoleta, informa l’utente che la connessione si sta ripristinando ed evita di ripetere azioni che potrebbero essere già state completate.
How to Troubleshoot Common Grok Voice 3.0 API Errors
- Authentication failure: verifica che XAI_API_KEY sia impostata nel terminale che esegue lo script e che la chiave appartenga a un account con accesso. Non incollare la chiave nei log o nei messaggi di supporto.
- Unexpected client-library arguments: verifica che pip abbia installato la versione di websockets richiesta nell’ambiente Python usato per eseguire lo script.
- No audio output: ispeziona gli eventi di errore e response.done, conferma che session.updated abbia riconosciuto la configurazione e verifica che sia stata richiesta una risposta per il turno manuale.
- Distorted playback: confronta i byte effettivi con il codec, il sample rate, il numero di canali e l’header WAV configurati. Rinominare un file MP3 in WAV non lo converte.
- controlla l’accesso di rete e lo stato del servizio, poi ispeziona l’ultimo evento riuscito. Ritenta una connessione fallita separatamente da qualsiasi azione business che potrebbe essere già stata eseguita.
What Should You Budget for Grok Voice 3.0 API Calls?
L’uso della voce e le integrazioni personalizzate possono generare addebiti separati. Per questo tutorial, le tariffe pubblicate rilevanti sono la sessione realtime e gli input testuali; servizi di trascrizione e generazione vocale standalone sono servizi separati.
- Sessione speech-to-speech: $0.08 al minuto, equivalenti a $4.80 all’ora.
- Input testuale durante una sessione vocale: $0.004 per input testuale.
Tariffe verificate il 29 ottobre 2026. Consulta la pagina ufficiale dei prezzi per le tariffe aggiornate.
Ad esempio, 500 minuti di sessione fatturabili corrispondono a $40 in addebiti voce di base. Questa stima esclude input testuali, tool opzionali, telefonia e la tua infrastruttura. Inizia con sessioni di test brevi e chiudi le connessioni inattive quando la conversazione termina.
Conclusion
Inizia con un turno completo dell’API Grok Voice 3.0: connettiti, configura la sessione, invia un prompt, ricevi l’audio e riproduci il risultato. Una volta che questo percorso funziona, aggiungi parlato registrato, poi costruisci acquisizione dal microfono e riproduzione in streaming attorno ad esso. Introduci i tool business solo dopo che le vie conversazionali e di gestione errori sono affidabili.