
TL;DR
MiniMax M3.1 Flash è un modello di IA ad alta velocità progettato per agenti autonomi, ingegneria del software, uso del computer e automazione di workflow complessi. Rilasciato ufficialmente il 19 ottobre 2026, combina una finestra di contesto da 1 milione di token con una profondità di ragionamento configurabile e costi di inferenza inferiori.
MiniMax riporta fino a oltre 200 token di output al secondo, una riduzione del 70% dei costi di carico di lavoro degli agenti rispetto al predecessore e prestazioni competitive su Automation-Bench, DeepSWE e OSWorld. A $0.15 per milione di token di input e $0.60 per milione di token di output, il modello rende più economici i workflow di agenti IA multi-step.
Punti chiave
- Prestazioni di MiniMax M3.1 Flash: i benchmark riportati dal fornitore includono Automation-Bench 62.8, DeepSWE v1.1 73.7 e OSWorld 2.0 61.7, evidenziando le capacità in automazione degli agenti, coding e uso del computer.
- Prezzi API di MiniMax M3.1 Flash: le tariffe ufficiali sono $0.15/M per l’input, $0.60/M per l’output e $0.015/M per l’input in cache. Le tariffe CometAPI sono $0.80/M per l’input e $3.20/M per l’output al 21 ottobre 2026, senza tariffa cache pubblicata sulla pagina del modello.
- Velocità di inferenza di MiniMax M3.1 Flash: MiniMax riporta oltre 200 token/s in condizioni favorevoli e una throughput P50 superiore a 170 token/s, supportando workflow di agenti reattivi.
- Efficienza degli agenti con MiniMax M3.1 Flash: cinque livelli di sforzo di ragionamento consentono agli sviluppatori di bilanciare completamento dei task, latenza e costi complessivi degli agenti IA.
- Accesso all’API di MiniMax M3.1 Flash: gli sviluppatori possono accedere al modello rilasciato tramite MiniMax o esplorare l’integrazione con CometAPI utilizzando identificatori di modello e prezzi specifici del provider.
Che cos'è MiniMax M3.1 Flash?
MiniMax M3.1 Flash è un modello linguistico di nuova generazione ottimizzato per ragionamento agentico, coding, uso di strumenti ed esecuzione autonoma di workflow. MiniMax ha presentato ufficialmente M3.1 Flash il 19 ottobre 2026.
Invece di concentrarsi esclusivamente sull’intelligenza conversazionale o su punteggi isolati, punta al costo totale di completamento dei task attraverso ragionamento ripetuto, chiamate a strumenti ed esecuzioni multi-step. MiniMax ha inoltre associato il suo sviluppo iniziale a Space Bunny, un modello distribuito in modo anonimo che, secondo quanto affermato, ha elaborato più di 200 trilioni di token prima dell’annuncio; si tratta di un dato di utilizzo dichiarato, non di un conteggio pubblicato dei token di training.
Per gli sviluppatori che costruiscono assistenti di coding autonomi, colleghi aziendali IA e agenti basati su browser, M3.1 Flash offre tre vantaggi rilevanti: ampia capacità di contesto, generazione rapida e uso di token economico.
Quali sono le specifiche di MiniMax M3.1 Flash?
| Specifiche API | MiniMax M3.1 Flash |
|---|---|
| Sviluppatore | MiniMax |
| Rilascio ufficiale | 19 ottobre 2026 |
| Famiglia di modelli | MiniMax M3 |
| Finestra di contesto | 1,000,000 token |
| Capacità principali | Automazione agenti, coding, ragionamento, uso del computer |
| Modalità di input | Testo, immagini e video tramite l’API compatibile con OpenAI di MiniMax; confermare supporto presso altri provider |
| Modalità di output | Testo |
| Controlli di ragionamento | Low, medium, high, xhigh, max |
| Velocità di output riportata | Fino a oltre 200 token/s |
| Velocità P50 riportata | 170+ token/s |
| Canali di accesso | MiniMax API, M Plan, MiniMax Code |
| Pesi aperti | Annunciati per un rilascio futuro |
| Numero di parametri specifico di M3.1 | Non indicato nell’annuncio |
Una grande finestra di contesto è utile per il coding a livello di repository e i workflow ricchi di documenti, ma non garantisce un richiamo perfetto. Gli agenti in produzione dovrebbero comunque usare retrieval selettivo, risposte strutturate degli strumenti e compressione del contesto.
Cinque impostazioni di sforzo di ragionamento consentono agli sviluppatori di riservare calcolo intensivo a pianificazione complessa e debugging, invece di spendere il massimo sforzo per ogni classificazione, estrazione o semplice step di selezione degli strumenti. Poiché una singola richiesta a un agente può attivare decine di invocazioni del modello, piccoli risparmi sui passaggi di routine possono ridurre in modo sostanziale il costo totale.
Come si comporta MiniMax M3.1 Flash nei benchmark?
MiniMax riporta risultati su benchmark che coprono automazione aziendale, ingegneria del software, uso del computer, cybersicurezza e ragionamento multimodale. Si tratta di valutazioni riportate dal fornitore, non di un sostituto dei test indipendenti su una reale distribuzione.
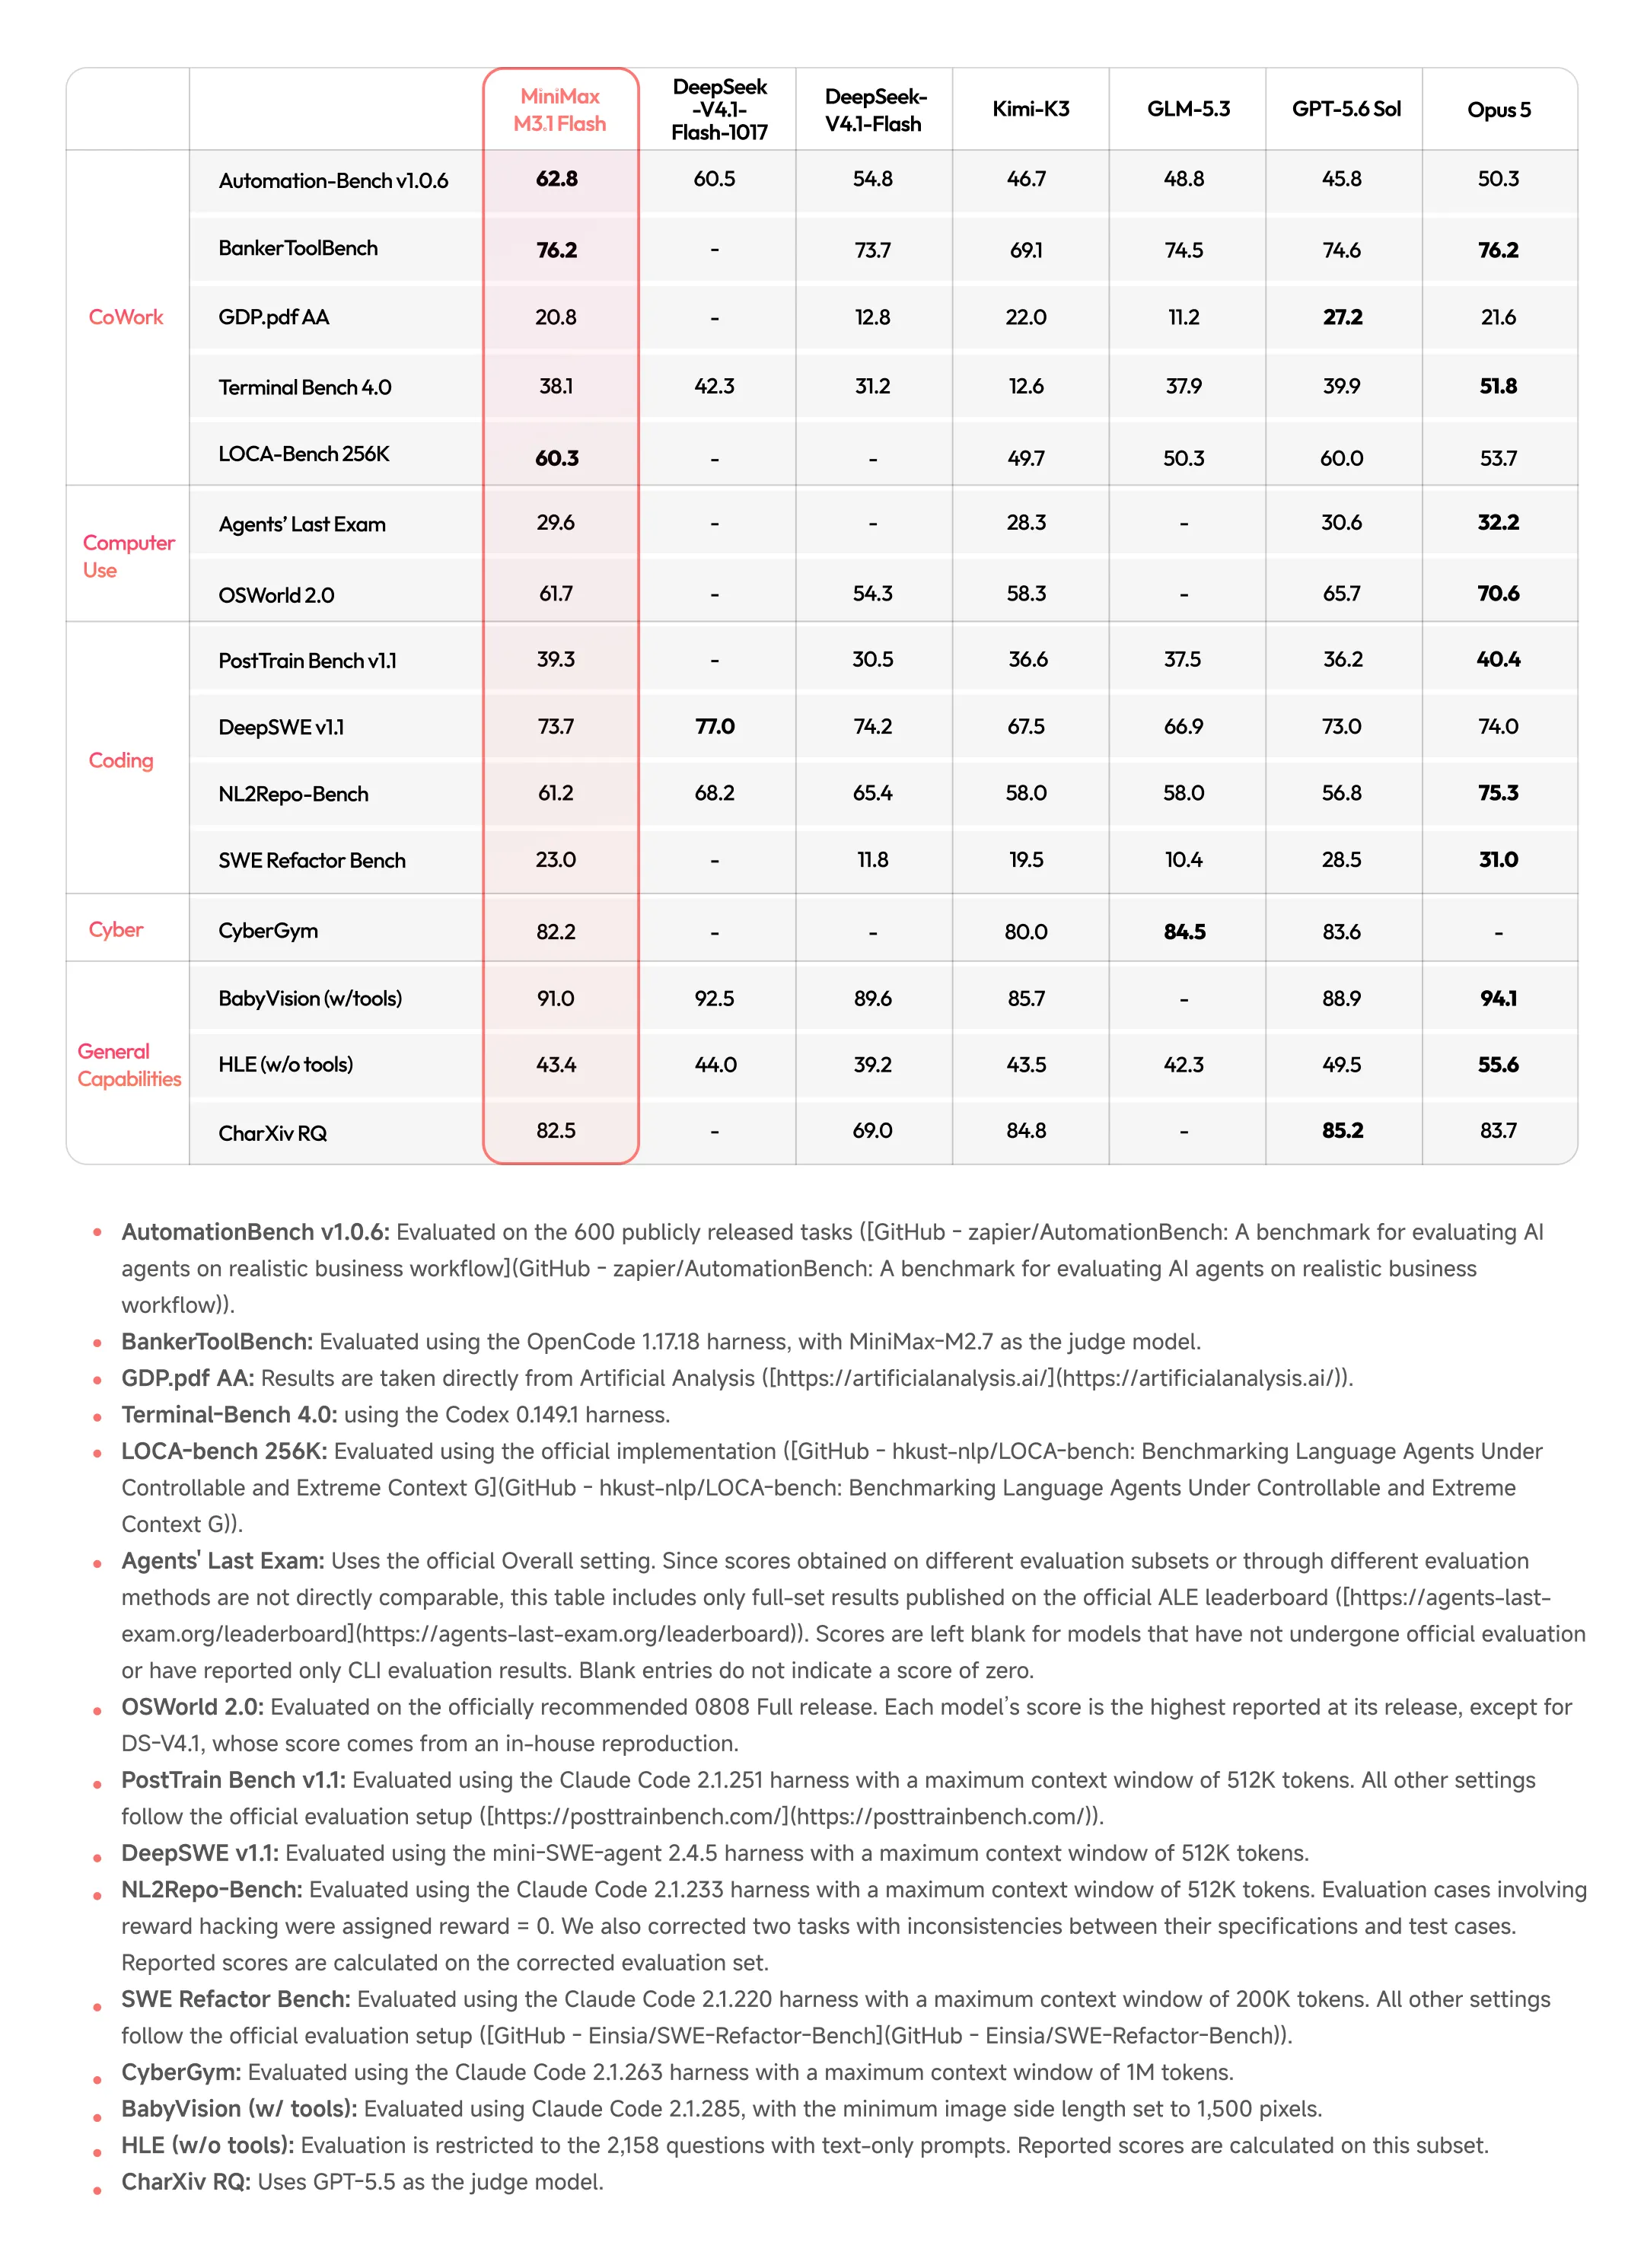
Confronto ufficiale dei benchmark di MiniMax, incluse note di valutazione. I punteggi sono riportati dal fornitore e non rappresentano un test indipendente uniforme.
| Risultati benchmark ufficiali | M3.1 Flash | Che cosa misura |
|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | Automazione aziendale multi-step |
| BankerToolBench | 76.2 | Ragionamento finanziario e strumenti |
| LOCA-Bench 256K | 60.3 | Esecuzione agente a lungo contesto |
| DeepSWE v1.1 | 73.7 | Ingegneria del software autonoma |
| Terminal Bench 4.0 | 38.1 | Problem solving su terminale |
| OSWorld 2.0 | 61.7 | Interazione con desktop/computer |
| Agents’ Last Exam | 29.6 | Task economici complessi |
| CyberGym | 82.2 | Problem solving in cybersicurezza |
| BabyVision with tools | 91.0 | Ragionamento visivo con strumenti |
| HLE without tools | 43.4 | Conoscenza e ragionamento impegnativi |
Automation-Bench v1.0.6 usa 600 task pubblici. BankerToolBench usa OpenCode 1.17.18 con MiniMax-M2.7 come giudice; Terminal Bench 4.0 usa Codex 0.149.1. DeepSWE v1.1 usa mini-SWE-agent 2.4.5 con un limite di contesto a 512K. OSWorld usa la release 0808 Full: la tabella combina il punteggio più alto di ciascun modello, tranne DeepSeek V4.1, che MiniMax ha riprodotto internamente. Queste configurazioni differenti limitano conclusioni dirette tra modelli.
Per l’automazione aziendale, dare priorità ad Automation-Bench e BankerToolBench; per agenti di coding, esaminare DeepSWE e i risultati basati su terminale. OSWorld valuta interazioni con un ambiente computerizzato anziché generare meri set di istruzioni. Un singolo punteggio aggregato non può sostituire un’analisi specifica per il task.
Quanto è veloce MiniMax M3.1 Flash?
I sistemi di agenti effettuano spesso molte chiamate modello sequenziali, quindi la sola throughput non descrive la reattività.
| Metrica di velocità | Prestazioni riportate |
|---|---|
| Throughput di output di picco quotidiano | 200+ token/s |
| Throughput mediano di output (P50) | 170+ token/s |
| Miglioramento inferenza online | Quasi 3× vs generazione precedente |
| Riduzione costo carico lavoro agenti | 70% vs predecessore |
Queste velocità e riduzioni dei costi di carico lavoro sono riportate dal fornitore e descrivono la valutazione al lancio di MiniMax, non throughput o risparmi garantiti per ogni applicazione. Hardware di serving, concorrenza, lunghezza dei prompt e variabilità tra esecuzioni non sono completamente specificati nell’annuncio.
La latenza end-to-end include anche ritardo del primo token, overhead di ragionamento, tempo degli strumenti, retry e dipendenze tra step. Un generatore più veloce può perdere il vantaggio se un agente necessita di più chiamate per completare lo stesso task.
Quanto costa l’API di MiniMax M3.1 Flash?
MiniMax ha annunciato tariffe standard piatte per M3.1 Flash senza un livello separato a lungo contesto nella descrizione iniziale dei prezzi. Nel frattempo, la Preview API di MiniMax M3.1 Flash su CometAPI offre una struttura di prezzi separata con uno sconto del 20% rispetto alle tariffe di riferimento visualizzate.
| Categoria di prezzo | M3.1 Flash ufficiale | CometAPI Preview (≤512K) | CometAPI Preview (>512K) |
|---|---|---|---|
| Token di input / 1M | $0.15 | $0.24 | $0.48 |
| Token di output / 1M | $0.60 | $0.96 | $1.92 |
| Input in cache / 1M | $0.02 | $0.05 | $0.10 |
| Struttura prezzi | Tariffa piatta | Livello short-context | Livello long-context |
I prezzi ufficiali dell’API MiniMax rendono M3.1 Flash particolarmente interessante per i carichi di lavoro degli agenti. I token di output costano quattro volte la tariffa standard di input, mentre l’input in cache costa un decimo. Istruzioni ripetute e storici degli strumenti possono quindi diventare un importante obiettivo di ottimizzazione.
I prezzi Preview di CometAPI partono da $0.24 per milione di token di input e $0.96 per milione di token di output, rappresentando uno sconto del 20% rispetto ai prezzi Preview di riferimento mostrati. Tuttavia, queste tariffe restano più alte dei nuovi prezzi ufficiali annunciati per M3.1 Flash perché le due offerte usano basi di prezzo diverse.
Per gli sviluppatori, la distinzione chiave è che CometAPI fornisce un’esperienza di integrazione unificata, mentre la release ufficiale offre attualmente tariffe per token pubblicate più basse. Prima della distribuzione, verificare la versione del modello attiva, il livello di lunghezza del contesto e le regole di fatturazione per stimare accuratamente il costo dei workflow di agenti autonomi.
Costo per task agente di MiniMax M3.1 Flash
Costo di inferenza stimato = (token di input non in cache × tariffa input + token di input in cache × tariffa cache + token di output × tariffa output) / 1,000,000.
| Carico di lavoro illustrativo | Input non in cache | Input in cache | Output | Costo stimato |
|---|---|---|---|---|
| Simple tool assistant | 10K | 0 | 2K | $0.0027 |
| Pull request review | 40K | 20K | 8K | $0.0111 |
| Multi-step coding agent | 100K | 200K | 30K | $0.0360 |
| Enterprise research | 300K | 700K | 80K | $0.1035 |
| Large autonomous workflow | 1M | 3M | 200K | $0.3150 |
Calcoli illustrativi, non fatturazione osservata. Presuppone che le letture in cache rientrino nella tariffa cache annunciata; esclude costi di strumenti, ricerca, browser, infrastruttura e revisione umana.
Sforzo di ragionamento e costo del task
L’analisi dei costi di Automation-Bench di MiniMax collega lo sforzo di ragionamento al successo nel benchmark e alla spesa di inferenza per task.
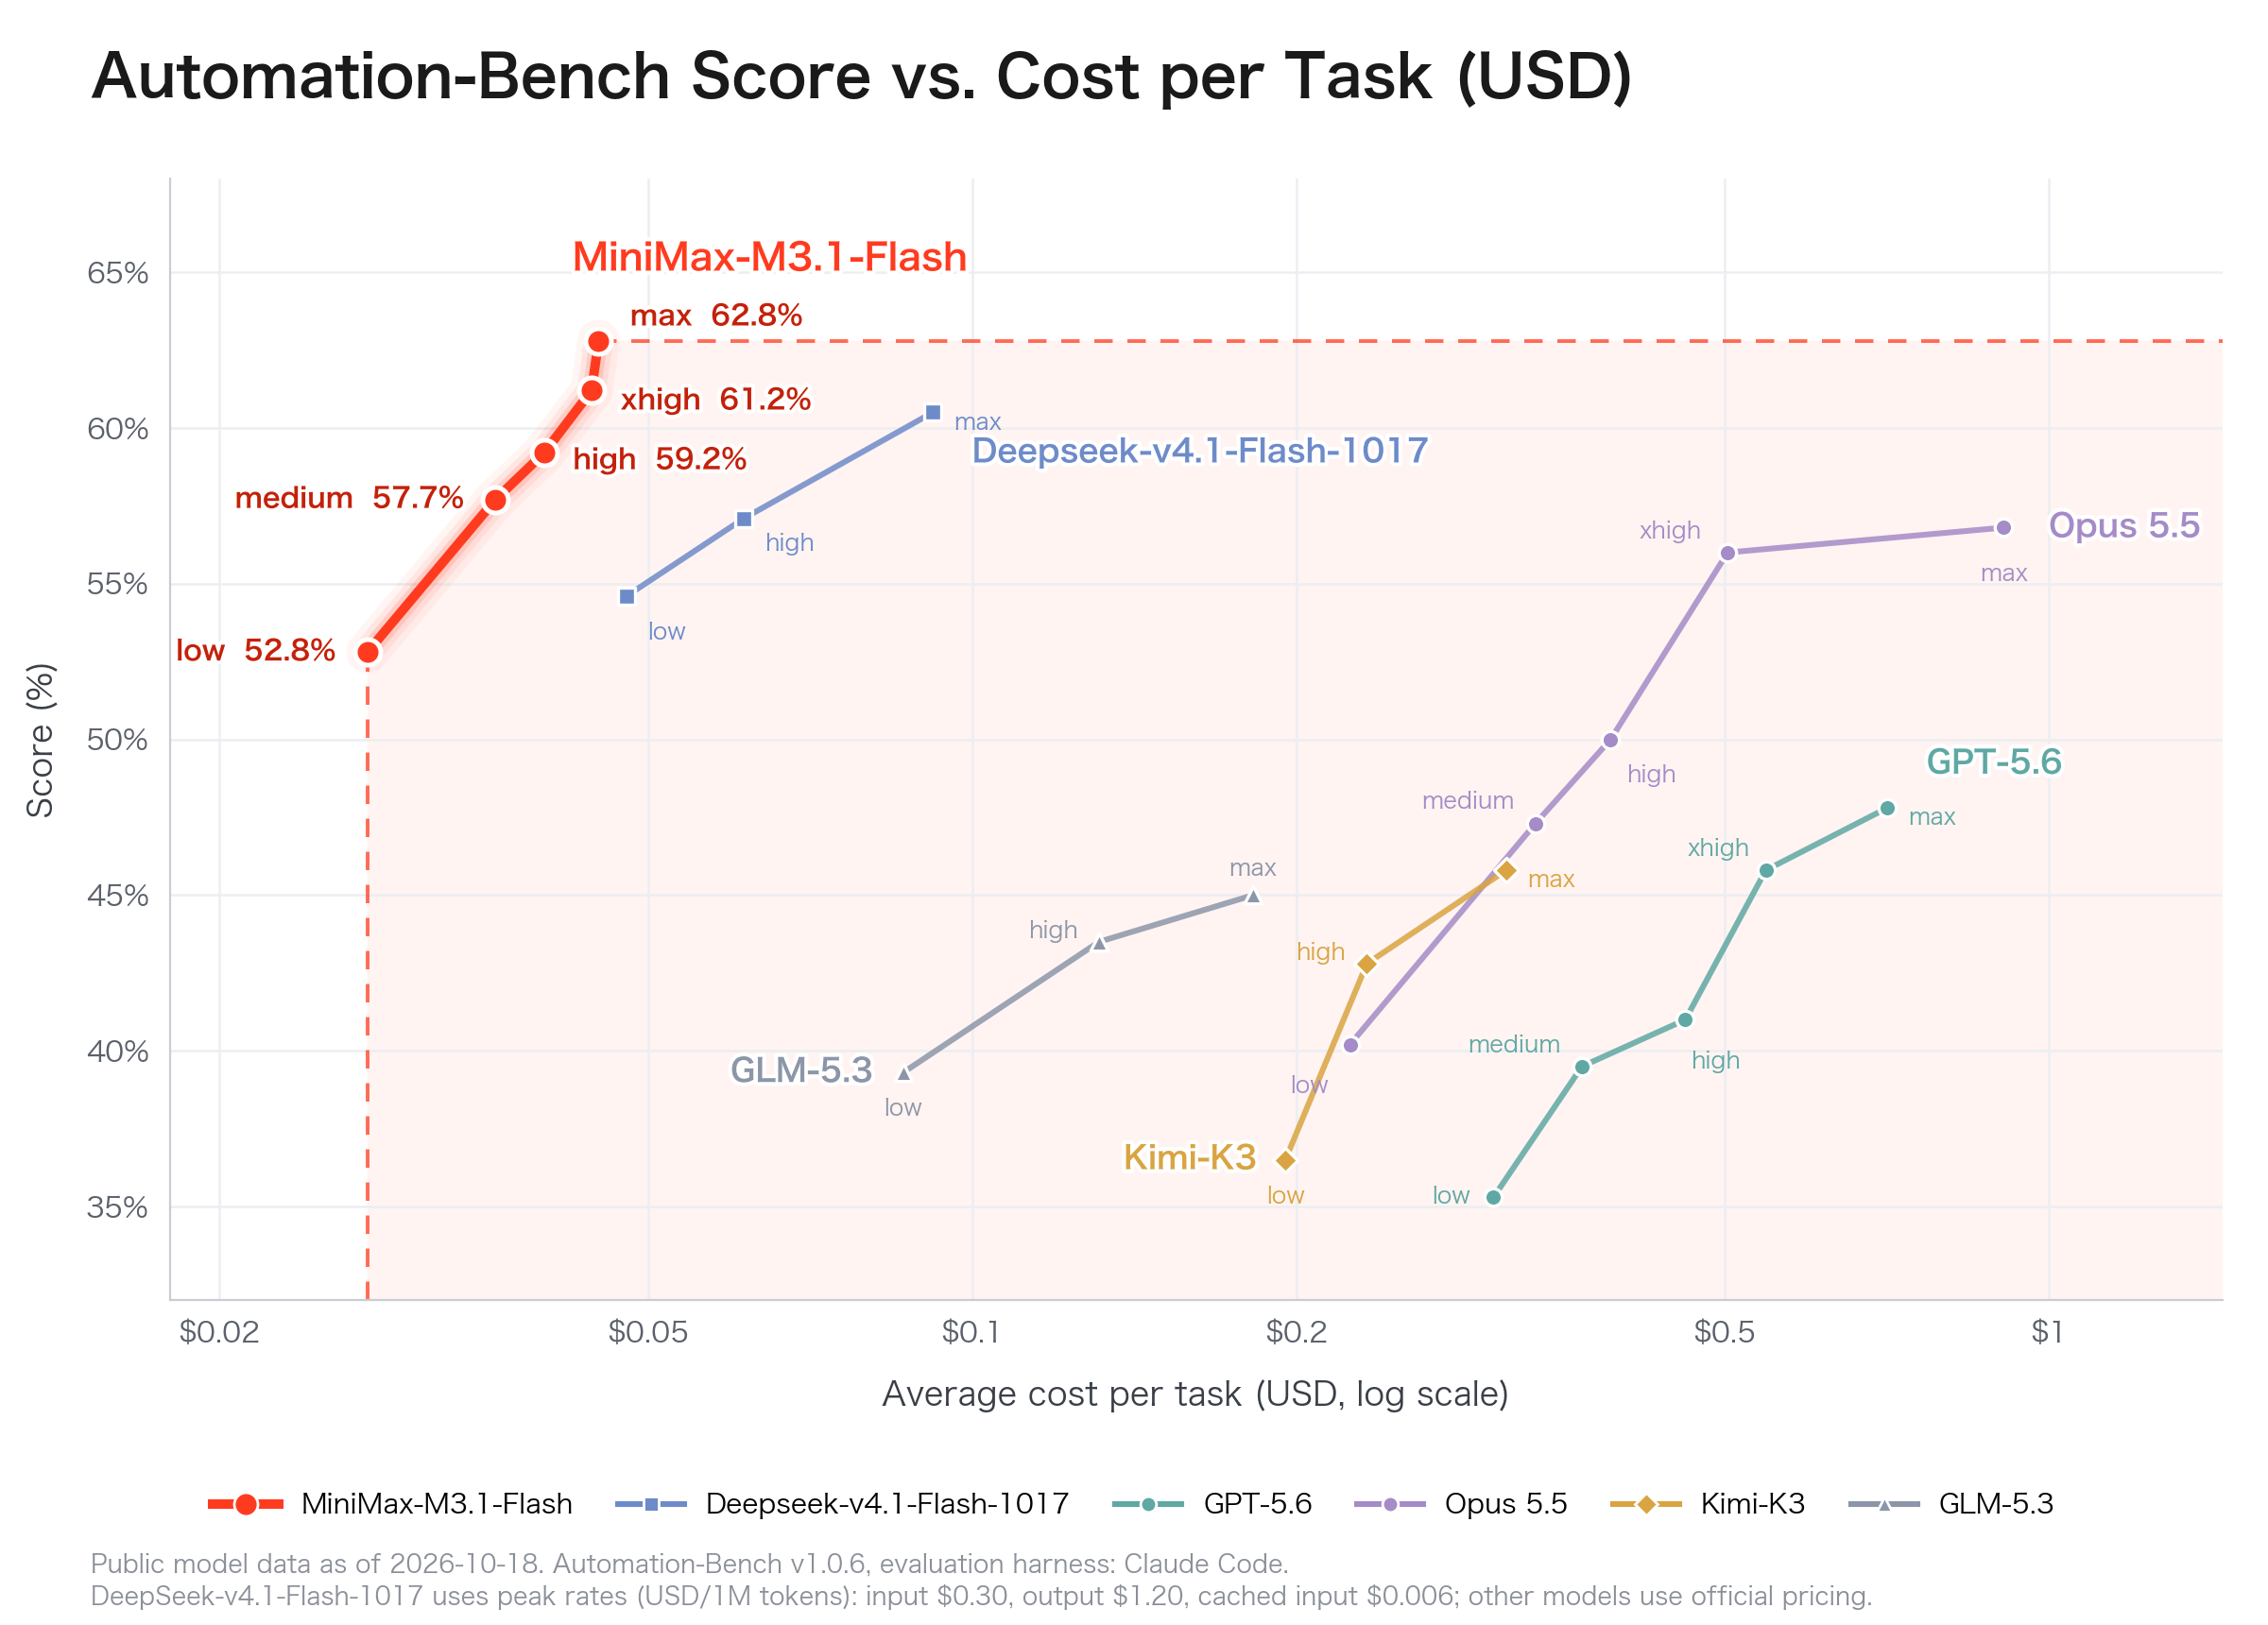
Grafico ufficiale di MiniMax su punteggio vs costo in Automation-Bench. L’asse orizzontale è logaritmico; i costi in dollari esatti non sono stampati per i singoli punti MiniMax.
Le note di valutazione del grafico ufficiale specificano Automation-Bench v1.0.6 con il harness Claude Code e dati pubblici dei modelli al 18 ottobre 2026. DeepSeek usa tariffe token di picco; gli altri modelli usano prezzi ufficiali. Dettagli hardware e intervalli di confidenza su esecuzioni ripetute non sono specificati.
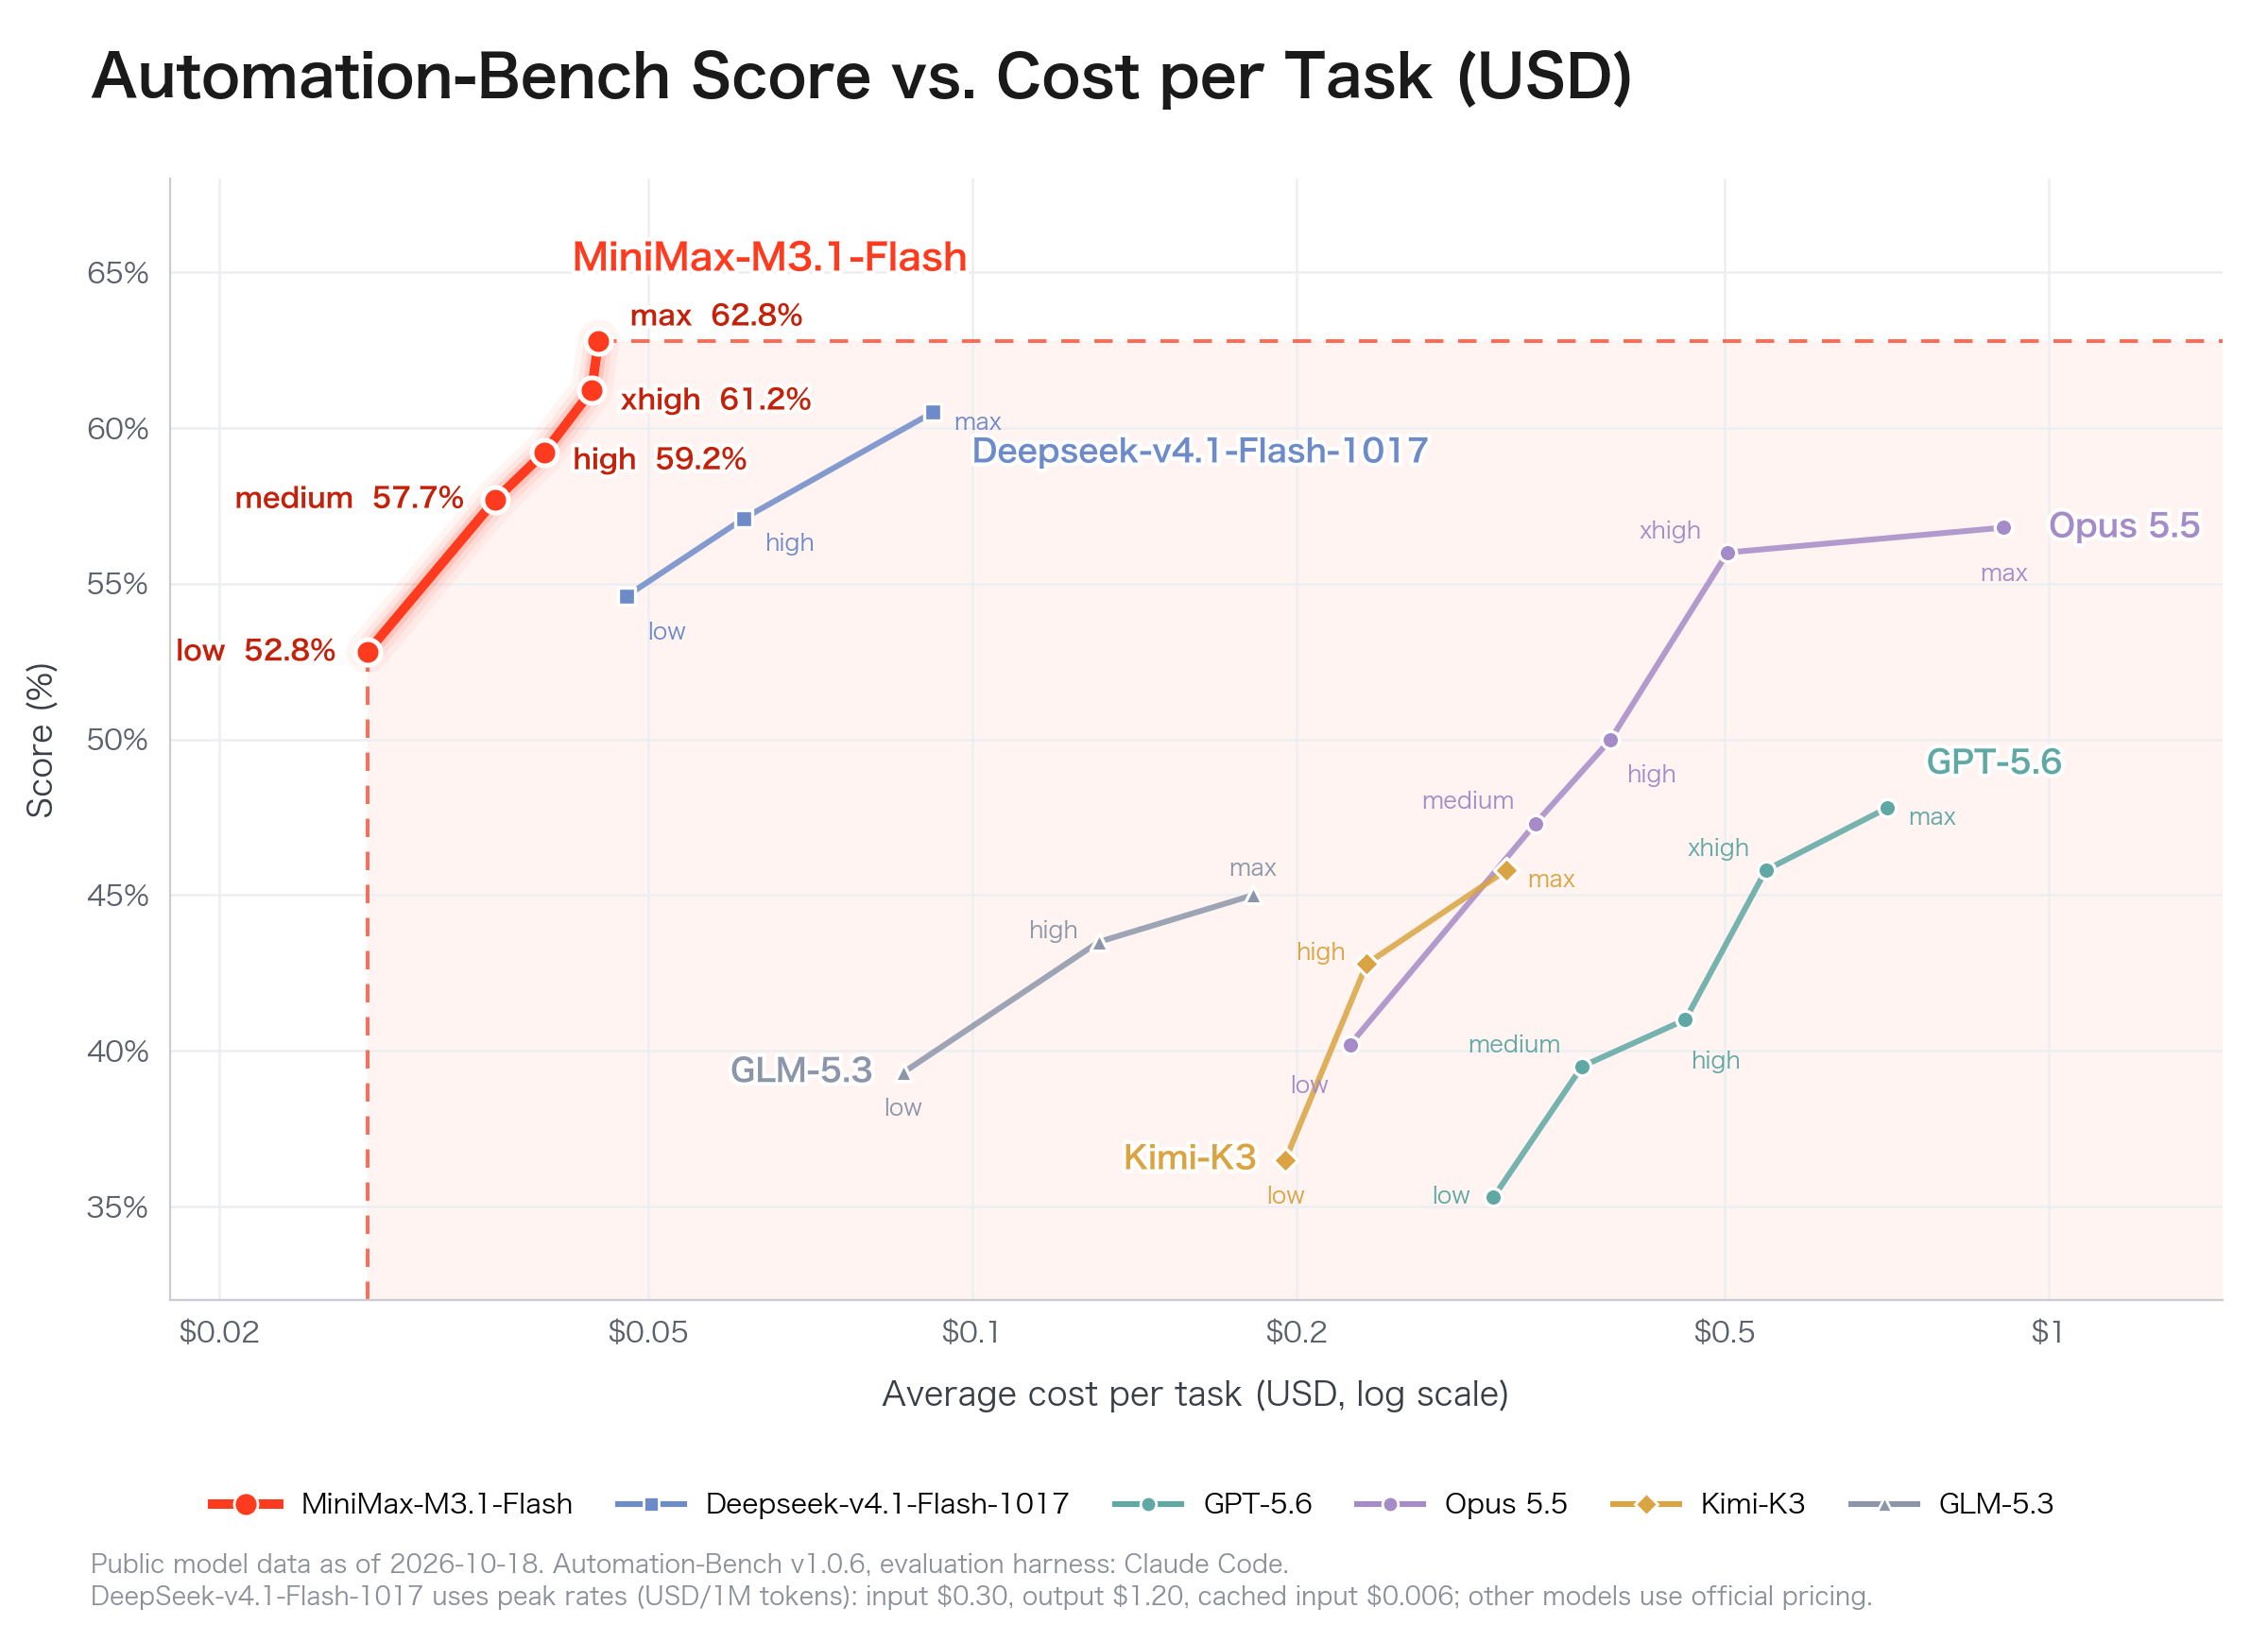
| Sforzo di ragionamento | Punteggio Automation-Bench etichettato |
|---|---|
| Low | 52.8% |
| Medium | 57.7% |
| High | 59.2% |
| Xhigh | 61.2% |
| Max | 62.8% |
L’attuale tabella di confronto ufficiale e il punto a sforzo massimo mostrano entrambi 62.8. La curva dei costi confronta le impostazioni di sforzo all’interno della configurazione del fornitore; non stabilisce un costo in dollari fisso per un agente in produzione.
Il punteggio etichettato cresce di 10 punti percentuali da low a max. In distribuzione, confrontare medium e livelli più elevati su un set di task fisso, contando tentativi falliti e retry nella spesa totale. Scegliere l’impostazione che raggiunge l’obiettivo di qualità al minor costo misurato per task accettato.
Come possono gli sviluppatori accedere a MiniMax M3.1 Flash tramite CometAPI?
Gli sviluppatori possono accedere alla API di MiniMax M3.1 Flash su CometAPI. Il catalogo pubblico verificato il 20 ottobre 2026 mostra l’ID modello minimax-m3.1-flash anche se l’URL mantiene un suffisso di anteprima. Usare l’ID modello disponibile per il proprio account, invece di derivare un identificatore API dall’URL della pagina.
Inviare una richiesta POST a https://api.cometapi.com/v1/chat/completions con Authorization: Bearer YOUR_COMETAPI_KEY e Content-Type: application/json. Nel body JSON, impostare model su minimax-m3.1-flash (se abilitato per il proprio account) e fornire un array messages. Consultare la documentazione di CometAPI per i dettagli della richiesta.
Perché usare CometAPI? La sua chiave API unificata, il formato di richiesta compatibile e la dashboard di utilizzo possono semplificare il lavoro tra diversi provider di modelli. Per MiniMax M3.1 Flash, valutare tale comodità di integrazione rispetto ai prezzi specifici del provider sopra riportati e verificare le funzionalità disponibili per il proprio account.
Quali agenti IA traggono maggior beneficio da MiniMax M3.1 Flash?
| Caso d’uso | Perché può essere adatto | Considerazione di distribuzione |
|---|---|---|
| Enterprise automation | Risultati solidi su Automation-Bench | Convalidare strumenti e retry |
| Coding assistants | Prestazioni competitive su DeepSWE | Eseguire test e rivedere patch |
| Customer support | Prezzi bassi per input e cache | Monitorare accuratezza |
| Research agents | Finestra di contesto da 1M | Verificare evidenze e fonti |
| Computer-use agents | Capacità su OSWorld | Gestire cambi UI e recovery |
| Security code review | Risultato su CyberGym | Verifica indipendente |
I benefici sono più forti quando un agente completa abbastanza task correttamente da compensare costi di retry, orchestrazione e revisione. L’uso in produzione dovrebbe misurare sia le prestazioni a livello di modello sia a livello di workflow.
MiniMax M3.1 Flash è la scelta con il miglior valore per gli agenti IA?
MiniMax M3.1 Flash è un’ottima opzione per agenti sensibili ai costi che coinvolgono contesto ripetuto e strumenti strutturati, ma il prezzo per token più basso non produce sempre il costo più basso per task riuscito. Chiamate fallite, retry aggiuntivi e intervento umano possono annullare i risparmi. Valutare tasso di completamento accettato, tempo end-to-end, costo totale per task riuscito e tasso di intervento umano.
FAQ
Perché MiniMax M3.1 Flash può restituire una risposta vuota?
Sull’API nativa compatibile con OpenAI di MiniMax, i token di thinking consumano il budget di generazione. Un limite troppo piccolo può terminare una richiesta con finish_reason impostato su length prima che venga prodotto testo di risposta visibile. Ispezionare la finish reason e l’uso dei token, aumentare il budget di completamento quando appropriato e gestire reasoning_content separatamente dalla risposta finale. Confermare la stessa semantica della risposta su una route di terze parti.
Come dovrebbe essere archiviata la cronologia delle chiamate agli strumenti di MiniMax M3.1 Flash?
Conservare il messaggio completo dell’assistente, incluse le chiamate agli strumenti e il reasoning content, prima di aggiungere i risultati degli strumenti corrispondenti. Salvare solo la risposta visibile può rimuovere informazioni necessarie per lo step successivo. Mantenere gli ID delle tool-call e l’ordine dei messaggi, e validare il comportamento in replay usando l’endpoint del provider effettivo. Le linee guida di MiniMax sulla cronologia conversazionale descrivono i requisiti dell’API nativa.
Come possono i team rilevare cambi di routing in MiniMax M3.1 Flash?
Mantenere una piccola suite di regressione con input fissi, struttura di output attesa e asserzioni sulle tool-call. Registrare l’ID del modello richiesto, l’identificatore di modello restituito quando presente, il provider, il timestamp e l’uso fatturato. Rieseguirla dopo aggiornamenti del provider; un alias stabile da solo non dimostra che il checkpoint o il comportamento sottostante siano invariati.
Come dovrebbe essere organizzata una migrazione a MiniMax M3.1 Flash?
Iniziare con task in sola lettura o riprodotti, quindi instradare una piccola quota di traffico live mantenendo un fallback testato. Definire soglie di rollback per chiamate a strumenti non valide, timeout e task non riusciti prima di aumentare il traffico. Esaminare esempi di regressioni invece di basarsi solo su punteggi medi, perché un piccolo numero di fallimenti costosi può superare i risparmi su token.
Conclusione
MiniMax M3.1 Flash migliora l’economia degli agenti IA autonomi grazie a token economici, ragionamento configurabile, un’ampia finestra di contesto e solidi risultati riportati in automazione e coding. Il suo vantaggio chiave è l’equilibrio tra prestazioni, latenza e costo per task, non la superiorità assoluta su ogni benchmark.
Gli sviluppatori dovrebbero convalidare i tassi reali di completamento dei workflow e i costi totali dell’agente, quindi scegliere la route MiniMax M3.1 Flash la cui configurazione attiva, funzionalità supportate e fatturazione corrispondano ai requisiti.