
TLDR MiniMax M4 non è stato rilasciato. MiniMax ha dichiarato pubblicamente un impegno per una nuova generazione dei suoi modelli della serie M (e Hailuo video) nella seconda metà del 2026. L’attuale flagship resta MiniMax M3 (lanciato il 1° giugno 2026: ~428B parametri totali / ~23B parametri attivi, contesto da 1M token tramite MiniMax Sparse Attention, multimodale nativo, pesi aperti, 59.0% su SWE-Bench Pro).
Un aggiornamento di efficienza a metà ciclo, Minimax M3.1 Flash, è stato lanciato il 19 ottobre 2026, offrendo un’inferenza circa 3× più veloce e ~70% di riduzione dei costi per agenti. Gli sviluppatori possono già accedere alla lineup MiniMax attiva (inclusi M3 e M3.1 Flash) tramite gateway unificati come CometAPI per un routing semplificato, monitoraggio e controllo dei costi.
Punti chiave
- MiniMax M4 non è rilasciato al 20 ottobre 2026. L’azienda ha solo confermato “una nuova generazione di modelli della serie M e Hailuo nella seconda metà del 2026.”
- Modelli in produzione attuali: MiniMax M3 (1° giugno 2026) e il modello focalizzato sull’efficienza M3.1 Flash (19 ottobre 2026).
- M3 ha introdotto MSA (MiniMax Sparse Attention) abilitando un contesto pratico da 1M token, comprensione nativa di immagini/video, forti punteggi su coding/agent e pesi aperti.
- M3.1 Flash privilegia velocità e costo (dichiara ~3× di velocità d’inferenza e 70% di costi per agenti in meno) mantenendo il contesto a 1M e input multimodali; i pesi aperti sono attesi poco dopo il lancio.
- Un report di luglio 2026 descriveva un’iniziativa interna da ~2,7 trilioni di parametri (chiamata internamente M3 Pro) con possibile rilascio open-weight già nel Q3 2026; non si è concretizzata pubblicamente ed è distinta dall’impegno più ampio per la “nuova generazione”.
- Migliorie attese per M4 (speculative, basate sulla traiettoria): ulteriori progressi su coding/agent, efficienza del lungo contesto affinata, capacità multimodali o di computer use più robuste, e prezzi aggressivi continuativi.
- Raccomandazione di accesso: utilizzare un gateway multi-provider come CometAPI per instradare il traffico su MiniMax M3/M3.1 Flash (e futuro M4) insieme ad altri modelli frontier con fatturazione, osservabilità e logiche di fallback unificate.
MiniMax M4 arriverà davvero presto?
Informazioni confermate
La domanda principale non è se MiniMax stia sviluppando futuri sistemi di AI, ma se ci siano prove concrete che un modello chiamato MiniMax M4 sia prossimo al rilascio.
MiniMax ha rilasciato M3 a giugno 2026 e ha lanciato ufficialmente M3.1 Flash il 19 ottobre 2026. Si tratta di un rilascio intermedio confermato, non di una prova di una roadmap M4. Annuncio di lancio ufficiale.
L’archivio ufficiale delle ricerche include ora M3.1 Flash. Non è stato trovato alcun annuncio di lancio M4 nelle fonti ufficiali esaminate al 20 ottobre 2026.
| Categoria di evidenza | Riscontro | Valutazione |
|---|---|---|
| Annuncio ufficiale M4 | Non verificato | Non confermato |
| Identificatore pubblico M4 | Non verificato | Non confermato |
| Screenshot leak benchmark M4 | Nessuna evidenza indipendente verificata | Non confermato |
| Endpoint API M4 | Non verificato | Non confermato |
| Prezzi M4 | Non pubblicati | Sconosciuto |
| Pesi modello M4 | Non verificato | Sconosciuto |
| Lancio MiniMax M3 | 1° giugno 2026 | Confermato |
| Rilascio M3.1 Flash | Rilasciato il 19 ottobre 2026; disponibile tramite MiniMax API, M Plan e MiniMax Code | Confermato |
Segnalazioni della community / Leak
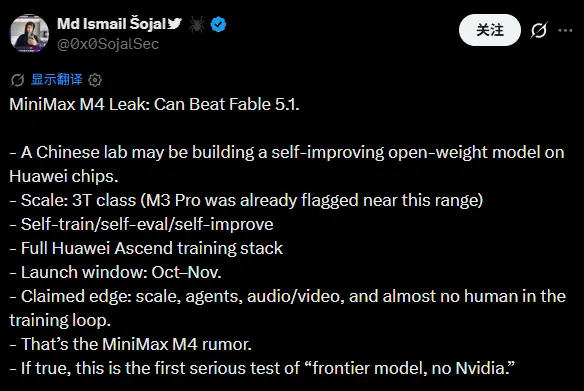
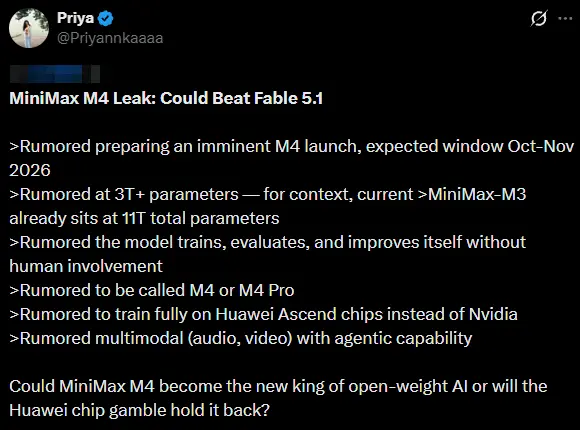
Due post su X datati 27 settembre 2026 discutono un possibile rilascio M4. Dimostrano che tali affermazioni circolavano nella community, non che MiniMax le abbia confermate. Entrambi sono trattati qui come segnalazioni non verificate; il badge di verifica a pagamento degli autori non garantisce l’accuratezza delle affermazioni.
In un post di @0x0SojalSec, l’autore suggerisce un modello da circa tre trilioni di parametri, un rilascio open-weight e l’addestramento su hardware Huawei Ascend. L’estratto leggibile descrive anche un loop in cui il modello partecipa al proprio addestramento e valutazione. Queste sono affermazioni dell’autore del post, non specifiche M4 verificate.
Un post di Priya (@Priyannkaaaa)suggerisce un possibile rilascio tra ottobre-novembre 2026 e un conteggio di parametri superiore a tre trilioni. Riporta anche un’affermazione non verificata sulla dimensione del precedente modello M3. Tale confronto non è adottato come baseline fattuale in questo articolo.
Quando potrebbe essere rilasciato MiniMax M4?
I modelli precedenti restano punti di riferimento utili, incluso MiniMax M2.5 API in CometAPI. Le loro date stabiliscono un contesto storico, non una previsione del prossimo rilascio.
MiniMax non ha confermato una data di lancio per M4. La finestra ottobre-novembre 2026 menzionata nel post della community di Priya è una voce, non un calendario ufficiale; l’estratto sottostante e i suoi limiti sono discussi in Segnalazioni della community / Leak. La storia dei rilasci della famiglia di modelli mostra sia generazioni maggiori sia versioni intermedie, ma gli intervalli di lancio passati non consentono di prevedere con affidabilità il prossimo rilascio.
| Pietra miliare | Timeline di rilascio ufficiale | Significato |
|---|---|---|
| MiniMax M2.5 | 12 febbraio 2026 | Coding e produttività |
| MiniMax M2.7 | 18 marzo 2026 | Miglioramenti ai workflow degli agenti |
| MiniMax M3 | 1° giugno 2026 | Contesto da 1M e multimodalità |
| M3.1 Flash | 19 ottobre 2026 — rilascio ufficiale | Modello focalizzato su efficienza per coding e agent |
| MiniMax M4 | Non annunciato | Nessuna timeline verificata |
Un annuncio formale di prodotto MiniMax sarebbe il segnale più forte. Documentazione API o un identificatore di modello autenticato fornirebbero ulteriore supporto. Risultati benchmark e model card pubbliche permetterebbero di valutare i miglioramenti tecnici, mentre prezzi ufficiali e rate limit determinerebbero la viabilità in produzione.
Prezzo di MiniMax M4 — Cosa suggeriscono i leak e le generazioni precedenti
Non esistono prezzi ufficiali per M4. Tutte le cifre sotto sono estrapolate dai rate card attivi di M3 e M3.1 Flash (USD, per milione di token, valori approssimativi a metà ottobre 2026):
| Modello | Input / 1M | Output / 1M | Input in cache | Contesto | Note |
|---|---|---|---|---|---|
| MiniMax M3 | $0.30 | $1.20 | ~$0.06 | 1M | Listino “sconto permanente 50%”; tier superiore per contesto >512k |
| MiniMax M3.1 Flash | $0.15 | $0.60 | $0.015 | 1M | ~50% più economico di M3; ottimizzato per throughput degli agenti |
| Intervallo previsto M4 (spec.) | $0.20–$0.40 | $0.80–$1.50 | Struttura di sconto simile | 1M+ | Probabilmente tra le offerte open-weight frontier più economiche |
Fonti per i prezzi attuali: documentazione della piattaforma MiniMax, aggregatori indipendenti e annunci di lancio.
MiniMax ha ripetutamente posizionato i suoi modelli a una frazione del costo dei principali modelli closed-source occidentali, eguagliandoli o superandoli su benchmark selezionati per coding e agent. Un M4 completo dovrebbe proseguire questa strategia, con possibili tier premium per contesti estesi, latenza prioritaria o maggiore sforzo di reasoning.
Raccomandazione CometAPI: invece di gestire direttamente più chiavi API MiniMax e rate card, instradare tramite un gateway unificato come CometAPI. Ciò consente switch senza soluzione di continuità tra M3, M3.1 Flash e (quando disponibile) M4, fallback automatici, analytics d’uso e spesso un migliore prezzo effettivo tramite aggregazione dei volumi—soprattutto utile per workload agentici che consumano grandi quantità di token.
Cosa rivela MiniMax M3.1 Flash sulla prossima generazione
MiniMax M3.1 Flash provides un riferimento più aggiornato per valutare cosa potrebbe offrire un futuro modello MiniMax M4. Introdotto ufficialmente il 19 ottobre 2026, M3.1 Flash si concentra su workflow agentici, sviluppo software, uso del computer e cybersecurity, enfatizzando inferenza più rapida e costi d’uso più bassi. Questi miglioramenti offrono indizi utili sulle priorità ingegneristiche attuali di MiniMax, sebbene non stabiliscano una data di rilascio M4 né ne confermino le specifiche future.
1. L’affidabilità degli agent sta diventando importante quanto l’intelligenza grezza
Uno dei temi più evidenti nell’annuncio di M3.1 Flash è l’enfasi sul completamento di compiti complessi e multi-step. MiniMax riporta miglioramenti nei workflow agentici, nel coding, nell’uso del computer e nell’automazione enterprise.
Questa direzione suggerisce che la prossima generazione di modelli potrebbe essere valutata meno per performance di Q&A isolate e più per la capacità di completare interi workflow in modo affidabile.
Per esempio, un agent di ingegneria software può dover ispezionare un repository, identificare un difetto, modificare diversi file, eseguire test, diagnosticare fallimenti e verificare la patch finale. Il successo dipende non solo dalla qualità del ragionamento ma anche dalla selezione degli strumenti, dal tracciamento dello stato, dal recupero dagli errori e dalla coerenza lungo più step.
Un futuro M4 potrebbe seguire questa direzione migliorando la pianificazione a lungo orizzonte, riducendo le chiamate agli strumenti non necessarie e recuperando più efficacemente da azioni fallite. Si tratta di target di valutazione ragionevoli, non di funzionalità M4 confermate.
2. L’efficienza dell’inferenza potrebbe diventare un vantaggio competitivo chiave
MiniMax riporta che M3.1 Flash offre quasi tre volte la velocità d’inferenza online rispetto al predecessore e riduce i costi complessivi d’uso del 70% per i compiti agentici. L’azienda attribuisce i miglioramenti di efficienza a una sparsity più aggressiva.
Queste affermazioni evidenziano un’importante distinzione tra intelligenza del modello ed efficienza operativa pratica. Un modello che completa un compito con meno retry, minore latenza e minore consumo di token può essere più prezioso di un modello con un punteggio benchmark leggermente superiore ma che richiede molte più risorse.
Per un possibile M4, le domande rilevanti includeranno se può sostenere alto throughput su compiti di lunga durata, preservare la qualità dell’output con budget d’inferenza più stretti e ridurre il costo totale per completare con successo un compito.
I miglioramenti riportati per M3.1 Flash sono dichiarazioni dell’azienda e dovrebbero essere valutati indipendentemente sotto carichi di lavoro comparabili prima di considerarli garanzie di performance generali.
3. Coding e computer use sono aree da osservare
L’annuncio di M3.1 Flash riporta un punteggio di 73.7% su DeepSWE v1.1, 61.7 su OSWorld V2 e 82% su CyberGym. Questi risultati coprono aspetti diversi dell’ingegneria del software, dell’interazione con il computer e della cybersecurity, rispettivamente.
Nel complesso, forniscono un punto di partenza più utile per valutare modelli futuri rispetto a un singolo benchmark general-purpose.
Se MiniMax introducesse M4, gli sviluppatori dovrebbero cercare evidenza che migliori il completamento pratico dei compiti piuttosto che limitarsi ad aumentare un punteggio headline. Test utili potrebbero includere bugfix a livello di repository, workflow cross-application, automazione del browser, analisi di vulnerabilità e recupero da chiamate agli strumenti fallite.
I confronti tra benchmark dovrebbero preservare versione del dataset, ambiente di esecuzione, scaffold dell’agent, limiti di risorse e metodologia di scoring. Senza condizioni comparabili, le differenze tra punteggi modello potrebbero non riflettere reali miglioramenti di capacità.
4. Lungo contesto e ragionamento multimodale richiedono ancora valutazione pratica
MiniMax M3 supporta già una finestra di contesto fino a un milione di token e input multimodali nativi, incluse immagini e video. Il rilascio di M3.1 Flash mantiene la finestra a un milione di token e combina comprensione multimodale con capacità più orientate agli agent.
Ciò significa che una finestra di contesto più ampia, da sola, non sarebbe necessariamente una ragione convincente per aggiornare a M4.
Progressi più significativi potrebbero includere un miglior retrieval da grandi repository, maggiore coerenza su documenti lunghi, interpretazione più accurata dell’evidenza visiva e coordinamento più affidabile tra percezione ed esecuzione degli strumenti.
Per esempio, un agent di sviluppo potrebbe dover ispezionare una registrazione dello schermo, identificare un guasto dell’interfaccia utente, tracciare il codice applicativo rilevante, implementare una correzione e verificarne il risultato. La qualità del workflow completo conta più della capacità del modello di processare un input di grandi dimensioni in isolamento.
Questi scenari rappresentano possibili priorità di valutazione per M4, non capacità annunciate da MiniMax.
5. Le future release potrebbero essere valutate per costo per compito completato
L’annuncio di M3.1 Flash rafforza l’importanza di valutare l’economia dei modelli a livello di workflow. I prezzi per token non catturano il costo completo dell’uso di un agent.
Un confronto più utile considera la probabilità di completare con successo un compito, il numero di tentativi richiesti, il consumo di token, i costi degli strumenti, la latenza e l’intervento umano.
Gli sviluppatori che si preparano a un futuro rilascio M4 dovrebbero stabilire una baseline con i modelli attualmente disponibili e utilizzare lo stesso set di compiti per confrontare i rilasci successivi. Questo permette di determinare se un nuovo modello offre miglioramenti significativi di produttività piuttosto che semplici variazioni nelle classifiche benchmark.
Quanto sono solidi i benchmark di MiniMax M3 e cosa dovrebbe superare M4?
MiniMax ha pubblicato un set consistente di risultati benchmark per M3, fornendo target misurabili per un modello futuro. I seguenti valori sono risultati M3 riportati, non previsioni per M4.
| Benchmark | Punteggio riportato MiniMax M3 | Cosa valuta | Target di verifica per M4 |
|---|---|---|---|
| SWE-Bench Pro | 59.0% | Ingegneria software reale | Maggiore risoluzione di compiti verificata |
| Terminal-Bench 2.1 | 66.0% | Esecuzione agent su terminale | Più operazioni end-to-end riuscite |
| SWE-fficiency | 34.8% | Efficienza dei compiti di coding | Migliore performance con budget comparabili |
| KernelBench Hard | 28.8% | Ottimizzazione di kernel GPU | Kernel più corretti e più veloci |
| MCP Atlas | 74.2% | Compiti orientati a tool e MCP | Migliore selezione ed esecuzione degli strumenti |
Questi sono risultati riportati dal vendor nell’annuncio del 1° giugno 2026, non repliche indipendenti. Le suite misurano esiti diversi, quindi le percentuali non devono essere mediate in un unico punteggio di accuratezza.
Performance su coding e ingegneria del software
Cosa è confermato (M3)
- SWE-Bench Pro: 59.0%
- Terminal-Bench 2.1: 66.0%
- Risultati solidi su bugfix reali, sviluppo frontend/backend e compiti di ottimizzazione kernel (valutazioni interne MiniMax hanno mostrato iterazioni autonome di più ore).
Cosa aggiunge M3.1 Flash: Affermazioni di ulteriori progressi su benchmark di coding, agent e cybersecurity, oltre a un aumento drastico dei token-per-second e minore costo per traiettoria agent completata.
Cosa resta non confermato / atteso per M4: Punteggi assoluti più alti su benchmark stile SWE-Bench e di coding interattivo multi-turn, migliore gestione di progetti a lungo orizzonte e maggiore capacità di mantenere coerenza su sessioni multi-file e multi-day. Qualsiasi modello di scala 2.7T (se rilasciato) dovrebbe elevare ulteriormente il ceiling di capacità, sebbene conteggio di parametri attivi e sparsity determineranno il costo reale.
Efficienza del lungo contesto e architettura
Confermato: M3 ha introdotto MSA (MiniMax Sparse Attention), offrendo un contesto pratico da 1M token con un compute per token pari a 1/20 rispetto alla generazione precedente a attention densa, >9× di prefilling e >15× di decoding a lunghezze estreme, mantenendo allineamento con full attention sulla maggior parte delle capacità.
Miglioramenti attesi: Raffinamenti dei pattern di sparsity, supporto migliore per contesti ancora più lunghi o retrieval più denso entro la finestra, minore footprint di memoria per self-hosting e gestione migliorata di lunghi documenti multimodali interleaved.
Capacità multimodali e di computer-use
Confermato: Comprensione nativa di immagini e video sin dalle prime fasi di training, oltre a dimostrata computer-use (operatività desktop) in MiniMax Code e harness per agent.
Atteso per M4: Integrazione più stretta della comprensione video con la pianificazione degli agent, pipeline più robuste da documenti/screenshot a codice, e controllo del computer multi-applicazione più affidabile su orizzonti più lunghi.
Workflow agentici, uso di tool e auto-miglioramento
Confermato: M2.7 ha già sperimentato loop di auto-miglioramento ricorsivo. M3 e M3.1 Flash enfatizzano collaborazione multi-agent, ricerca dinamica di tool, compiti autonomi di lunga durata e loop producer-verifier all’interno di MiniMax Code.
Atteso: Team di agent più robusti su più giorni, migliore recupero da fallimenti degli strumenti, supporto nativo per ecosistemi di tool più ampi e possibilmente tecniche di auto-miglioramento o ricerca evolutiva a scala maggiore.
Prezzo di MiniMax M4 — Cosa suggeriscono i leak e le generazioni precedenti
Non esistono prezzi ufficiali per M4. Tutte le cifre sotto sono estrapolate dai rate card attivi di M3 e M3.1 Flash (USD, per milione di token, valori approssimativi a metà ottobre 2026):
| Modello | Input / 1M | Output / 1M | Input in cache | Contesto | Note |
|---|---|---|---|---|---|
| MiniMax M3 | $0.30 | $1.20 | ~$0.06 | 1M | Listino “sconto permanente 50%”; tier superiore per contesto >512k |
| MiniMax M3.1 Flash | $0.15 | $0.60 | $0.015 | 1M | ~50% più economico di M3; ottimizzato per throughput degli agenti |
| Intervallo previsto M4 (spec.) | $0.20–$0.40 | $0.80–$1.50 | Struttura di sconto simile | 1M+ | Probabilmente tra le offerte open-weight frontier più economiche |
MiniMax ha ripetutamente posizionato i suoi modelli a una frazione del costo dei principali modelli closed-source occidentali, eguagliandoli o superandoli su benchmark selezionati per coding e agent. Un M4 completo dovrebbe proseguire questa strategia, con possibili tier premium per contesti estesi, latenza prioritaria o maggiore sforzo di reasoning.
Raccomandazione CometAPI: invece di gestire direttamente più chiavi API MiniMax e rate card, instradare tramite un gateway unificato come CometAPI. Ciò consente switch senza soluzione di continuità tra M3, M3.1 Flash e (quando disponibile) M4, fallback automatici, analytics d’uso e spesso un migliore prezzo effettivo tramite aggregazione dei volumi—soprattutto utile per workload agentici che consumano grandi quantità di token.
MiniMax M3 vs M3.1 Flash vs direzione attesa per M4
| Dimensione | M3 API in CometAPI (giu 2026) | MiniMax M3.1 Flash (ott 2026) | Direzione attesa per M4 (H2 2026+) |
|---|---|---|---|
| Stato | Live, pesi aperti | Live, pesi imminenti | Non rilasciato |
| Parametri (approx.) | 428B totali / ~23B attivi | Scala simile | Sconosciuta (possibile MoE più ampio) |
| Contesto | 1M token (MSA) | 1M token | 1M+ con ulteriore efficienza |
| Coding (SWE-Bench Pro) | 59.0% | Ulteriori progressi dichiarati | Attesi punteggi assoluti più alti |
| Velocità d’inferenza | Baseline robusto | ~3× più veloce dichiarato | Ulteriori ottimizzazioni |
| Costo agentico | Competitivo | ~70% in meno dichiarato | Prezzi aggressivi continuativi |
| Multimodale | Immagini + video nativi | Idem + affinamenti | Integrazione più profonda |
| Pesi aperti | Sì | Previsti a breve | Altamente probabile |
| Prezzo API (in/out) | $0.30 / $1.20 | $0.15 / $0.60 | Atteso $0.20–0.40 / $0.80–1.50 |
Selezione del modello in base al flusso di lavoro degli sviluppatori
Utilizzare il M3.1 Flash rilasciato come candidato di valutazione corrente e mantenere M3 e qualsiasi workflow M2.7 consolidato per confronto. Misurare i compiti accettati, i retry, gli interventi umani e il costo totale sullo stesso carico di lavoro. Regolare lo sforzo in modo deliberato invece di assumere che il massimo “thinking” sia sempre il miglior setpoint operativo.
M4 non è ancora una scelta operativa pronta per la produzione. La preparazione più utile è costruire una suite di benchmark riproducibile contro i modelli esistenti così da valutare rapidamente un futuro rilascio.
Come accedere ai modelli MiniMax attuali (e prepararsi a M4)
Mentre si attende M4, il percorso pratico è usare i modelli live:
- Ottenere una chiave API MiniMax dalla piattaforma ufficiale.
- Oppure, per affidabilità in produzione, instradare tramite un gateway multi-modello come CometAPI. CometAPI offre un singolo endpoint e una singola chiave che può indirizzare MiniMax M3, M3.1 Flash e altri provider, con dashboard d’uso integrate, gestione dei rate limit e la possibilità di cambiare modello senza modifiche al codice.
- Per agent di coding, abbinare il modello a MiniMax Code (desktop/CLI) o framework open che già supportano endpoint MiniMax compatibili con Anthropic o OpenAI.
- Monitorare i canali ufficiali MiniMax e i cataloghi degli aggregatori; nel momento in cui appare un nuovo model ID della serie M, gateway come CometAPI in genere lo espongono rapidamente.
Questo approccio minimizza il lock-in e consente ai team di valutare M3 vs M3.1 Flash (ed eventualmente M4) su carichi reali con osservabilità coerente.
Conclusione
MiniMax M4 resta un modello futuro definito da un impegno aziendale chiaro ma ad alto livello, più che da specifiche concrete. La generazione M3 ha già affermato MiniMax come un serio contendente open-weight nel coding, negli agent e nel lavoro multimodale a lungo contesto; M3.1 Flash ha poi spinto il fronte dell’efficienza. Qualunque forma assuma la “nuova generazione” H2 2026—che si chiami M3.5, M4 o altro—erediterà una solida base di sparse attention, pesi aperti e prezzi aggressivi.
Per sviluppatori e team che costruiscono agent di produzione oggi, la raccomandazione operativa è semplice: integrare i modelli MiniMax live (M3 e M3.1 Flash) tramite un layer flessibile multi-provider come CometAPI. Questo offre vantaggi immediati in capacità e costi, posizionandovi per adottare M4 non appena apparirà su endpoint pubblici—con modifiche minime al codice e piena visibilità su performance e spesa.