Specifiche tecniche di MiniMax M3.1-Flash
| Voce | MiniMax M3.1-Flash |
|---|---|
| ID modello | MiniMax-M3.1-Flash |
| Famiglia del modello | Serie MiniMax M3.1, modello per coding |
| Data di rilascio | 27 settembre 2026 |
| Focus principale | Sviluppo software quotidiano, dalle correzioni di bug alla realizzazione completa di funzionalità |
| Finestra di contesto | 1.000.000 token |
| Modalità di input | Testo, immagine e video |
| Modalità di output | Testo |
| Controllo del ragionamento | reasoning_effort: low, medium, high, xhigh, max |
| Comportamento del ragionamento | È richiesto un ragionamento adattivo; la documentazione pubblica esaminata non supporta la disattivazione del ragionamento |
| Output massimo | Non pubblicato separatamente nel materiale pubblico esaminato |
| Numero di parametri | Non divulgato pubblicamente |
| Pesi aperti | Nessun checkpoint/repository del modello pubblico identificato |
MiniMax ha annunciato M3.1-Flash per MiniMax Code il 27 settembre 2026, posizionandolo per attività di sviluppo quotidiane come il bug fixing e la consegna completa di funzionalità. La copertura pubblica attuale identifica in modo coerente una finestra di contesto da 1M token e uno sforzo di ragionamento regolabile, pur osservando che non sono stati pubblicati né una tabella di benchmark autonoma né il prezzo per token.
Che cos’è MiniMax M3.1-Flash?
MiniMax M3.1-Flash è un modello testuale orientato al coding, progettato per flussi di lavoro iterativi di sviluppo software, non soltanto per la generazione di codice. MiniMax descrive il flusso come comprendente la comprensione dei requisiti, la localizzazione del problema, l’implementazione, il testing di regressione e la verifica delle modifiche rispetto alla funzionalità esistente.
I suoi controlli distintivi documentati sono il lungo contesto e una scala a cinque livelli per lo sforzo di ragionamento. I livelli disponibili sono low, medium, high, xhigh e max, consentendo agli sviluppatori di bilanciare profondità del ragionamento e latenza in base alla complessità del compito.
Caratteristiche principali di MiniMax M3.1-Flash
- 1M-token context: La descrizione pubblicata del modello indica una finestra di contesto da un milione di token, adatta a grandi repository, specifiche lunghe e sessioni estese di agenti di coding.
- Input multimodale nativo: Le descrizioni pubbliche del modello indicano testo, immagine e video come input, mentre l’output è testuale.
- Cinque livelli di sforzo di ragionamento:
low,medium,high,xhighemaxoffrono un controllo più fine sulla profondità del ragionamento rispetto a un semplice interruttore on/off. - Flusso di lavoro di sviluppo end-to-end: MiniMax posiziona specificamente il modello per la localizzazione dei bug, l’implementazione, la gestione dei casi limite, il completamento dei test di regressione e la validazione delle modifiche.
- Distribuzione orientata: Il lancio pubblico iniziale avviene tramite MiniMax Code e Token Plan, anziché un’offerta standalone pay-as-you-go completamente documentata.
- Adatto ai coding-agent: Il modello è pensato per interazioni di sviluppo ripetute in cui il contesto del repository, l’output degli strumenti, i test e le correzioni iterative contano più della generazione di codice one-shot.
MiniMax M3.1-Flash vs altri modelli di coding MiniMax
| Modello | Focus | Contesto | Dati di benchmark pubblici | Accesso/stato |
|---|---|---|---|---|
| M3.1-Flash | Coding quotidiano, sviluppo iterativo | 1M | Non ancora pubblicati | MiniMax Code / Token Plan |
| M3 | Coding d’avanguardia + lavoro agentico, multimodalità nativa | Fino a 1M | Pubblicati da MiniMax | API, Token Plan, MiniMax Code |
| M2.7 | Ingegneria del software + ampio lavoro per agenti/produttività | Non usato qui come una specifica M3.1 copiata | Pubblicati da MiniMax | API, Token Plan, Agent |
M3 è il punto di riferimento più approfonditamente documentato: MiniMax pubblica l’architettura, la metodologia di valutazione per coding/agent e la disponibilità API. Anche M2.7 dispone di record di benchmark pubblici e integrazione API. M3.1-Flash è più recente e attualmente ha un’impronta documentale pubblica più ristretta, quindi i confronti dovrebbero concentrarsi sul posizionamento documentato invece di proclamare un vincitore di benchmark. 4
Casi d’uso rappresentativi
- Correzione di bug a livello di repository: Fornire al modello una grande codebase, la descrizione del problema, i log e i test e usare il lungo contesto per mantenere il contesto di progetto rilevante.
- Implementazione di funzionalità: Usare il modello per passare da un requisito in linguaggio naturale alle modifiche al codice e al testing di regressione.
- Code review e remediation: Chiedere di identificare i casi limite, proporre patch e verificare che le modifiche non interrompano il comportamento esistente.
- Debug multimodale: Fornire screenshot, diagrammi o video insieme ai requisiti testuali quando il contesto visivo è parte del problema ingegneristico.
- Sessioni di coding-agent di lunga durata: Usare l’ampia finestra di contesto per specifiche, file di repository, output del terminale e risultati di test iterativi.
- Sviluppo sensibile alla velocità: Selezionare un livello di sforzo di ragionamento più basso per modifiche di routine e aumentarlo per cambiamenti multi-step più complessi.
Come accedere all’API di MiniMax M3.1-Flash
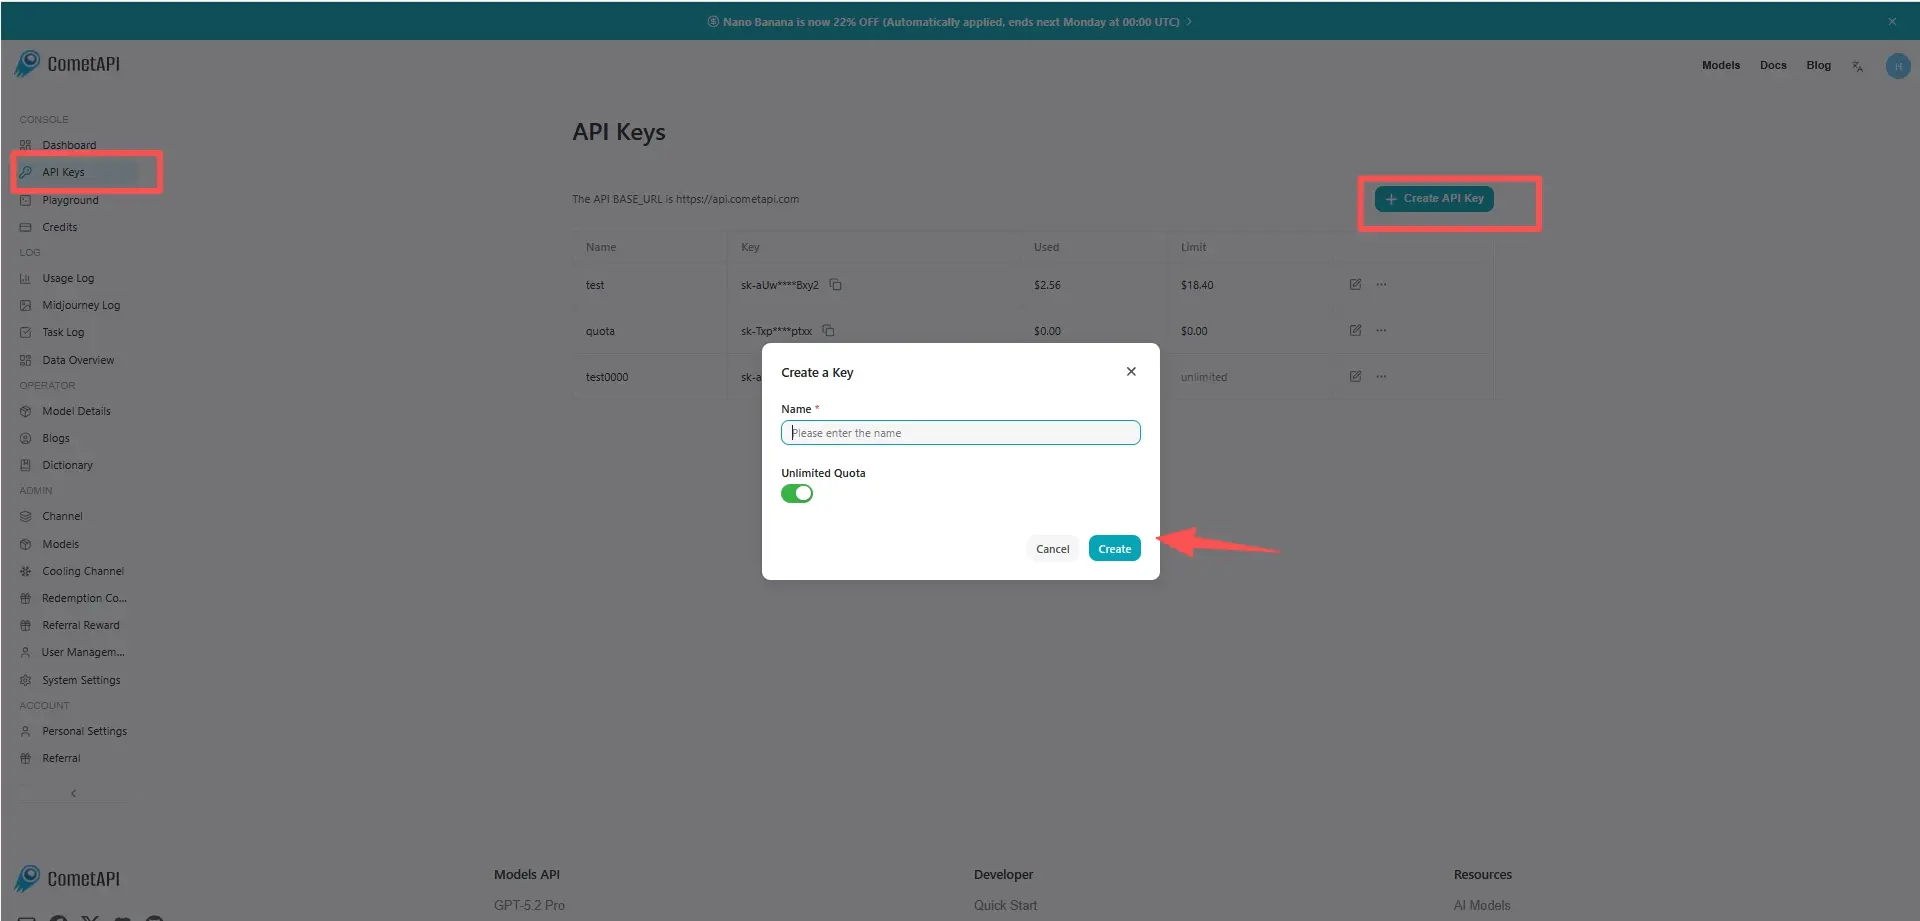
Passaggio 1: registrarsi per ottenere la chiave API
Accedi a cometapi.com. Se non sei ancora nostro utente, registrati prima. Accedi alla console CometAPI. Ottieni la chiave API delle credenziali di accesso dell’interfaccia. Fai clic su “Add Token” nella voce API token del centro personale, ottieni la chiave token: sk-xxxxx e invia.
Passaggio 2: inviare richieste all’API MiniMax M3.1-Flash
Seleziona l’endpoint “minimax-m3.1-flash” per inviare la richiesta API e imposta il corpo della richiesta. Il metodo e il corpo della richiesta sono disponibili nella documentazione API sul nostro sito web. Il nostro sito fornisce anche un test Apifox per comodità. Sostituisci <YOUR_API_KEY> con la tua chiave CometAPI effettiva del tuo account. La base URL è Chat Completions.
Inserisci la tua domanda o richiesta nel campo content: è ciò a cui il modello risponderà. Elabora la risposta dell’API per ottenere l’output generato.
Passaggio 3: recuperare e verificare i risultati
Elabora la risposta dell’API per ottenere la risposta generata. Dopo l’elaborazione, l’API risponde con lo stato dell’attività e i dati di output.