
TL;DR: FLUX 3 è il modello fondativo multimodale unificato di Black Forest Labs. La sua Video API pubblicamente disponibile genera clip fino a 20 secondi a 24 fps, con audio sincronizzato opzionale, a partire da testo, immagini, keyframe o video esistenti. Supporta risoluzioni da HD fino a UHD/4K, mentre FLUX 3 Image e il modello a pesi aperti FLUX 3 Dev restano elementi di rollout separati.
Che cos'è FLUX 3?
FLUX 3 è un modello multimodale d’avanguardia di Black Forest Labs. Invece di addestrare indipendentemente un modello per le immagini, un altro per i video e un altro per l’audio, BFL addestra una rappresentazione condivisa tra queste modalità.
L’idea centrale è che immagini, video e suono siano osservazioni diverse dello stesso mondo sottostante. Un’auto in movimento ha aspetto visivo, moto, suono, relazioni spaziali, proprietà dei materiali e comportamento causale. Imparare questi segnali insieme fornisce al modello più vincoli rispetto all’apprendimento dei singoli fotogrammi isolati.
Ecco perché Black Forest Labs descrive FLUX 3 come un passo verso un reality model o world model piuttosto che un semplice generatore di immagini o video. Il sistema video rilasciato già dimostra questa direzione: audio sincronizzato, movimento, struttura della scena, dialoghi, comportamento della camera e suoni ambientali sono gestiti in un unico flusso di generazione.
Non tutte le funzionalità annunciate di FLUX 3 sono già pubbliche. A settembre 2026, FLUX 3 Video è disponibile, mentre FLUX 3 Image e il modello a pesi aperti FLUX 3 Dev restano elementi di rollout separati.
Specifiche di FLUX 3 a colpo d'occhio
Le seguenti specifiche riflettono la documentazione sviluppatori FLUX 3 attuale, non la configurazione preliminare del lancio di luglio.
| Specifiche | Documentazione ufficiale di FLUX 3 |
|---|---|
| Sviluppatore | Black Forest Labs |
| Famiglia di modelli | FLUX 3 |
| Tipo di modello | Fondativo multimodale unificato / modello video generativo |
| Rilascio pubblico video | 4 agosto 2026 |
| Direzione principale dell'addestramento | Apprendimento congiunto di rappresentazioni per immagini, video e audio |
| Fondamento di ricerca | Self-Flow |
| Output API principale attuale | Video con audio sincronizzato |
| Da testo a video | Supportato |
| Da immagine a video | Supportato |
| Da keyframe a video | Supportato |
| Continuazione video | Supportata |
| Durata massima T2V/I2V | 20 secondi |
| Durata continuazione video | 5–15 secondi |
| Frame rate | 24 fps |
| Risoluzione | HD, FHD, QHD/2K e UHD/4K |
| Risoluzione FHD 16:9 | 1920 × 1088 |
| Riferimenti immagine | Fino a 10 per workflow I2V/keyframe |
| Audio nativo | Sì |
| Dialogo multilingue | Sì |
| Sincronizzazione labiale | Sì |
| Generazione multi-shot | Sì |
| Modalità Bozza | Sì |
| Endpoint pubblico FLUX 3 per immagini statiche | Non ancora rilasciato pubblicamente da BFL |
| FLUX 3 Dev a pesi aperti | Pianificato |
La documentazione BFL attuale specifica 5–20 secondi per testo‑video e immagine‑video, mentre la continuazione video accetta una finestra di generazione di 5–15 secondi. I rapporti di aspetto supportati includono 21:9, 2:1, 16:9, 4:3, 1:1, 3:4 e 9:16.
Come funziona FLUX 3?
Self-Flow
Il fondamento di ricerca chiave è Self-Flow, l’approccio di flow matching auto‑supervisionato di Black Forest Labs. Le pipeline di addestramento generativo tradizionali spesso si basano su modelli di rappresentazione pre‑addestrati separati o supervisione ausiliaria. Self-Flow è progettato per apprendere rappresentazioni utili direttamente dall’obiettivo generativo.
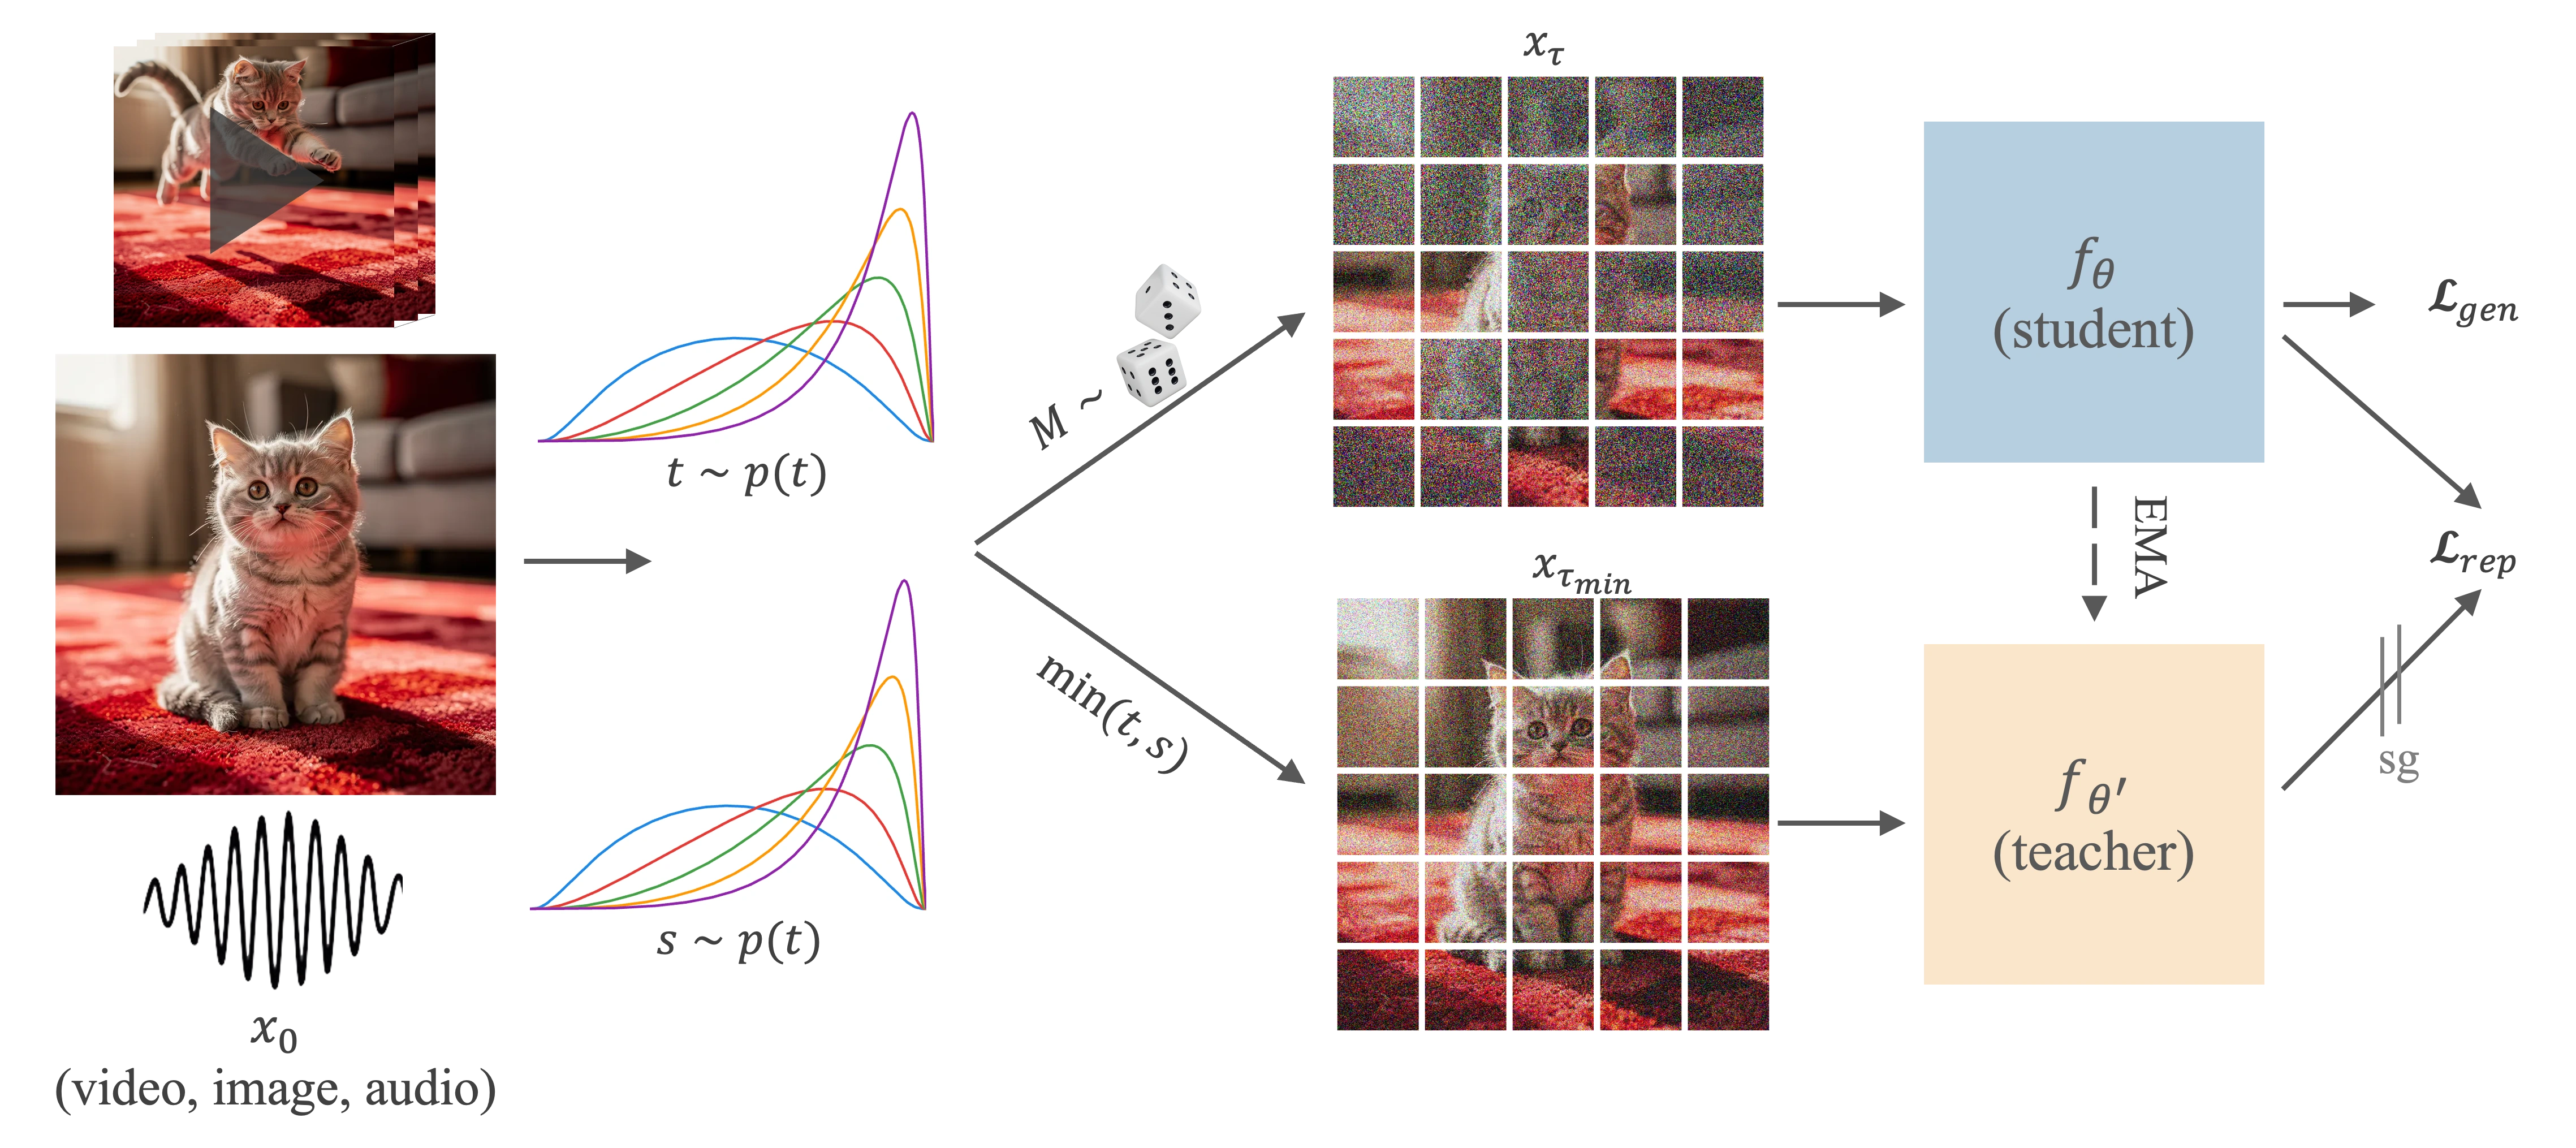
Un meccanismo importante è il Dual-Timestep Scheduling. A gruppi diversi di token possono essere assegnati livelli di rumore differenti durante l’addestramento. Questo crea un’asimmetria informativa: alcune parti dell’input contengono più informazioni utilizzabili di altre, costringendo la rete a costruire rappresentazioni che aiutino a inferire ciò che manca.
In termini pratici, FLUX 3 viene incentivato a imparare le relazioni tra oggetti, fotogrammi, movimento, suono ed eventi temporali invece di memorizzare semplicemente come dovrebbero apparire i singoli frame.
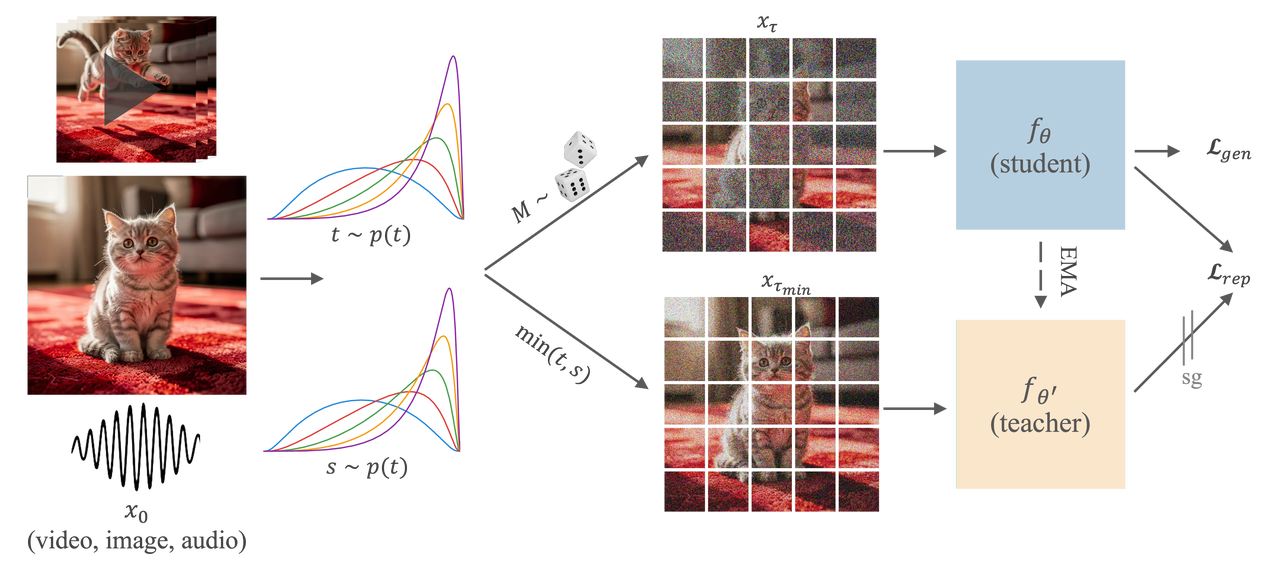
Architettura del metodo Self-Flow - fonte immagine ufficiale: Black Forest Labs Self-Flow project
BFL ha inoltre testato l’addestramento multimodale congiunto usando un backbone derivato da FLUX.2 con milioni di video e centinaia di milioni di immagini. Gli esperimenti supportano l’ipotesi più ampia di FLUX 3 secondo cui l’apprendimento delle rappresentazioni e la generazione non devono essere sistemi separati.
Perché il video è centrale per FLUX 3
Il video è particolarmente prezioso per il world modeling perché contiene informazioni che un’immagine statica non può fornire. Un singolo fotogramma può mostrare una palla sopra il pavimento; un video può rivelare che la palla sta cadendo, rimbalzando, deformandosi all’impatto, producendo un suono e cambiando direzione in seguito.
BFL ha rivelato che la predizione video rappresenta oltre il 95% del calcolo di addestramento di FLUX 3. L’audio è relativamente poco costoso perché è un segnale molto meno dimensionale, strettamente accoppiato agli eventi visibili. Questa allocazione aiuta a spiegare perché il video è la prima capacità di FLUX 3 a raggiungere la disponibilità generale.
Cosa può fare FLUX 3?
Da testo a video
Gli utenti possono generare un video completo da istruzioni in linguaggio naturale. BFL afferma che il modello rilasciato gestisce prompt semplici e complessi coordinando movimento, logica della scena, composizione visiva e suono. Questo è particolarmente utile per prompt che contengono eventi multipli sequenziali, invece di un singolo soggetto animato.
Da immagine a video e keyframe
FLUX 3 può animare un’immagine iniziale, lavorare verso un frame finale o usare più immagini come keyframe temporizzati. L’API attuale supporta fino a dieci riferimenti immagine nei workflow immagine‑video, consentendo ai creatori di controllare come una scena cambia nel tempo invece di chiedere al modello di improvvisare l’intera sequenza.
Continuazione video
Si può fornire un video esistente e il relativo audio come contesto e FLUX 3 può generare ciò che accade dopo. BFL descrive una continuazione che preserva movimento, comportamento della camera, dialoghi e suono attraverso la transizione, il che è materialmente diverso dal generare un secondo clip indipendente e unire i due file in seguito.
Audio nativo e dialoghi
FLUX 3 produce audio in fase di generazione invece di richiedere un passaggio separato per voce o suoni. Le capacità audio rilasciate includono dialoghi, effetti sonori e suoni ambientali. Sono supportati anche dialoghi multilingue con sincronizzazione labiale.
Più inquadrature in un'unica generazione
Un singolo prompt può contenere più scene o angolazioni di camera. Questo conta perché molti modelli video precedenti sono più forti quando viene richiesto un’unica breve inquadratura visivamente continua; FLUX 3 è esplicitamente progettato per supportare sequenze multi‑shot in un’unica generazione.
Modalità Bozza
La Modalità Bozza è una delle aggiunte più pratiche per la generazione video ad alto volume. Invece di pagare il prezzo pieno per ogni esperimento di prompt, gli sviluppatori possono creare un’anteprima più veloce e a costo inferiore e poi migliorare la bozza selezionata preservando la composizione e il movimento scelti. Secondo il listino BFL attuale, una bozza standard T2V/I2V costa $0.06 al secondo, contro $0.17 al secondo per la generazione HD normale.
Cosa non è stato ancora distribuito?
L’annuncio di lancio di FLUX 3 ha descritto funzionalità di immagine, video, audio e azioni sotto un’unica direzione architetturale, ma la disponibilità è scaglionata.
| Funzionalità | Roadmap e disponibilità attuali di BFL |
|---|---|
| Generazione video FLUX 3 | Generalmente disponibile |
| Audio video nativo | Generalmente disponibile |
| Da testo a video | Generalmente disponibile |
| Immagine‑video / keyframe | Generalmente disponibile |
| Continuazione video | Generalmente disponibile |
| Combinazioni più ricche di riferimenti immagine/video/audio | Espansione pianificata |
| Generazione ed editing immagini FLUX 3 | In arrivo |
| FLUX 3 Dev a pesi aperti | Pianificato |
| Distribuzione di predizione di azioni | Ricerca / percorso partner commerciali |
Questa distinzione è particolarmente importante per gli utenti familiari con FLUX.2 Max. FLUX.2 rimane un’opzione dedicata attuale per la generazione di immagini statiche, mentre il prodotto pubblico FLUX 3 è incentrato su video e audio.
Prestazioni di FLUX 3 nei benchmark
Ora ci sono due tipi utili di evidenza benchmark per FLUX 3: la valutazione interna post‑rilascio di BFL e la valutazione indipendente di terze parti. La prima mostra la preferenza umana relativa secondo il protocollo BFL; la seconda verifica se quei punti di forza rimangono visibili in un benchmark progettato separatamente.
Valutazione ELO post‑rilascio di BFL
L’annuncio iniziale di luglio includeva tassi di vittoria preliminari. Il benchmark più rilevante per gli utenti attuali è la valutazione del modello rilasciato del 4 agosto di BFL. Black Forest Labs riporta un punteggio ELO testo‑video di 1135 nella sua valutazione interna all‑vs‑all.
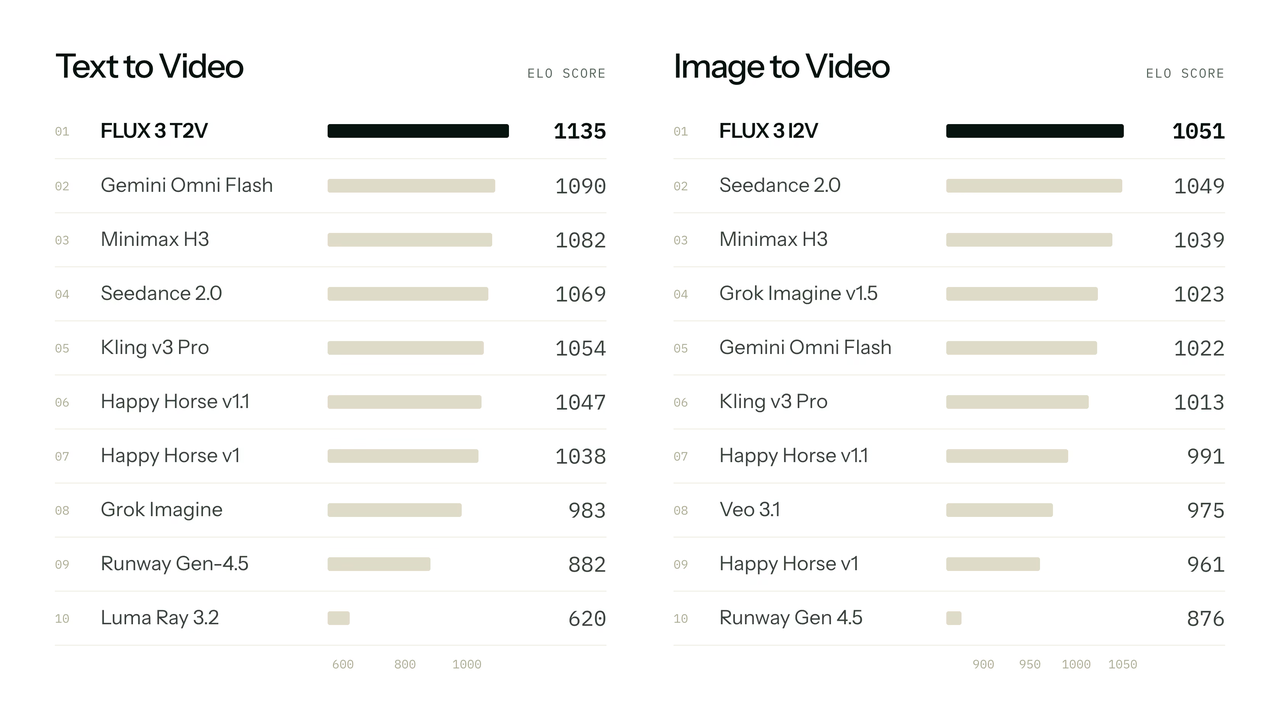
Valutazione ELO del modello rilasciato FLUX 3 - fonte immagine ufficiale: Black Forest Labs
| Metrica | Valutazione del modello rilasciato da BFL |
|---|---|
| ELO testo‑video | 1135 |
| Posizione T2V | Punteggio più alto nel gruppo testato da BFL |
| Risultato immagine‑video | A pari merito con il concorrente più forte testato e superiore ai restanti modelli valutati |
| Tipo di valutazione | Valutazione interna basata su preferenza umana |
| Stadio del modello | Rilascio FLUX 3 Video generalmente disponibile |
Questa è un’evidenza più solida rispetto al benchmark preliminare di lancio perché valuta il modello rilasciato in agosto. È comunque un benchmark gestito dal fornitore e non dovrebbe essere interpretato come prova che FLUX 3 supererà ogni concorrente in ogni categoria di prompt.
Benchmark indipendente su FLUX 3
Il v-benchmark v2 di Megaton fornisce un controllo indipendente. FLUX 3 è stato valutato nell’agosto 2026 e attualmente registra un Megaton Index di 76.51/100, classificandosi al #3 nel set pubblicato al momento della valutazione.
| Dimensione del benchmark | Valutazione Megaton di FLUX 3 |
|---|---|
| Megaton Index | 76.51 |
| Aderenza al prompt | 87.07 |
| Coerenza della scena | 94.76 |
| Fisica | 70.63 |
| Fedeltà umana | 73.70 |
| Fedeltà oggetti e prodotti | 83.82 |
| Coerenza causale e semantica | 80.91 |
| Fedeltà del testo | 82.41 |
| Cinematografia | 71.43 |
| Gusto e direzione artistica | 65.00 |
Il profilo è più informativo del punteggio complessivo. La Coerenza della scena a 94.76 è la categoria principale più forte del modello, mentre aderenza al prompt, fedeltà degli oggetti, coerenza causale e fedeltà del testo superano anch’esse 80. Fisica, Fedeltà umana e Gusto & Direzione artistica sono più deboli, mostrando che una rappresentazione temporale più forte non elimina i movimenti sintetici o la variabilità della qualità artistica.
Questo spiega anche perché le conclusioni dei benchmark possono differire: il test di preferenza interno di BFL colloca FLUX 3 in cima al suo set di confronto, mentre la classifica indipendente di Megaton lo posiziona terzo. Prompt diversi, dimensioni di punteggio, popolazioni di valutatori e metodi di aggregazione diversi possono produrre classifiche diverse.
FLUX 3 vs Seedance 2.5 vs MiniMax H3 vs Wan 3.0
Il mercato dei video AI si è mosso rapidamente nel 2026. FLUX 3 ora compete con sistemi multimodali che combinano sempre più generazione long‑form, audio sincronizzato, riferimenti ed editing.
| Dimensione | FLUX 3 | Seedance 2.5 | MiniMax H3 | Wan 3.0 |
|---|---|---|---|---|
| Sviluppatore | Black Forest Labs | ByteDance Seed | MiniMax | Alibaba |
| Clip massimo pubblicizzato | 20 s | 30 s | 15 s | 30 s |
| Risoluzione video | HD / FHD / QHD (2K) / UHD (4K) | Dipende dal livello API | Fino a 2K | Fino a 1080p |
| Audio nativo | Sì | Sì | Sì, stereo | Sì |
| Da testo a video | Sì | Sì | Sì | Sì |
| Input immagine/riferimento | Sì | Sì | Sì | Sì |
| Controllo keyframe/riferimenti | Keyframe temporizzati avanzati | Controllo dei riferimenti multimodali avanzato | Condizionamento multimodale | Controllo dei riferimenti multimodali |
| Continuazione/editing video | Continuazione disponibile | Workflow orientato all’editing | Focus sulla generazione onnimodale | Workflow di editing e riferimento |
| Generazione multi‑shot | Sì | Sì | Sì | Sì |
| Punto di forza distintivo | Architettura orientata al reality model, coerenza di scena, Self-Flow | Storytelling long‑form e controllo dei riferimenti | Generazione audiovisiva 2K e contesto onnimodale | Clip lunghe e costo iniziale inferiore |
| Prezzo unitario di partenza su CometAPI* | $0.136/s | $0.0824/s indicato | $0.064/s | $0.040/s |
* Il prezzo è solo un confronto approssimativo. Le API video utilizzano risoluzioni, durate, livelli di qualità e regole di fatturazione diversi, quindi il numero più economico al secondo non è necessariamente l’output di qualità equivalente più economico.
FLUX 3 vs Seedance 2.5
Seedance 2.5 ha un evidente vantaggio in durata, con generazione fino a 30 secondi rispetto ai 20 secondi di FLUX 3. È anche fortemente orientato alla generazione guidata da riferimenti, all’editing e allo storytelling long‑form. FLUX 3 si differenzia grazie alla sua architettura condivisa di world model, alla coerenza di scena, alla generazione audiovisiva nativa, ai keyframe temporizzati e a una roadmap più ampia per immagini/azioni.
I test indipendenti confermano che si tratta di una competizione davvero di fascia alta: attualmente Megaton colloca Seedance 2.5 sopra FLUX 3 nel complesso.
FLUX 3 vs MiniMax H3
MiniMax H3 offre output fino a 2K e audio stereo nativo, fornendo una specifica tecnica solida per contenuti audiovisivi. FLUX 3 supporta una finestra di generazione massima più lunga—20 secondi contro i 15 secondi di H3—e la sua Modalità Bozza offre un workflow di iterazione a costo controllato.
FLUX 3 vs Wan 3.0
Wan 3.0 enfatizza input multimodali ampi, generazione audiovisiva, editing e clip fino a 30 secondi. È anche più economico al prezzo iniziale indicato da CometAPI. FLUX 3 è più costoso ma si differenzia per il posizionamento come reality model, la coerenza di scena, il fondamento di ricerca Self-Flow, la Modalità Bozza e l’integrazione con la predizione di azioni.
Prezzi di FLUX 3
Black Forest Labs addebita FLUX 3 in base alla durata del video generato.
| Modalità | Prezzi ufficiali FLUX 3 di BFL |
|---|---|
| T2V / I2V Draft HD | $0.06/s |
| T2V / I2V HD | $0.17/s |
| T2V / I2V FHD | $0.29/s |
| T2V / I2V QHD (2K) | $0.40/s |
| T2V / I2V UHD (4K) | $0.80/s |
| Continuazione video Draft | $0.12/s |
| Continuazione video HD | $0.41/s |
| Continuazione video FHD | $0.53/s |
| Continuazione video QHD (2K) | $0.65/s |
| Continuazione video UHD (4K) | $0.95/s |
Una generazione HD standard di 10 secondi costa quindi circa $1.70 al tasso indicato da BFL, mentre una generazione FHD di 10 secondi costa circa $2.90. La continuazione video è sostanzialmente più costosa della generazione ordinaria, quindi le applicazioni che estendono frequentemente i clip dovrebbero modellare separatamente tali costi.
Prezzo di FLUX 3 su CometAPI
CometAPI attualmente indica FLUX 3 come disponibile con ID modello flux-3.
| Risoluzione | Prezzi FLUX 3 su CometAPI |
|---|---|
| 720p | $0.136/s |
| 1080p | $0.232/s |
Per una generazione di 10 secondi, ciò corrisponde a circa $1.36 a 720p o $2.32 a 1080p. Rispetto alle tariffe indicate da BFL di $0.17/s e $0.29/s, i prezzi predefiniti di CometAPI sono circa il 20% inferiori per questi due livelli.
Nota sulla disponibilità: alcuni testi descrittivi più vecchi su CometAPI riflettono ancora il periodo di Early Access di luglio. La scheda del modello live attuale, la sezione prezzi e l’esempio API elencano flux-3 come Available, con una data di rilascio su CometAPI del 13 agosto 2026. Per le decisioni di integrazione, l’API live e i campi di prezzo sono più rilevanti del testo di disponibilità più vecchio.
Perché FLUX 3 conta oltre il video AI
La parte più insolita di FLUX 3 non è la generazione di video da 20 secondi. Diversi concorrenti possono già generare clip altrettanto lunghi o più lunghi. La scommessa tecnica più ampia è che una forte rappresentazione video possa diventare una base per altre forme di intelligenza.
Dalla predizione video alla predizione di azioni
I segnali di controllo robotico sono previsioni temporali condizionate da osservazioni visive, quindi BFL usa la rappresentazione video di FLUX 3 come base per la predizione di azioni. La sua collaborazione con mimic robotics ha prodotto FLUX-mimic, in cui un decoder di azioni legge rappresentazioni dal modello video invece di addestrare un intero stack di percezione indipendente.
BFL riporta che il backbone di FLUX-mimic può funzionare in meno di 80 ms su una singola RTX 5090, mentre il sistema robotico completo raggiunge un ciclo di reazione di circa 101 ms. L’azienda ha inoltre discusso una valutazione industriale con Audi.
Questo non rende la Video API pubblica di FLUX 3 un’API per la robotica. Dimostra però perché BFL ha investito molto nella rappresentazione video multimodale invece di trattare la generazione video come un compito media isolato.
Quali sono i principali punti di forza di FLUX 3?
- Coerenza temporale e di scena. Il punteggio di Coerenza della scena di 94.76 di Megaton è la categoria principale più forte del modello.
- Generazione audiovisiva nativa. Dialoghi, effetti, ambienti sonori e visuali possono essere generati insieme invece di essere assemblati da modelli separati.
- Forte aderenza al prompt. Il risultato indipendente di Aderenza al prompt di 87.07 suggerisce che i punti di forza del modello vanno oltre la sola resa visiva.
- Controllo tramite keyframe. Fino a dieci immagini possono partecipare agli attuali workflow immagine‑video, offrendo controllo temporale esplicito.
- Workflow da bozza a finale. La Modalità Bozza affronta un vero problema di costo nel video AI: molte generazioni vengono scartate durante l’iterazione dei prompt.
- Ampia gamma visiva. BFL posiziona FLUX 3 come capace di output grezzi, naturali, cinematografici, nostalgici, giocosi, stilizzati e insoliti, non un unico stile di casa fisso.
- Direzione di ricerca verso il world model. Self-Flow e la predizione di azioni rendono FLUX 3 rilevante oltre la generazione di media.
Quali sono le limitazioni di FLUX 3?
- La roadmap multimodale completa non è stata ancora rilasciata. Non bisogna dare per scontati FLUX 3 Image pubblico e i pesi aperti di FLUX 3 Dev a partire dall’annuncio a livello di famiglia.
- 20 secondi non sono più la durata leader del settore. Alcuni concorrenti del 2026 supportano già generazioni da 30 secondi.
- La fisica non è risolta. Megaton assegna a FLUX 3 un punteggio Fisica di 70.63, considerevolmente sotto il punteggio di coerenza della scena.
- La fedeltà umana ha ancora margini di miglioramento. Un punteggio indipendente di 73.70 significa che anatomia difficile e movimento umano realistico possono ancora fallire.
- La continuazione video è costosa. Il prezzo di BFL per la continuazione è sostanzialmente più alto per secondo rispetto alla T2V/I2V ordinaria.
- Il benchmark competitivo di punta di BFL è interno. Le decisioni di produzione dovrebbero includere anche test indipendenti utilizzando i propri prompt, tipi di inquadratura, lingue e asset di riferimento.
Come usare FLUX 3 con CometAPI
La copertura precedente di FLUX 3 da parte di CometAPI spiega la fase di Early Access di luglio, i benchmark preliminari e il rollout pianificato. Questa sezione si concentra sull’integrazione in produzione attuale, i prezzi e il flusso API operativo per non ripetere quella guida storica. Il modello di produzione FLUX 3 utilizza l’ID modello flux-3.
Una richiesta 720p di base usa l’endpoint /v1/videos:
Bash
curl --request POST "https://api.cometapi.com/v1/videos" \--header "Authorization: Bearer $COMETAPI_KEY" \ --form-string "model=flux-3" \ --form-string "prompt=Una barchetta di carta scivola su uno stagno immobile nella tenue luce del mattino" \ --form-string "seconds=5" \ --form-string "size=1280x720" |
|---|
Il workflow video è asincrono. Dopo che la richiesta iniziale restituisce un task ID, l’applicazione controlla il task fino a quando la generazione è completa e poi recupera il video risultante. Per le applicazioni in produzione, la generazione dovrebbe normalmente essere gestita da un job in background o da una coda di task invece di mantenere una richiesta HTTP aperta per l’intero tempo di rendering.
Chi dovrebbe usare FLUX 3?
FLUX 3 è particolarmente interessante per applicazioni che richiedono più di clip visivamente attraenti di cinque secondi: sistemi pubblicitari con visuali e audio sincronizzati, produzione automatizzata di short‑form, dimostrazioni di prodotto in cui la persistenza degli oggetti conta, generazione di dialoghi multilingue, workflow da storyboard a video, animazione controllata da keyframe, contenuti educativi ed esperimenti con pipeline multimodali più lunghe.
Può essere meno attraente quando l’unico requisito è il costo per secondo più basso possibile, quando è necessario generare più di 20 secondi in un’unica passata, o quando la generazione di immagini statiche è il compito principale. Per le immagini statiche, un modello FLUX per immagini già esistente come FLUX.2 Max può attualmente essere più adatto.
FLUX 3 è migliore di altri modelli video AI?
Non esiste una risposta unica difendibile per ogni caso d’uso. La valutazione interna di BFL colloca il FLUX 3 rilasciato al primo posto nel suo confronto testo‑video, mentre la valutazione indipendente di Megaton colloca FLUX 3 terzo complessivamente dietro concorrenti più recenti. Entrambi i risultati possono essere validi perché i test misurano distribuzioni di prompt e dimensioni di qualità diverse.
FLUX 3 appare particolarmente forte quando contano coerenza della scena, aderenza al prompt, fedeltà degli oggetti, coerenza causale, resa del testo, suono sincronizzato e keyframe controllabili. Altri modelli possono vincere su durata massima, risoluzione, preferenze artistiche, fedeltà umana, workflow di editing o costo. Per gli sviluppatori, il confronto corretto è specifico per il carico di lavoro piuttosto che basato sulla classifica.
Domande frequenti
FLUX 3 è già disponibile?
Sì. FLUX 3 Video è diventato generalmente disponibile tramite BFL il 4 agosto 2026. CometAPI indica anche FLUX 3 come Available con ID modello flux-3. Il rilascio di FLUX 3 per immagini statiche e i pesi aperti FLUX 3 Dev restano elementi separati della roadmap.
FLUX 3 può generare audio?
Sì. FLUX 3 Video genera audio nativo sincronizzato, inclusi dialoghi, suoni ambientali ed effetti. Sono supportati anche dialoghi multilingue e sincronizzazione labiale.
Quanto possono essere lunghi i video generati da FLUX 3?
La generazione da testo e da immagine supporta attualmente 5–20 secondi. La continuazione video supporta 5–15 secondi di contenuto generato ex novo.
Quali risoluzioni supporta FLUX 3?
BFL supporta HD (fino a 1 megapixel per fotogramma), FHD (fino a 2 MP), QHD/2K (fino a 4 MP) e UHD/4K (fino a 8 MP). Un output FHD 16:9 è 1920 × 1088. Le fasce di risoluzione si basano sui pixel totali per frame piuttosto che sul rapporto di aspetto; la Modalità Bozza è solo HD.
FLUX 3 supporta l'immagine‑video?
Sì. Immagine‑video e generazione da keyframe fanno parte del set di funzionalità FLUX 3 Video generalmente disponibile.
FLUX 3 è un modello di generazione di immagini?
Dal punto di vista architetturale, FLUX 3 è addestrato su immagini, video e audio, e BFL ha dimostrato ricerca su generazione ed editing di immagini. Tuttavia, il prodotto FLUX 3 Image rimane un rilascio futuro; non confondere la roadmap della famiglia con l’attuale FLUX 3 Video API pubblica.
FLUX 3 è open source?
Non al momento. BFL ha annunciato FLUX 3 Dev, una variante multimodale a pesi aperti, ma non ha ancora fornito una data di rilascio pubblica.
Quanto costa FLUX 3?
BFL prezza testo/immagine‑video a $0.06/s per Draft HD, $0.17/s per HD, $0.29/s per FHD, $0.40/s per QHD e $0.80/s per UHD. Video‑to‑video costa $0.12/s per Draft HD, poi $0.41/s per HD, $0.53/s per FHD, $0.65/s per QHD e $0.95/s per UHD. CometAPI attualmente indica $0.136/s per 720p e $0.232/s per 1080p.
Che cos'è Self-Flow?
Self-Flow è l’approccio di flow matching auto‑supervisionato di BFL. È progettato per permettere a un modello generativo di sviluppare rappresentazioni interne utili senza dipendere da un modello di rappresentazione esterno. L’uso di livelli di rumore diversi tra i token incoraggia la rete a inferire le informazioni mancanti e a imparare relazioni tra osservazioni multimodali.
FLUX 3 è un world model?
Black Forest Labs posiziona FLUX 3 come una base per reality model, perché le sue rappresentazioni condivise si estendono dalla predizione audiovisiva verso la predizione di azioni fisiche. Definirlo un world model generale completo sarebbe più forte di quanto supporti l’evidenza attuale; una descrizione più precisa è un modello fondativo generativo multimodale esplicitamente progettato attorno a obiettivi di world modeling.
Conclusione
FLUX 3 rappresenta per Black Forest Labs un cambiamento più ampio rispetto a un aggiornamento convenzionale da un modello FLUX di immagini a un altro. La sua idea chiave è addestrare una rappresentazione multimodale condivisa del mondo, quindi utilizzare tale rappresentazione per video, suono, immagini ed eventualmente azioni. Self-Flow fornisce il fondamento di ricerca, mentre il modello FLUX 3 Video rilasciato è la prima dimostrazione produttiva di questa strategia.
A settembre 2026, FLUX 3 Video supporta clip fino a 20 secondi, 24 fps, output da HD a UHD/4K, audio sincronizzato, dialoghi multilingue, immagine‑video, keyframe, continuazione video, generazione multi‑shot e Modalità Bozza.
Il quadro dei benchmark è anche più credibile rispetto al lancio. La valutazione del modello rilasciato da BFL colloca FLUX 3 primo nel suo test ELO T2V interno, mentre i test indipendenti di Megaton lo collocano terzo complessivamente ed evidenziano una coerenza della scena particolarmente forte.
FLUX 3 non è quindi automaticamente il miglior modello video per ogni carico di lavoro. Seedance 2.5, MiniMax H3 e Wan 3.0 possono offrire generazione più lunga, risoluzione nominale più alta, prezzi più bassi o diverse capacità di riferimento ed editing.
Ciò che rende FLUX 3 particolarmente interessante è la direzione sottostante al generatore video: BFL scommette che le stesse rappresentazioni necessarie per predire video convincenti possano alla lunga supportare generazione di immagini, audio, ragionamento fisico e azioni robotiche. Gli sviluppatori possono già testare il primo passo in produzione tramite FLUX 3 su CometAPI utilizzando l’ID modello flux-3.