
Rispondi prima
GPT-6 Astra è il nuovo modello di punta di OpenAI per il lavoro end‑to‑end complesso. OpenAI ha rilasciato GPT-6 Astra il 3 settembre 2026, posizionandolo su ragionamento complesso, uso del computer, coding, ricerca, lavoro scientifico e creazione di artefatti professionali. Il modello API ha una finestra di contesto da 1,05M token e un output massimo di 128K, accetta input di testo e immagini e supporta lo sforzo di ragionamento da basso fino a massimo. Il prezzo API Standard parte da $10 input / $50 output per milione di token. Il cambiamento pratico più importante non è un salto uniforme su ogni benchmark di intelligenza generale: i guadagni maggiori di Astra compaiono nell’esecuzione agentica, nell’uso del computer, nel recupero su contesti lunghi, nei flussi di lavoro di coding, nella scienza e nella cybersecurity.
Questo è rilevante perché il precedente articolo di CometAPI GPT-6 Is Coming Soon — What Will It Look Like? era necessariamente speculativo. Ora che Astra è pubblico, questa guida si concentra sul comportamento confermato del modello, i compromessi sui benchmark, l’economia dell’API e dove il modello è effettivamente una scelta migliore rispetto ad alternative all’avanguardia più economiche.
Che cos’è GPT-6 Astra?
GPT-6 Astra è il successore del modello di punta GPT-5.6 Sol di OpenAI. OpenAI descrive Astra come il modello più capace per il lavoro end‑to‑end più difficile, con enfasi su flussi di lavoro che richiedono al modello di ragionare, usare strumenti, interagire con software, rivedere il lavoro intermedio e portare un compito dalla richiesta iniziale al risultato finale. Questo posizionamento è importante: Astra non è semplicemente un modello di chat più grande. È progettato per agire come motore di ragionamento all’interno di agenti che operano su browser, terminali, documenti, fogli di calcolo, ambienti di sviluppo e software aziendale.
Il post di lancio evidenzia risultati allo stato dell’arte in uso del computer, navigazione, ingegneria del software, cybersecurity, scienza e lavoro professionale. Riporta 97,6% / 99,9% / 100% su FrontierMath Tier 4, ARC-AGI-3 ed ExploitBench rispettivamente. Questi punteggi di copertina sono notevoli, ma non vanno interpretati come “Astra vince ogni benchmark”. Sull’Artificial Analysis Intelligence Index usato nella tabella comparativa di OpenAI, Astra segna 61,2 mentre Claude Fable 5.1 segna 65,7. Il rilascio va quindi inteso più come un salto nell’esecuzione e nel lavoro agentico che come una vittoria pulita su tutte le misure di intelligenza.
Cosa è cambiato rispetto a GPT-5.6 Sol?
L’uso del computer è diventato una capacità di prima classe
Il guadagno generazionale più chiaro di Astra è l’uso del computer. Su OSWorld 2.0, OpenAI riporta 72,6% per Astra contro 65,7% per GPT-5.6 Sol. Nella stessa simulazione di latenza, Astra ha completato i task in circa 40 minuti rispetto a circa 75 minuti per Sol, una riduzione di circa il 47%. Insieme a un harness Codex aggiornato, OpenAI riporta un completamento 1,9× più rapido su Mind2Web. Il punto pratico non è solo che Astra può “vedere” uno schermo; riesce a mantenere coerente più a lungo un compito software multistep facendo meno deviazioni costose.
La creazione di artefatti professionali è più ponderata
OpenAI ha esplicitamente addestrato Astra per flussi di lavoro professionali che terminano in artefatti utilizzabili invece che in prosa grezza. I materiali di lancio descrivono prestazioni più solide su documenti, fogli di calcolo, presentazioni, analisi dei dati, lavoro di design e aderenza a template. Astra è anche migliore nel mantenere l’orientamento quando i requisiti cambiano a metà del task, per cui un messaggio di steering è meno probabile che sovrascriva l’obiettivo originale. Questo è particolarmente utile negli agenti enterprise di lunga durata, dove spesso arrivano nuove istruzioni a workflow già iniziato.
Le sessioni lunghe conservano più contesto di lavoro utile
Per le sessioni di coding lunghe, Astra introduce un nuovo modo per Codex di preservare e recuperare appunti dopo che il contesto attivo si riempie. Gli approcci precedenti si basavano molto sulla compattazione, che può omettere perché una correzione tentata è fallita o quali vincoli erano già stati testati. OpenAI afferma che Astra può mantenere appunti oltre le finestre di contesto, migliorando la continuità durante grandi refactoring e sessioni di debugging.
Lo sforzo di ragionamento ora si estende fino a max
Gli sviluppatori possono scegliere uno sforzo di ragionamento low, medium, high, xhigh o max. Questo crea una curva qualità‑costo più ampia rispetto a trattare Astra come un singolo punto di funzionamento fisso. Le linee guida ufficiali sul modello raccomandano di selezionare lo sforzo più basso che soddisfi il tuo target di valutazione, perché la migliore economia del modello spesso deriva dall’efficienza sui token piuttosto che dall’esecuzione sempre al massimo ragionamento.
Prestazioni di benchmark di GPT-6 Astra
OpenAI ha pubblicato un ampio confronto che copre uso del computer, lavoro professionale, coding, ragionamento accademico, salute, cybersecurity, contesto lungo e allineamento. Il modo più utile di leggere la tabella è separare “intelligenza generale” da “capacità di completare lavoro con uso di strumenti”. Astra è solo marginalmente sopra Sol sull’Artificial Analysis Intelligence Index nella tabella di OpenAI, ma è nettamente avanti su diversi benchmark agentici e operativi.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Cosa suggerisce il delta |
|---|---|---|---|
| AutomationBench | 41,4% | 18,1% | Grande salto nei flussi di lavoro aziendali end‑to‑end |
| OSWorld 2.0 | 72,6% | 65,7% | Interazione con il computer e completamento dei task migliori |
| Terminal-Bench 4.0 | 57,9% | 37,3% | Grande miglioramento nel coding agentico basato su terminale |
| Terminal-Bench Science 0.1 | 64,6% | 22,4% | Grande avanzamento nei flussi scientifici che usano codice/strumenti |
| FrontierMath Tier 4 v2 | 97,6% | 83,0% | Ragionamento matematico di frontiera più solido |
| ExploitBench | 100,0% | 78,5% | Capacità di cybersecurity di classe Critical |
| SRE-Bench, one attempt | 88,0% | 55,9% | Lavoro di reverse engineering / SRE molto più forte |
| MRCR v2, 512K-1M | 96,3% | 73,8% | Recupero in contesti molto lunghi migliorato |
| AA Intelligence Index v4.1.1 | 61,2 | 60,9 | L’intelligenza generale è sostanzialmente piatta vs Sol |
Il disegno è insolitamente chiaro. Il vantaggio di Astra è maggiore quando un benchmark richiede interazione prolungata con uno strumento o un ambiente. AutomationBench sale da 18,1% a 41,4%; Terminal-Bench Science aumenta da 22,4% a 64,6%; e il benchmark long‑context MRCR migliora da 73,8% a 96,3% nella banda 512K–1M. Per contro, l’Artificial Analysis Intelligence Index passa da 60,9 a 61,2. Ecco perché descrivere Astra come “2,5× più costoso ma solo leggermente più intelligente” manca la vera proposta di valore del prodotto.
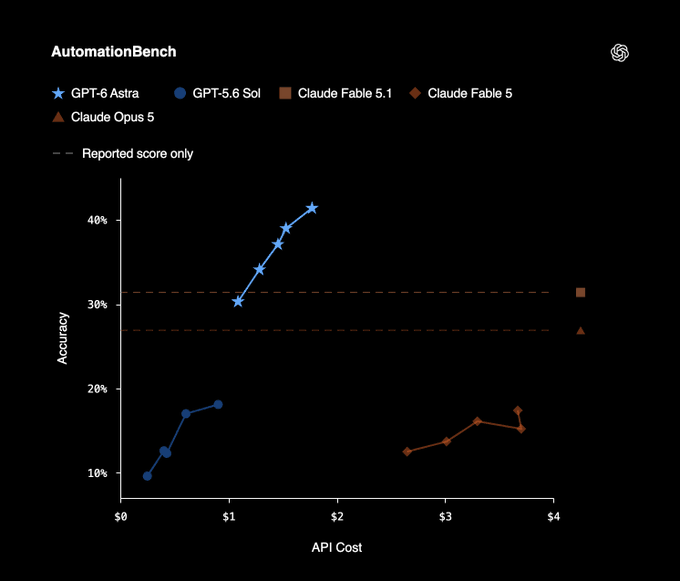
Fonte: OpenAI AutomationBench chart (immagine originale, non ridisegnata)
Benchmark indipendenti: GPT-6 Astra è un salto generazionale?
I test indipendenti offrono un importante controllo di realtà. Artificial Analysis riporta un punteggio Intelligence Index di 61, pari a GPT-5.6 Sol a sforzo max. Allo stesso tempo, Astra migliora sensibilmente sul Coding Agent Index e usa significativamente meno token nel coding agentico. Artificial Analysis ha misurato circa una riduzione tripla dell’uso di token rispetto a GPT-5.6 Sol a sforzo max nel suo harness Codex, permettendo ad Astra di ottenere un punteggio più alto a circa lo stesso costo per task di coding‑agent.
L’economia appare meno favorevole sull’intelligenza generale. Astra usa circa il 10% di token di output in meno rispetto a Sol nell’Intelligence Index a sforzo max, ma l’aumento di prezzo per token di 2,5× domina quel guadagno di efficienza; Artificial Analysis stima che Astra sia circa il 75% più costoso per task a sforzo max. Riporta inoltre una riduzione del tasso di allucinazioni dal 92% al 51% su AA-Omniscience mentre l’accuratezza è aumentata di quattro punti.
La conclusione utile è specifica per il carico di lavoro: GPT-6 Astra appare più “generazionale” dove un agente deve agire, iterare, usare strumenti e portare a termine un compito complicato. Per il ragionamento ordinario o la generazione di testo ad alto volume, il premio di prezzo può essere molto più difficile da recuperare.
GPT-6 Astra vs GPT-5.6 Sol vs Claude Fable 5.1 vs Gemini 3.8 Flash
Un confronto pratico per la selezione di modello dovrebbe includere capacità, multimodalità, contesto, esecuzione agentica e prezzo. I modelli seguenti non sono intercambiabili: Astra è ottimizzato per l’esecuzione end‑to‑end difficile, Claude Fable 5.1 guida alcune misure di intelligenza generale e Gemini 3.8 Flash offre prezzi dei token molto più bassi con input nativi più ampi.
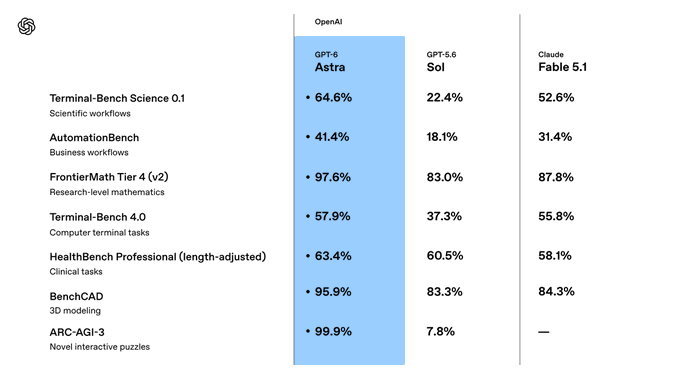
| Metrica | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Gemini 3.8 Flash |
|---|---|---|---|---|
| Finestra di contesto | 1,05M | 1,05M | 1M | 1,048M |
| Output massimo | 128K | 128K | 128K | 65,5K |
| Modalità di input | Testo, immagine | Testo, immagine | Testo, immagine/PDF | Testo, immagine, audio, video, PDF |
| AA Intelligence Index | 61,2 | 60,9 | 65,7 | 58,7 |
| AutomationBench | 41,4% | 18,1% | 31,4% | — |
| Terminal-Bench 4.0 | 57,9% | 37,3% | 55,8% | 19,1% |
| DeepSWE 1.1 | 74,1% | 72,7% | 67,4% | 73,8% |
| FrontierMath Tier 4 v2 | 97,6% | 83,0% | 87,8% | — |
| HLE con strumenti | 57,2% | — | 65,0% | — |
| HealthBench Professional | 63,4% | 60,5% | 58,1% | 52,1% |
| Prezzo ufficiale standard input | $10/M | $4/M | $10/M | $0,75/M |
| Prezzo ufficiale standard output | $50/M | $20/M | $50/M | $3,75/M |
Quando GPT-6 Astra è la scelta migliore
Scegli Astra quando il task è costoso perché gli umani devono salvare esecuzioni agent fallite: grandi modifiche di codice, automazione di browser/desktop, ricerca approfondita che attraversa strumenti, creazione di artefatti tecnici o flussi di lavoro scientifici e operativi complessi. Il suo premium si giustifica più facilmente quando meno retry, meno correzioni manuali e un minore uso di token di output contano più del prezzo per token.
Quando Claude Fable 5.1 è la scelta migliore
Claude Fable 5.1 resta un serio concorrente di frontiera. Nella tabella di lancio di OpenAI, segna 65,7 sull’Artificial Analysis Intelligence Index contro 61,2 di Astra, e 65,0 su Humanity’s Last Exam con strumenti contro 57,2 di Astra. Ciò significa che Astra non dovrebbe essere presentato come vincitore universale dell’intelligenza. Se il tuo set di valutazione assomiglia più a ragionamento long‑form che a esecuzione con uso del computer, Claude Fable 5.1 può ancora essere l’opzione più adatta.
Quando Gemini 3.8 Flash è la scelta migliore
Gemini 3.8 Flash mira a un punto diverso della frontiera. Supporta input di testo, immagine, audio, video e PDF con una finestra di contesto di circa 1M token, mentre il prezzo introduttivo ufficiale è molto al di sotto di Astra. Per estrazione multimodale ad alto volume, comprensione di video/audio, agenti di routine o carichi di lavoro dove l’economia dei token $10/$50 è difficile da giustificare, Gemini 3.8 Flash è spesso la scelta più economica in produzione.
Perché la valutazione di cybersecurity di GPT-6 Astra è importante
Astra è il primo modello OpenAI ampiamente distribuito a raggiungere la soglia di capacità di cybersecurity Critical secondo il Preparedness Framework dell’azienda. OpenAI afferma che il modello può identificare falle di sicurezza precedentemente sconosciute e sviluppare strategie di exploit su sistemi rafforzati quando dotato degli strumenti e degli accessi giusti. Nelle valutazioni di lancio, Astra ha segnato 100% su ExploitBench, 42,4% su ExploitGym e 88,0% su SRE-Bench in un tentativo.
Questa capacità comporta controlli di distribuzione più restrittivi. OpenAI afferma che le protezioni di produzione possono rallentare, mettere in pausa o fermare lavori legittimi, in particolare nei contesti cyber a rischio più elevato. ChatGPT o Codex possono chiedere a un utente di rivedere un’azione prima di proseguire, mentre un task API può fermarsi. La distribuzione predefinita di Astra rifiuta anche richieste più avanzate di creazione di exploit; il programma Daybreak fornisce accesso separato e verificato per alcuni flussi di lavoro difensivi.
La system card documenta un compromesso sulla monitorabilità: in generale Astra è meglio allineato di Sol, ma il suo ragionamento scritto può essere più difficile da monitorare in condizioni di valutazione avversariale. OpenAI quindi distribuisce un monitoraggio del disallineamento più ampio attorno all’inferenza agentica di Astra con strumenti. I team enterprise dovrebbero trattare permessi degli agenti, confini di approvazione, log di audit e accesso agli strumenti a privilegio minimo come parte dell’architettura del modello, non come componenti opzionali.
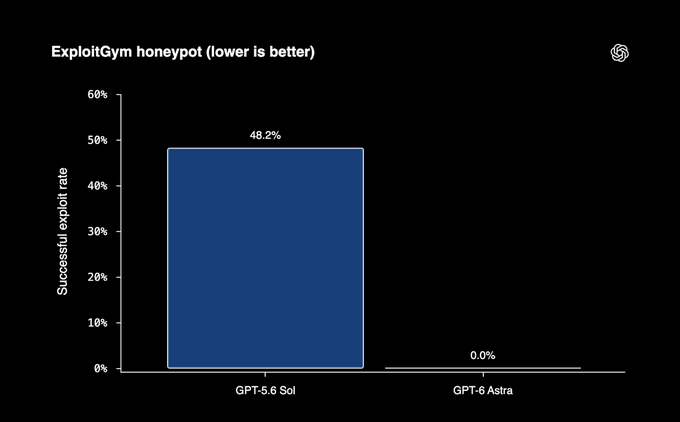
Fonte: OpenAI official ExploitGym honeypot safety chart (immagine originale, non ridisegnata)
Prezzi di GPT-6 Astra
La pagina prezzi API attuale di OpenAI separa le richieste a contesto breve e lungo. Per l’elaborazione Standard, le tariffe a contesto breve sono $10 input, $1 input in cache, $12,50 scritture di cache e $50 output per milione di token. Le richieste oltre 272K token di input usano lo schema per contesto lungo: $20 input, $2 input in cache, $25 scritture di cache e $75 output per milione di token.
| Elaborazione / contesto | Input | Input in cache / scrittura cache | Output |
|---|---|---|---|
| Standard, contesto breve | $10/M | $1/M / $12,50/M | $50/M |
| Standard, contesto lungo (>272K input) | $20/M | $2/M / $25/M | $75/M |
| Batch / Flex, contesto breve | $5/M | $0,50/M / $6,25/M | $25/M |
| Batch / Flex, contesto lungo | $10/M | $1/M / $12,50/M | $37,50/M |
| Fast mode, contesto breve | $20/M | $2/M / $25/M | $100/M |
| Fast mode, contesto lungo | $40/M | $4/M / $50/M | $150/M |
Rispetto a GPT-5.6 Sol, i prezzi per token Standard a contesto breve di Astra sono 2,5× più alti ($10/$50 contro $4/$20). Quel premium non implica automaticamente un costo per task completato 2,5× più alto. Nel coding agentico, sia OpenAI sia Artificial Analysis riportano un uso di token di output inferiore per Astra in alcune configurazioni. L’unità corretta per la valutazione è quindi il costo per task riuscito, non il solo costo per token.
Come accedere a GPT-6 Astra
OpenAI ha iniziato un rollout scaglionato il 3 settembre 2026. Astra è programmato per arrivare agli utenti ChatGPT Plus, Pro, Business ed Enterprise, all’API OpenAI e su AWS nei giorni successivi. Gli amministratori enterprise possono abilitare Astra per workspace, e l’accesso è disattivato di default al lancio.
Chiamare GPT-6 Astra con la OpenAI Responses API
from openai import OpenAI
client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "high"},
    input=(
        "Analizza l'architettura di questo repository. Identifica il problema di progettazione a rischio più elevato, spiega le evidenze e proponi un piano di migrazione."
    ),
)

print(response.output_text)
L’ID del modello è gpt-6-astra. Per i flussi di lavoro ricchi di strumenti, la Responses API è il punto di partenza naturale perché Astra supporta function calling, structured outputs, web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP e tool search. Il fine-tuning non è attualmente supportato.
Casi d’uso reali di GPT-6 Astra
Sviluppo di giochi e flussi di lavoro software visuali
Playco ha testato Astra dentro Playbot, un IDE potenziato dall’AI che lavora direttamente in Unity e Godot. OpenAI riporta il 50% di correzioni manuali in meno rispetto al modello precedente, e tre prototipi a tema costruiti da una singola base “grey‑box”. Questo esempio è importante perché il task richiede più della generazione di sorgenti: il modello deve ragionare sul layout spaziale, giocare, testare le modifiche, identificare bug e iterare in un ambiente visuale.
Revisione di documenti legali e finanziari
OpenAI posiziona Astra per flussi di lavoro professionali multistep che producono documenti, fogli di calcolo e analisi rifiniti. Nella revisione legale e finanziaria, il suo valore pratico è mantenere lo stato del task attraverso molti file, verificare incrociando le evidenze e restituire un artefatto finito invece di rispondere a una singola domanda isolata. La validazione da parte di esperti, i controlli di approvazione e l’accesso ai dati a privilegio minimo restano necessari.
Agenti di ingegneria a lungo orizzonte
La combinazione di risultati su Terminal-Bench, DeepSWE, migrazione di database, uso del computer e contesto lungo rende Astra particolarmente rilevante per l’ingegneria alla scala del repository. Un modello di distribuzione utile è dare ad Astra un ambiente di sviluppo vincolato, un issue o un obiettivo di migrazione, test e accesso agli strumenti; quindi valutare il successo sulla qualità dei task unificati, il numero di iterazioni fallite, il tempo di revisione umana e il costo totale. Questa è una metrica di produzione migliore di un singolo punteggio di benchmark di coding.
Limitazioni di GPT-6 Astra
- Prezzo per token premium. Astra costa 2,5× GPT-5.6 Sol per token ai prezzi Standard a contesto breve, quindi chat di routine, classificazione, estrazione e drafting semplice sono spesso poco economici.
- Il contesto lungo ha una maggiorazione. Le richieste con più di 272K token di input passano a tariffe più alte per l’intera richiesta, quindi “contesto 1,05M” non va interpretato come memoria a prezzo fisso.
- Nessun input audio o video nativo nel modello. Astra accetta testo e immagini e produce testo; Gemini 3.8 Flash è più flessibile quando la comprensione audio/video nativa è centrale per il carico di lavoro.
- Nessun fine-tuning. La pagina ufficiale del modello attualmente indica che il fine-tuning non è supportato, quindi la personalizzazione si basa su prompting, strumenti, retrieval e design del workflow.
- Le protezioni cyber possono interrompere i flussi di lavoro. OpenAI avverte esplicitamente che controlli di sicurezza aggiuntivi possono mettere in pausa o fermare lavoro legittimo in contesti a rischio più alto.
- Non è un vincitore universale dei benchmark. Claude Fable 5.1 supera Astra sull’Artificial Analysis Intelligence Index e su HLE‑con‑strumenti nelle cifre incluse nel confronto pubblicato da OpenAI.
FAQ
GPT-6 Astra è stato rilasciato ufficialmente?
Sì. OpenAI ha iniziato il rollout il 3 settembre 2026. La disponibilità è scaglionata tra organizzazioni, piani ChatGPT a pagamento, accesso API e AWS, invece di apparire per ogni account nello stesso momento.
Qual è la finestra di contesto di GPT-6 Astra?
La pagina ufficiale del modello indica una finestra di contesto da 1,05M token e un output massimo di 128K token. Le richieste oltre 272K token di input usano il listino per contesto lungo.
Quanto costa GPT-6 Astra?
Il prezzo Standard a contesto breve è $10 input / $50 output per milione di token, con $1 input in cache e $12,50 scritture di cache. Contesto lungo, Batch/Flex e Fast mode hanno tariffe diverse, quindi le stime di produzione dovrebbero usare il tier che corrisponde alla richiesta effettiva.
GPT-6 Astra è migliore di Claude Fable 5.1?
Dipende dal carico di lavoro. Astra è in vantaggio su diverse valutazioni di uso del computer, coding‑agent, scienza, cyber e lavoro professionale, mentre Claude Fable 5.1 supera Astra sull’Artificial Analysis Intelligence Index e su HLE con strumenti nel confronto pubblicato da OpenAI. Usa le tue valutazioni di agente/task invece di assumere che un modello domini ogni categoria.
GPT-6 Astra è AGI?
Le pagine prodotto ufficiali di OpenAI descrivono Astra come una nuova generazione di intelligenza e il suo modello più capace ampiamente distribuito, ma non definiscono il prodotto stesso come “AGI”. La saturazione dei benchmark su alcuni compiti non equivale a una definizione universale e condivisa di AGI.
Conclusione
GPT-6 Astra va compreso come un modello di frontiera focalizzato sull’esecuzione. La prova più forte del progresso non è il piccolo movimento da 60,9 a 61,2 rispetto a GPT-5.6 Sol sull’Artificial Analysis Intelligence Index; è il miglioramento molto maggiore nell’uso del computer, nel coding agentico, nei flussi di lavoro scientifici, nel recupero su contesti lunghi, nel completamento di task professionali e nella cybersecurity. La finestra di contesto da 1,05M e lo stack di strumenti profondo offrono agli sviluppatori più spazio per costruire agenti che restano utili oltre una singola risposta.
Il compromesso è il prezzo. Il pricing Standard $10/$50 è premium, le richieste a contesto lungo costano di più e test indipendenti mostrano che Astra può essere significativamente più costoso di Sol su carichi di lavoro di intelligenza generale. Il modello guadagna quel premium quando migliori tassi di completamento e minori correzioni umane superano il costo dei token. Per carichi di lavoro più semplici o ad alto volume, GPT-5.6, Claude Fable 5.1 e soprattutto Gemini 3.8 Flash restano alternative pertinenti piuttosto che predecessori obsoleti.