Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
無料で始める 無料で始める
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog GPT-6 Astra API の最適な代替サービス:料金、ベンチマーク、ユースケース GPT-6 Astra API の最適な代替サービス:料金、ベンチマーク、ユースケース - CometAPI
ai-comparisons / CometAPIリサーチ
GPT-6 Astra API の最適な代替サービス:料金、ベンチマーク、ユースケース GPT-6 Astra API の最適な代替手段(Claude Opus 5、Claude Fable 5.1、GPT-5.6 Sol、Gemini 3.8 Flash、Claude Sonnet 5、DeepSeek V4.1 Flash を含む)
Deon Goodwin AIモデルとAPIの調査チーム GPT-6 Astra API の最適な代替手段(Claude Opus 5、Claude Fable 5.1、GPT-5.6 Sol、Gemini 3.8 Flash、Claude Sonnet 5、DeepSeek V4.1 Flash を含む)
この要約で素早く答えを把握し、ガイドで背景、例、実装詳細を確認してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)TL;DR: どの GPT-6 Astra API 代替を選ぶべきか?
ワークロード別にモデルを選ぶ: 最も近いプレミアム代替としては Claude Opus 5、持続的に最難度の推論には Claude Fable 5.1、最小摩擦での OpenAI 移行には GPT-5.6 Sol、高ボリューム運用には Claude Sonnet 5、低コストのマルチモーダル作業には Gemini 3.8 Flash、トークンコストが最重要なら DeepSeek V4.1 Flash。
一方で、コンピュータ操作、自律実行、科学的推論、サイバーセキュリティでの性能が再試行や人的介入を大幅に減らすワークロードには、GPT-6 Astra を維持する。
重要ポイント: GPT-6 Astra を置き換える際に重要な点は?
GPT-6 Astra は、最も得意なエージェント系タスクでは代替が難しい。公式の GPT-6 Astra ベンチマーク表 では、Terminal-Bench 4.0 で 57.9%、FrontierMath Tier 4 で 97.6%、GPQA Diamond で 96.0% を記録。
Claude Opus 5 はまず検証すべき最もバランスの取れた直接代替候補。Anthropic は Opus 5 を入力/出力それぞれ $5/$25(百万トークンあたり)に設定しており、Astra の基本料金の半額。
Claude Fable 5.1 は予算向け代替ではない。
明確性、出典の帰属、最新のAPI用語について確認済みです。
GPT-5.6 Sol は真のプラットフォーム切り替えというより摩擦の少ないダウングレード。1.05M のコンテキストウィンドウ、128K の最大出力、$4/$20 の価格により、OpenAI アプリの移行負荷が小さい。
DeepSeek V4 Flash は異なるコスト階層。公式のピーク/オフピーク料金はプレミアムモデルの価格を大きく下回るが、低トークンコストだけでは同等のエージェント成功率は担保されない。
最良の本番指標は通常、受理済み完了タスクあたりのコスト。再試行、ツール失敗、レイテンシ、出力トークン使用、人手による手直しを含めて評価すること。
GPT-6 Astra API とは? Astra は長時間の実行を想定した設計で、一般的なチャットボットとは異なる。公式の機能概要は、ソフトウェアエンジニアリング、ブラウジング、科学、サイバーセキュリティ、複雑な推論に加えて、コンピュータ使用とプロフェッショナルワーク を強調している。
API model ID gpt-6-astra Provider OpenAI Context window 1,050,000 tokens Maximum output 128,000 tokens Input Text, images Output Text Knowledge cutoff April 30, 2026 Reasoning effort Low, medium, high, xhigh, max Standard input price $10 / 1M tokens Cached input $1 / 1M tokens Standard output price $50 / 1M tokens Long-context threshold More than 272K input tokens
なぜチームは GPT-6 Astra 以外も検討するのか Astra は、追加の能力によって失敗、ツールエラー、手動介入、弱いモデルでの繰り返し呼び出しを排除できるときに最も魅力的だ。要約、抽出、分類、一般的な RAG、通常のチャット、標準的なコード生成では、プレミアム価格の正当化が難しくなる。
そのため、コスト削減、既存プロバイダーエコシステムの維持、キャッシュ経済性の改善、マルチモーダル対応の追加、あるいは Astra をエスカレーション用に温存しつつ日常トラフィックに高速モデルを使うために代替案を評価する。
ベンチマーク比較と制約
エビデンスノート: 表では、OpenAI の公開する比較フレームワークを用い、複数の代替モデルを共通のセットアップで配置している。これらのベンダー報告スコアは、モデルスナップショット、プロンプト、ツール、評価手法により変動しうる。候補の絞り込みに使い、最終候補は本番に近いタスクで検証すること。
Terminal-Bench 4.0 57.9% 37.3% 55.8% 52.6% 19.1% DeepSWE v1.1 74.1% 72.7% 67.4% 73.7% 73.8% FrontierCode 1.1 Extended 64.5% 60.6% 63.6% 63.6% 56.3% GPQA Diamond 96.0% 94.6% 93.7% 93.7% 95.3% FrontierMath Tier 4 97.6% 83.0% 87.8% 73.2% — Humanity’s Last Exam, with tools 57.2% — 65.0% 63.6% —
この結果は、どのモデルも「万能な Astra の代替」ではないことを示している。Astra はいくつかのエージェント系および科学系評価で明確なリードを持つ一方で、Fable 5.1 は Humanity’s Last Exam で上回り、DeepSWE ではいくつかの代替が非常に近い。
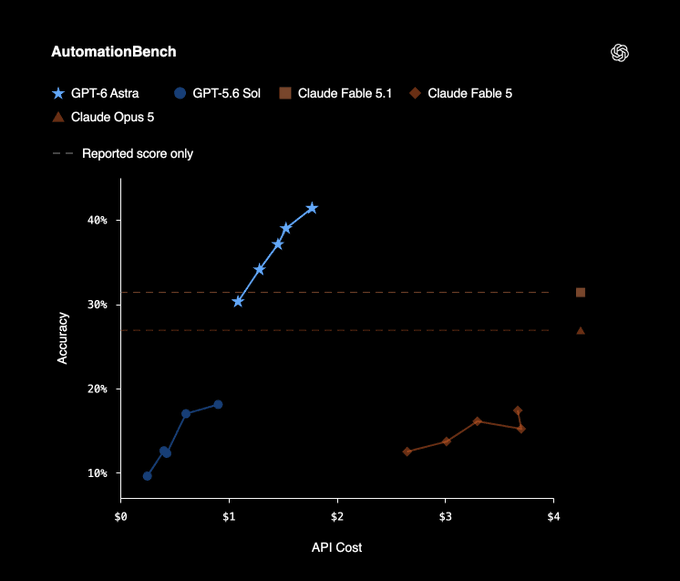
OpenAI 公式の AutomationBench ベンチマーク図。
また、公的なベンチマーク指標は、手法やモデルスナップショットの改訂に伴って変わりうる。候補を絞り込むために使いつつ、ワークロード固有の評価を置き換えるものではない。
GPT-6 Astra の代替 どの単一モデルも、あらゆるワークロードで Astra を置き換えない。最も実用的な選択は、必要な能力、既存のプロバイダーエコシステム、失敗や再実行のコストによって決まる。
Claude Opus 5 $5 / $25 1M 最も近い全体的なプレミアム代替 Claude Fable 5.1 $10 / $50 1M 最難度の推論と長時間エージェント GPT-5.6 Sol $4 / $20 1.05M OpenAI からの最小摩擦移行 Claude Sonnet 5 $2 / $10 1M 高ボリュームのプロダクション Gemini 3.8 Flash $0.75 / $3.75 promotional 1M 低コストのマルチモーダル作業 DeepSeek V4.1 Flash $0.22–$0.44 / $0.66–$1.32 1M 最低トークンコストと高ボリューム処理
Claude Opus 5
検討理由 Claude Opus 5 は、Astra より低いリスト価格でプレミアムな推論、コーディング、プロフェッショナルワーク性能が必要な場合に最初に試すべき代替。
価格、コンテキスト、キャッシュ Anthropic は Claude Opus 5 を入力 $5/M、出力 $25/M とし、1M トークンのコンテキストウィンドウを提供。運用予算化前に最新のキャッシュ条件を確認すること。
得意分野 コーディング、分析、プロフェッショナルライティング、エージェントワークフローで競争力があり、引用ベンチマーク表では DeepSWE と FrontierCode で Astra に近い。
制約 常に Astra を上回るわけではない。コンピュータ操作、高度な自律実行、サイバーセキュリティ、OpenAI ネイティブのツールが中核となる場合は Astra が依然有力。
適している用途 / 避けるべき用途 適している用途: プレミアムなコーディングエージェント、複雑な分析、プロフェッショナルライティング。 避けるべき用途: ワークフローが Astra 固有のツールやコンピュータ使用能力に大きく依存する場合。
Claude Fable 5.1
検討理由 Claude Fable 5.1 は、低コスト代替ではなく、最難度の推論、リサーチ、コーディング、長時間のエージェントタスク向けの競合フラッグシップ。
価格、コンテキスト、キャッシュ 入力 $10/M、出力 $50/M のレートは Astra の見出し価格に一致。1M トークンのコンテキストウィンドウと $0.25/M のキャッシュリード価格により、大きなプロンプトの頻繁な再利用時に経済性が向上。
得意分野 持続的な推論とキャッシュ重視のエージェントに特に魅力があり、引用比較ではツール使用ありの Humanity’s Last Exam で Astra を上回る。
制約 見出しトークンレートを下げるわけではなく、いくつかのエージェント系・科学系ベンチマークや OpenAI ネイティブツールでは Astra に優位性が残る。
適している用途 / 避けるべき用途 適している用途: 最大限の推論品質と長コンテキストの反復ワークフロー。 避けるべき用途: 標準トークン価格を大幅に下げることが主目的の場合。
GPT-5.6 Sol
検討理由 GPT-5.6 Sol は、OpenAI 互換の挙動やツールに基づくアプリケーションにとって、最小摩擦の移行経路を提供する。
価格、コンテキスト、キャッシュ 引用されたモデル仕様では、入力 $4/M、出力 $20/M、1.05M のコンテキストウィンドウ、128K の最大出力。最終予算化前に最新のキャッシュ入力条件を確認。
得意分野 DeepSWE と GPQA Diamond では Astra に近い水準を維持しつつ、標準の短コンテキスト階層では大幅に安価。
制約 Terminal-Bench や FrontierMath に代表されるタスクでは差が広がるため、タスク完了の弱さが再試行や手直しを増やすなら節約は消える可能性がある。
適している用途 / 避けるべき用途 適している用途: 既存の OpenAI アプリケーション、Astra の最強エージェント能力を必要としない一般的なワークロード。 避けるべき用途: Astra の大幅なベンチマーク優位が繰り返し効くワークロード。
Claude Sonnet 5
検討理由 Claude Sonnet 5 は、すべての要求でフロンティアフラッグシップを要しない、堅実で再現性のある知的作業の実用的なプロダクションデフォルト。
価格、コンテキスト、キャッシュ 恒久レートは入力 $2/M、出力 $10/M、コンテキストウィンドウは 1M トークン。プロンプト再利用の多い導入では最新のキャッシュ条件を確認。
得意分野 チケット分類、ドキュメント抽出、標準 RAG、コンテンツ変換、コード解説、日常的な関数呼び出し、構造化生成に適する。
制約 すべての長期的・最先端の推論問題で Astra を代替できるわけではない。
適している用途 / 避けるべき用途 適している用途: 高ボリュームの本番トラフィックと日常的な業務自動化。 避けるべき用途: 難易度の高いエージェントタスクでの失敗がフラッグシップモデルのプレミアムより高くつく場合。
Gemini 3.8 Flash
検討理由 Gemini 3.8 Flash は、マルチモーダル入力、大きなコンテキスト、低コストのホスト型 API を組み合わせ、ドキュメント、メディア、コーディング、バッチのパイプラインに適する。
価格、コンテキスト、キャッシュ 導入レートは 2026 年 12 月 31 日まで入力 $0.75/M、出力 $3.75/M。コンテキストウィンドウは 1M トークン、プロモ期間中はキャッシュも割引。
得意分野 マルチモーダル抽出、PDF、音声、動画、画像、大規模ドキュメントコレクション、バッチ分析、コスト重視のコーディングワークロードに好適。
制約 プロモ価格は期間限定で、最難度の自律エージェントやコンピュータ使用タスクでは Astra と比較したワークロード固有の検証が必要。
適している用途 / 避けるべき用途 適している用途: 低コストのマルチモーダルと高ボリュームのバッチ処理。 避けるべき用途: トークンコストに関わらず最強の自律実行が必要なアプリケーション。
DeepSeek V4.1 Flash
検討理由 DeepSeek V4.1 Flash は、高スループットの推論、コーディング、要約、抽出、分類、オフライン処理向けのコスト優先オプション。
価格、コンテキスト、キャッシュ ピーク/オフピークのスケジュールでは、キャッシュヒット入力 $0.007–$0.014/M、キャッシュミス入力 $0.22–$0.44/M、出力 $0.66–$1.32/M、コンテキストウィンドウは 1M トークン。公開前に最新の V4.1 価格ページを再確認すること。
得意分野 トークンコストが支配的で、ルーティング、検証、オフラインの品質チェックでばらつきを管理できる場合に魅力的。
制約 大幅に低いトークン価格は、同等の自律タスク成功率を保証しない。信頼性、ツール挙動、レイテンシ、受理率は対象ワークロードで測定すべき。
適している用途 / 避けるべき用途 適している用途: 検証付きの大規模・コスト重視処理。 避けるべき用途: 高価値の自律ラン失敗がトークン節約を上回る場合。
GPT-6 Astra と代替の比較: 各カテゴリでの勝者は? 価格、アーキテクチャ、コンテキスト、ベンチマークの証拠を総合すると、単純な一位から六位のランキングより有用な意思決定表になる。
Overall Astra alternative Claude Opus 5 Astra のリスト価格の半額で強力な準フロンティア性能 Maximum reasoning Claude Fable 5.1 フラッグシップ級の推論と長期性能 Stay inside OpenAI GPT-5.6 Sol 類似の API エコシステムと 60% 低いトークン価格 High-volume production Claude Sonnet 5 $2/$10 での高品質 Multimodal price/performance Gemini 3.8 Flash 1M コンテキストと非常に低い 2026 年導入価格 Lowest API cost DeepSeek V4.1 Flash $0.22–$0.44(入力)と $0.66–$1.32(出力) Computer-use-heavy agents GPT-6 Astra Astra の明確な差別化要因の一つ Scientific and difficult mathematical workflows GPT-6 Astra FrontierMath と科学系エージェントで非常に強力 Cache-heavy long agents Claude Fable 5.1 $0.25/M のキャッシュリード
最も重要なポイントは、GPT-6 Astra がいくつかのカテゴリで依然優位だということ。代替記事で、より安いモデルが普遍的に置き換えられると示唆すべきではない。Astra を全域で使えば高くつくが、完了率の高さで弱いモデルの複数回試行を置き換えられるなら、依然として経済的になりうる。
GPT-6 Astra の置き換えで実際にどれだけ節約できる? 未キャッシュの入力トークン 100 万、出力トークン 20 万を消費するワークロードを考える。キャッシュ割引、ツール料金、再試行、バッチ価格、長コンテキストの追加料金を無視すると:
GPT-6 Astra $20.00 Claude Fable 5.1 $20.00 Claude Opus 5 $10.00 GPT-5.6 Sol $8.00 Claude Sonnet 5 $4.00 Gemini 3.8 Flash promotional rate $1.50 DeepSeek V4.1 Flash off-peak $0.35
total_cost =
(input_tokens / 1,000,000 * input_rate)
+
(output_tokens / 1,000,000 * output_rate)
この単純な例は、トークン価格だけが唯一の指標になり得ない理由も示す。$20 の Astra リクエストが一度で成功し、$4 のモデルが 6 回の試行、複数のツール再試行、人手の修正を要するなら、実際には Astra のほうが安かった。
cost_per_accepted_task =
total_model_and_tool_cost
/
number_of_tasks_accepted_without_rework
この数値を、レイテンシ、タスク成功、再試行率、ツールコールエラー、人へのエスカレーション率と併せて追跡する。
マルチモデル API レイヤの実用的な利点は、評価がプロバイダー統合プロジェクトにならなくてよいこと。CometAPI は、GPT-6 Astra API 、GPT-5.6、Claude Fable 5.1、Claude Sonnet 5、Gemini 3.8 Flash、DeepSeek V4.1 Flash を一つのモデルカタログで提供する。
OpenAI 互換クライアントを使えば、モデルをハードコードせず設定可能にできる:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

model = "claude-fable-5-1"

response = client.chat.completions.create(
    model=model,
    messages=[
        {
            "role": "user",
            "content": "Review this migration plan and identify the three highest-risk assumptions.",
        }
    ],
)

print(response.choices[0].message.content)
同じ評価セットを、次のようなモデル ID を使って再実行できる:
gpt-6-astra
gpt-5.6
claude-fable-5-1
claude-sonnet-5
gemini-3.8-flash
deepseek-v4-flash
これは、ベンチマークのリーダーボードから代替を選ぶだけより有益だ。100~500 の本番代表プロンプトを取り、タスク成功、人の受理、再試行、ツールエラー、総トークン、レイテンシ、総 API コストを記録する。
GPT-6 Astra を 1 モデルで置き換えるべきか、モデルルーティングを使うべきか? 多くのアプリでは、Astra を 1 つの普遍モデルに置き換えるのは誤った最適化だ。より効率的なアーキテクチャは次のようになる:
日常トラフィック → Claude Sonnet 5、Gemini 3.8 Flash、または DeepSeek V4.1 Flash
難しい推論 → Claude Opus 5 または GPT-5.6 Sol
非常に難しい長期タスク → Claude Fable 5.1 または GPT-6 Astra
コンピュータ使用や Astra 固有のエージェントワークフロー → GPT-6 Astra
これにより、Astra はデフォルトモデルではなくエスカレーションモデルになる。本当にフロンティアエージェント性能が必要なのが 10% のリクエストだけなら、100% を Astra に通すのは、残り 90% にもそのプレミアムを支払うことになる。
どの GPT-6 Astra API 代替を選ぶべきか? Claude Opus 5 を選ぶ — 品質と価格のバランスが最も近い。
Claude Fable 5.1 を選ぶ — 見出しトークンレートより推論最大化を重視するなら。
GPT-5.6 Sol を選ぶ — 既に OpenAI を使っており、最小の統合変更で移行したいなら。
Claude Sonnet 5 を選ぶ — 本番トラフィックの大半が堅実だが平凡な知的作業なら。
Gemini 3.8 Flash を選ぶ — マルチモーダル、スケール、低ホスト API コストが重要なら。
DeepSeek V4.1 Flash を選ぶ — トークンコストが支配的で、より多くの評価と検証を許容できるなら。
そして、GPT-6 Astra 自体 を選ぶのは、コンピュータ使用が強い、難しい自律ソフトウェア作業、科学的推論などのエージェント能力でアプリが真に恩恵を受ける場合。
最大の誤りは「間違った」フロンティアモデルを選ぶことではない。そもそもフロンティアモデルを必要としないリクエストに、その価格を支払うことだ。
FAQ GPT-6 Astra API の全体的な最良代替は?
Claude Opus 5 は最も強力な汎用代替の一つ。1M コンテキストウィンドウ、強力なコーディングおよびエージェント能力、$5/$25 のリスト価格で、Astra の標準トークンレートの半額。
ここで扱ったモデルの中では、DeepSeek V4.1 Flash が最も低いファーストパーティトークン価格。現行のオフピークは未キャッシュ入力 $0.22/M、出力 $0.66/M。ただし、安価であることは Astra の自律タスク成功率に匹敵することを意味しない。
Claude Fable 5.1 は GPT-6 Astra より優れている?
どちらのモデルもすべてのワークロードを制するわけではない。OpenAI の比較では Astra が FrontierMath Tier 4 と Terminal-Bench 4.0 で大きな優位を示す一方、Fable 5.1 はツール使用ありの Humanity’s Last Exam でより高得点。
GPT-6 Astra 後でも GPT-5.6 Sol を使う価値はある?
ある。標準 API 価格が $4/$20 と Astra の $10/$50 を大きく下回りつつ、1.05M のコンテキストウィンドウを維持。Astra の利得がタスク完了を実質的に改善しないワークロードでは、より良いデフォルトになり得る。
Gemini 3.8 Flash は GPT-6 Astra の代替として十分?
一部のコーディング、マルチモーダル、ドキュメント、バッチ処理ワークロードでは十分。劇的に安価で、1M コンテキストウィンドウを持つ。最難度の自律エージェントやコンピュータ使用タスクでは、Astra が依然として強い。
GPT-6 Astra は非常に長いプロンプトで価格面の不利がある?
ある。入力が 272K トークンを超えると、OpenAI はより高い価格帯を適用するため、長コンテキストのリクエストは別枠で予算化すべき。
モデル比較ではトークン価格とベンチマークのどちらを使うべき?
両方をスクリーニング指標として使う。本番で最も重要なのは、通常は受理済み完了タスクあたりのコストであり、推論トークン、再試行、ツールコール、レイテンシ、人手の手直しを含めて評価すること。
同じアプリで複数の GPT-6 Astra 代替を併用できる?
できる。多くのアプリでは、あらゆるリクエストを 1 つのモデルに委ねるより、モデルルーティングのほうが望ましい。低コストモデルで日常リクエストを処理し、より強力なモデルで難易度に応じてエスカレーションするのが有効だ。