
TL;DR
Claude Haiku 5.5 と GPT-6 Luna は、大量の API ワークロード向けの低コスト推論モデルです。どちらも入力トークン100万あたり$0.10、出力トークン100万あたり$0.50から開始します。Anthropic のローンチ資料で公開された6つの比較では、Haiku がいずれも上回っています。Luna は 272K 入力トークンまで基本レートを維持する一方、Haiku のしきい値は 100K です。開発者にとって重要な指標は、受理率、エンドツーエンドのレイテンシ、API 互換性、そして受理結果あたりのコスト(事前定義のチェックを通過した出力数で、すべての試行の総コストを割ったもの)です。
重要なポイント
- Haiku 5.5 は引用された OSWorld 2.1 のコンピュータ利用比較で 72.4% と、Luna の 48.9% を上回ります。
- Terminal-Bench 4.0 では、引用結果が Haiku 39.2%、Luna 16.4% です。
- 短文脈の価格は同一ですが、Haiku の高価格階層は 100K プロンプトトークン超で適用、Luna は 272K まで基本レートを維持します。
- Artificial Analysis の最大努力(max effort)モデルページ(2026年10月9日確認)では、Haiku の出力速度が 240.6 tokens/s、Luna が 123.0 tokens/s と報告されています。スループットは最初のトークン待機時間を含みません。
- 共有ベンチマークで示されるコンピュータ利用やターミナルタスクでは Haiku から開始し、大規模プロンプトには Luna を検討しましょう。代表的なパイロットが有用な改善を示すまで、現行モデルは維持してください。
Claude Haiku 5.5 と GPT-6 Luna とは?
Claude Haiku 5.5: 概要
Claude Haiku 5.5 は 2026年10月7日にローンチしました。低価格の推論と調整可能な推論、ツール利用、長文脈、テキストと画像の入力を組み合わせています。典型的な用途は、ドキュメント抽出、データベースクエリ、カスタマーサポート、軽量サブエージェントなどです。
GPT-6 Luna: 概要
GPT-6 Luna は 2026年9月22日にローンチしました。分類、情報抽出、構造化出力、プログラミング支援、長文書処理など、スケールでの特化タスクに向けて位置付けられています。柔軟な推論設定を備え、単純作業向けに推論なし(none)構成もあります。
仕様
| Specification | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Developer | Anthropic | OpenAI |
| Release | 2026年10月7日 | 2026年9月22日 |
| Model ID | claude-haiku-5-5 | gpt-6-luna |
| Context window | 1,000,000 tokens | 1,050,000 tokens |
| Maximum output (standard API) | 128,000 tokens | 128,000 tokens |
| Input | Text and image | Text and image |
| Output | Text | Text |
| Reasoning | Adjustable, Low to Max | None to Max |
| Default effort | Medium | Medium |
| Knowledge cutoff | 2026年6月 | 2026年5月18日 |
| Tool use | Yes | Yes |
| Structured output | Yes | Yes |
| Open weights | No | No |
| Architecture and parameter count | Not specified in the cited official materials | Not specified in the cited official materials |
仕様はベンダーの標準 API モデルドキュメントに基づきます(2026年10月9日確認):Haiku の標準 API 仕様 と Luna の標準 API 仕様。アーキテクチャとパラメータ数は、これらの情報源では確証できないため記載していません。
Claude Haiku 5.5 vs GPT-6 Luna: ベンチマーク結果
| Benchmark | Haiku 5.5 | GPT-6 Luna | Leader |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1,620 | 1,437 | Haiku +183 |
| AA-Briefcase v1.1 (Elo) | 1,578 | 1,336 | Haiku +242 |
| OSWorld 2.1, offline partial score | 72.4% | 48.9% | Haiku +23.5 pp |
| Terminal-Bench 4.0 | 39.2% | 16.4% | Haiku +22.8 pp |
| FrontierCode 1.1 Main | 46.4% | 42.4% | Haiku +4.0 pp |
| Chartography, no tools | 46.4% | 29.1% | Haiku +17.3 pp |
上の6行は、Anthropic が公開したローンチ比較結果(2026年10月9日確認)の再掲です。これは Anthropic によって公開された比較(独立結果の再掲を含む)であり、本記事のために新たに実施したテストではありません。GDPval-AA と AA-Briefcase は Elo スコアです。パーセンテージの差はパーセントポイントです。これらのベンチマーク群は異なるタスクを測るもので、普遍的な勝者を算術平均で決めるべきではありません。
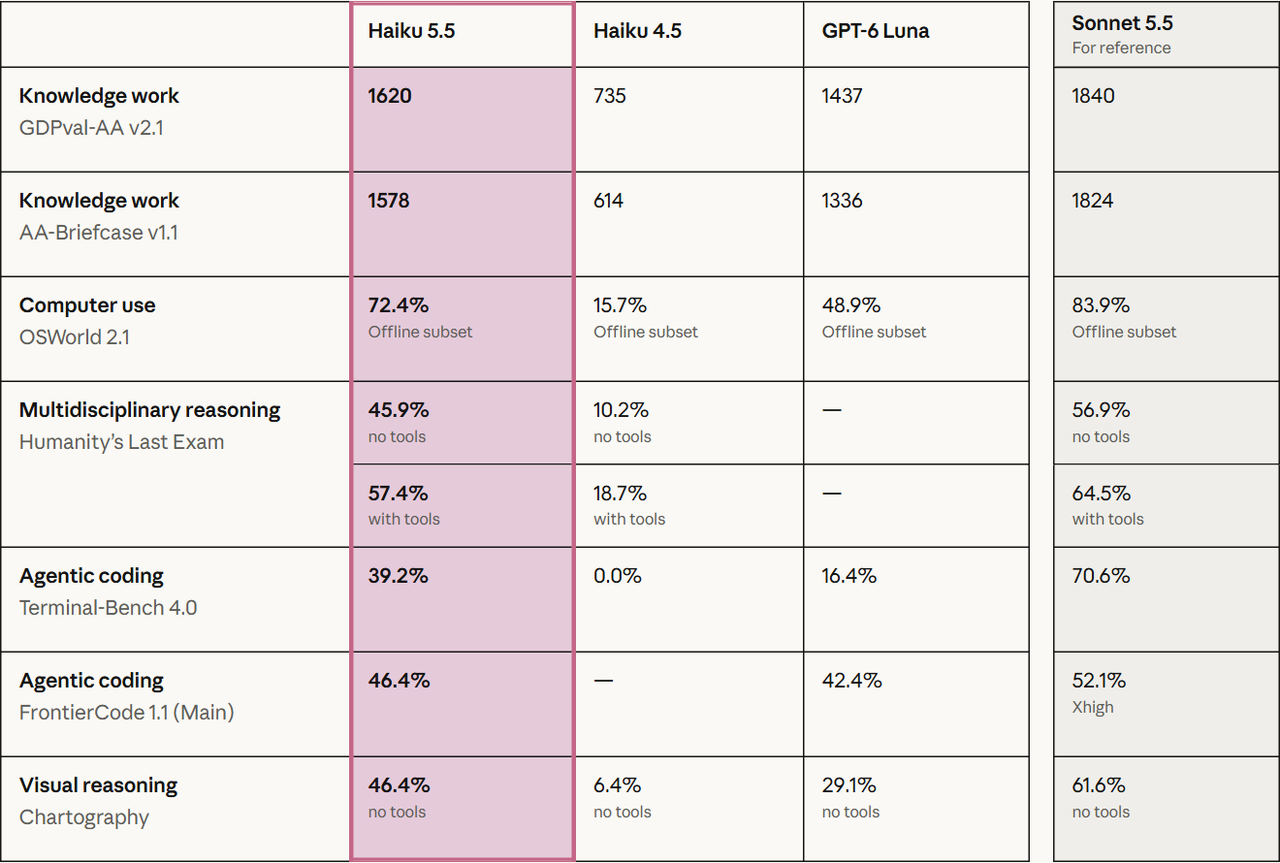
このローンチ表で Haiku の相対的な優位が最も大きく見えるのは、視覚的なコンピュータ操作とターミナルベースのタスクです。一方、FrontierCode での差が小さいことは、20ポイントの差をすべてのコーディング状況に外挿すべきでないことを示唆します。これらの結果をパイロット候補の選定に用い、その後はプロンプトとツールスタックで検証してください。
推論努力と評価の限界
推論の努力値は、精度とコストのトレードオフを変えます。同一のワークロードとハーネスで利用可能な設定を比較してください。同名の設定でも、ベンダー間で推論トークンの予算が同等であることは保証されません。ローンチ表は OSWorld のオフラインサブセットと、ツールなしの Chartography を報告しています。ハーネス、タスク選定、リトライ、ツールアクセスは結果を変え得ます。Anthropic のシステムカードは、ベンチマーク特有の条件を文書化しています。Anthropic のシステムカードでベンチマーク手法を確認してください。
- OSWorld は 82 タスクのオフラインサブセット、Ubuntu 仮想マシン、1080p スクリーンショット、500 アクション上限、最大(max)努力、タスクあたり 5 回の試行を用います。72.4%/48.9% の比較は部分点のスコアであり、タスクの完全達成率ではありません。Haiku の厳格な合格率は 37.1% です。Anthropic は OpenAI の API を通じて同じタスクサブセットで Luna を実行しました。
- Terminal-Bench は 66 のコンテナ化タスクを用います。Haiku は最大(max)努力、Claude Code bare mode、インターネットへの送信なし、フォールバックモデルなしで実行し、タスクあたり平均 10 回の試行でした。
- FrontierCode Main は 100 タスクで、タスクあたり 5 回の実行です。Claude モデルは Claude Code、GPT モデルは Codex を使用しました。
- GDPval-AA と AA-Briefcase は Artificial Analysis によって独立評価され、その結果がローンチ資料で再掲されています。これは単一の本番ハーネスではなく、別個の評価パイプラインです。
Claude Haiku 5.5 vs GPT-6 Luna: 機能比較
コンピュータ利用とエージェント的コーディング
共有されているローンチタスクのうち、GUI との対話やターミナル作業を要するものでは Haiku の優位が最も大きく見られます。OSWorld の部分スコア差は 23.5 ポイント、Terminal-Bench の差は 22.8 ポイントです。FrontierCode の 4.0 ポイントという小さな差は、広義の「コーディング」を単一のワークロードとして扱うべきでない理由を示します。
ブラウザ自動化では、ページ遷移、フォーム入力、ツール障害からの回復、エンドツーエンド完了をテストしてください。コーディングでは、パッチがリポジトリの機能チェックを通過し、スコープ内に収まっているかを確認しましょう。大きな見出し差でモデルを選ぶより、そうした受理チェックの方が有用です。
長文脈とドキュメント処理
名目上のコンテキスト容量の 5% の差は、巨大なプロンプト処理の信頼性と価格ほど重要ではありません。文脈窓が大きいからといって、どちらかのモデルが情報取得で本質的に優れているわけではありません。
鍵は高レートの適用タイミングです。150K トークンのプロンプトは Haiku のしきい値を超えますが、Luna の基本階層内に留まります。したがって、そのトークン負荷では Luna の方が低コストの出発点です。とはいえ、どちらが優れたドキュメント解析者かは、抽出精度、引用、許容解を得るためのリトライ回数によって変わります。
推論コントロール
両モデルとも推論努力は調整可能で、引用ドキュメントでは既定が「Medium」です。Luna は none 設定も公開しています。抽出やルーティングは、不確実な多段ツールワークフローより推論が少なくて済むことがあります。同一の努力ラベルでも、ベンダー間で計算予算が同一とは限りません。
マルチモーダル入力と構造化ワークフロー
両モデルともテキストと画像を受け付け、テキストを出力します。これはスクリーンショット、ドキュメント画像抽出、構造化された下流ワークフローに適しています。もっとも、入力対応だけでは小さな文字、チャート、可視 UI に対する精度が同等であることは示されません。これらは別途測定してください。
スピードとタスク経済性
| Independent metric (max effort) | Haiku 5.5 — Artificial Analysis | GPT-6 Luna — Artificial Analysis |
|---|---|---|
| Intelligence Index v4.3.2 | 43 | 38 |
| Output speed | 240.6 tokens/s | 123.0 tokens/s |
| Weighted cost per Intelligence Index task | $0.21 | $0.07 |
Artificial Analysis は独立のテスト発行元です。表は、ベンダー公式の性能ではなく、2026年10月9日に確認した最大努力のモデルページのスナップショットです。出力速度は生成開始後に受信したトークンを測り、最初のトークンまでの時間やタスク全体のレイテンシとは別です。タスクあたりコストは加重 Intelligence Index の指標であり、あなたの本番タスクの見積もりや成功結果あたりのコストではありません。
Haiku のスナップショット出力スループットは Luna の約 1.96 倍ですが、Luna の評価タスクの加重コストは低い数値です。これはタスク完了時間に 1.96 倍の優位があることを意味しません。本番テストでは、最初のトークンまでの時間、完了時間、出力長、推論消費、ツール実行時間を個別に記録してください。
Claude Haiku 5.5 vs GPT-6 Luna: 価格と API アクセス
公式標準レート
| USD per 1M tokens | Haiku ≤100K | Haiku >100K | Luna ≤272K | Luna >272K |
|---|---|---|---|---|
| Input | $0.10 | $0.50 | $0.10 | $0.20 |
| Cached read | $0.01 | $0.05 | $0.01 | $0.02 |
| Cache write (Haiku: 5-minute TTL) | $0.125 | $0.625 | $0.125 | $0.25 |
| Output | $0.50 | $2.50 | $0.50 | $0.75 |
標準処理レートでの 100万トークンあたりの USD(2026年10月9日確認)。表はHaiku の標準レートと 5 分キャッシュ書き込みレートおよびLuna の短文脈/長文脈レートを用いています。ツール料金、税、地域加算、任意の処理階層調整は除外しています。入力しきい値を超えると、超過分だけでなくリクエスト全体に高レートが適用されます。
中心的な相違は課金しきい値です。Haiku は 100K プロンプトトークン超で高レートに移行する一方、Luna は 272K まで低い階層を維持します。さらにしきい値超でも、Luna の長文脈の入力・出力価格は引用値ではより低く設定されています。
Haiku は 1 時間のキャッシュ書き込みも提供しており、短/長プロンプトでそれぞれ $0.20/$1.00(100万トークン)です。キャッシュの保持と価格メカニズムはベンダー間で異なるため、両者のキャッシュ書き込み行を同一製品として扱うのではなく、再利用パターンを比較してください。Haiku の 128K 出力上限は標準 API の制限であり、Message Batches API はベータヘッダーにより 300K 出力をサポートできます。
固定トークン予算における試算コスト
| Workload | Input / Output | Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Ticket classification | 2K / 200 | $0.0003 | $0.0003 |
| Short report | 40K / 4K | $0.006 | $0.006 |
| Repository analysis | 150K / 5K | $0.0875 | $0.0175 |
| Large document review | 300K / 10K | $0.175 | $0.0675 |
| Massive context analysis | 800K / 20K | $0.45 | $0.175 |
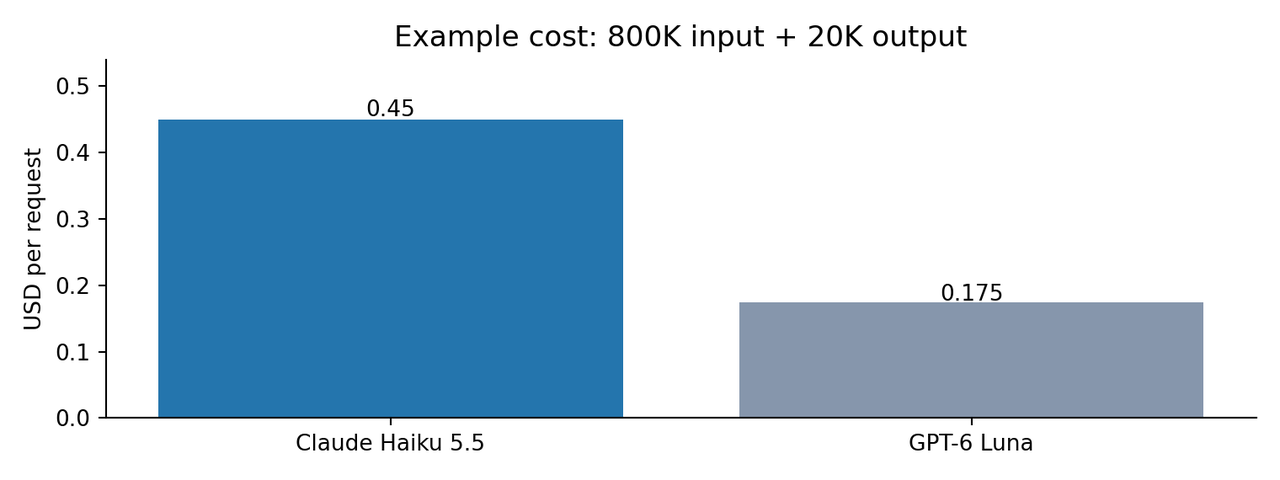
筆者によるキャッシュ未使用の標準レート試算:cost = input tokens × input rate / 1,000,000 + billed output tokens × output rate / 1,000,000。「Output」はこの試算における課金対象の総出力を指し、推論トークンが出力として課金される場合を含みます。可視の回答長とは限りません。両モデルで同一の報告トークン数を用いていますが、トークナイザは異なり得ます。
安いトークンが、必ずしも安い「成功結果」を意味するわけではありません。チームは、再試行、失敗したツール呼び出し、推論トークン消費、トークナイザ差異を考慮すべきです。
CometAPI のアクセスと統合上の制約
CometAPI は両モデルへのアクセス手段を提供します。ゲートウェイ経由で比較・導入する前に、各ルートのモデル ID、対応エンドポイント、リクエストパラメータ、ツール動作、課金ルールを確認してください。これらのプロバイダリンクはアクセス手段を示しますが、ベンダーの技術資料や標準価格情報の代替ではありません。
OpenAI への直接統合では、Luna は Responses API を通じてビルトインツールをサポートします。Chat Completions の関数呼び出しは none の推論努力を要します。Haiku は Anthropic の Messages API と adaptive thinking を用います。ゲートウェイは基盤のスキーマを互換にはしません。利用予定の正確なルートで、ツール定義、構造化出力の挙動、ストリーミングイベント、アカウンティングを検証してください。
同一プロンプトで Claude Haiku 5.5 と GPT-6 Luna をどう比較するか?
長文書抽出の例
実用的な比較として、有効日、更新条項、通知期間、例外を含むサプライヤ契約バンドルを用いる方法があります。ドキュメントバンドル、抽出指示、期待フィールド、検証ルールを同一に保ちます。以下は評価設計の例であり、新たに測定したモデル結果ではありません。
例のプロンプト: 各契約について、サプライヤ名、有効日、更新日、解約通知期間、価格の例外を抽出してください。抽出した各値について、ドキュメントタイトルと正確な根拠箇所を引用してください。フィールドが存在しない場合は null を返し、欠落日付を推測しないでください。矛盾する条項をフラグし、最終回答を 1,000 語以内に収めてください。
| Check | Acceptance criterion | What to record |
|---|---|---|
| Extraction accuracy | Required fields match an independently checked answer key | 正解、誤り、欠落値 |
| Grounding | Every non-null field has a valid supporting passage | 裏付けのない主張、誤ったドキュメント引用 |
| Instruction following | No invented dates; absent fields return null | スキーマ不一致、制約違反 |
| Economics | Calculate spend per accepted extraction | 課金入力、出力、推論、リトライ、フォールバックのコスト合計 |
| Latency | Compare full job completion under the same tool policy | 最初のトークン時間、エンドツーエンド時間 |
代表的なバンドルを複数回実行し、結果が分かれるケースは繰り返してください。まずは同じ利用可能な努力レベルから開始し、次に各モデルの低コスト構成を試してください。勝者を示す前に、サンプルサイズ、設定、ルート、日付、失敗件数を併記しましょう。
Haiku 5.5 か GPT-6 Luna か:どちらを選ぶべき?
| Dimension | Better-supported starting point | Decision boundary |
|---|---|---|
| GUI interaction | Claude Haiku 5.5 | 共有 OSWorld の部分スコアは Haiku を支持。タスク完全達成で検証 |
| Terminal coding | Claude Haiku 5.5 | 共有 Terminal-Bench スコアは Haiku を支持。リポジトリ変更で検証 |
| Short prompts and base prices | Test both | 基本レートは同一。課金使用量とリトライ回数を比較 |
| Prompts above 100K tokens | GPT-6 Luna on standard rates | Luna は基本階層の維持が長い。精度が総コストを左右し得る |
| Streamed token throughput | Claude Haiku 5.5 in the dated snapshot | スループットはタスク完了レイテンシと同義ではない |
| Simple repeated extraction | Test Luna with low or no reasoning | 価格だけでなく、受理可能な出力の有無で選定 |
ベンチマーク関連のインタラクティブタスクには Claude Haiku 5.5 を
公開された GUI 操作、ターミナルコーディング、プロフェッショナルワークのタスクに類似するアプリケーションでは、より高い完了率が追加の推論や長文脈コストを相殺し得るため、Haiku から開始してください。その優位を本番のツールスタックで確認しましょう。
大規模プロンプトのコスト管理には GPT-6 Luna を
プロンプトが 100K トークンを頻繁に超え、標準的なトークンコストが予算に大きく影響する場合は Luna から始めましょう。低推論または無推論で成功し得る反復抽出やルーティングにも適します。ただし、受理結果率と実際の課金使用量に基づく条件付きの推奨です。
ニーズの異なるワークロードには併用を
パイロットでは、長文書抽出を Luna、GUI/ターミナルタスクを Haiku にルーティングし、受理チェックでそれぞれ検証します。スキーマ検証の失敗、必要証拠の欠落、タスク特有のチェック不合格時にフォールバックを起動し、フォールバックのコストとレイテンシも比較に含めてください。
切り替え前に検証を
現行モデルをベースラインに含めてください。候補が所定の正確性目標を満たし、受理結果あたりのコストまたはエンドツーエンドのレイテンシを移行・保守コストを上回る幅で改善した場合のみ移行しましょう。致命的なツールエラーが増える場合は展開を保留してください。パイロットの結果次第では、Luna の低レートがリトライで相殺されたり、Haiku の高いベンチマークスコアがタスク成功を改善しない可能性もあります。
- 代表的なワークロードサンプルを用い、正解・誤り・不完全を採点する。
- 最初のトークンのレイテンシ、エンドツーエンドの時間、ツールの信頼性を測定する。
- 入力、キャッシュ、出力、推論のトークン数を個別に追跡する。
- リトライとフォールバックを含め、成功結果あたりのコストを算出する。
- 既定(Medium)と高設定を比較し、デフォルトで最大設定を有効にする前に検証する。
結論
Claude Haiku 5.5 は、本稿で比較したプロフェッショナルワーク、コンピュータ利用、エージェント的コーディングのベンチマークで、ヘッドトゥヘッドのローンチ時点の証拠がより強固です。独立スナップショットにおける出力スループットも高い値を示しています。GPT-6 Luna は、Haiku の 100K しきい値を超えるプロンプトに対して標準レート上の明確な優位があり、評価タスクの加重コストも低く出ています。いずれの観察も、本番での信頼性や成功結果あたりのコストを単独で決定するものではありません。
実務上の勝者は、完全に測定された運用コストの最小で受理可能な結果を提供するモデルです。単一のベンチマークを答えとせず、自身のプロンプト、ツール、リトライ規則で両者を走らせて評価してください。
FAQ
両モデルの基本トークン価格が同じなのに、タスクコストが異なるのはなぜですか?
基本価格が同じでも、請求総額は同じになりません。モデルによって入力・出力・推論トークンの使用量が異なり、受理可能な結果を出すまでに必要なリトライやツール呼び出し回数も異なります。長文脈レートやキャッシュ利用も総計に影響します。トークン価格だけでなく、合格した結果 1 件あたりの総コスト(すべての試行の総コスト ÷ 受理結果数)で比較してください。
長文脈の高レートは、しきい値超過分のトークンのみに適用されますか?
いいえ。本稿で説明した標準価格では、入力しきい値を超えると、超過分だけでなくリクエスト全体に高レートが適用されます。例えば 150K 入力トークンのリクエストは Haiku の 100K しきい値を超えますが、Luna の 272K 基本階層内に留まります。見積もりでは、リクエスト全体に適用される入力・出力レートを用いてください。
Claude Haiku 5.5 と GPT-6 Luna はプロンプトキャッシュを共有できますか?
モデル間・プロバイダ間でキャッシュエントリが転用できると仮定しないでください。別々の再利用戦略を設計し、各ルートでヒット率と請求使用量を測定しましょう。ゲートウェイのサポート、保持ルール、リクエスト構造が、繰り返し入力がキャッシュ対象かどうかに影響します。節約の見込みを立てる前に検証してください。
Haiku から Luna への移行テストでは何をカバーすべきですか?
代表的なテキストと画像入力、必要な構造化フィールド、ツール引数、ストリーミング応答、エラー回復をテストしてください。移行前に現行システムの受理率を確立し、同一のリトライとツール方針の下で両候補を比較します。トークン価格やモデルカテゴリが似ていても、互換性を意味しません。
ベンチマークスコアに基づき、Haiku と Luna のどちらをフォールバックにすべきですか?
スコアは候補選定に使い、フォールバックは観測された失敗(無効なツール引数、必須フィールドの欠落、タスク特有のチェック未達)をトリガーにしてください。フォールバック頻度と総コストを追跡しましょう。2 番手モデルはレイテンシとコストを増やし得るため、受理結果を改善することを確認してください。ただ別の回答を出すだけでは不十分です。
機微なデータを両方の API にルーティングできますか?
関与する正確なベンダーとゲートウェイ、現行の保持設定、処理場所、契約条件、組織のデータポリシーを確認してください。モデルの性能や価格表は、規制対象または機密データに適したルートを保証しません。そうした要件が決定的な場合は、承認済みのルートを使用してください。