
TL;DR
Google は 2026 年 9 月 30 日に、複雑で長時間にわたるワークフロー向けのフロンティアモデルである Gemini 4 Argon を発表しました。公開された結果には明確な傾向が見られます。専門的なナレッジワーク、長コンテキスト課題、特定のソフトウェアエンジニアリング評価で強みを示す一方、いくつかのターミナルやコンピュータ操作系ベンチマークでは弱さが見られます。Google は段階的なロールアウトでモデルを導入しています。別途、CometAPI は 10 月 1 日時点のカタログ掲載を報告しています。導入前にアカウント適格性とテストリクエストの成功を確認してください。重要なのは、どこで性能向上が現れているかという点です。
Argon は Vals Index で 68.9%、Vals Finance Agent v2 で 65.4%、DeepSWE v1.1 で 77.9%、LVBench で 91.7%、GraphWalks(256K–1M)で 84.2% を記録。一方で、FrontierSWE v2、Terminal-Bench 4.0、Terminal-Bench Science、OSWorld-2.0 では競合のフロンティアモデルに遅れを取っています。
結果は、Argon をワークロード別に評価する視点を支持しています。最も強いスコアは、専門的なナレッジワーク、非常に長いコンテキスト、特定のマルチモーダルおよびソフトウェアエンジニアリング評価に集中しています。他モデルは、いくつかのターミナルやコンピュータ操作テストで優位性を維持しています。
Key Takeaways
- Gemini 4 Argon は、エンタープライズのナレッジワーク、長コンテキスト推論、マルチモーダル理解、長期ホライゾンのコーディング評価で最も強力です。
- 最大出力上限 100 万トークンは、長い推論軌跡に対する生成の余裕を提供しますが、公開の入力コンテキスト仕様を確立するものではありません。
- Argon は複数のナレッジワークおよび長コンテキストの公開結果でリードしていますが、GPT-6 Astra と Claude Opus 5.5 は一部のコーディングおよびコンピュータ操作の評価で先行しています。
- ベンチマークスコアは特定のモデルとエージェント構成を記述します。指標、入力条件、評価設定は見出しのパーセンテージと同じくらい重要です。
- Google のロールアウトと CometAPI のアクセスは別個の提供状況です。トラフィック移行前に、実際の経路、モデル識別子、アカウント適格性を検証してください。
What Is Gemini 4 Argon?
Gemini 4 Argon は、Google DeepMind の新しいフロンティア Gemini モデルで、短い 1 回のプロンプトへの回答ではなく、多くのステップにまたがる推論を要する難易度の高いワークフローを中心に設計されています。
Google の公式ポジショニングは、実世界のソフトウェアエンジニアリング、法務・金融などのエンタープライズ・ナレッジワーク、防御的サイバーセキュリティ、マルチモーダル理解、長時間実行のエージェント型タスクを強調しています。
これは最近の Flash リリースとは重要な差異です。CometAPI の Gemini 3.8 Flash API は、大規模なエージェント型ワークロード向けの低コストなワークホースとして設計されています。一方で Argon は Google のスタックにおけるフロンティア側を代表し、深さと持続的な実行を優先しています。
Model Specifications
| 仕様 | Gemini 4 Argon |
|---|---|
| 開発元 | Google DeepMind |
| 発表日 | September 30, 2026 |
| モデルファミリ | Gemini 4 |
| 位置付け | フロンティア推論・長期ホライゾンモデル |
| 最大出力 | 1,000,000 tokens |
| 長コンテキスト評価 | GraphWalks で 256K–1M まで検証 |
| 公開された入力コンテキスト上限 | ローンチ時点の標準的な公開 API 仕様表では正式に未指定 |
| マルチモーダル理解 | あり;チャート、文書、長尺動画の評価を含む |
| エージェント型コーディング | あり |
| コンピュータ操作 | 評価済み |
| サイバーセキュリティ | 防御に特化した機能 |
| Google 公開 API のモデルID | Google の初期公開ドキュメントでは未発表;CometAPI ではカタログ識別子として gemini-4-argon を使用。 |
Output Budget and Trade-offs
Google は Argon の最大出力上限を 100 万トークンと発表しました。これはローンチ告知で引用された従来の 64K 上限からの引き上げです。これにより、より長い推論軌跡のための余裕が生まれます。ただし、エージェントの複数呼び出し全体での保証予算や、あらゆるタスクの改善を意味するものではありません。
最大出力は知能そのものではありません。出力トークンを増やしてもモデルが自動的に高性能になるわけではなく、潜在的なボトルネックのひとつを取り除くだけです。モデルがその予算を生産的に使いこなす必要があります。
コストとレイテンシーのトレードオフもあります。生成トークンが数十万に達するような実際の消費は、名目上のトークン単価が魅力的に見えても高価で遅くなり得ます。

記事から再掲した選択ベンチマーク結果。各行内でモデルを比較してください。指標や評価条件は異なります。本チャートは装飾的なグラデーションアートワークの代わりであり、独立検証ではありません。
最大出力上限と入力コンテキストウィンドウは異なる能力を表します。GraphWalks の評価範囲は入力に関する実測の証拠であり、公開 API 仕様の代替ではありません。
How Does Gemini 4 Argon Perform on Benchmarks?
Google DeepMind のパフォーマンステーブルは、エージェント・ワークフロー、プロフェッショナルなナレッジワーク、マルチモーダル課題をカバーしています。以下の値は公表された比較を再掲したものです。これらはトークンスループットや応答レイテンシーではなく、タスクの遂行性能を測定しています。「—」はこの比較で結果が報告されていないことを意味します。
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Evaluation conditions |
|---|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% | Vals AI |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% | Private set; Zapier leaderboard |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% | Vals AI |
| Harvey's Legal Agent | 19.6% | 5.4% | 6.7% | 3.8% | Vals AI |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% | mini-swe harness; mixed sources |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% | Proximal leaderboard |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% | Vals AI leaderboard |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% | Self-test / leaderboard |
| PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% | v1.1; OpenCode; 10h; one H100 |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% | Verifier timeout ×6 |
| LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% | Linux tools; internet |
| RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% | Surge leaderboard |
| GraphWalks up to 128K | 99.7% | 98.7% | 91.4% | 90.6% | BFS F1; 650 items |
| GraphWalks 256K–1M | 84.2% | 71.8% | 65.0% | 66.8% | BFS F1; 200 items |
| Agent's Last Exam | 39.5% | 34.2% | — | 38.2% | Binary pass; ALE-Claw; 5h |
| OSWorld-2.0 | 69.2% | 72.6% | — | — | Offline partial score; best of 3 runs |
| Chartography | 71.6% | 71.0% | 46.2% | 66.3% | No tools; Surge leaderboard |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% | No tools; model-specific frame sampling |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% | pass@1; pass@4 breaks ties |
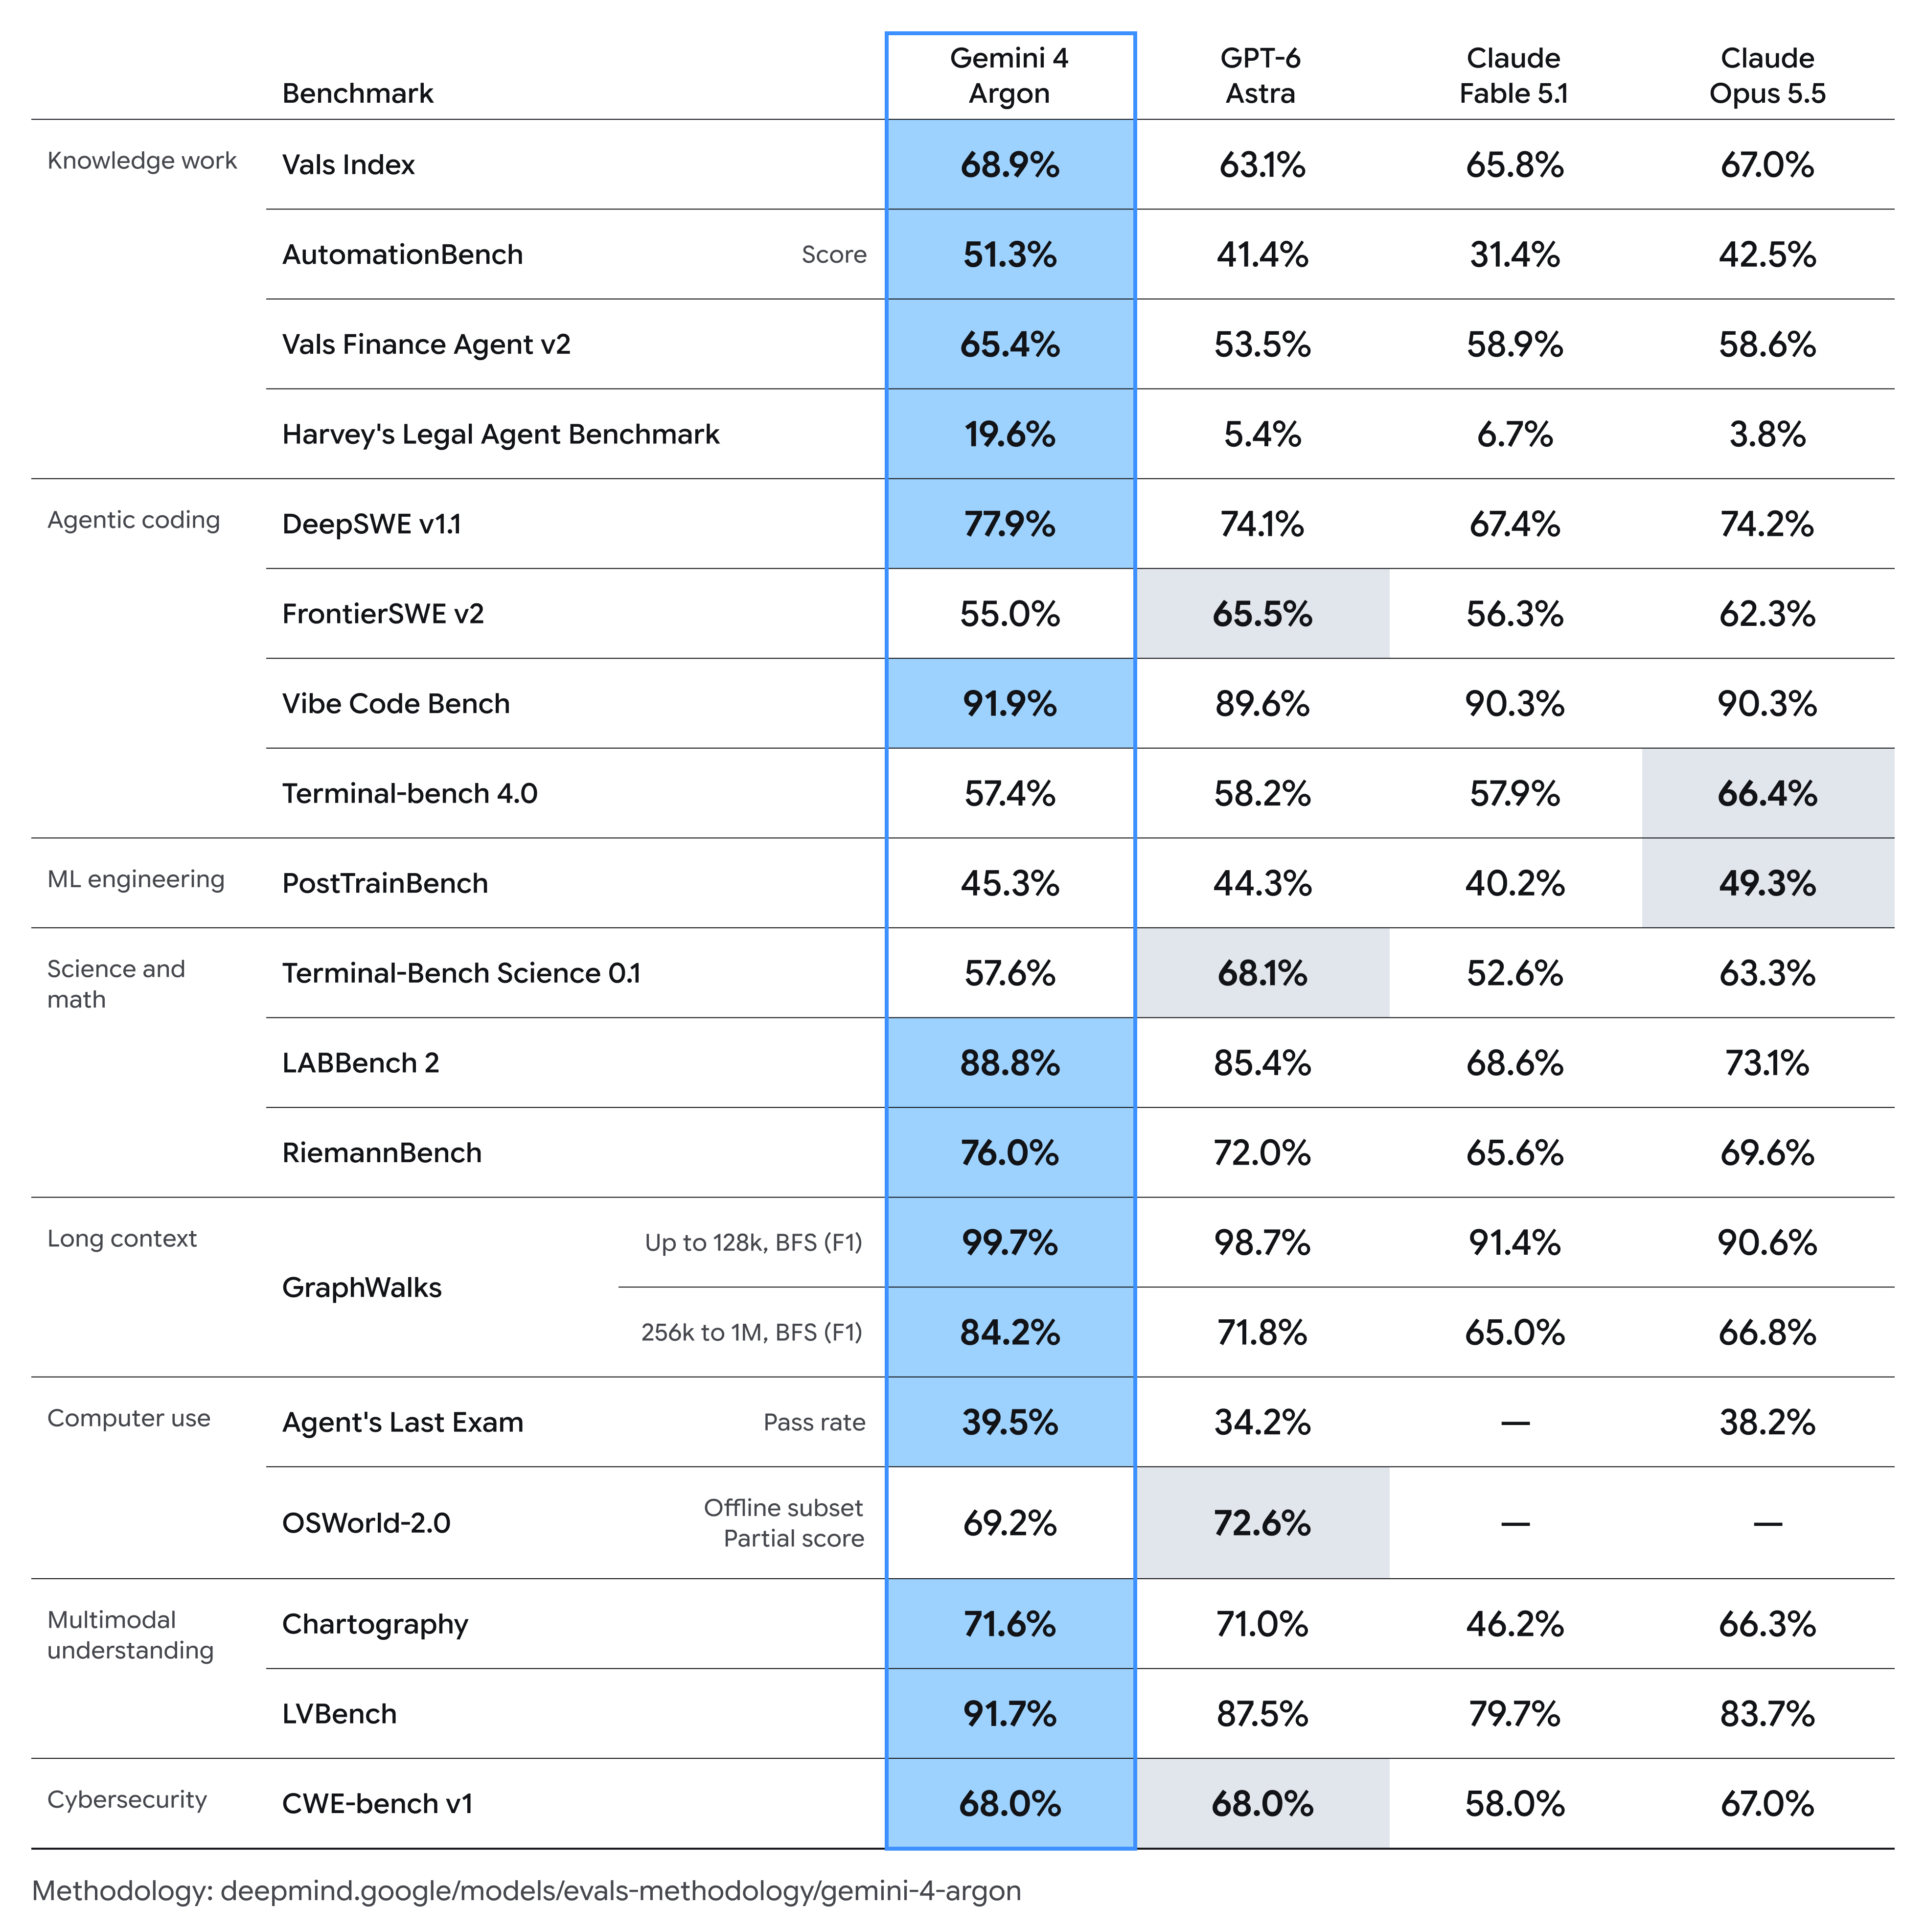
Google 公式の Gemini 4 Argon ベンチマーク比較
特記なき限り、Argon の結果は単一試行かつ最高の思考設定を使用。他モデルの結果は一般にプロバイダー報告に基づき、ベンチマーク固有の例外があります。LVBench は、Gemini が 1 FPS、GPT-6 Astra が 800 フレーム、Fable 5.1 が 300、Opus 5.5 が 600。入力は同一ではありません。各行を厳密な再実行として扱うのではなく、報告された構成を比較してください。
Evaluation Conditions and Limitations
この表は有用ですが、独立した普遍的なリーダーボードと解釈すべきではありません。
- ベンチマークの選定は Google による選定です。
- 行ごとにエージェントフレームワーク、時間予算、ツール、入力サンプリングなど、ベンチマーク固有の評価設定が異なります。
- 公式手法では、競合の結果は原則プロバイダー報告値を使用し、ベンチマーク固有のリーダーボードおよび自算例外があります。
- 最高のベンチマーク設定は、プロダクションの推論デフォルト構成を必ずしも反映しません。
- 見出しのスコアだけでは、トークン使用量、ツール呼び出し、リトライ、経過時間、人手介入の有無は分かりません。
プロダクションシステムでは、1 トークン単価や単一のベンチマーク値より、成功タスクあたりのコストの方がより良い指標であることが多いです。
Which Workload Is Gemini 4 Argon Best For?
Knowledge Work Performance
Argon の結果で最も明確なのは、プロフェッショナルなマルチステップのナレッジワークです。
Vals Index では Argon が 68.9% に到達し、Claude Opus 5.5 の 67.0% と比較して数値差は控えめですが、専門化したワークフローでは傾向がより明瞭になります。
- Vals Finance Agent v2:65.4%。Google の表で示された最強の競合より 6.5 ポイント上。
- AutomationBench:51.3%。Claude Opus 5.5 より 8.8 ポイント上。
- Harvey's Legal Agent Benchmark:19.6%。次点の報告モデルは 6.7%。
このパフォーマンスプロファイルは、情報収集、状態保持、段階をまたぐ推論を行い、閉じた質問への回答ではなくプロフェッショナルな成果物の生成が求められるときに、Argon の利点が最大化されることを示唆します。
絶対値としての法務エージェントのスコアが低いことも重要です。19.6% という数値だけでは、どれだけの基準やワークフローが失敗したかは分かりません。有用な結論は、この評価で Argon が相対的に大きな改善を示した一方で、この結果が法務業務の自動化を信頼できるレベルで確立するものではないという点です。
Long-Context Reasoning
Argon の最も顕著な優位性は、GraphWalks の 256K–1M バージョンかもしれません。
- Gemini 4 Argon:84.2%
- GPT-6 Astra:71.8%
- Claude Opus 5.5:66.8%
- Claude Fable 5.1:65.0%
これは、公開比較で最も近いモデルに対して 12.4 ポイントの優位です。
短いコンテキスト長では差はずっと小さくなります。GraphWalks(~128K)では、Argon が 99.7%、GPT-6 Astra が 98.7%。このことは、この特定の超長コンテキスト評価において、Argon の性能劣化が比較モデルよりも緩やかなことを示唆します。
Google は、この差を特定のアテンション機構、検索システム、学習レシピ、推論時戦略に帰するのに足るアーキテクチャ情報を開示していません。「Gemini 4 が新しいアテンションアーキテクチャを導入した」といった主張は、公的証拠を超えるものになります。
Coding Performance
公式のベンチマーク表は、単純なイエスを支持しません。
Argon はある形式のコーディングでは非常に高性能で、他では明確に負けています。DeepSWE v1.1 では 77.9% と、Claude Opus 5.5 の 74.2%、GPT-6 Astra の 74.1% を上回ります。Vibe Code Bench のスコアも 91.9% と強力です。
- FrontierSWE v2:Argon 55.0% 対 GPT-6 Astra 65.5%。
- Terminal-Bench 4.0:Argon 57.4% 対 Claude Opus 5.5 66.4%。
- Terminal-Bench Science 0.1:Argon 57.6% 対 GPT-6 Astra 68.1%。
この分岐は開発者にとって重要です。Argon は、コンテキストやプランニングが多い長期的なエンジニアリング・ワークフローとしてのコーディングで特に強く、一方でターミナル中心の実行では競争が拮抗しています。リポジトリ移行ベンチマークと、対話的ターミナル・ベンチマークを「コーディング能力」の同一尺度として扱うべきではありません。
Defensive Cybersecurity
サイバーセキュリティは中核の展開領域です。Google の防御的サイバーセキュリティのポジショニングには、自律的な脆弱性発見、検証、パッチ適用が含まれます。これはプロバイダーの能力主張であり、以下の CWE-bench の結果は独自評価での脆弱性修復を測定します。
CWE-bench v1 では、Argon は 68% を記録し、GPT-6 Astra と同率でトップ、Claude Opus 5.5(67%)をわずかに上回ります。
Google はまた、悪用、間接的なプロンプトインジェクション、リスキーなエージェント挙動、実行環境の侵害に対するより強力なセーフガードを強調しています。これにより Argon は、従来型のモデルアップグレードであると同時に、エージェントセキュリティのリリースでもあります。
Multimodal Understanding
Argon は Chartography で 71.6%、長尺動画理解の LVBench で 91.7% を記録。Google の表では LVBench で GPT-6 Astra に対して 4.2 ポイントの優位です。ただし、モデルごとにフレームサンプリング設定が異なるため、これは純粋なモデル差ではなく、報告されたセットアップの比較です。
これは、多くのプロフェッショナルなワークフローがテキストのみではないため重要です。金融リサーチ・エージェントはチャートを確認する必要があり、エンタープライズアシスタントはレポート、PDF、スクリーンショットを組み合わせ、動画分析システムは個別フレームの独立処理ではなく長いシーケンス全体でのイベント保持が必要な場合があります。
Argon のマルチモーダルな知覚と持続的な推論の組み合わせは、単なるマルチモーダル対応以上に関連性があります。
Science and Mathematics Performance
結果は混在していますが、概して強力です。Argon は LABBench 2 で 88.8%、RiemannBench で 76.0% に到達し、Google の表で比較されたモデルを上回ります。しかし、Terminal-Bench Science 0.1 では GPT-6 Astra が 68.1%、Argon は 57.6% です。
この差は、より広いパターンを示唆します。Argon は科学情報の推論では強い一方、あらゆるツール駆動の科学的実行において最強というわけではないようです。
Computer-Use Performance
Agent's Last Exam では、Argon はバイナリ合格率 39.5% と、GPT-6 Astra(34.2%)や Claude Opus 5.5(38.2%)を上回ります。OSWorld-2.0 のオフラインサブセットでは、部分スコア 69.2% と、GPT-6 Astra の 72.6% を下回ります。OSWorld の値はフルタスクの成功率ではなく、Claude の欠測は能力ゼロを意味しません。
したがって、現時点のデータはコンピュータ操作全般での優位を示していません。プロダクション展開では、ナビゲーション精度、誤クリック、リトライ頻度、意図しない操作、完了までの時間、人手修正率など、タスクレベルのテストでベンチマークを補完する必要があります。
Gemini 4 Argon vs GPT-6 Astra and Claude
| Dimension | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|
| Knowledge work | 非常に強力 | 強力 | 非常に強力 | 強力 |
| Long-context benchmark | 公開結果で最強 | 強力 | 中程度〜強 | 中程度 |
| Long-horizon coding | 非常に強力 | 非常に強力 | 非常に強力 | 強力 |
| Terminal coding | 競争力がある | 強力 | 選抜テストで最強 | 競争力がある |
| Scientific terminal agents | 競争力がある | 選抜テストで最強 | 強力 | 競争力がある |
| Multimodal understanding | 非常に強力 | 非常に強力 | 強力 | 競争力がある |
| Computer use | 競争力がある | 強力 | 混在/比較限定 | 比較限定 |
| Cybersecurity | CWE-bench v1 で同率トップ | 同率トップ | ほぼ同等 | 低い |
この比較において、Argon は長コンテキスト、ドキュメント中心、プロフェッショナルなエージェント業務で際立っています。開発者は CometAPI を通じて GPT-6 Astra、Claude Opus 5.5、Claude Fable 5.1 と比較できます。
Performance-based selection
上記の定性的ラベルは、選定されたベンチマーク表の要約であり、普遍的なランキングではありません。作業が Argon のリーディング評価に近い場合は Argon をパイロットで優先し、ターミナル中心ワークロードではデフォルト選定前に Astra と Opus をテストしてください。
Specifications and deployment constraints
この性能比較は、アーキテクチャ上の優位や一般的な価格性能の勝者を確立するものではありません。Argon のパラメータ数やアーキテクチャは、確認した Google のローンチ資料では特定されていません。公開の入力コンテキスト上限は、公式 API ドキュメントが必要です。CometAPI は gemini-4-argon の経路を報告していますが、Google の広範なロールアウトとは独立に、サポートパラメータとアカウントアクセスを確認してください。各経路の制限と実際のタスクコストを比較した上で展開してください。
How Can Developers Access Gemini 4 Argon Through CometAPI?
CometAPI は、モデルが gemini-4-argon として利用可能と報告しています。アカウントダッシュボードで API キーを作成し、プレイグラウンドでその識別子を選び、統合前にテストリクエストを実行してください。OpenAI 互換の例ではベース URL は https://api.cometapi.com/v1 を使用します。モデルのサポートエンドポイントとパラメータはアカウントドキュメントで確認してください。カタログのバッジだけでは、成功呼び出しの確認にはなりません。
- CometAPI アカウントを作成し、ダッシュボードで API キーを発行。
- gemini-4-argon を選び、プレイグラウンドで代表的なリクエストを検証。
- 互換クライアントを CometAPI のベース URL、キー、モデル識別子で設定し、展開前にサポートされるリクエストスキーマと課金を確認。
CometAPI and official pricing
Google は、Gemini 4 Argon のイントロ価格として、入力 100 万トークンあたり $2、出力 100 万トークンあたり $10、入力キャッシュは入力単価の 95% オフと発表しました。イントロ期間後は、入力 $4、出力 $20/100 万トークンと発表されています。これらは Google の発表価格であり、CometAPI の価格や即時の一般 API アクセスを確認するものではありません。
| Billing basis | Gemini 4 Argon API in CometAPI | Google official announcement | Comparison |
|---|---|---|---|
| Input / 1M tokens | $3.20 | $4.00 after introductory period | 20% below announced post-intro rate |
| Output / 1M tokens | $16.00 | $20.00 after introductory period | 20% below announced post-intro rate |
Conclusion
Gemini 4 Argon のベンチマークプロファイルは、単純なリーダーボード主張よりも示唆に富みます。
この比較で最も強い結果は、プロフェッショナルなナレッジワーク、長コンテキスト、持続的なエージェント実行に集中しています。 このパターンはワークロード選定に有用ですが、根底にあるアーキテクチャを特定したり、どのメカニズムが向上をもたらしたかを証明するものではありません。
報告された金融、法務、長尺動画、ソフトウェアエンジニアリングの結果は、それらのワークロードに対するフォーカスしたパイロットを支持します。同じ優位がプロダクションで持続するかは、入力ミックス、エージェントフレームワーク、推論設定、検証要件に依存します。
同時に、フロンティアモデルの性能はますます専門特化していることが分かります。Argon は DeepSWE でリードしつつ FrontierSWE で遅れ、Agent's Last Exam でリードしつつ OSWorld で遅れ、LABBench でリードしつつ Terminal-Bench Science で遅れることがあります。これらのベンチマークは、エージェントシステムの異なる側面をストレステストします。
開発者にとって最も重要な教訓は、モデル選定はブランドやファミリ単位ではなく、ワークロード単位で行う必要性が高まっているということです。
FAQ
開発者は自分たちのワークロードで Gemini 4 Argon をどのように検証すべきですか?
代表的なタスクセットを明確な合格基準とともに構築します。ツール、時間制限、入力準備、リトライ方針をモデル間で可比に保ちます。完了タスク数、総トークン、経過時間、人手修正を記録します。小規模なパイロットから開始し、プロダクショントラフィックをルーティングする前に失敗ケースを分析します。
Gemini 4 Argon のベンチマーク百分率を 1 つのスコアに平均化できますか?
いいえ。表は F1、合格率、部分スコアなど異なる指標を混在させています。全体平均ではなく、タスク固有の基準を使用してください。
Gemini 4 Argon のエージェントは常に最大出力予算を使うべきですか?
いいえ。品質と信頼性の要件を満たす最小限のテスト済み予算を選択してください。最大出力上限は上限であり、目標ではありません。
CometAPI を通じた Gemini 4 Argon アクセスはどのように評価すべきですか?
アカウントレベルの提供状況確認と、ドキュメント記載の CometAPI 経路を用いた小さなリクエストから始めます。応答品質、レイテンシー、制限、課金トークンを測定し、代替モデルに用いるのと同じ合格基準を適用します。CometAPI のアクセス主張は Google の広範なロールアウトと別として扱い、経路が要件を満たすまでルーティングを可変に保ってください。