Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
無料で始める 無料で始める
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog GPT-6.1 Terra と GPT-6.1 Sol:ベンチマーク、料金、どちらを選ぶべきか ai-comparisons / CometAPIリサーチ
GPT-6.1 Terra と GPT-6.1 Sol:ベンチマーク、料金、どちらを選ぶべきか 公開された公式仕様やモデルカードを確認できないため、具体的な数値・価格を断定することはできません。以下は比較観点、検証設計、結果記録テンプレート、および擬似的な CometAPI の Python 呼び出し例です。実際の数値・API 名・パラメータは公式ドキュメントに合わせて置き換えてください。
比較観点とチェックリスト
- 公式ベンチマーク
- 推奨指標: MMLU、GSM8K、MATH、HumanEval/MBPP、BBH、TruthfulQA、MT-Bench、Long-context(Needle-in-a-Haystack 等)
- 収集元: 公式モデルカード、評価リポジトリ、技術ブログ、発表スライド
- 記録テンプレ:
- MMLU: Terra [ ], Sol [ ](評価条件: 温度、トップP、停止語、上下文長)
- GSM8K: Terra [ ], Sol [ ](pass@1/consistency)
- HumanEval: Terra [ ], Sol [ ](pass@1、テスト再実行回数)
- Long-context: Terra [ ], Sol [ ](最大コンテキスト、再現率)
- 推論性能(Reasoning)
- 観点: 算術・論理多段推論、長文要約における整合性、コード合成の正当性、ツール利用(関数呼び出し/RAG)での計画精度
- 設定統一: 温度=0~0.2、max_tokens、stop、同一プロンプトとツール可用性、deterministic seed
- 指標: 正答率、反事実混入率、根拠引用率、再現性(同一設定で一致率)、平均/95%レイテンシ
- API 価格と制限
- 入力単価($ / 1K tokens)、出力単価($ / 1K tokens)
- 無料枠・ボリューム割引、バッチ/ストリーミング可否
- コンテキスト長上限、出力上限、レート制限(RPM/TPM)、優先キューの有無
- 記録テンプレ:
- Terra: 入力 [ ], 出力 [ ], コンテキスト [ ], 限流 [ ]
- Sol: 入力 [ ], 出力 [ ], コンテキスト [ ], 限流 [ ]
- 実務ワークロード適合性
- RAG 質疑応答: 出典リンク必須、引用一貫性、ハルシネーション率
- コード生成+単体テスト: pass@1、修正反復回数、実行エラー率
- 構造化抽出: スキーマ準拠率、欠損/重複、数値桁落ち
- 関数呼び出し/ツール連携: 引数整合率、関数選択誤り率、タイムアウト率
- 長文要約/比較: 事実整合性、参照範囲の漏れ、要約圧縮率
- 多言語翻訳/ローカライズ: 用語一貫性、句読点/体裁遵守、固有名詞保持
- 実験設計の注意
- 同一データ・同一前処理、キャッシュ/再試行の管理、API バージョン固定
- ストリーミング/バッチは別評価、ログ: request_id、用量、コスト、レイテンシ、エラー分類
- 出力後検証: 正規表現・スキーマバリデーション・型チェックを自動化
比較の一般的な判断軸(埋め込み用)
- Terra を選ぶ場合の指標候補
- コスト効率・スループットを重視
- 低レイテンシ API、短~中コンテキストの安定運用
- バッチ処理・大量トラフィックでの一貫性
- Sol を選ぶ場合の指標候補
- 高難度推論や長文、厳密な整合性を重視
- 長コンテキストや複雑な関数呼び出しシナリオ
- 高い正答率が費用対効果で許容される場面
結果記録テンプレ(例)
- ベンチマーク
- Terra: MMLU [ ], GSM8K [ ], HumanEval [ ], Long-context [ ]
- Sol: MMLU [ ], GSM8K [ ], HumanEval [ ], Long-context [ ]
- 推論
- Terra: 正答率 [ ], 95%tile レイテンシ [ ], 反事実率 [ ]
- Sol: 正答率 [ ], 95%tile レイテンシ [ ], 反事実率 [ ]
- API/運用
- Terra: 入力単価 [ ], 出力単価 [ ], 限流 [ ], 安定性 [ ]
- Sol: 入力単価 [ ], 出力単価 [ ], 限流 [ ], 安定性 [ ]
- ワークロード別
- RAG: Terra [合格率/引用率], Sol [合格率/引用率]
- 抽出: Terra [スキーマ準拠], Sol [スキーマ準拠]
- コード: Terra [pass@1], Sol [pass@1]
CometAPI Python 例(擬似コード)
- 注意: これは擬似コードです。実際の CometAPI クライアント名、エンドポイント、パラメータ、レスポンス構造は公式仕様に置き換えてください。モデル ID も実環境の名称を使用してください。
# 擬似コード:2 モデルの比較実行と計測
import time
from typing import Dict, Any
# 例: CometAPI のクライアント初期化(実際の SDK に置換)
class CometClient:
def __init__(self, api_key: str, base_url: str = None):
self.api_key = api_key
self.base_url = base_url
def chat(self, model: str, messages: Any, temperature: float = 0.0, max_tokens: int = 512, stream: bool = False) -> Dict[str, Any]:
# 実際の API 呼び出しに置換
# 返却想定: {"id": "...", "usage": {"prompt_tokens": .., "completion_tokens": ..}, "choices": [{"message": {"role": "assistant", "content": "..."}}]}
return {"id": "req_...", "usage": {"prompt_tokens": 100, "completion_tokens": 120}, "choices": [{"message": {"role": "assistant", "content": "回答"}}]}
def run_once(client: CometClient, model: str, prompt: str) -> Dict[str, Any]:
messages = [
{"role": "system", "content": "あなたは正確で簡潔なアシスタントです。根拠は短く述べてください。"},
{"role": "user", "content": prompt}
]
t0 = time.perf_counter()
resp = client.chat(model=model, messages=messages, temperature=0.0, max_tokens=512, stream=False)
t1 = time.perf_counter()
out = {
"request_id": resp.get("id"),
"latency_sec": round(t1 - t0, 3),
"prompt_tokens": resp.get("usage", {}).get("prompt_tokens"),
"completion_tokens": resp.get("usage", {}).get("completion_tokens"),
"content": resp.get("choices", [{}])[0].get("message", {}).get("content")
}
return out
def compare_models():
api_key = "YOUR_API_KEY"
base_url = "https://api.comet.example" # 実際のエンドポイントに置換
client = CometClient(api_key=api_key, base_url=base_url)
models = ["gpt-6.1-terra", "gpt-6.1-sol"] # 実際のモデル ID に置換
prompt = "次の式の値を求めてください: (7×13) - (5×9)。最終答えのみを提示してください。"
results = {}
for m in models:
res = run_once(client, m, prompt)
results[m] = res
print(f"[{m}] latency={res['latency_sec']}s, tokens_in={res['prompt_tokens']}, tokens_out={res['completion_tokens']}")
print(f"output: {res['content']}\n")
return results
if __name__ == "__main__":
compare_models()
評価強化のための追加ヒント
- 同一データセットで少なくとも3回以上リピートし、平均と95%タイルを算出
- 入出力トークン数から推定コストを算出(価格表に基づき $/1K tokens を掛け合わせ)
- 長文/関数呼び出し/RAG などはプロファイルを分け、設定を固定して比較
- 実運用ログ(request_id、エラーコード、再試行回数)を保存して後追い可能にする
公開された公式仕様やモデルカードを確認できないため、具体的な数値・価格を断定することはできません。以下は比較観点、検証設計、結果記録テンプレート、および擬似的な CometAPI の Python 呼び出し例です。実際の数値・API 名・パラメータは公式ドキュメントに合わせて置き換えてください。
比較観点とチェックリスト
- 公式ベンチマーク
- 推奨指標: MMLU、GSM8K、MATH、HumanEval/MBPP、BBH、TruthfulQA、MT-Bench、Long-context(Needle-in-a-Haystack 等)
- 収集元: 公式モデルカード、評価リポジトリ、技術ブログ、発表スライド
- 記録テンプレ:
- MMLU: Terra [ ], Sol [ ](評価条件: 温度、トップP、停止語、上下文長)
- GSM8K: Terra [ ], Sol [ ](pass@1/consistency)
- HumanEval: Terra [ ], Sol [ ](pass@1、テスト再実行回数)
- Long-context: Terra [ ], Sol [ ](最大コンテキスト、再現率)
- 推論性能(Reasoning)
- 観点: 算術・論理多段推論、長文要約における整合性、コード合成の正当性、ツール利用(関数呼び出し/RAG)での計画精度
- 設定統一: 温度=0~0.2、max_tokens、stop、同一プロンプトとツール可用性、deterministic seed
- 指標: 正答率、反事実混入率、根拠引用率、再現性(同一設定で一致率)、平均/95%レイテンシ
- API 価格と制限
- 入力単価($ / 1K tokens)、出力単価($ / 1K tokens)
- 無料枠・ボリューム割引、バッチ/ストリーミング可否
- コンテキスト長上限、出力上限、レート制限(RPM/TPM)、優先キューの有無
- 記録テンプレ:
- Terra: 入力 [ ], 出力 [ ], コンテキスト [ ], 限流 [ ]
- Sol: 入力 [ ], 出力 [ ], コンテキスト [ ], 限流 [ ]
- 実務ワークロード適合性
- RAG 質疑応答: 出典リンク必須、引用一貫性、ハルシネーション率
- コード生成+単体テスト: pass@1、修正反復回数、実行エラー率
- 構造化抽出: スキーマ準拠率、欠損/重複、数値桁落ち
- 関数呼び出し/ツール連携: 引数整合率、関数選択誤り率、タイムアウト率
- 長文要約/比較: 事実整合性、参照範囲の漏れ、要約圧縮率
- 多言語翻訳/ローカライズ: 用語一貫性、句読点/体裁遵守、固有名詞保持
- 実験設計の注意
- 同一データ・同一前処理、キャッシュ/再試行の管理、API バージョン固定
- ストリーミング/バッチは別評価、ログ: request_id、用量、コスト、レイテンシ、エラー分類
- 出力後検証: 正規表現・スキーマバリデーション・型チェックを自動化
比較の一般的な判断軸(埋め込み用)
- Terra を選ぶ場合の指標候補
- コスト効率・スループットを重視
- 低レイテンシ API、短~中コンテキストの安定運用
- バッチ処理・大量トラフィックでの一貫性
- Sol を選ぶ場合の指標候補
- 高難度推論や長文、厳密な整合性を重視
- 長コンテキストや複雑な関数呼び出しシナリオ
- 高い正答率が費用対効果で許容される場面
結果記録テンプレ(例)
- ベンチマーク
- Terra: MMLU [ ], GSM8K [ ], HumanEval [ ], Long-context [ ]
- Sol: MMLU [ ], GSM8K [ ], HumanEval [ ], Long-context [ ]
- 推論
- Terra: 正答率 [ ], 95%tile レイテンシ [ ], 反事実率 [ ]
- Sol: 正答率 [ ], 95%tile レイテンシ [ ], 反事実率 [ ]
- API/運用
- Terra: 入力単価 [ ], 出力単価 [ ], 限流 [ ], 安定性 [ ]
- Sol: 入力単価 [ ], 出力単価 [ ], 限流 [ ], 安定性 [ ]
- ワークロード別
- RAG: Terra [合格率/引用率], Sol [合格率/引用率]
- 抽出: Terra [スキーマ準拠], Sol [スキーマ準拠]
- コード: Terra [pass@1], Sol [pass@1]
CometAPI Python 例(擬似コード)
- 注意: これは擬似コードです。実際の CometAPI クライアント名、エンドポイント、パラメータ、レスポンス構造は公式仕様に置き換えてください。モデル ID も実環境の名称を使用してください。
# 擬似コード:2 モデルの比較実行と計測
import time
from typing import Dict, Any
# 例: CometAPI のクライアント初期化(実際の SDK に置換)
class CometClient:
def __init__(self, api_key: str, base_url: str = None):
self.api_key = api_key
self.base_url = base_url
def chat(self, model: str, messages: Any, temperature: float = 0.0, max_tokens: int = 512, stream: bool = False) -> Dict[str, Any]:
# 実際の API 呼び出しに置換
# 返却想定: {"id": "...", "usage": {"prompt_tokens": .., "completion_tokens": ..}, "choices": [{"message": {"role": "assistant", "content": "..."}}]}
return {"id": "req_...", "usage": {"prompt_tokens": 100, "completion_tokens": 120}, "choices": [{"message": {"role": "assistant", "content": "回答"}}]}
def run_once(client: CometClient, model: str, prompt: str) -> Dict[str, Any]:
messages = [
{"role": "system", "content": "あなたは正確で簡潔なアシスタントです。根拠は短く述べてください。"},
{"role": "user", "content": prompt}
]
t0 = time.perf_counter()
resp = client.chat(model=model, messages=messages, temperature=0.0, max_tokens=512, stream=False)
t1 = time.perf_counter()
out = {
"request_id": resp.get("id"),
"latency_sec": round(t1 - t0, 3),
"prompt_tokens": resp.get("usage", {}).get("prompt_tokens"),
"completion_tokens": resp.get("usage", {}).get("completion_tokens"),
"content": resp.get("choices", [{}])[0].get("message", {}).get("content")
}
return out
def compare_models():
api_key = "YOUR_API_KEY"
base_url = "https://api.comet.example" # 実際のエンドポイントに置換
client = CometClient(api_key=api_key, base_url=base_url)
models = ["gpt-6.1-terra", "gpt-6.1-sol"] # 実際のモデル ID に置換
prompt = "次の式の値を求めてください: (7×13) - (5×9)。最終答えのみを提示してください。"
results = {}
for m in models:
res = run_once(client, m, prompt)
results[m] = res
print(f"[{m}] latency={res['latency_sec']}s, tokens_in={res['prompt_tokens']}, tokens_out={res['completion_tokens']}")
print(f"output: {res['content']}\n")
return results
if __name__ == "__main__":
compare_models()
評価強化のための追加ヒント
- 同一データセットで少なくとも3回以上リピートし、平均と95%タイルを算出
- 入出力トークン数から推定コストを算出(価格表に基づき $/1K tokens を掛け合わせ)
- 長文/関数呼び出し/RAG などはプロファイルを分け、設定を固定して比較
- 実運用ログ(request_id、エラーコード、再試行回数)を保存して後追い可能にする
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)TL;DR
高頻度で検証可能かつコストに敏感なタスクには GPT-6.1 Terra から始めてください。複雑なコーディング、マルチステップのツール使用、失敗が高コストとなるワークフローには GPT-6.1 Sol を評価しましょう。実務的なデフォルトは、まず Terra を使い、事前に定義したテストやバリデーションに失敗した場合に Sol へエスカレーションすることです。
Key Takeaways
標準トークン料金: OpenAI Standard において、Terra は入力 100 万トークンあたり $1、出力 100 万トークンあたり $5、Sol はそれぞれ $2 と $10。タスク別の性能: 最大推論設定では、Terra は Agents’ Last Exam v1 と Terminal-Bench-Science 0.1 でわずかにリード、Sol は Terminal-Bench 4.0 と OSWorld 2.1 でリード。共有のコンテキスト容量: 両モデルとも 1.05 百万トークンのコンテキストウィンドウを提供し、テキストと画像入力に対応。
明確性、出典の帰属、最新のAPI用語について確認済みです。
この要約で素早く答えを把握し、ガイドで背景、例、実装詳細を確認してください。
異なる推論制御:
none
low
運用コストが重要: リトライやツール呼び出しを含む、成功タスクあたりの支出を比較し、人間によるレビューコストは別途追跡。
GPT-6.1 Terra vs GPT-6.1 Sol: Overview and Specifications 以下の概要はトレードオフを要約したものです。詳細セクションでは、それぞれの選択の根拠、課金前提、および限界について説明します。
GPT-6.1 Terra: Efficient Visual and Agent Workflows OpenAI は 2026 年 10 月 26 日に GPT-6.1 Terra を発表しました。日常的なプロフェッショナルワークフロー向けに、ビジュアル推論、コンピュータ使用、汎用テキスト生成を組み合わせています。低いトークン単価により、頻出タスクで結果を検証できる場合の出発点として有用です。
GPT-6.1 Sol: Complex Coding and Professional Reasoning GPT-6.1 Sol は 2026 年 9 月 29 日にリリースされ、要求の厳しいコーディングやプロフェッショナル業務を対象とします。不慣れなリポジトリ、依存関係が多い長い連鎖作業、高価な修正が発生しうる状況では、追加の推論能力の価値を評価してください。
Context, Reasoning, and API Specifications API features: 両モデルとも Structured Outputs、ストリーミング、および Batch API に対応しています。ツール呼び出しは Responses API を使用し、ファインチューニングには非対応です。選択したプロバイダとエンドポイントが、アプリケーションに必要な機能を提供していることを確認してください。
両モデルとも、1,050,000 トークンのコンテキストウィンドウ内で最大 128,000 出力トークンが可能です。出力の上限をすべて確保すると、入力、システム指示、ツール履歴を含むその他のやり取りに 922,000 トークンが残ります。これは計画上の試算であり、別個の固定入力上限ではありません。
Architecture disclosure: 公開されているモデル仕様は、信頼できる比較に足る内部アーキテクチャの詳細を提供していません。コンテキスト容量や推論設定を、パラメータ数やアーキテクチャの証拠とみなすべきではありません。
Reasoning controls: Terra の none 設定は、単純な変換や抽出に有用です。初回比較では、両モデルでサポートされる同一の推論設定を使用し、その後に各モデルをワークロードの品質とレイテンシ要件に合わせて調整してください。
両モデルは同じ公開コンテキスト容量を持ちますが、それが同一のリトリーバル精度や長文コンテキスト推論品質を意味するわけではありません。したがってモデル選定では、推論品質、ワークフロー効率、コスト、タスク固有のリトリーバル性能を考慮してください。
報告結果は混在しています。Terra は一部のエージェントおよび科学系コーディング評価で僅差でリードし、Sol は一般的なターミナルコーディング、デスクトップ自動化、ビジョンでスコアが高い傾向です。以下の比較では、OpenAI のローンチ結果と独立評価を分け、それぞれが本番性能に対して何を示し、何を示さないかを説明します。
Official Benchmark Results and Test Conditions 以下の結果は、OpenAI の Terra ローンチ評価に基づきます。Terra は medium と最大推論強度、Sol は最大推論強度で示されています。最終列は最大推論強度同士の比較です。
OSWorld はオフラインの 2.1 評価を使用しています。ファクト性テストは、エラーを誘発するよう設計された OpenAI の内部プロンプトを使っています。これらは特定の評価セットアップにおけるベンダー報告の結果であり、本番ワークロードの測定ではありません。
全スコアはパーセンテージです。差分はパーセンテージポイント(pp)で表記しています。ファクトエラー率のみ低い方が良い指標です。0.1 ポイントのエラー率差だけでは、有意な信頼性優位を示すものではありません。
ソフトウェアエンジニアリングでは、Sol の Terminal-Bench におけるリードと、Terra の Terminal-Bench-Science における僅差のリードは、タスクの種類に依存することを示唆します。アプリケーションワークフローでは、Sol の OSWorld の高スコアはデスクトップ自動化での評価を支持し、Terra の Agents’ Last Exam の結果はプロフェッショナルなエージェントタスクの候補であることを示します。いずれの傾向も普遍的な勝者を確立するものではありません。
エージェントのスキャフォールディング、ツールアクセス、環境構成はこれらの結果に影響します。これらの数値はテスト候補の特定に用い、実際に必要なリポジトリ変更やアプリケーションワークフローに対して検証してください。
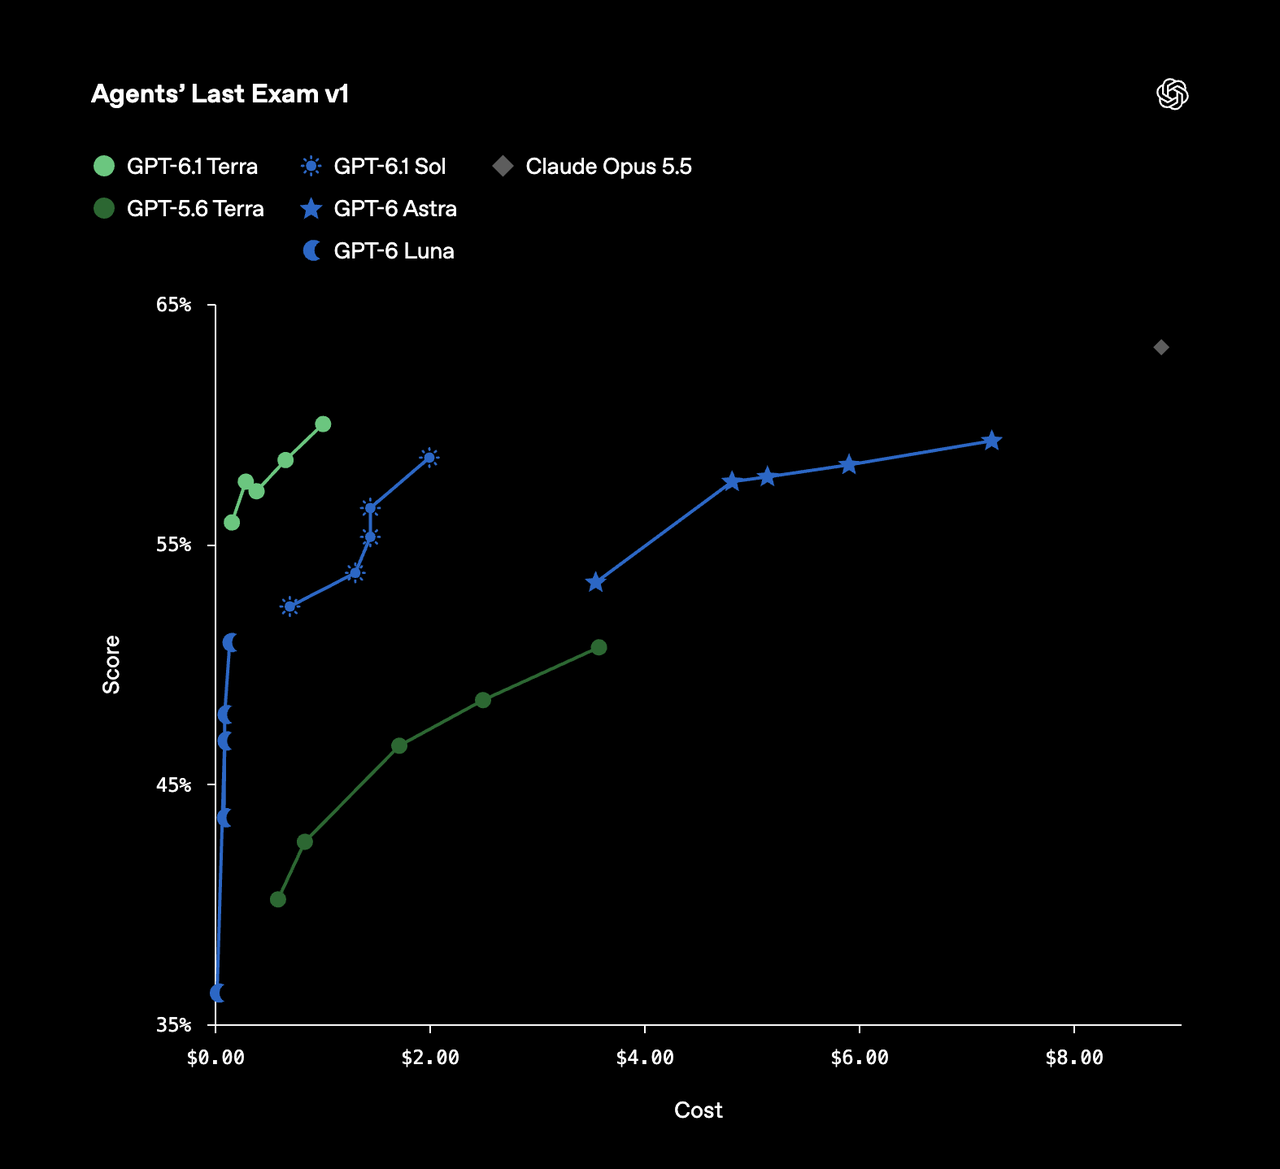
OpenAI の Agents’ Last Exam v1 チャートは、モデル設定ごとの推定タスクコストに対するスコアをプロットしています。これは上記のスコア表にコスト効率の観点を加えたものであり、描画されたコストは評価セットアップ固有のものです。
Independent Intelligence and Coding Evaluations Artificial Analysis の 10 月 26 日の評価では、最大推論強度で Terra は Sol より Intelligence Index で 4 ポイント低い位置付けです。Coding Agent Index v2.0 では Terra 48、Sol 54 です。これらは独立評価であり、独自の方法とスコアスケールを持つため、OpenAI のベンチマーク結果と数値的に結合すべきではありません。
同分析では、Terra の low および medium の推論設定がインテリジェンス評価で特にコスト効率に優れると指摘しています。これは、最大強度設定と並行して実用的な設定もテストすることを支持します。評価コストはテストセットアップ固有であり、アプリケーション支出の見積もりとして扱うべきではありません。
Speed and Latency: Task Completion vs. Token Generation OpenAI は、Terra が評価対象の Agents’ Last Exam タスクを Sol より 3 倍以上速く完了すると報告しています。これは推論やソフトウェア操作を含むエンドツーエンドのタスク測定であり、出力トークンのスループットが 3 倍であることや、すべての API リクエストで同程度の高速化が得られることを意味しません。
インタラクティブなアプリケーションでは、出力が始まるまでの待ち時間を測る「最初のトークンまでの時間」と、回答が続く速さを測る「1 秒あたりの出力トークン数」を区別してください。エージェントでは、ツール呼び出し、リトライ、リカバリを含む「エンドツーエンドの完了時間」を優先しましょう。
同一のプロンプト、ツール、サポートされる推論設定、合格基準を用いて両モデルを比較し、レイテンシをタスク成功と並行して記録してください。より速い応答でも、修正が増えたりワークフローを完了できない場合、その価値は限定的です。
Vision and Long-Context Performance: What the Results Establish 最大強度での MMMU-Pro において、Sol は 0.8 パーセンテージポイントのリードを示していますが、これは 1 つのビジョン評価結果であり、すべてのビジュアルワークフローでより優れている保証にはなりません。小さなラベル、悪いスキャン、密なダイアグラム、見慣れないレイアウトなど、代表的な入力でテストしてください。
上記の評価は、どのモデルが長文コンテキストのリトリーバルや推論で優れているかを確立してはいません。両モデルが同じ公開コンテキスト容量を持つとしても、それはリトリーバル精度やセッション間の記憶を示すものではありません。各モデルが文書から関連証拠を特定・活用できるかをテストし、アプリケーション状態はリクエスト間で明示的に維持してください。
GPT-6.1 Terra vs GPT-6.1 Sol: Cost トークン価格はコスト比較の出発点にすぎません。リトライ、推論トークン、ツール呼び出し、人間によるレビューも、タスクを成功裏に完了するための支出に影響します。
以下のレートは USD での 100 万トークンあたりの価格です。
OpenAI API Pricing Terra の掲載 Standard レートは、これらのカテゴリにおいて Sol の半分です。実際の課金はリクエスト構成に依存します。長文コンテキストリクエスト、処理階層、地域処理、ツール使用には異なる条件があり得ます。本番コスト見積もりの前に、該当する OpenAI の料金ドキュメントを確認してください。
CometAPI は独自の料金と機能提供を持つサードパーティのアクセス経路です。掲示された通常の入力・出力レートは下記に別途示しています。
これらのレートでは、CometAPI の通常の入力・出力価格は上記の OpenAI Standard レートより 20% 低くなっています。デプロイ前に、最新価格、長文コンテキスト課金、キャッシュ対応、ツール提供状況をアカウント単位で確認してください。
Example Cost for 1,000 Requests 仮にアプリケーションが 1,000 リクエストを行い、それぞれ 2,000 の未キャッシュ入力トークンと 500 の課金対象出力トークンを使用するとします。これは合計 200 万入力トークンと 50 万出力トークンを生みます。
1,000 リクエストで各 2,000 の未キャッシュ入力トークンと 500 の課金対象出力トークンを使用する場合の推定コストは次の通りです。
Terra(OpenAI 経由): 入力 $2.00、出力 $2.50、合計 $4.50 。Sol(OpenAI 経由): 入力 $4.00、出力 $5.00、合計 $9.00 。Terra(CometAPI 経由): 入力 $1.60、出力 $2.00、合計 $3.60 。Sol(CometAPI 経由): 入力 $3.20、出力 $4.00、合計 $7.20 。 これらの計算は、上記の通常レートを用いており、Batch API の割引は含みません。キャッシュ書き込み、個別のツール費用、リトライは除外しています。出力として課金される推論トークンは、出力合計に含める必要があります。
Effective Cost per Successful Task 本記事における成功タスクとは、所定の品質・スキーマ(該当時)・完了チェックを追加の人間による修正なしに通過したものを指します。
低いトークン価格が必ずしも低い運用コストを生むとは限りません。Terra の節約は、試行回数、推論トークン、人間の介入が増えると縮小し得ます。Sol の高いレートも、最初の試行でより多くのタスクを成功させるなら正当化されます。
成功タスクあたりの実効モデル・ツールコスト = 全試行におけるモデルとツールの総支出 ÷ 成功タスク数。
人間によるレビューと修正のコストは別途追跡してください。トークン価格だけでなく、所定の品質目標を最も低い合算コストで満たすモデルを選びましょう。
Which Model Should You Choose: GPT-6.1 Terra or GPT-6.1 Sol? タスクの複雑性、検証可能な出力品質、総完了コストに基づいて選択してください。Terra は日常的なワークフローの出発点として有用です。Sol は、難易度の高い推論や失敗コストが大きい場合に評価する価値があります。
When to Choose GPT-6.1 Terra Terra から開始するのは、高ボリュームの抽出、文書ドラフティング、カタログ照合、予測可能なアプリケーションワークフローに適しています。これらのタスクは、ソース文書、必須フィールド、自動バリデーションルールに照らして結果を検証できる場合に好適です。
Terra が、許容されるリトライおよび人間レビューの予算内で、精度と完了率の目標を満たす場合に選択してください。繰り返しの失敗で節約が消えるなら、低いトークン単価の利点は限定的です。
When to Choose GPT-6.1 Sol 難しいデバッグ、多数の依存関係を含むリポジトリの変更、依存関係が連鎖するデスクトップワークフローには Sol を評価してください。
テストの結果、より多くの受け入れられるパッチを出し、より多くのテストに合格し、手動修正が少ないことが示される場合には Sol を選択します。そうした改善が、作業完了までの総コストを下げるなら、より高いトークンコストは正当化されます。
When to Use Terra First and Escalate to Sol ハイブリッドワークフローでは、最初の試行を Terra に任せ、事前定義のチェックに失敗した場合に Sol へエスカレーションできます。エスカレーションは、モデルの自己申告の信頼度ではなく、観測可能な結果に基づいて判断してください。
例えばコード生成ワークフローでは、以下のようにします。
Terra に要求された変更を生成させる。
関連するテストとバリデーションチェックを実行する。
変更がこれらのチェックに不合格、または Terra の検証済み能力を超える場合は Sol にエスカレートする。
リトライ予算を使い切ったら、未解決のケースを人間レビューに回す。
エスカレーション時には、元の要求、関連コンテキスト、失敗した出力、バリデーション結果を保持してください。両モデルの使用量を記録し、コスト比較にワークフロー全体を含めます。
Production Evaluation Checklist デフォルトモデルの選定やエスカレーションワークフローのデプロイ前に:
代表的なタスクを使用: 日常的なリクエストと、失敗コストが高いケースの両方を含める。比較を制御: 同等の指示、証拠、ツール、合格基準を用いる。モデル ID、エンドポイント、推論設定、テスト日を記録する。受け入れ結果を測定: 精度、スキーマ妥当性(該当時)、テスト結果、手動修正なしの完了を確認する。時間と支出を測定: 中央値および尾部レイテンシ、課金トークン、ツール呼び出し、リトライ、人間レビュー工数を追跡する。比較を反復: タスクを複数回実行し、モデルの順序を交互にして一過性の影響を抑える。運用上限を定義: リトライ予算、エスカレーショントリガ、承認要件を事前に設定する。
Where Can You Access GPT-6.1 Terra and GPT-6.1 Sol?
Official Provider Access 両モデルは OpenAI API から利用可能です。テキストリクエストには Chat Completions がサポートされ、ツール呼び出しには Responses API が必要です。対象モデルのサポートパラメータ、アカウント制限、使用予定のルートで利用可能なツールを確認してください。
いずれのモデルも CometAPI 経由で使用するには、その クイックスタートガイド に従って OpenAI 互換の SDK をセットアップします。COMETAPI_KEY 環境変数で CometAPI キーを安全に供給し、ベース URL を https://api.cometapi.com/v1 に設定してください。モデル識別子には gpt-6.1-terra または gpt-6.1-sol を指定し、該当ルートがアカウントで有効化されていることを確認します。
最初の比較では、両モデルに同一の代表的なタスクを与え、推論強度は medium を使用してください。指示と合格基準を揃え、各タスクを反復し、モデル順序を交互にします。単一の応答で判断せず、成功結果、経過時間、課金トークン、リトライを比較してください。
Conclusion 頻繁で検証可能なワークフローでは、低いトークン単価と速いタスク完了が重要となるため、GPT-6.1 Terra から始めましょう。難しいコーディング、マルチステップのツール使用、失敗コストが大きい場合には、より高い推論能力が重要となる GPT-6.1 Sol を評価すべきです。最終選択は、代表的な評価セットにおける「受け入れ済みタスクあたりのコスト」に基づき、価格や単一のベンチマークだけで決めるべきではありません。
多くのアプリケーションにとって有用な次の一歩は、明確な合格条件と限定されたエスカレーションルートを持つ小規模かつ代表的なトライアルです。価格や単一のベンチマークに頼らず、計測結果に基づいてモデルを決定してください。
Starting workload 日常的なビジュアル作業と再現性の高いエージェント 複雑なコーディングと持続的な専門的推論 Context and modalities 総コンテキスト容量は同一;テキストと画像入力 総コンテキスト容量は同一;テキストと画像入力 Reasoning control 推論オフのオプションを含む 少なくとも低レベルの推論強度が必要 Published performance pattern 再現性の高いエージェントタスクで低コスト性能 難易度の高いコーディングとデスクトップテストで強力 API access OpenAI および CometAPI OpenAI および CometAPI
Official release date October 26, 2026 September 29, 2026 API model ID gpt-6.1-terra gpt-6.1-sol Context window 1,050,000 tokens 1,050,000 tokens Knowledge cutoff June 1, 2026 April 30, 2026 Input / output Text and images / text Text and images / text Reasoning effort none, low, medium, high, xhigh, max low, medium, high, xhigh, max Default reasoning effort medium medium
Agents’ Last Exam v1 57.60% 60.00% 58.60% Terra +1.4 pp MMMU-Pro (Vision) 84.60% 85.50% 86.30% Sol +0.8 pp OSWorld 2.1, offline 66.70% 74.20% 78.00% Sol +3.8 pp Terminal-Bench 4.0 35.80% 50.30% 55.90% Sol +5.6 pp Terminal-Bench-Science 0.1 34.30% 58.30% 57.00% Terra +1.3 pp Factual error rate on difficult prompts 10.10% 4.30% 4.40% Terra 0.1 pp lower
OpenAI Standard — input $1.00 $2.00 OpenAI Standard — cached input $0.05 $0.10 OpenAI Standard — output $5.00 $10.00 OpenAI Standard — 30-minute cache write $1.25 $2.50 OpenAI Standard — 12-hour cache write $2.50 $5.00 CometAPI ordinary input $0.80 $1.60 CometAPI ordinary output $4.00 $8.00
ワークフロー全体を比較:
GPT-6.1 Terra と GPT-6.1 Sol:ベンチマーク、料金、どちらを選ぶべきか - CometAPI