Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
無料で始める 無料で始める
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog Qwen 3.8 Max をローカルにデプロイする方法:ハードウェア、vLLM、SGLang、量子化に関するガイド guide / CometAPIリサーチ
Qwen 3.8 Max をローカルにデプロイする方法:ハードウェア、vLLM、SGLang、量子化に関するガイド 以下は、Qwen 3.8 Max(開源重み Qwen3.8-2.4T-A95B)をローカルデプロイするための実践ガイドです。vLLM/SGLang、FP8/FP4、最大 1M コンテキスト、そして本番最適化の観点を網羅します。
前提
- モデルは 1M コンテキスト用に事前対応済み(訓練/微調整+RoPE/NTK/YaRN 等の長文設定が含まれる)であることが望ましい。未対応チェックポイントに単純なスケーリングを適用すると品質・安定性が大きく劣化します。
- Hopper 世代(H100/H200/B100 など)の GPU を推奨(FP8、FlashAttention 世代最適化の恩恵が大きい)。
モデル取得
- 例(Hugging Face/ModelScope から LFS で取得・ローカル配置):
$ git lfs install
$ git clone <MODEL_REPO_URL> /models/Qwen3.8-2.4T-A95B
- trust_remote_code が必要な場合は読み込み側で有効化(セキュリティポリシーに注意)。
GPU要件の見積もり(目安)
- 重み(推論のみ):
- FP16/BF16: 約 2.0 GB × 1B パラメータ → 95B なら約 190 GB
- FP8(weight-only + scale/metadata 含む): 約 1.1–1.2 GB × 1B → 95B なら約 105–115 GB
- 4-bit(AWQ/GPTQ 等 weight-only): 約 0.55–0.6 GB × 1B → 95B なら約 52–57 GB
- KV キャッシュ(非常に支配的。概算・GQA 前提の目安):
- FP16 相当で約 320 KB/トークン(GQA により MHA 比で圧縮済みと仮定)
- FP8 で約 160 KB/トークン、FP4 で約 80 KB/トークン
- 例: 128k トークンなら FP8 KV ≈ 160 KB × 128k ≈ 約 20 GB、1M トークンなら ≈ 約 160 GB
- 実運用では 1M を常時保持するのは現実的でないことが多く、スライディングウィンドウ/KV オフロード/分割プリフィル等と併用するのが一般的。
量子化(FP8/FP4)の選択肢
- FP8
- Hopper 世代推奨。weight-only の FP8 チェックポイントを利用するのが安定。KV キャッシュも FP8 化できるランタイムなら併用でメモリ削減。
- FP4(4-bit)
- AWQ/GPTQ/HQQ 等の weight-only 量子化チェックポイント推奨。自前量子化する場合は AutoAWQ/GPTQ ツールチェーンで生成し、vLLM/SGLang が読み込める形式で保存。
- 品質の要点
- 4-bit は大幅に省メモリだが長文・推論安定性への影響が大きい。Max クラスの長文前提なら FP8 を基準に、必要に応じて 4-bit を評価。
vLLM での起動(例)
- インストール(CUDA/torch は環境に合わせる):
$ pip install "vllm>=0.5.4"
- OpenAI 互換 API サーバ:
$ python -m vllm.entrypoints.openai.api_server \
--model /models/Qwen3.8-2.4T-A95B \
--tensor-parallel-size 8 \
--dtype auto \
--max-model-len 1048576 \
--gpu-memory-utilization 0.90 \
--served-model-name qwen38-max \
--host 0.0.0.0 --port 8000
- 量子化・長文向けの追加例(環境・モデル対応に依存):
- KV キャッシュ圧縮: --kv-cache-dtype fp8(対応環境)または fp16/bf16 から選択
- チャンク化プリフィル: --enable-chunked-prefill True(大規模一括投入時の帯域効率改善)
- CPU オフロード(足りない場合): --swap-space <GB>(NVMe と組み合わせ)
- シャーディング: --tensor-parallel-size N を GPU 台数に合わせる
- 量子化重み: --quantization awq/gptq(該当フォーマットのモデルに一致させる)
- クライアント呼び出し(OpenAI 互換):
- base_url=http://<host>:8000/v1 model=qwen38-max を指定して chat/completions 等を利用。
SGLang での起動(例)
- インストール:
$ pip install "sglang>=0.3.2"
- サーバ起動(例):
$ python -m sglang.launch_server \
--model /models/Qwen3.8-2.4T-A95B \
--tp 8 \
--host 0.0.0.0 --port 8000
- 量子化・長文向けの追加例(実装バージョンに依存):
- --quantization awq/gptq
- --kv-cache-dtype fp8(対応時)
- --max-context-len 1048576(モデル対応が前提)
- RadixAttention/Chunked prefill/Prefill–decode 並列化などの最適化フラグを有効化
1M コンテキスト運用のポイント
- モデル側前提
- 1M に対応したチェックポイントを利用(config.json の rope_scaling/positional 設定が既に含まれていることが望ましい)。
- ランタイム側
- KV キャッシュ圧縮(fp8/fp4)やオフロード(CPU/NVMe)、チャンク化プリフィル、スライディングウィンドウを併用。
- 実際は 1M を常時保持せず、重要ブロックを残しつつ古いブロックを捨てる/圧縮する戦略が現実的。
- アプリ設計
- 検索拡張(RAG)や要約・圧縮、階層化メモリを併用して実効コンテキストを制御。
本番最適化チェックリスト
- 性能
- FlashAttention 2/3、Tensor Cores を活かす CUDA/ドライバを整備。
- バッチング/スケジューラ(vLLM/SGLang のデフォルト)を活用。max_num_seqs、max_tokens_per_batch をワークロードに合わせ調整。
- Speculative decoding/Chunked prefill/Continuous batching を有効化(サポート時)。
- Tensor parallel の分割数を GPU 台数・NVLink 括りに合わせ最適化。
- メモリ
- FP8/FP4 の weight-only+KV 圧縮、KV の CPU/NVMe オフロードを組み合わせて「重み+KV」の合計が収まるよう設計。
- 長文要求が少ないトラフィックは短い max_model_len のプールへ分流(SLO を層分け)。
- 安定性/運用
- ウォームアップ(典型長で事前実行)、固定長プロンプトのキャッシュ、分散障害時のヘルスチェックと自動復旧。
- プロメテウス/ログ集約でトークンレイテンシ、KV ブロック使用率、OOM 直前指標を可視化。
- ノード間は NCCL/TCP チューニング(NVLink 推奨、跨りはレイテンシ増に注意)。
- 品質
- 量子化(特に 4-bit)は長文・推論安定性を A/B 測定。重要ジョブは FP8 を基準、必要なら混在デプロイ(ルーティング)で最適化。
- セキュリティ/再現性
- trust_remote_code の管理、モデル/依存の固定(hash/pin)、容器化(Docker/OCI)と CUDA 互換層の固定。
代表的な構成例(目安)
- 構成A(高品質・長文重視): 8×H100 80GB, FP8 weight-only, KV=FP8, max_model_len 128k(ピーク時のみ 512k〜1M をスイッチ)、CPU/NVMe オフロード有。
- 構成B(省メモリ・高密度): 4×H100 80GB, 4-bit weight-only(AWQ/GPTQ), KV=FP8, max_model_len 64k〜128k、長文要求は別プールへ転送。
- 構成C(大規模 1M 実験): 8–16×H100 80GB 以上, FP8 weight-only, KV=FP4/FP8 併用、強オフロード+チャンク化プリフィル+スライディングウィンドウ、長文は分割投入。
トラブル対処の要点
- OOM: max_model_len/並列度/バッチサイズを下げる、KV 圧縮/オフロードを強化、TP を増やして再配置。
- 性能伸び悩み: スループット系フラグ(chunked prefill/continuous batching/speculative)とバッチ閾値を再調整、PCIe/ネットワーク帯域を確認。
- 品質低下: 量子化ビット幅/グループサイズを緩和、FP8 に戻す、長文時のみ高精度プールを使用。
補足
- 実際の起動フラグ名やサポート状況は vLLM/SGLang のバージョンで変わります。該当バージョンの --help とリリースノートを確認し、モデルの量子化形式・長文設定と揃えてください。
Deon Goodwin AIモデルとAPIの調査チーム 以下は、Qwen 3.8 Max(開源重み Qwen3.8-2.4T-A95B)をローカルデプロイするための実践ガイドです。vLLM/SGLang、FP8/FP4、最大 1M コンテキスト、そして本番最適化の観点を網羅します。
前提
- モデルは 1M コンテキスト用に事前対応済み(訓練/微調整+RoPE/NTK/YaRN 等の長文設定が含まれる)であることが望ましい。未対応チェックポイントに単純なスケーリングを適用すると品質・安定性が大きく劣化します。
- Hopper 世代(H100/H200/B100 など)の GPU を推奨(FP8、FlashAttention 世代最適化の恩恵が大きい)。
モデル取得
- 例(Hugging Face/ModelScope から LFS で取得・ローカル配置):
$ git lfs install
$ git clone <MODEL_REPO_URL> /models/Qwen3.8-2.4T-A95B
- trust_remote_code が必要な場合は読み込み側で有効化(セキュリティポリシーに注意)。
GPU要件の見積もり(目安)
- 重み(推論のみ):
- FP16/BF16: 約 2.0 GB × 1B パラメータ → 95B なら約 190 GB
- FP8(weight-only + scale/metadata 含む): 約 1.1–1.2 GB × 1B → 95B なら約 105–115 GB
- 4-bit(AWQ/GPTQ 等 weight-only): 約 0.55–0.6 GB × 1B → 95B なら約 52–57 GB
- KV キャッシュ(非常に支配的。概算・GQA 前提の目安):
- FP16 相当で約 320 KB/トークン(GQA により MHA 比で圧縮済みと仮定)
- FP8 で約 160 KB/トークン、FP4 で約 80 KB/トークン
- 例: 128k トークンなら FP8 KV ≈ 160 KB × 128k ≈ 約 20 GB、1M トークンなら ≈ 約 160 GB
- 実運用では 1M を常時保持するのは現実的でないことが多く、スライディングウィンドウ/KV オフロード/分割プリフィル等と併用するのが一般的。
量子化(FP8/FP4)の選択肢
- FP8
- Hopper 世代推奨。weight-only の FP8 チェックポイントを利用するのが安定。KV キャッシュも FP8 化できるランタイムなら併用でメモリ削減。
- FP4(4-bit)
- AWQ/GPTQ/HQQ 等の weight-only 量子化チェックポイント推奨。自前量子化する場合は AutoAWQ/GPTQ ツールチェーンで生成し、vLLM/SGLang が読み込める形式で保存。
- 品質の要点
- 4-bit は大幅に省メモリだが長文・推論安定性への影響が大きい。Max クラスの長文前提なら FP8 を基準に、必要に応じて 4-bit を評価。
vLLM での起動(例)
- インストール(CUDA/torch は環境に合わせる):
$ pip install "vllm>=0.5.4"
- OpenAI 互換 API サーバ:
$ python -m vllm.entrypoints.openai.api_server \
--model /models/Qwen3.8-2.4T-A95B \
--tensor-parallel-size 8 \
--dtype auto \
--max-model-len 1048576 \
--gpu-memory-utilization 0.90 \
--served-model-name qwen38-max \
--host 0.0.0.0 --port 8000
- 量子化・長文向けの追加例(環境・モデル対応に依存):
- KV キャッシュ圧縮: --kv-cache-dtype fp8(対応環境)または fp16/bf16 から選択
- チャンク化プリフィル: --enable-chunked-prefill True(大規模一括投入時の帯域効率改善)
- CPU オフロード(足りない場合): --swap-space <GB>(NVMe と組み合わせ)
- シャーディング: --tensor-parallel-size N を GPU 台数に合わせる
- 量子化重み: --quantization awq/gptq(該当フォーマットのモデルに一致させる)
- クライアント呼び出し(OpenAI 互換):
- base_url=http://<host>:8000/v1 model=qwen38-max を指定して chat/completions 等を利用。
SGLang での起動(例)
- インストール:
$ pip install "sglang>=0.3.2"
- サーバ起動(例):
$ python -m sglang.launch_server \
--model /models/Qwen3.8-2.4T-A95B \
--tp 8 \
--host 0.0.0.0 --port 8000
- 量子化・長文向けの追加例(実装バージョンに依存):
- --quantization awq/gptq
- --kv-cache-dtype fp8(対応時)
- --max-context-len 1048576(モデル対応が前提)
- RadixAttention/Chunked prefill/Prefill–decode 並列化などの最適化フラグを有効化
1M コンテキスト運用のポイント
- モデル側前提
- 1M に対応したチェックポイントを利用(config.json の rope_scaling/positional 設定が既に含まれていることが望ましい)。
- ランタイム側
- KV キャッシュ圧縮(fp8/fp4)やオフロード(CPU/NVMe)、チャンク化プリフィル、スライディングウィンドウを併用。
- 実際は 1M を常時保持せず、重要ブロックを残しつつ古いブロックを捨てる/圧縮する戦略が現実的。
- アプリ設計
- 検索拡張(RAG)や要約・圧縮、階層化メモリを併用して実効コンテキストを制御。
本番最適化チェックリスト
- 性能
- FlashAttention 2/3、Tensor Cores を活かす CUDA/ドライバを整備。
- バッチング/スケジューラ(vLLM/SGLang のデフォルト)を活用。max_num_seqs、max_tokens_per_batch をワークロードに合わせ調整。
- Speculative decoding/Chunked prefill/Continuous batching を有効化(サポート時)。
- Tensor parallel の分割数を GPU 台数・NVLink 括りに合わせ最適化。
- メモリ
- FP8/FP4 の weight-only+KV 圧縮、KV の CPU/NVMe オフロードを組み合わせて「重み+KV」の合計が収まるよう設計。
- 長文要求が少ないトラフィックは短い max_model_len のプールへ分流(SLO を層分け)。
- 安定性/運用
- ウォームアップ(典型長で事前実行)、固定長プロンプトのキャッシュ、分散障害時のヘルスチェックと自動復旧。
- プロメテウス/ログ集約でトークンレイテンシ、KV ブロック使用率、OOM 直前指標を可視化。
- ノード間は NCCL/TCP チューニング(NVLink 推奨、跨りはレイテンシ増に注意)。
- 品質
- 量子化(特に 4-bit)は長文・推論安定性を A/B 測定。重要ジョブは FP8 を基準、必要なら混在デプロイ(ルーティング)で最適化。
- セキュリティ/再現性
- trust_remote_code の管理、モデル/依存の固定(hash/pin)、容器化(Docker/OCI)と CUDA 互換層の固定。
代表的な構成例(目安)
- 構成A(高品質・長文重視): 8×H100 80GB, FP8 weight-only, KV=FP8, max_model_len 128k(ピーク時のみ 512k〜1M をスイッチ)、CPU/NVMe オフロード有。
- 構成B(省メモリ・高密度): 4×H100 80GB, 4-bit weight-only(AWQ/GPTQ), KV=FP8, max_model_len 64k〜128k、長文要求は別プールへ転送。
- 構成C(大規模 1M 実験): 8–16×H100 80GB 以上, FP8 weight-only, KV=FP4/FP8 併用、強オフロード+チャンク化プリフィル+スライディングウィンドウ、長文は分割投入。
トラブル対処の要点
- OOM: max_model_len/並列度/バッチサイズを下げる、KV 圧縮/オフロードを強化、TP を増やして再配置。
- 性能伸び悩み: スループット系フラグ(chunked prefill/continuous batching/speculative)とバッチ閾値を再調整、PCIe/ネットワーク帯域を確認。
- 品質低下: 量子化ビット幅/グループサイズを緩和、FP8 に戻す、長文時のみ高精度プールを使用。
補足
- 実際の起動フラグ名やサポート状況は vLLM/SGLang のバージョンで変わります。該当バージョンの --help とリリースノートを確認し、モデルの量子化形式・長文設定と揃えてください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)ローカルで Qwen3.8-Max を実行することは今や可能ですが、「Qwen 3.8 Max をローカルで」という表現には重要な注意点が一つあります。Alibaba のホスト型 Max 製品とダウンロード可能なチェックポイントは密接に関連していますが、同一の製品ではありません。
Qwen は 2026 年 8 月上旬にホスト型 Max サービスを最初に提供し、2026 年 8 月 12 日に Qwen3.8-2.4T-A95B をオープンウェイトとして公開しました(リンク )。このチェックポイントこそが、実際に自社インフラにデプロイするモデルです。
これは一般的な「ゲーミング PC 上の Ollama」チュートリアルではありません。非量子化チェックポイントは 2.4 兆パラメータの Mixture-of-Experts モデルであり、現行の vLLM レシピでは BF16 ウェイトのサイズが 4.45 TiB とされています。実運用志向の 4-bit 浮動小数点変種でも、ウェイト容量はおおよそ 1.3~1.5 TiB に達します。
簡潔な答え: 完全な Qwen 3.8 Max クラスのセルフホスティングはデータセンター導入です。実用的なプロダクションの出発点は
明確性、出典の帰属、最新のAPI用語について確認済みです。
この要約で素早く答えを把握し、ガイドで背景、例、実装詳細を確認してください。
Qwen 3.8 Max と実際にデプロイするオープンモデルの違い ダウンロード可能な Qwen3.8-2.4T-A95B チェックポイントは、1 トークンあたり約 95B パラメータがアクティブな 2.4T パラメータの因果言語モデルと公式に説明されています。ホスト型 Max サービスは、現行のオープンチェックポイントにはないプロダクト層の機能を追加しています。
総パラメータ 2.4T 2.4T アクティブパラメータ ~95B ~95B アーキテクチャ スパース MoE スパース MoE 入力 テキスト、画像、動画 テキスト コンテキスト 1M マネージド・コンテキスト 262,144 ネイティブ;~1.01M まで拡張可能 思考動作 管理された思考/非思考オプション 思考必須;推論負荷は設定可能 組み込みツール マネージドサービスで提供 アプリケーション側でツール提供が必要 セルフホスティング ウェイト管理不要 あり;オープンチェックポイント
ホスト型製品は、テキスト・画像・動画入力と 1,000,000 トークンのコンテキストを提供します。対照的に、オープンチェックポイントはテキスト専用で、ネイティブのコンテキストは 262,144 トークンです。アプリケーションがマルチモーダル入力やマネージドの組み込みツールに依存する場合、この差は重要です。
Qwen 3.8 のアーキテクチャと仕様 CometAPI は「What is Qwen3.8 Max」でモデル背景を既に扱っているため、このデプロイガイドではメモリ、並列化、サービングに影響する詳細に絞って解説します。
総/アクティブパラメータ 2.4T / 1 トークンあたり約 95B 層構成 92 層:69 Gated DeltaNet + 23 フルアテンション MoE ルーティング 512 のルーティッド・エキスパート;10 ルーティッド + 1 共有がアクティブ フルアテンションヘッド 64 クエリ/4 キー・バリューヘッド ネイティブコンテキスト 262,144 トークン 拡張コンテキスト 約 1,010,000 トークンまで Multi-Token Prediction 対応 オープンチェックポイントのモダリティ テキストのみ
「95B のアクティブパラメータ」を、95B モデル相当のメモリフットプリントと解釈しないでください。スパース活性化はトークン当たりの計算量を減らしますが、サービングシステムは依然として全エキスパートのウェイトセットにアクセスする必要があります。
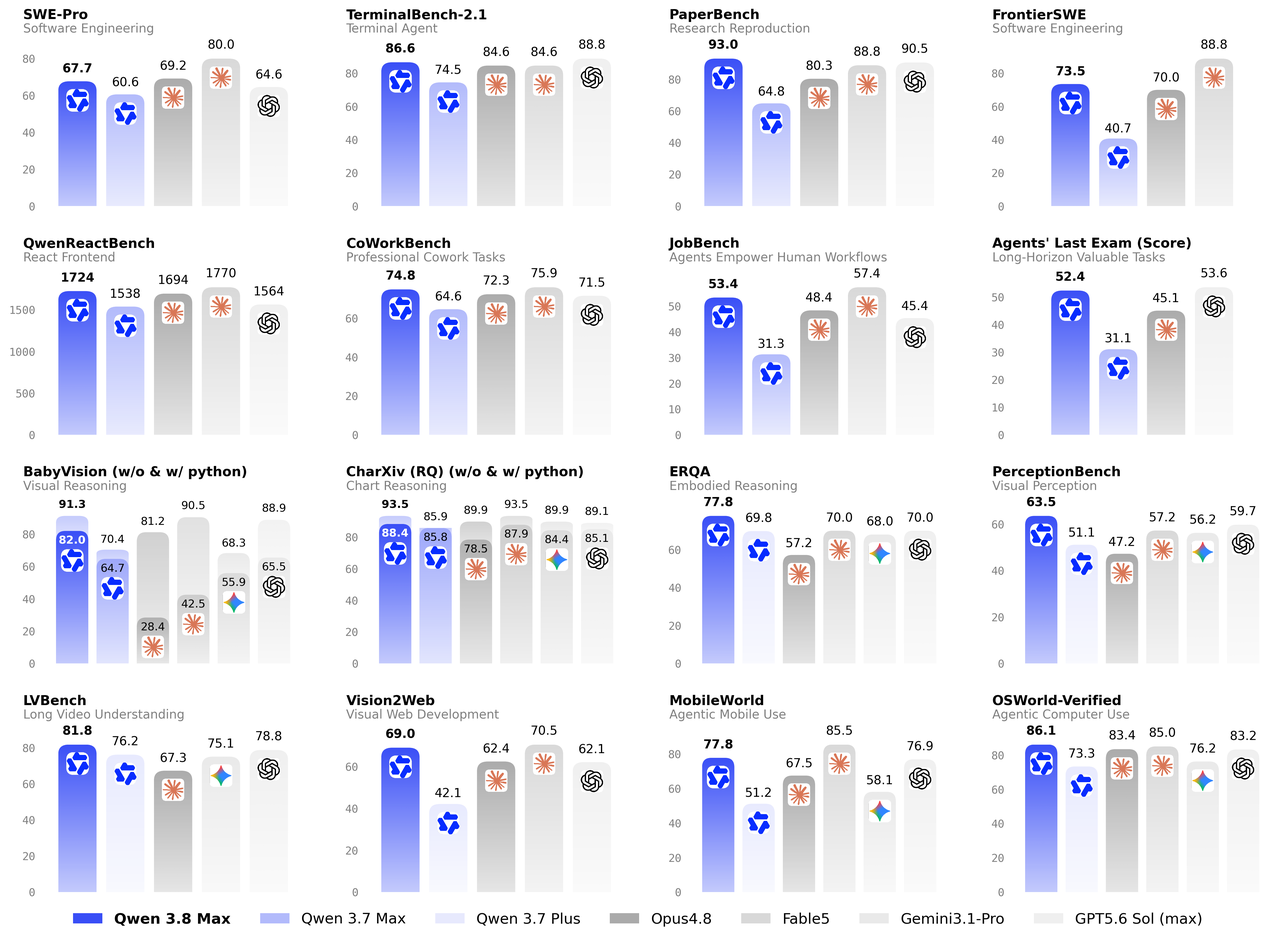
Qwen 3.8 Max ベンチマークのスナップショット CometAPI の既存の Qwen3.8 Max 概要でベンチマークは詳述されているため、本記事では公式の Qwen モデルカードのベンチマーク表から、デプロイに関係するサブセットのみを取り上げます。
Terminal Bench 2.1 86.6 74.5 88.8 SWE-bench Pro 67.7 60.6 64.6 PaperBench 93.0 64.8 90.5 FrontierSWE 73.5 40.7 — CoWorkBench 74.8 64.6 71.5 GPQA Diamond 92.6 92.4 94.1
Qwen チーム
このサブセットで Qwen3.7-Max に対する最大の改善は PaperBench と FrontierSWE です。Qwen3.8-Max は SWE-bench Pro と PaperBench で GPT-5.6 Sol を上回る一方、Terminal Bench 2.1 では GPT-5.6 Sol が先行しています。デプロイ判断では、これらは能力の文脈として扱い、以下のメモリやサービングスループット測定をより運用面の指標としてください。
ベンチマーク表は普遍的なランキングではありません。ハーネス、タイムアウト、コンテキスト制限、ツールアクセス、量子化により結果は変わり得ます。使用予定のチェックポイント、精度、サービングエンジン、プロンプト分布を厳密に一致させてベンチマークを行ってください。
ローカルデプロイに Qwen3.8 はどんなハードウェアを必要とするか?
Qwen3.8-2.4T-A95B の GPU 要件 これが主要なデプロイ論点です。現行の vLLM Qwen3.8 レシピ は、チェックポイントのフットプリントと実運用を想定した GPU 台数(ランタイムの余裕込み)を公開しており、単純にパラメータ数から VRAM を見積もるより有用です。
BF16 4.45 TiB 24 GPUs 24 GPUs 48 GPUs 最高忠実度/リサーチ FP8 2.27 TiB 16 GPUs 16 GPUs 32 GPUs 高忠実度のプロダクション MXFP4 1.45 TiB — 8 GPUs 16 GPUs 実用的な AMD デプロイ NVFP4 W4A4 1.32 TiB 8 GPUs — 16 GPUs 実用的な NVIDIA デプロイ
本当に Qwen3.8 をセルフホストする必要がある多くの組織にとって、実用的な出発点は FP4 です。NVIDIA 側の注目構成は 8× B300 での NVFP4 W4A4 で、AMD 側の対応は 8× MI355X での MXFP4 です。
8× H200 サーバーは、これら推奨のフルモデルデプロイには足りません。公式レシピでは FP4 に 16× H200、FP8 に 32、BF16 に 48 を割り当てています。
Qwen3.8-27B の VRAM 要件 Qwen3.8-27B は実用的なワークステーションクラスの代替です。生のウェイトメモリは BF16 で約 54 GB、FP8 で 27 GB、4-bit で 13.5 GB です。ランタイムのオーバーヘッドと KV キャッシュにより、特に長いコンテキスト長では実際の必要量が増加します。
BF16 ~54 GB コンテキストやサービングのオーバーヘッドに応じて 64–80 GB GPU を使用 FP8 / INT8 ~27 GB 実運用の余裕を考慮し 40–48 GB GPU を推奨 4-bit ~13.5 GB 中程度のコンテキスト長なら 20–24 GB のコンシューマ GPU でも可
これらはパラメータ数から導いた計画用の概算です。プロダクションのハードウェアを選定する前に、正確なチェックポイント、量子化形式、サービングエンジン、コンテキスト長、KV キャッシュ設定で確認してください。
Qwen3.8 はコンシューマ向け GPU で動作するか? フルの Qwen3.8-2.4T-A95B モデルは、強い量子化を行っても一般的なコンシューマ GPU では実用的ではありません。コミュニティプロジェクトは 4 台の DGX Spark を跨いだ 397 GB の UD-Q1_0 ビルドという極端な圧縮のデモを示しましたが、これは品質重視のサービングにおける基準ではなく、実験的な極端量子化のアプローチです。
ワークステーションやホームラボには、より適切なのは Qwen3.8-27B です。オープンウェイトは 2026 年 8 月 14 日に公開されました。このモデルはホスティングが桁違いに容易で、「ローカル」が 1 台のワークステーションを意味する場合に適した選択です。
Qwen 3.8 Max をインストールする前に インストールコマンドを実行する前にインフラを計画してください。Linux、互換のアクセラレータスタック、チェックポイント用の十分なローカルまたは共有ストレージ、高帯域の GPU 相互接続、およびノードを跨ぐ場合は分散推論向けに設計されたネットワークが必要です。vLLM レシピは現在、vLLM nightly と Transformers 5.4.0 以降 を推奨しています。
uv venv
source .venv/bin/activate

uv pip install -U vllm \
  --extra-index-url https://wheels.vllm.ai/nightly

uv pip install -U "transformers>=5.4.0"
vLLM で Qwen 3.8 を FP8 でデプロイする方法 2 ノード・16 GPU の B300 クラスデプロイでは、ヘッドノードで以下を実行します。
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
On the worker node, use the same topology with a different node rank and no API server:
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 1 \
  --master-addr "$HEAD_ADDR" \
  --headless \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
この 16 GPU の例を H200 サーバーにサイズ変更せずにそのまま移植しないでください。同じ FP8 変種でも、vLLM レシピでは現在 32× H200 と見積もられています。
1 台の 8× B300 サーバーで Qwen 3.8 を動かす方法 NVIDIA Blackwell では、最も実用的なフルモデル構成は NVFP4 です。vLLM は現在、8 基の B300 にまたがるテンソル並列で NVFP4 W4A4 を検証しています。
vllm serve Inferact/Qwen3.8-2.4T-A95B-NVFP4 \
  --tensor-parallel-size 8 \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
Inferact の NVFP4 ビルドは、元の BF16 の Qwen アーティファクトではなく量子化チェックポイントです。BF16 や FP8 の代替として扱う前に、自組織の受け入れセットでモデル品質を検証してください。
SGLang で Qwen 3.8 をデプロイする方法 SGLANG_ENABLE_MOE_DEFERRED_FINALIZE=1 \
SGLANG_FLASHINFER_MNNVL_CUTEDSL_AR_FUSION=1 \
sglang serve \
--trust-remote-code \
--model-path RadixArk/Qwen3.8-2.4T-A95B-NVFP4 \
--tp-size 8 \
--context-length 200000 \
--preferred-sampling-params '{"top_k": 20}' \
--attention-backend trtllm_mha \
--linear-attn-prefill-backend flashinfer \
--linear-attn-decode-backend flashinfer \
--reasoning-parser qwen3 \
--tool-call-parser qwen3_coder \
--host 0.0.0.0 \
--port 30000
SGLang は、MTP を用いた TP8 B300 でバッチサイズ 1 の場合に 346 出力トークン/秒を報告しており、分離サービング構成では総合スループットがさらに大きくなります。これらの数値はサービングスタックの測定値であり、モデル品質のベンチマークではないと解釈してください。
ローカルの OpenAI 互換エンドポイントをテストする vLLM と SGLang はどちらも OpenAI 互換の API を公開しているため、アプリケーション統合は容易です。
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600,
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-2.4T-A95B-FP8",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant Redis architecture for three regions."
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=8192,
)

print(response.choices[0].message.content)
公式のモデルカードは、ベースラインのサンプリングパラメータとして temperature=1.0、top_p=0.95、top_k=20 を推奨しています。エージェント的な作業では、最終的な可視回答だけでなく推論にも十分な出力予算を残してください。
1M コンテキストウィンドウを有効にする VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 \
vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
--max-model-len 1010000 \
--hf-overrides '{"max_position_embeddings": 1010000}' \
--reasoning-parser qwen3 \
...
サポートされるからといって 1M をデフォルトにしないでください。最大コンテキストを大きくするとキャッシュ容量を多く予約し、同時実行性が大幅に低下する可能性があります。--max-model-len は実際のワークロードに合わせて設定してください。
Qwen3.8 の推論性能を向上させるには?
単一ユーザーのレイテンシを下げるために MTP-3 を使用する Qwen3.8 は Multi-Token Prediction を含みます。vLLM の公開測定では、MTP-3 により FP8 TP16 の場合にユーザー当たりの出力が 130 から 307 tok/s に 、NVFP4 TP8 で 133 から 304 tok/s に向上します。
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
fastsafetensors を使って起動時間を短縮する テラバイト規模のモデルでは、起動時間が重要です。ある vLLM の計測では、fastsafetensors と遅延読み込みによりウェイトのロード時間が 545 s から 306 s に短縮されました。
--load-format fastsafetensors \
--safetensors-load-strategy lazy
エキスパート並列を使って同時スループットを増やす 高い同時実行を求める場合、Qwen3.8 は 512 のルーティッド・エキスパートを持つため、エキスパート並列レイアウトが有効です。vLLM は FP8 EP で最大 3,200 total tok/s/GPU 、最適化された NVFP4 DEP16 構成で最大 4,300 total tok/s/GPU を報告しています。
--max-model-len を適切に設定して VRAM と同時実行のバランスを取る --max-model-len はワークロードが本当に必要とする最長シーケンス長に設定してください。値が大きいほど KV キャッシュの予約が増え、メモリ圧力が高まり、モデルウェイトが既に収まっていても同時処理数が減ることがあります。
モデルが宣伝する最大コンテキストではなく、代表的な本番パーセンタイルから始めてください。同じ精度、バッチパターン、サービングエンジンでロードテストし、実際の要求がより長いコンテキストを必要とする場合のみ引き上げます。
Qwen 3.8 Max のローカルデプロイと API の比較 オープンウェイトは、ローカル推論が自動的に経済的であることを意味しません。適切な判断は、稼働率、データ常駐要件、要員体制、可用性目標、そしてマネージドモデルのマルチモーダル機能が本当に必要かどうかに依存します。
インフラ マルチ GPU サーバーまたはクラスター GPU インフラ不要 入力モダリティ テキスト テキスト、画像、動画 コンテキスト 262K ネイティブ;~1.01M 拡張 マネージド 1M データ制御 最大 クラウド API オペレーション 監視・アップグレード・HA を自前で実施 プロバイダ管理 最適適用 データ常駐、持続的な高稼働、インフラチーム 多くのアプリチーム、変動するワークロード
既に適切なアクセラレータを保有し、持続的に高い稼働率が見込める場合、セルフホスティングは正当化できます。もしこのモデルのためだけにクラスターを調達するなら、通常は CometAPI 上の Qwen3.8-Max のほうが摩擦が少ないでしょう。既存の API ガイドはホスト型の統合を、料金ガイドはコストモデルを扱っているため、本記事はローカルデプロイに焦点を当てています。
Qwen 3.8 のローカルデプロイでよくある問題
サーバーが起動時に GPU メモリ不足になる キャッシュが原因なら --max-model-len をまず下げてください。ウェイト自体が収まらない場合、コンテキストを削っても根本解決にはならないため、検証済みの低精度チェックポイントに移行するか GPU を追加してください。
テンソル並列のサイズが無効で失敗する
サーバーの起動に長時間かかる 1~数テラバイトのウェイトのロードに加え、カーネルの JIT もあり、起動には数分を要します。VLLM_ENGINE_READY_TIMEOUT_S を増やし、短い起動時間を前提にせず実際の推論エンドポイントをプローブしてください。
ローカルモデルが画像を処理できない Qwen3.8-2.4T-A95B のオープンチェックポイントはテキスト専用です。この制限は Qwen3.8-2.4T-A95B に固有です。Qwen3.8-27B は、別途ビジョン投影ファイルをロードした場合に視覚入力をサポートします。
1M コンテキストでスループットが大幅に低下する --max-model-len を、ワークロードが実際に必要とする最長シーケンスに下げてください。サポートされる最大のコンテキストウィンドウが最適な本番設定とは限りません。ワークロード要件、KV キャッシュ使用量、同時実行性のバランスが取れるコンテキスト制限を選びましょう。
Ollama や LM Studio は Qwen 3.8 Max を実行できるか? エコシステムは、llama.cpp スタイルの推論のために強く量子化された Qwen3.8 ウェイトをパッケージ化できますが、それを一般的なデスクトップの Ollama ワークフローと混同すべきではありません。数百 GB を占める量子化ビルドは、依然として数百 GB のアクセス可能なメモリを要求し、品質と性能に大きなトレードオフを伴います。
通常のローカル開発には、Qwen3.8-27B が適切なターゲットです。極端なコミュニティ量子化により異例のハードウェアで技術的に起動できるとしても、フルの 2.4T モデルはサーバー/クラスター向けモデルとして扱うべきです。
どのデプロイ方法を選ぶべきか? NVIDIA Blackwell では、8× B300 の NVFP4 デプロイが現在もっともすっきりしたフルモデルの出発点です。AMD では、8× MI355X の MXFP4 が対応する実用構成です。チェックポイントの出所と品質をインフラ規模より優先する場合は FP8 を、最大忠実度が複数ラック規模のメモリ要件を正当化する場合にのみ BF16 を選びましょう。
結論 Qwen3.8-Max は初期の API 提供以来の重要な境界を越えました。すなわち、Max クラスの Qwen ファミリーにおいて、組織が完全に自社インフラで運用可能な 2.4T のオープンチェックポイントが登場したことです。
しかし、オープンウェイトはコンシューマハードウェアを意味しません。4.45 TiB の BF16 フットプリント、2.27 TiB の FP8 チェックポイント、1.3~1.5 TiB の FP4 変種により、Qwen3.8-2.4T-A95B は入手可能なオープンモデルの中でも最もインフラ負荷が大きい部類に入ります。実用面の救いは、vLLM と SGLang が既にこのアーキテクチャをサポートしていること、そして FP4 により 1 ノードの 8× B300 または 8× MI355X デプロイが現実的になることです。
データ制御、持続的な稼働率、インフラ所有がクラスターを正当化する場合はセルフホストを。それ以外はマネージドの Max API を使用するか、「ワークステーション 1 台で強力な Qwen モデル」を望むなら Qwen3.8-27B を選びましょう。
Qwen 3.8 Max をローカルにデプロイする方法:ハードウェア、vLLM、SGLang、量子化に関するガイド - CometAPI