Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
無料で始める 無料で始める
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
guide / CometAPIリサーチ
Claude Fable 5.1 APIの使い方 CometAPI を通じて Claude Fable 5.1 を呼び出す方法、effort を設定する方法、ツールを使用する方法、破壊的変更への対処方法、移行方法を学ぶ
CometAPI を通じて Claude Fable 5.1 を呼び出す方法、effort を設定する方法、ツールを使用する方法、破壊的変更への対処方法、移行方法を学ぶ
この要約で素早く答えを把握し、ガイドで背景、例、実装詳細を確認してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)クイックサマリー: CometAPI で Claude Fable 5.1 API を使うには、API キーを用意し、モデル ID を claude-fable-5-1 に設定し、長いワークフローを組む前に小さなリクエストで検証してください。本ガイドは、アクセス、effort、ストリーミング、ツール、キャッシュ、移行、プロダクションチェックを扱います。デプロイは単なるモデル文字列の変更以上のものとして扱い、ルート互換性の確認、出力の検証、採択タスクの品質・レイテンシ・コストの測定を行ってから使用範囲を広げてください。
主要なポイント
まずは1件のリクエストを動かす: 認証情報、モデルアクセス、選択したエンドポイント、そして非機微のテストデータで有用なレスポンスを確認。
effort を意図的に選ぶ: まずは High から始め、代表的なタスクで他の設定を比較。すべてのリクエストで最大 effort を使わない。Claude Code はデフォルトが High。Claude Cowork / Claude.ai はデフォルトが Medium。
移行時の挙動を確認:
明確性、出典の帰属、最新のAPI用語について確認済みです。
ワークフロー全体を測定: キャッシュ使用、トークンコスト、レイテンシ、拒否、フォールバック挙動、最終結果が受入基準を満たすかを追跡。
Claude Fable 5.1 とは? Claude Fable 5.1 は、意欲的なコーディング、多段階のリサーチ、コンピュータ操作、文書集約型のプロフェッショナルワークフローに向けた、Anthropic の一般提供モデルの中で最高能力のモデルです。Anthropic は、多くのワークロードを Claude Opus 5 から始め、高 effort の Opus でも不足する場合に Fable 5.1 へ引き上げることを推奨しています。
違いは運用上のものです。Fable 5.1 は依存ステップをまたいで作業を継続し、ツール呼び出しの失敗から回復し、結果を検証し、長時間の実行中に進捗を報告するよう設計されています。これは完了率を改善し得ますが、同時にコスト、レイテンシ、可観測性がデプロイにおいて中心的な要素になります。
Claude Fable 5.1 API 仕様 プロバイダ Anthropic モデル ID claude-fable-5-1 リリース日 September 1, 2026 コンテキストウィンドウ 1,000,000 tokens 最大出力 128,000 tokens 入出力 テキストおよび画像→テキスト Thinking Adaptive, always on デフォルトの effort API は High、Claude Code はデフォルト High、Claude Cowork / Claude.ai はデフォルト Medium Effort レベル low, medium, high, xhigh, max ナレッジカットオフ June 2026 公式価格 $10 input / $50 output per million tokens キャッシュ読み取り $0.25 per million tokens
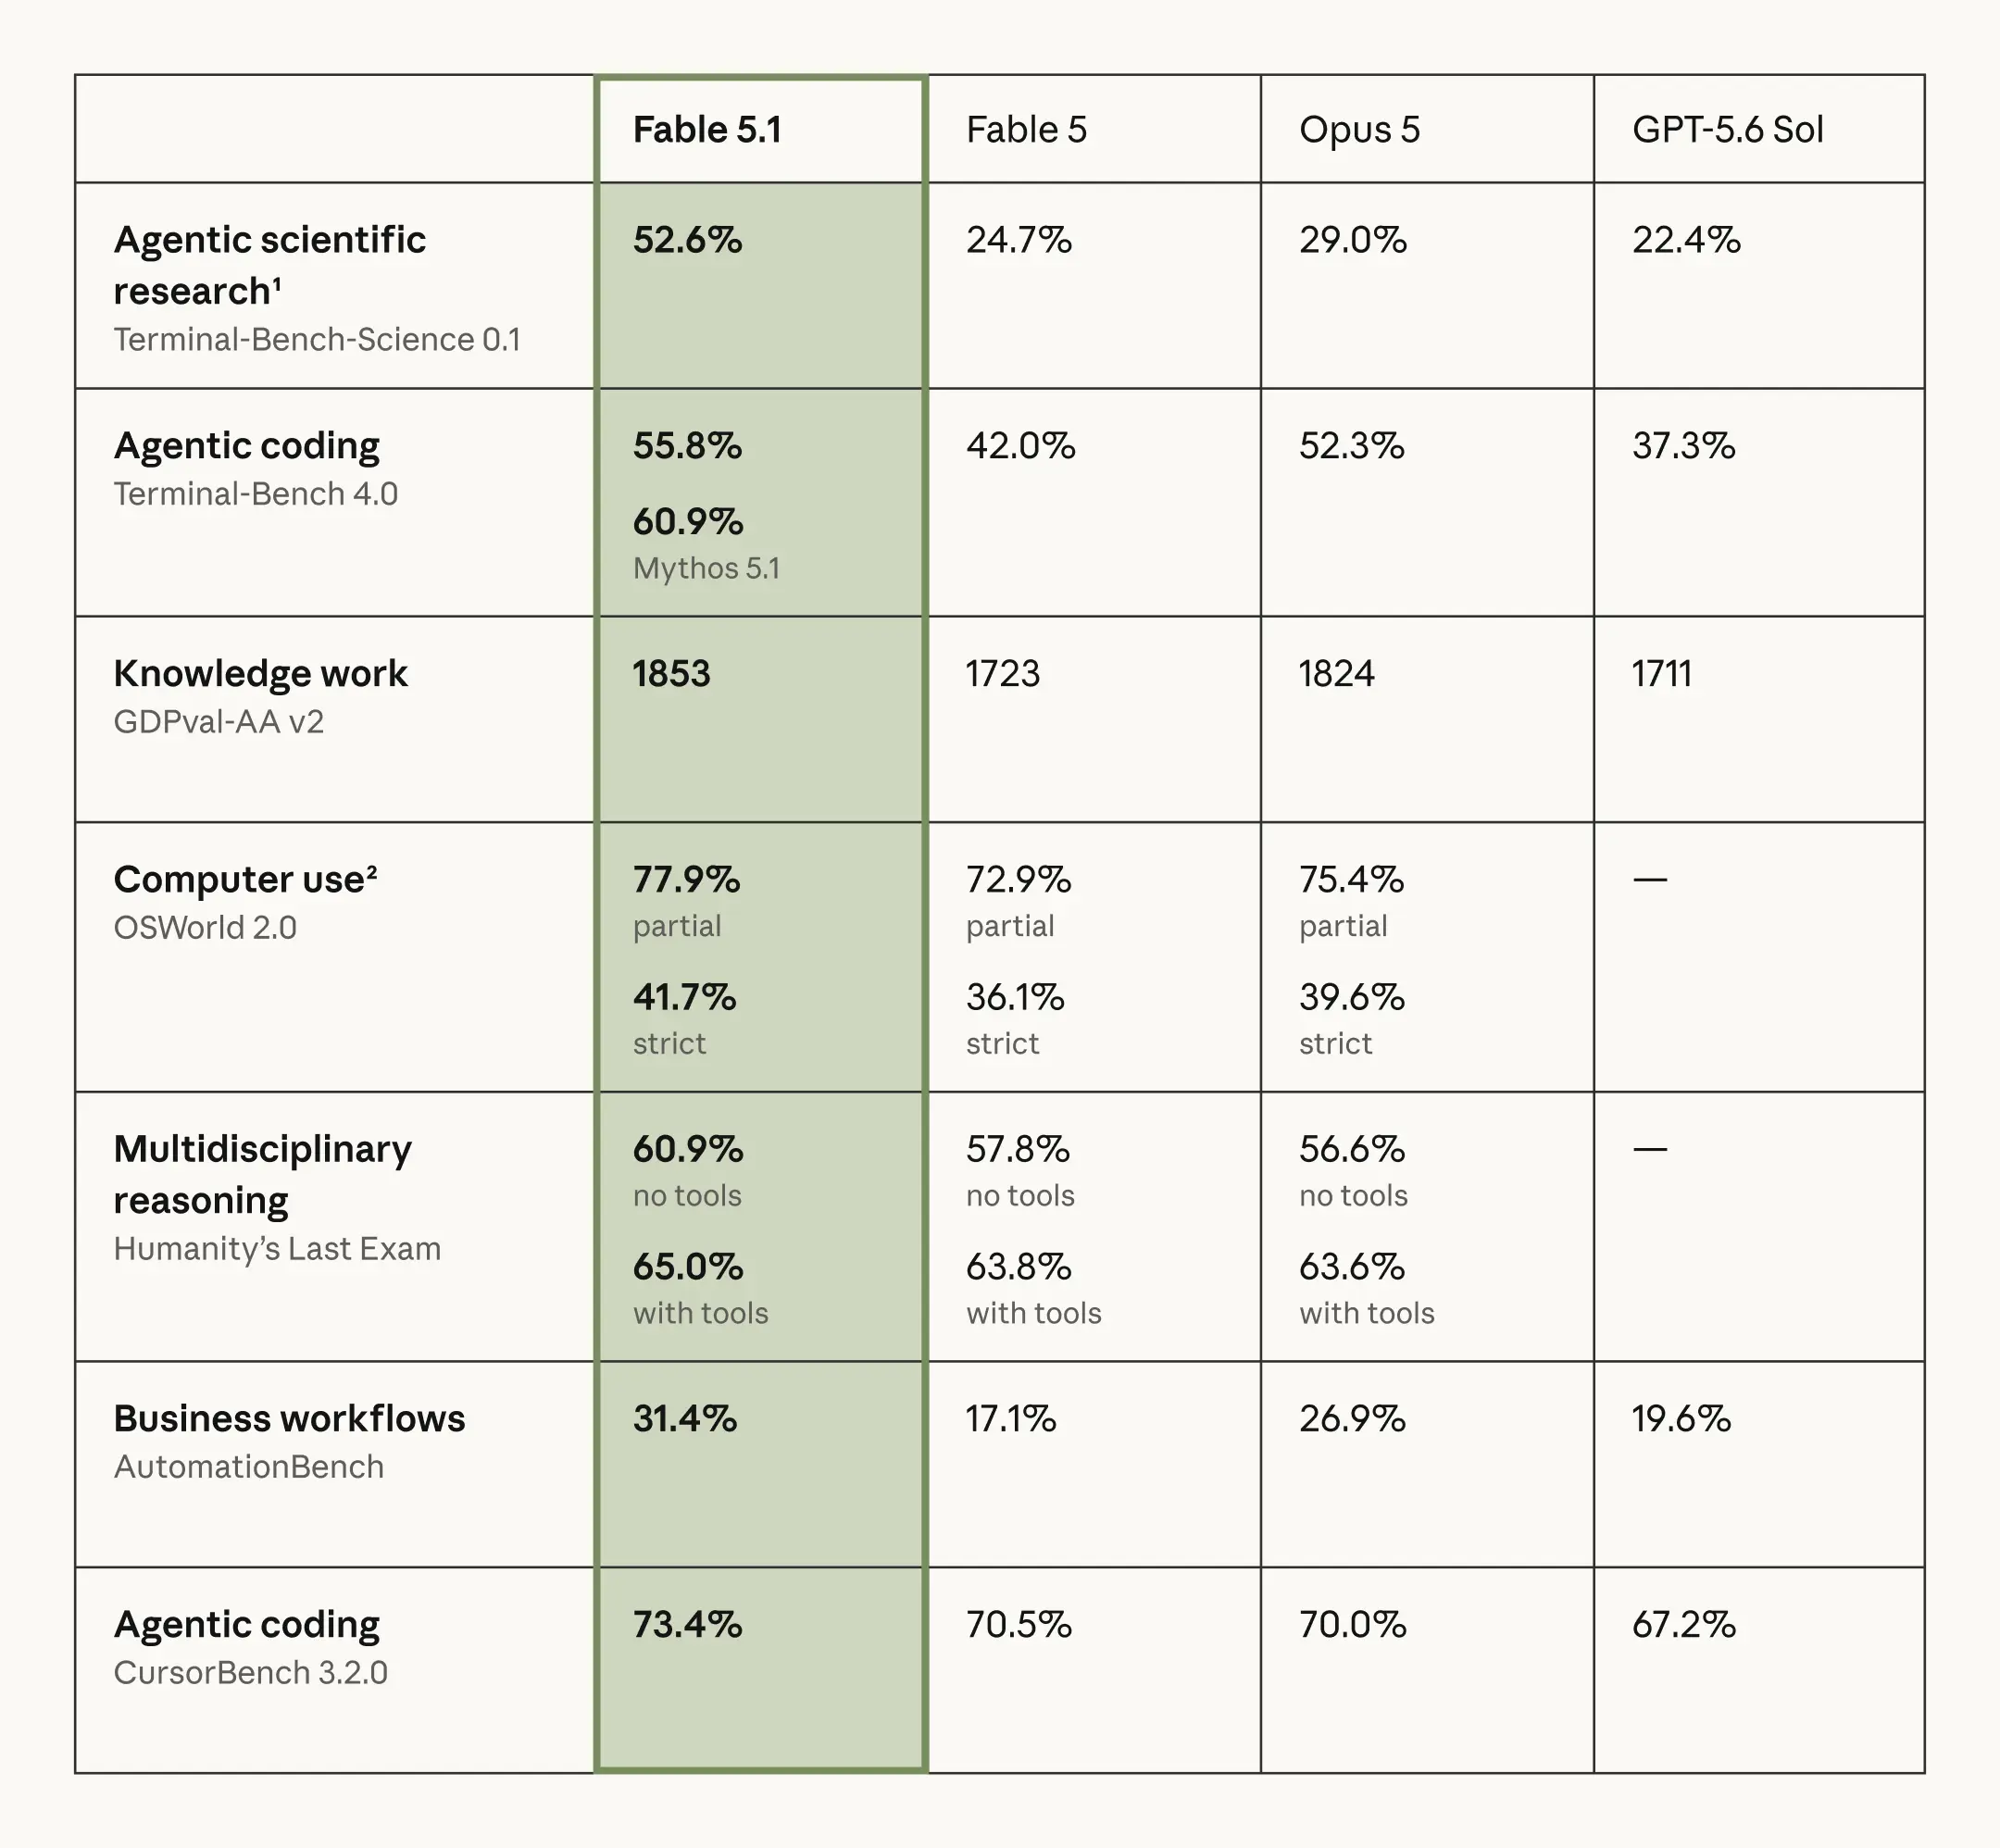
Claude Fable 5.1 API: 公式ベンチマーク性能 このベンチマリークサマリーは、記事の主目的が実装であるため、意図的に簡潔です。以下の結果は、API プレミアムが最も効く可能性が高い領域を示します。
Terminal-Bench-Science 0.1 52.6% 24.7% 29.0% 22.4% Terminal-Bench 4.0 55.8% 42.0% 52.3% 37.3% GDPval-AA v2 1,853 Elo 1,723 1,824 1,711 OSWorld 2.0, partial 77.9% 72.9% 75.4% — Humanity's Last Exam, no tools 60.9% 57.8% 56.6% — AutomationBench 31.4% 17.1% 26.9% 19.6% CursorBench 3.2.0 73.4% 70.5% 70.0% 67.2%
このセットで世代間の最大の伸びは Terminal-Bench-Science の 52.6% 対 24.7% です。AutomationBench は 17.1% から 31.4% に上昇し、Terminal-Bench 4.0 は 55.8% に改善しています。結果として、Fable 5.1 をリサーチエージェント、長時間のコーディング、業務の自動化でテストする強力な根拠となりますが、短いリクエストをすべて最も高価なモデルにルーティングすべきという話ではありません。
Claude Fable 5 API からの変更点は? コアの役割 長時間エージェントとリサーチの強化 最初の公開 Mythos クラスモデル 最難関ワークフローの再評価 強制ツール選択 エラーを返す 以前はサポート 強制と名前指定の強制を削除 Thinking の互換性 より厳格な互換ルール 以前の挙動 履歴は append-only を維持 進捗アップデート ツール呼び出し間の可読な更新 この形では未提供 長時間実行のステータスを公開 メッセージ単位の effort ベータで利用可能 この形では未提供 会話内で深さを調整 キャッシュ読み取り価格 $0.25 / MTok $1.00 / MTok 長文脈経済性の再計算 入出力価格 $10 / $50 per MTok $10 / $50 per MTok リストレートに変更なし
3 つのブレイキングチェンジ
強制的なツール使用はサポートされなくなった Claude Fable 5.1 は、任意または特定のツールを強制する tool_choice 値を拒否し、400 invalid-request エラーを返します。自動選択を維持し、厳密なスキーマや構造化出力で検証し、必須のワークフローステップはモデルのツール呼び出しを強制するのではなく、アプリケーションのオーケストレーションで実施してください。
以前のモデルは Fable 5.1 の Thinking ブロックを読めない Thinking の互換性は一方向です。Fable 5.1 は以前の互換 Claude モデルが作った thinking ブロックを消費できますが、以前のモデルは Fable 5.1 が作ったブロックを読めません。ルーターやフォールバックが以前のモデルに切り替えると、そのブロックは推論前に破棄される可能性があるため、モデル切り替えをログし、フォールバック挙動を明示的にテストしてください。
以前のターンを編集すると保存済み Thinking が無効化される 以前の system プロンプト、ツール定義、メッセージ、参照ファイルのバイトを変更すると、後続の thinking ブロックが無効になる可能性があります。会話のプレフィックスは append-only とし、履歴の書き換えではなく会話中の指示で対応し、移行中はプレフィックス不一致の変換を監視してください。
5 つの追加 API 機能
メッセージ単位の effort アプリケーションは会話中に effort を変更してもプロンプトキャッシュを無効化せずに済みます。このベータ機能により、ルーチンのフォローアップでは effort を下げ、難しい計画・デバッグ・検証のターンでは上げることができます。
ターンスコープのシステムメッセージ 1 ターンに適用され、その次のユーザーメッセージ後には表示されなくなるベータの system メッセージが利用できます。これはツールループ中の一時的な指示に有用で、プロンプトキャッシュの一致と後続の thinking ブロックの有効性の両方を保ちます。
ツール呼び出し間の可読な進捗アップデート ベータの progress-display オプションでは、選択された thinking ブロックに短いステータス更新を載せ、アプリケーションがユーザーに表示できます。長時間エージェントでは、これらの更新は最終回答ではなく運用上のステータスとして扱ってください。
低いキャッシュ読み取り価格 キャッシュ読み取りは 100 万トークンあたり $0.25 で、Fable 5 のキャッシュ読み取りレートの 4 分の 1 です。安定したキャッシュ可能プレフィックスを活用する長いセッションではコストを大きく削減できる可能性があります。
コンテンツの来歴 生成テキストには Anthropic の統計的ウォーターマークが付与され、Files API で取得する対応メディアには署名付き C2PA Content Credentials を含められます。これらの来歴機構はプロンプトトークンを増やさず、リクエスト形式の変更も不要です。
Claude Fable 5.1 API を使う前に必要なものは?
アカウントと API キー: CometAPI にサインインし、API キーコンソール でキーを生成。モデルアクセスと従量課金の準備ができているか確認してからテストコールを送信。
ローカル実行環境: 最初の HTTP 例ではターミナルと curl を使用。Python 例のためには、隔離環境で Python と pip を準備し、選んだ例が使う SDK をインストール。
選択したルート: CometAPI の Claude Fable 5.1 API は Messages と Chat Completions の形式を提供。対応するベース URL とリクエスト形式を使用し、両者のペイロードを混在させない。
セキュアな設定: COMETAPI_KEY をコミットされたソース外で設定し、モデル ID として claude-fable-5-1 を使用し、ネットワークが https://api.cometapi.com. に到達できることを確認。
安全なテストと受入チェック: 短く、機微でないプロンプトから開始。レスポンスに有用なコンテンツが含まれることを確認し、使用量や完了ステータスを確認、実文書やログを送る前に組織のデータ取扱要件を確認。
CometAPI は Claude Fable 5.1 を、Anthropic 互換の Messages ルートと OpenAI 互換の Chat Completions ルートで提供します。ネイティブの effort、thinking、キャッシング、Claude ツールセマンティクスが必要な場合は Messages を、アプリケーションがすでに OpenAI SDK に標準化している場合は Chat Completions を使用してください。
Step 1: API キーを保存する export COMETAPI_KEY="your-cometapi-key"
$env:COMETAPI_KEY="your-cometapi-key"
Step 2: 最初の Messages リクエストを送る curl https://api.cometapi.com/v1/messages \
--header "Authorization: Bearer $COMETAPI_KEY" \
--header "content-type: application/json" \
--data '{
"model": "claude-fable-5-1",
"max_tokens": 2048,
"messages": [{
"role": "user",
"content": "Review this deployment architecture and list the three highest-risk failure modes."
}]
}'
Step 3: Anthropic Python SDK を使う import os
import anthropic
client = anthropic.Anthropic(
api_key=os.environ["COMETAPI_KEY"],
base_url="https://api.cometapi.com",
)
response = client.messages.create(
model="claude-fable-5-1",
max_tokens=4096,
messages=[{
"role": "user",
"content": "Find the root cause of this test failure and propose a verified patch.",
}],
)
print(response.content[0].text)
Step 4: OpenAI Python SDK を使う import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["COMETAPI_KEY"],
base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
model="claude-fable-5-1",
messages=[{
"role": "user",
"content": "Design a migration plan for this service.",
}],
)
print(response.choices[0].message.content)
Claude Fable 5.1 API の推論はどのように機能しますか?
以前のモデルは Claude Fable 5.1 の Thinking ブロックを読めない Fable 5.1 が生成した thinking ブロックは、以前の Claude モデルとは後方互換ではありません。ワークフローが会話の途中でモデルを変更する場合、互換性のない thinking ブロックを削除するか、次のリクエストに必要なユーザー可視メッセージとツール結果のみを残して新しいブランチを開始してください。
以前のターンを編集すると保存済み Thinking が無効化される 保存された thinking ブロックは直前の会話状態に暗号学的に結び付けられています。以前の system プロンプト、ツール定義、ユーザーメッセージ、アシスタントの応答、ツールの結果を変更すると、この結合が壊れ、thinking 履歴エラーが発生する可能性があります。再生するプレフィックスはバイト単位で安定させ、古いターンを書き換えず新しいターンを追加してください。
複数ターンにまたがる保存済み Thinking 会話プレフィックスが不変の場合、保存された thinking は有用な推論状態を後続ターンに持ち越せます。thinking ブロックは元のメッセージ順で保存し、互換モデルにのみ再生し、履歴の編集は既存のトランスクリプトを変更するのではなく新しい会話ブランチとして扱ってください。
Effort で推論を制御する 難しい本番作業は High effort から始め、ルーチンのターンではより低い設定、受入タスク品質が十分に向上する場合にのみ xhigh や max を使用するようテストしてください。effort はターン間で変更できるため、1 つの会話が常に同じ推論レベルである必要はありません。
Fable 5.1 は adaptive thinking のみ を使用します。High effort から始め、ルーチン作業では低い設定を測定し、追加の能力がコストとレイテンシに見合う場合のみ xhigh または max を使ってください。
low ルーチンで明確に定義された作業 最速かつ最も経済的 medium バランスの取れた本番トラフィック 中程度の深さ high デフォルトの難易度の高い作業 ベストな出発点 xhigh 長時間のコーディングとエージェント レイテンシとトークンが増加 max 最高価値・最難関のタスク コストとレイテンシは二の次
response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=8192,
    output_config={"effort": "high"},
    messages=[{
        "role": "user",
        "content": "Audit this repository migration plan.",
    }],
)
Claude Fable 5.1 API: 長い応答をストリーミングし、ツールとプロンプトキャッシュを使用する 以下のコントロールを組み合わせて構成してください: 推論 effort、ストリーミング、ツール実行、プロンプトキャッシング、安全策と保持データの取り扱い。各要素が長時間リクエストの観測、検証、運用に影響します。
長い応答をストリーミングする ストリーミングは、長く高 effort のタスクではより安全なデフォルトです。大きな応答が完了するのを待たずに、アプリケーションが出力を受け取り始められるためです。
with client.messages.stream(
    model="claude-fable-5-1",
    max_tokens=8192,
    output_config={"effort": "high"},
    messages=[{
        "role": "user",
        "content": "Analyze these logs and produce a remediation plan.",
    }],
) as stream:
    for text in stream.text_stream:
        print(text, end="", flush=True)
強制ツール選択なしでツールを使う Fable 5.1 は、tool_choice の any や名前付きツールを強制する選択を拒否します 。自動選択を使用し、厳密なスキーマを使い、ツール引数はアプリケーションコードで検証し、必須のワークフロー順序はモデルの外で制御してください。特定のツールを必ず実行する必要があるワークフローでは、tool_choice に依拠して順序を強制しないでください。アプリケーション側でそのツールを呼び出すか、必要なステップをオーケストレーションコードで実装してください。
tools = [{
    "name": "search_incidents",
    "description": "Search recent production incidents",
    "input_schema": {
        "type": "object",
        "properties": {
            "service": {"type": "string"},
            "days": {"type": "integer"},
        },
        "required": ["service", "days"],
    },
}]

response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=4096,
    tools=tools,
    tool_choice={"type": "auto"},
    messages=[{
        "role": "user",
        "content": "Review checkout incidents from the last 30 days.",
    }],
)
長いコンテキストにプロンプトキャッシュを使う messages = [{
"role": "user",
"content": [
{
"type": "text",
"text": large_reference_document,
"cache_control": {"type": "ephemeral"},
},
{
"type": "text",
"text": "Identify obligations that changed in this revision.",
},
],
}]
安全策とデータ保持を扱う Anthropic によれば、多くのサイバーセキュリティや生物学関連でフラグされたリクエストは 能力の低いモデルへルーティングされる ことがあります。拒否やフォールバックはアプリケーションの状態として扱い、停止理由を記録し、適切なユーザーメッセージを表示し、ポリシーが許す場合は承認済みの代替へルーティングしてください。
また Fable は安全性監視のため デフォルトで 30 日のデータ保持 を要します。構文的に正しいリクエストのデバッグを単なる API 形式の問題として扱う前に、組織の適格性と保持設定を確認してください。
Fable 5.1 と Opus 5 と Sonnet 5 の比較 コンテキスト / 最大出力 1M / 128K 1M / 128K 1M / 128K 公式入出力価格 $10 / $50 $5 / $25 $2 / $10 相対レイテンシ 遅い 中程度 速い デフォルト effort high high high 主な強み 長期的課題での最大能力 プレミアムな一般推論 スピード/コストのバランス 最適な本番役割 能力引き上げ デフォルトの複雑作業 高ボリュームのベースライン
推奨結果: ルーチントラフィックは Sonnet 5 で開始し、複雑な一般作業は Opus 5 を用い、最も難しい、または繰り返し失敗するタスクにのみ Fable 5.1 を段階的に適用します。これは Anthropic のガイダンスに従い、プレミアム推論がすべてのリクエストに対するデフォルトコストになることを防ぎます。
Anthropic リスト価格 $10 $50 $0.25 CometAPI 掲載価格 $8 $40 ライブルートを確認 名目上の入出力差 20% 低い 20% 低い ルートにより変動
CometAPI のライブモデルページ が、現在のルート可用性と価格の情報源です。未キャッシュの入力 100,000 トークン、出力 10,000 トークンのリクエストでは、単純な CometAPI 見積りは $1.20 です。実コストは、キャッシング、推論、バッチ挙動、ルーティングにより変動し得ます。価格は変更される可能性があるため、プロダクション予算策定前にライブモデルページを確認してください。
Fable 5 からの移行チェックリスト
モデル ID を claude-fable-5 から claude-fable-5-1 に変更。
tool_choice の any と名前付きツール強制を削除し、auto を使用。
旧来の thinking 予算前提を output_config.effort に置き換え。
評価は High effort から開始し、実タスクでチューニング。
保存済み thinking ブロックを含む履歴は append-only を維持。
長い高 effort 実行に備えて max_tokens を増加。
使用状況メタデータでキャッシュヒットを検証。
拒否とフォールバックを明示的な状態として扱う。
本番トレースを再生し、採択タスク率、レイテンシ、コストを比較。
最も安全な移行戦略: 履歴を append-only に保つ。Fable 5.1 はターン間で thinking ブロックを保持できますが、再生される thinking ブロックは直前の会話状態に結び付けられています。以前の system、ツール、メッセージを変更するとこの結合が無効になる可能性があります。
よくある API エラー
ツール呼び出しの変更後に 400 エラー 考えられる原因: any または名前付きツールを強制する tool_choice。auto を使い、必須シーケンスはアプリケーションロジックで強制。
claude-fable-5.1 が動作しない 正しい ID はハイフン付きの claude-fable-5-1。
出力が想定より早く終わる effort controls how much reasoning the model performs, while max_tokens limits the response token budget. Higher effort can require more output budget, so production applications should tune both independently. Raise max_tokens where justified and stream long responses.
プロンプトキャッシュがヒットしない キャッシュ対象のプレフィックスをバイト単位で安定させる。タイムスタンプ、ツールの並び替え、system メッセージの変更は再利用を阻害。
HTTP 成功だが通常の回答がない stop_reason とフォールバックのメタデータを確認。すべての拒否をトランスポートエラーとみなさない。
履歴の再生で thinking エラーが出る 保存済み Fable 5.1 thinking ブロックの前にあるターンを編集しない。append-only の履歴か、現行の移行コントロールを使用。
Claude Fable 5.1 API を本番でどう使うべきか? リクエストルーティング、モデル実行、ツール実行、検証、評価を分離してください。モデル ID、effort、レイテンシ、トークン使用量、キャッシュ使用、停止理由、フォールバック挙動、最終タスク成功をログします。
Fable 5.1 は、リポジトリ全体の移行、難しいデバッグ、長時間エージェント、深いリサーチ、大規模文書の統合、高付加価値タスクで、安価なモデルが繰り返し失敗する場合に使用してください。要約、分類、抽出、短いカスタマーサービス応答のデフォルトとしては避けましょう。
例: チェックアウト障害の調査 チームはサニタイズされたチェックアウトエラー、直近のデプロイ差分、関連ランブックを提供します。アプリケーションは一致するインシデント記録を取得し、モデルに可能性のある原因を順位付けし、各仮説を証拠に結び付けるよう求めます。エンジニアは提案された診断手順をレビューし、合成トランザクションを用いたサンドボックスでのテストを承認します。受入ゲートは、再現可能な挙動、追跡可能な証拠、回帰チェックの合格です。あらゆる本番修復には別途人間の承認が必要です。
例: 運用要件の変更点を分析 チームは承認済み運用マニュアル、支援ポリシー、改訂版ドラフトを提供します。変更されていない参照資料は安定したコンテキストとして保持し、モデルに変更された義務、責任チーム、期限、例外を比較させます。各提案された所見は、両バージョンの該当箇所を参照し、明示的な変更と不確実な解釈を区別する必要があります。受入ゲートは、レビュアーが報告された各変更を引用証拠と突き合わせて確認し、手順更新や関係チームへの通知を行うことです。
結論 Claude Fable 5.1 は単なるモデル文字列の置き換えではありません。強制ツール挙動、thinking 履歴ルール、effort コントロール、キャッシュの経済性、長時間の進捗機能により、移行は慎重さを要します。