
TL;DR
2026年10月9日時点の報道では、Kimi K3.1 が今月登場する可能性が示唆されていますが、確認した情報源はいずれも公式なローンチ日、最終的な価格、または K3.1 固有のベンチマーク結果を示していません。報告されている Low / High / Max、Extra Long、Agent、Swarm の各フラグは既存の K3 機能と重なっています。意味のあるアップグレードといえるには、推論効率、長文コンテキストの信頼性、完了タスクあたりのコストが改善される必要があり、設定ラベルだけではその向上は示せません。
Key Takeaways
- リリース時期: 10月はメディア報道による可能性であり、引用元はいずれも公式なローンチ確約を示していません。
- 技術的手がかり: Low / High / Max と報告された 1M トークンのオプションは K3 の機能と重複しており、K3.1 のアーキテクチャや最終的な上限は未確認です。
- エージェントワークフロー: Agent、Swarm、search、batch の各フラグは、計測済みの改善というより統合作業の可能性を示唆します。
- 性能と価格: 公開されている K3 の結果と料金は参照用の基準であり、K3.1 のベンチマークや料金表ではありません。
- API 準備状況: CometAPI 経由で K3.1 を導入する前に、有効なモデル ID、ドキュメント化されたパラメータ、アカウントアクセスを確認してください。
What is Kimi K3.1?
Kimi K3.1 は、Moonshot AI の Kimi モデルファミリーの次期バージョンと報じられています。流出した設定識別子は、推論、長文コンテキスト、エージェントワークフローに関する取り組みを示唆します。最終仕様、リリース日、価格は確認した情報源では確立されておらず、公開が確定したモデルではなく候補として扱うべきです。
What Do We Know About Kimi K3.1?
元の投稿に K3.1 関連の識別子が示されている
2026年9月23日、@MaxForAI が設定スクリーンショットを投稿し、k3d1-agent を示しました。これは投稿に紐づく元の画像であり、その内部的な出所やプロダクション段階の状況は独立に認証されていません。
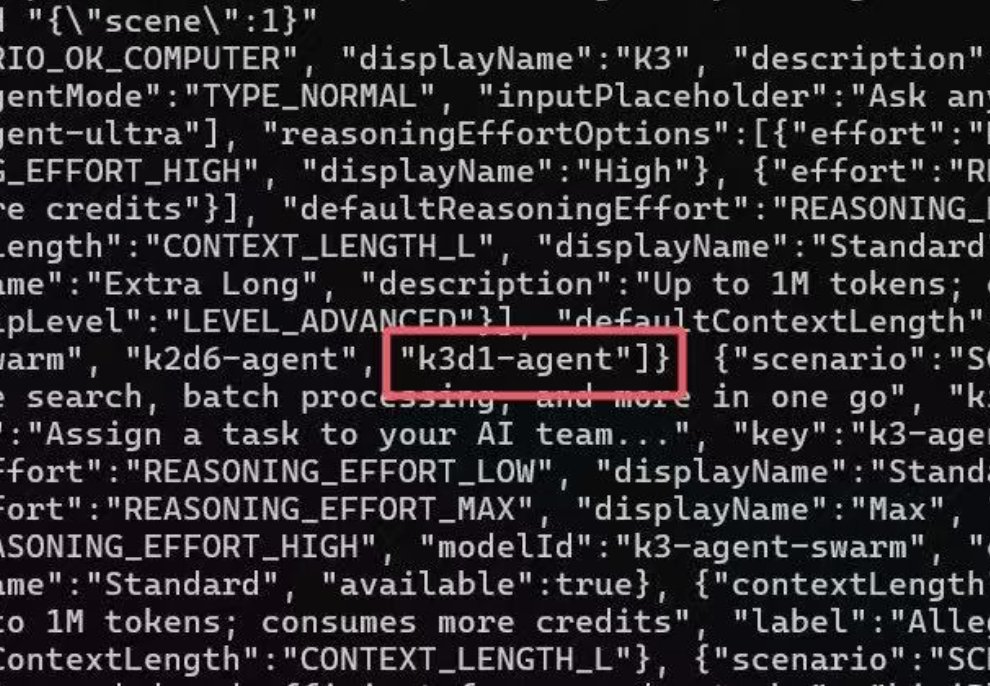
画像出典: @MaxForAI の元投稿。画像には、推論の努力度とコンテキスト設定に加えてエージェント識別子が含まれています。見えている設定文字列は、すべてのオプションが K3.1 に属することを証明するものではありません。
Wccftech の 9月23日レポートは、このスクリーンショットを K3.1 開発のシグナルとして解釈しています。IT Home の 9月24日のフォローアップは、報告されたオプションを繰り返しています。これらは同一のリークに対する二次的解釈であり、ローンチ準備の独立した確認ではありません。
報告されたオプションは推論とエージェントワークフローを示唆
報道は、Low / High / Max の推論設定、最大 1M トークンの Extra Long オプション、そして Agent、Swarm、search、batch フラグを記述しています。これらはワークフロー統合の可能性を示しますが、最終的なアーキテクチャ、検証済みの性能向上、または公開 API スキーマの公開を示すものではありません。
メディア報道でローンチ時期に差異がある
Wccftech は 10月前の到来の可能性を述べ、IT Home は 2026年10月としています。この不一致は、いずれの予測の有用性も限定します。どちらの報告も、日付入りの Moonshot によるリリース告知を提示していません。
モデル識別子は、非公開のチェックポイント、未完成の経路、段階的なデプロイ、またはアクセス制御付きプレビューを表す場合があります。単独では商用 API リリースを確立できません。流出したフラグの厳密な意味や可用性は依然不確かです。
When Will Kimi K3.1 Be Released?
検討した情報源はいずれも、Kimi K3.1 の公式なリリース日を確立していません。IT Home は 2026年10月、Wccftech の先行報道は 10月前としています。これは相違するメディア予測であり、検証済みの開発スケジュールではありません。スクリーンショットだけでは、ロールアウト日、アカウント適格性、デプロイ準備性は確立できません。
ローンチを確定扱いする前に、日付入りの Moonshot の告知、サポートされるモデル ID、開発者ドキュメント、アクセス条件を確認してください。価格と再現可能な K3.1 固有の評価は、導入判断に必要な別個の証拠です。
What Specifications Could Kimi K3.1 Offer?
最も強い技術的な基準は既存の Kimi K3 です。これは 2026年7月リリースで、2.8 兆パラメータのスパース MoE アーキテクチャ、ネイティブな視覚入力、そして一般に 1M トークンとされるコンテキストウィンドウを備えています。引用された情報源は、K3.1 のアーキテクチャ、パラメータ数、モデル固有の評価結果を確立していません。
Moonshot の公式モデルサマリーは有効パラメータ 104B と 1,048,576 トークンのコンテキストウィンドウを明記しています。7月27日のオープンウェイト告知は K3 のウェイト公開を確認しています。これらの仕様は K3 に適用され、噂の K3.1 には適用されません。
| Specification | Kimi K3 | Kimi K3.1 |
|---|---|---|
| Release | July 2026 | Potentially October 2026 |
| Total parameters | 2.8 trillion | Not disclosed |
| Activated parameters | 104 billion (official model summary) | Not disclosed |
| Architecture | Sparse MoE, KDA, AttnRes | Not disclosed |
| Context | 1,048,576 tokens (approximately 1M) | Up to 1M suggested |
| Reasoning | Low / High / Max in current Kimi Code documentation | Low / High / Max flags |
| Vision | Native visual input | Not confirmed |
| Swarm | Existing Kimi Swarm capability | Swarm flag reportedly appears |
| API price | Published K3 tariff | No final pricing |
| Weights | K3 weights released | Unknown |
What Features Are Reported for Kimi K3.1?
以下の 3 テーマは、報告された K3.1 の手がかりとドキュメント化された K3 の機能を組み合わせたものです。噂される K3.1 の機能を確定仕様として提示することなく、設定が何を意味し得るかを説明します。
三段階の推論レベルは努力度のトレードオフを提供
Low、High、Max は K3.1 の設定ラベルとして報告されています。これは努力度のトレードオフを表し、新しいアーキテクチャを意味するものではありません。現行の Kimi Code ドキュメントは K3 に対して low / high / max をサポートし、デフォルトは highです。これは Kimi Code の設定であり、あらゆる API や製品でデフォルトや付与が同一だと仮定すべきではありません。
Low は抽出、単純な Q&A、一般的な分類など、低レイテンシーが重視される場面に適している可能性があります。High はマルチステップの開発やドキュメント作業で実用的なバランスを提供する可能性があります。Max は難易度の高いコーディングやリサーチにより多くの推論予算を割り当て、レイテンシー増やコスト増の可能性があります。これらのタスク割り当ては検証すべき解釈であり、K3.1 の保証ではありません。
これらのワークロード例は分析的な解釈であり、K3.1 サービスの保証ではありません。開発者は、支出単位あたりの品質を比較すべきです。高努力の実行は試行あたりのコストが高くなる可能性がありますが、再試行が減れば全体のワークフローコストは下がるかもしれません。意味のあるアップグレードとは、同等のトークンおよびツール予算でタスク成功率が向上することです。
1M トークンのオプションは長文コンテキストの基準を拡張
100万トークンのウィンドウは、大規模なコードリポジトリ、長大な技術文書、プロジェクト履歴、広範なツールトレースを収容できます。しかし、最大コンテキスト長は、遠方の情報を正確に活用できることと同義ではありません。実用的なモデルは、正しい事実を取り出し、文書間の整合性を維持し、プリフィル遅延を管理可能に保つ必要があります。
長文コンテキストは、プロンプト内の位置によるリトリーバル、文書間の整合性、最初のトークンまでの時間で評価してください。また、キャッシュ再利用、およびエージェント履歴の保持や圧縮のコストも測定してください。名目上の 1M トークン上限は、モデルが許容可能な遅延と予算内で遠方の証拠を正確に回収できる場合にのみ有用です。
Moonshot はコンテキスト管理なし・1M トークンコンテキストでの K3 の BrowseComp スコア 90.4を報告しています。これは特定の K3 評価条件であり、圧縮コンテキストの結果や K3.1 の性能主張とは別物です。
Agent と Swarm のフラグは協調的なタスク実行を示唆
エージェント関連の識別子や Swarm のフラグは、コンテキスト数値よりも重要である可能性があります。Kimi はすでにマルチエージェントの作業をサポートしています。したがって、噂されるアップグレードは、Swarm ラベルの追加ではなく、ルーティング、委任、結果集約、コスト管理の改善が必要です。
あり得るオーケストレーションされたワークフローでは、コーディネータが複雑な要求をリサーチ、コーディング、テスト、統合のサブタスクに分割します。特化したワーカーが並列で実行し、証拠を返し、コーディネータが統合します。この並列化は経過時間を短縮し得ますが、モデル呼び出し総数は増えるため、壁時計時間とコストは別々に報告する必要があります。
Kimi の公式 Agent Swarm ドキュメントは既存の並列エージェント実行を説明しています。以下の例は、そのようなオーケストレーションがどのように作業を分割し得るかを示すものであり、K3.1 の最終構成や必須の Swarm トポロジを確立するものではありません。
リサーチワーカーは情報源を収集し引用を検証できます。コーディングワーカーはモジュールを修正し実行証拠を返せます。分析ワーカーは再現可能な計算で代替案を比較できます。コーディネータはタスクを割り当て、意見の不一致を調停し、予算を制限します。各ワーカーの出力は、結合結果を受け入れる前に検証が必要です。
K3.1 については、再現可能なエンドツーエンドのエージェントタスクのベンチマーク、障害回復、エージェント間の不一致処理、ツール呼び出し数、総支出を確認すべきです。設定フラグだけでは改善は確立できません。
How Does Kimi K3.1 Compare with K3 on Benchmarks?
K3.1 固有の検証済みベンチマーク表は入手できていません。以下の数値は Moonshot の公式 K3 評価からのもので、比較の基準としてのみ示します。モデルハーネスや評価設定が異なるため、厳密な同条件比較は限定されます。
| Benchmark | Kimi K3 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| DeepSWE | 67.5 | 73.0 | 70.0 |
| Terminal-Bench 2.1 | 88.3 | 88.8 | 88.0 |
| FrontierSWE | 81.2 | 71.3 | 86.6 |
| Program Bench | 77.8 | 77.6 | 76.8 |
| Kimi Code Bench 2.0 | 72.9 | 64.8 | 76.9 |
| SWE Marathon | 42.0 | 39.0 | 35.0 |
出典の不一致: 元のビジュアルでは Fable 5 は Terminal-Bench 2.1 で 84.6 と表示されますが、公式リポジトリの評価表は 88.0 を報告しています。上の表はリポジトリに従い、公式画像は改変せずに引用されています。
評価ノートは、K3 の max effort、temperature 1.0、top-p 1.0 を指定しています。DeepSWE v1.1 はここでは Kimi Code を用いており、別途引用の mini-SWE-agent の結果は 67.3 です。Terminal-Bench は K3 に Kimi Code、Fable 5 に Terminus 2、Sol に Codex を使用。FrontierSWE は K3 に Kimi Code/Codex を用い、7月16日の優位スコア。ProgramBench は K3 に Kimi Code を使用。KCB 2.0 は K3 に Kimi Code/Claude Code、Fable/Sol に Claude Code/Codex を使用。SWE Marathon は H20 調整の v1.1 ブランチで Claude Code/Codex を使用し、Fable は 35% のタスクでフォールバックに遭遇しました。これらはベンダー報告の結果であり、ハーネスが異なります。
各ベンチマークの完全なプロトコルは公式評価ノートを参照してください。これらの数値は、制御された K3.1 比較を確立するものではありません。
このセットでは、K3 は Program Bench と SWE Marathon で特に競争力がありますが、比較のリーダーはテストによって異なります。K3.1 が高速または高精度と断言するには、ドキュメント化されたエージェントハーネス、推論予算、評価日を伴うテストの公開が必要です。
What Could Kimi K3.1 API Pricing Look Like?
K3 の公式ローンチ時の料金は、キャッシュ済み入力 100万トークンあたり $0.30、未キャッシュ入力 $3、出力 $15 です。以下の表は、その参照スケジュールを記録したものであり、現在の K3.1 料金を検証したものではありません。K3.1 の料金およびオーケストレーションの課金は別途確認が必要です。
| Meter | Kimi K3 API in CometAPI (official launch tariff reference) | Kimi K3.1 API in CometAPI (unconfirmed tariff) |
|---|---|---|
| Cached input | US$0.30 / 1M tokens | Unconfirmed |
| Uncached input | US$3.00 / 1M tokens | Unconfirmed |
| Output | US$15.00 / 1M tokens | Unconfirmed |
| Agent orchestration | Depends on actual usage | Unconfirmed |
これらの K3 参照料金では、未キャッシュ入力 100,000 トークンと出力 10,000 トークンで US$0.45 となります。これは K3 の算術例であり、K3.1 の価格ではありません。エンタープライズの計画では、トークンだけでなく検証済みタスクあたりのコストを用いてください。
How Can Developers Prepare for Kimi K3.1 API Access?
アクセス確認は統合に先行
開発者は Kimi K3.1 API in CometAPI をフォローしてアクセス更新を確認できます。2026年10月9日時点で、このページの availability セクションは Coming Soon のままで、汎用的なエンドポイントとヘルスの文言が並んでいます。この一貫性に欠けるページは探索リンクとして扱い、有効なモデル ID とアカウントレベルのテスト成功を確認してから、本番アクセスを前提にしてください。
ローンチチェックリストは導入判断を支援
| Question | Evidence available now | Confirmation needed |
|---|---|---|
| Release? | September leak reports | Moonshot release announcement |
| New architecture? | No K3.1 model card | Technical report and parameters |
| Better reasoning? | Three familiar effort modes | Quality/cost vs K3 at each level |
| Better long context? | Reported 1M option | Accuracy and latency at 1M |
| Better multi-agent? | Agent/Swarm configuration flags | Agent success and cost benchmarks |
| API production access? | Coming Soon indicator | Supported IDs, docs, pricing |
準備はポータブルな評価と上限付きのテスト予算から始められます。移行は、文書化されたアクセスと再現可能なワークロードレベルの改善が確認されてからにしてください。重要なのは、カタログページや設定フラグの有無ではなく、K3.1 が受け入れ可能な結果をより確実かつ経済的に生み出せるかどうかです。
FAQs
開発者は Kimi K3.1 へのアクセスをどう検証できますか?
プロバイダーのサポートするモデル ID とアカウントの付与を確認し、小さなリクエストを実行して返却されたモデル識別子、usage、エラーを検査してください。成功した呼び出しは、そのアカウントと経路における当時点のアクセスを検証します。カタログエントリや health ラベルだけでは、公開ローンチや安定クォータは確立できません。
Kimi K3.1 は既存のエージェントで K3 の代替になりますか?
移行は互換性変更として扱ってください。ツールのスキーマ、推論履歴の取り扱い、出力形式、タイムアウト動作を確認し、代表的タスクをリプレイする前にチェックしましょう。固定したベースラインを用い、ロールバック経路を保持してください。似たモデル名やコンテキスト上限だけでは、長時間のセッションが同一に振る舞う証拠にはなりません。
チームは Kimi K3.1 のパイロット予算をどう組むべきですか?
噂のトークン価格を外挿するのではなく、上限付きのタスクセットから始めましょう。未キャッシュ入力、キャッシュヒット、推論/出力トークン、ツール呼び出し、再試行、人的修正時間を追跡してください。固定の評価予算を確保し、最終料金が文書化された後に、受け入れ結果あたりのコストを比較してください。
何が意味のある Kimi K3.1 のアップグレードといえますか?
同等の推論およびツール予算で、ワークロードにおける再現可能な改善を要求してください。遠方証拠の取得、矛盾する文書、エージェントの回復、エンドツーエンドのタスク受理をテストします。失敗率、レイテンシー、総支出を一緒に記録してください。名目上のウィンドウ拡大や追加設定フラグだけでは不十分です。
Conclusion
Kimi K3.1 は、報じられた将来の公開候補として扱うのが適切です。確認した証拠は、設定上の取り組みの可能性を示す一方で、K3 はすでに長文コンテキスト、可変の努力度、Swarm 実行を提供しています。実用的な機会は、持続可能なコストでのタスク品質の向上です。公式仕様、アクセス条件、価格、再現可能な K3.1 の結果が揃ってから移行判断を行えるよう、いまはポータブルな評価を準備してください。