SolutionsChoose your path
For individualsBuild, learn, and create with simple usage-based access. For businessScale teams, billing, governance, and model workflows. new/CometAPIリサーチ
Tencent Hyra 2.0: ハーネスのアーキテクチャ、ベンチマークと結果
Tencent Hunyuan Hyra 2.0、その三層構造のエージェントHarness、科学モデル、ベンチマーク、研究上のブレークスルー、そしてHyra 1.0との差異を探る。

Deon GoodwinAIモデルとAPIの調査チーム from openai import OpenAI
client = OpenAI(
api_key="YOUR_COMETAPI_KEY",
base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
model="gpt-5-mini",
messages=[{"role": "user", "content": "Build this workflow."}],
)
print(response.choices[0].message.content)
TL;DR
Tencent Hunyuan は 2026 年 11 月 2 日に Hyra 2.0 を発表しました。これは科学モデル、ソフトウェアツール、再利用可能なワークフローを開発するための研究用ハーネスです。最大の特徴は、複数日〜数週間にわたる実験における持続的な協調です。
現時点の公開内容は、一般提供のホスト型 Hyra 2.0 サービスではなく、選抜された研究成果物(モデル、コード、重み、レポート)です。2026 年 11 月 4 日時点で、Tencent の公開資料には汎用のオーケストレーション API やサブスクリプションプランの記載はありません。
Key Takeaways
- 研究目的: Hyra 2.0 は、複数の研究プロジェクトをまたいで活用できる再利用型の科学モデルとツールを開発する。
- 持続的な協調: Overall、Mission、Worker の各エージェントが役割を分担し、キューと研究記録が長期間の実験における進捗を保持する。
- 再利用可能な知識: エージェントメモリ、Books、研究スキルが、知見を根拠と利用条件とともに保持する。
- タスク特化の成果: 公開されたタンパク質・力場・細胞モデルは異なる科学的ワークロードに対応する。速度と品質は併せて評価すべき。
- 実用的なアクセス: 利用可能な研究成果物から始める。完全な Hyra ハーネスとホスト型 Hunyuan モデル API は別提供である。
What Is Tencent Hunyuan Hyra 2.0?
は Hunyuan Research Agent 2.0 の略であり、複雑な科学研究とエンジニアリングのワークフローを自動化するために設計されたマルチエージェントシステムです。
明確性、出典の帰属、最新のAPI用語について確認済みです。
Tencent は Hyra 2.0 を、個別の問題を解く段階から、より広い問いを探究するために用いられるモデル・手法・インフラの開発へと転換するものとして提示しています。
Hyra 2.0 は、固定のパラメータ数やコンテキスト長を持つ単体の基盤モデルではありません。さまざまな AI モデルを利用し、コードを実行し、科学実験を管理し、特化した研究エージェントを調整するオーケストレーションシステムです。
科学研究は推論だけでは完結しません。完全なプロジェクトには、実験設計、実装、学習、デバッグ、評価、反復的な改訂が必要となります。これらの活動はしばしば数日〜数週間に及び、並列実験や共有計算資源を伴います。
Hyra 2.0 は、モデルの知性に持続的な実行、構造化された協働、証拠に基づく検証を組み合わせることで、この運用上の課題に対処します。
Hyra 2.0 Technical Specifications
|
| Developer | Tencent Hunyuan |
| Public announcement | November 2, 2026 |
| System category | 自律型科学研究エージェント |
| Core architecture | 階層型マルチエージェント・ハーネス |
| Agent roles | Overall, Mission, Worker |
| Research execution | 長時間稼働・並行ワークフロー |
| Task management | 永続タスクキュー |
| Collaboration | Research Board とエージェント間メッセージング |
| Verification | 証拠に裏付けられた成果と独立した Review Worker |
| Memory | プロジェクト状態、階層化エージェントメモリ、共有 Books |
| Knowledge reuse | 検証済みの知見と再利用可能なスキル |
| Model flexibility | 異なる Worker が異なる基盤モデルを利用可能 |
| Research environments | WeCom、計算プラットフォーム、コードリポジトリ |
| Human oversight | 重要な操作に対する承認チェックポイント |
| Public artifacts | 選抜モデル、ソースコード、学習済み重み、技術レポート |
この仕様は、Hyra 2.0 のオーケストレーションと研究遂行の能力を記述しています。Hyra 2.0 によって作成される個々の科学モデルは、それぞれ別個のアーキテクチャ、パラメータ規模、性能ベンチマークを持ちます。
Hyra 1.0 から Hyra 2.0 への移行は、自動化された研究の根本的な制約に対処するものです。すなわち、1 つの問題をうまく解いても、次の問題を解く能力が必ずしも向上するわけではないという点です。
Hyra 1.0 は比較的単純なエージェントループで解を生成し、評価を実行し、反復によって成果を改善しました。Tencent のオープンソースモデル Hy3 を用いて、Hyra 1.0 は和集合と差集合の関係における最適指数の決定に寄与し、その結果とともに機械検証済みの証明が公開されました。この区別は重要です。評価済みの数学的結果は具体的な出力ですが、研究プロセスの改善は後続の問題にも再利用できます。
From Answers to Reusable Capabilities
- エージェントが個々の数学問題を解く。
- 類似問題を解ける証明ワークフローをエージェントが開発する。
- 将来の研究システムで用いる推論モデルと検証ツールをエージェントが改良する。
第 1 は解答を生みます。第 2 は再利用可能な方法を生みます。第 3 は基盤的な研究能力そのものを向上させ得ます。
Hyra 2.0 は第 2 と第 3 の段階を目標とします。
Tencent は再利用可能なツールを大きく 2 種類に分類しています。Symbolic tools は、コード、アルゴリズム、規則、ワークフローによって能力を表現します。自動検証システム、科学探索アルゴリズム、実験管理パイプラインなどが例です。Parametric tools は、学習済みの能力をモデル重みに格納します。タンパク質設計モデルや科学基盤モデルが該当します。
いずれかを改善すれば、すべての研究プロジェクトが同じ出発点から始める必要なく、下流の複数タスクに利益をもたらし得ます。
The Direction Toward Recursive Self-Improvement
Hyra 2.0 は、再帰的自己改善への道筋も形作ります。基盤モデル研究は、学習基盤、合成データパイプライン、最適化アルゴリズム、推論システムに依存します。
もし AI エージェントがこれらのツールを改良できるなら、より強力なモデルの開発に寄与できます。より強力なモデルは、その後のツール開発のラウンドに参加できます。
優れた研究ツール → より強力な AI モデル → より有能な研究エージェント → さらに優れた研究ツール。
Tencent は、事前学習インフラ、学習後のデータ生成、推論最適化への Hyra の適用を述べています。これはツール開発とモデル開発の間にもっともらしいフィードバックループを形成します。ただし、それ自体で無制限または完全自律的な自己改善を確立するわけではありません。提案された各利得は、その効果を分離できる実験をなお必要とします。
How Does the Hyra 2.0 Harness Architecture Work?
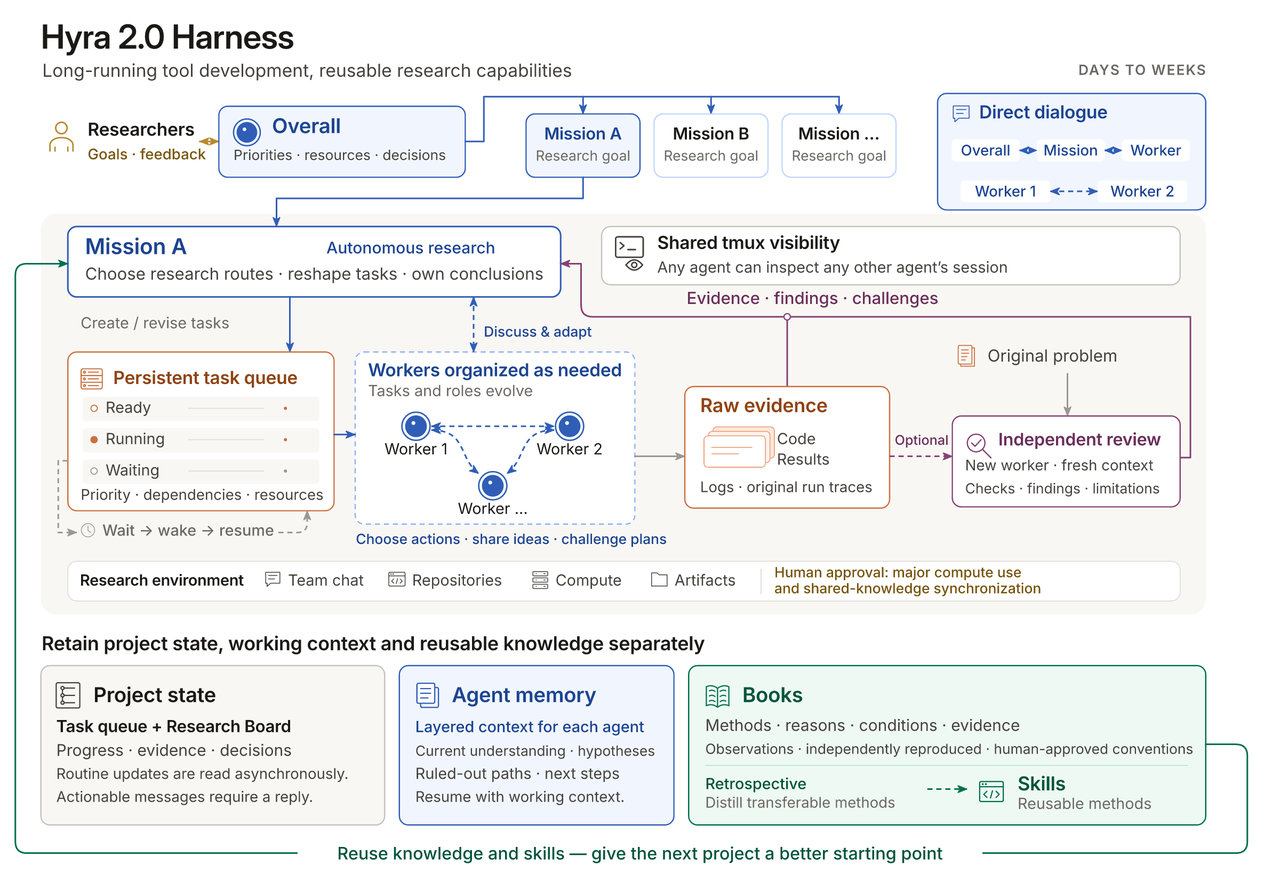
Hyra 2.0 の中核的なエンジニアリング革新は、Harness です。従来のエージェントループは、ツールの実行、結果の検査、セッション内での継続的推論を行えますが、科学モデル開発にはより高度な実行環境が必要です。
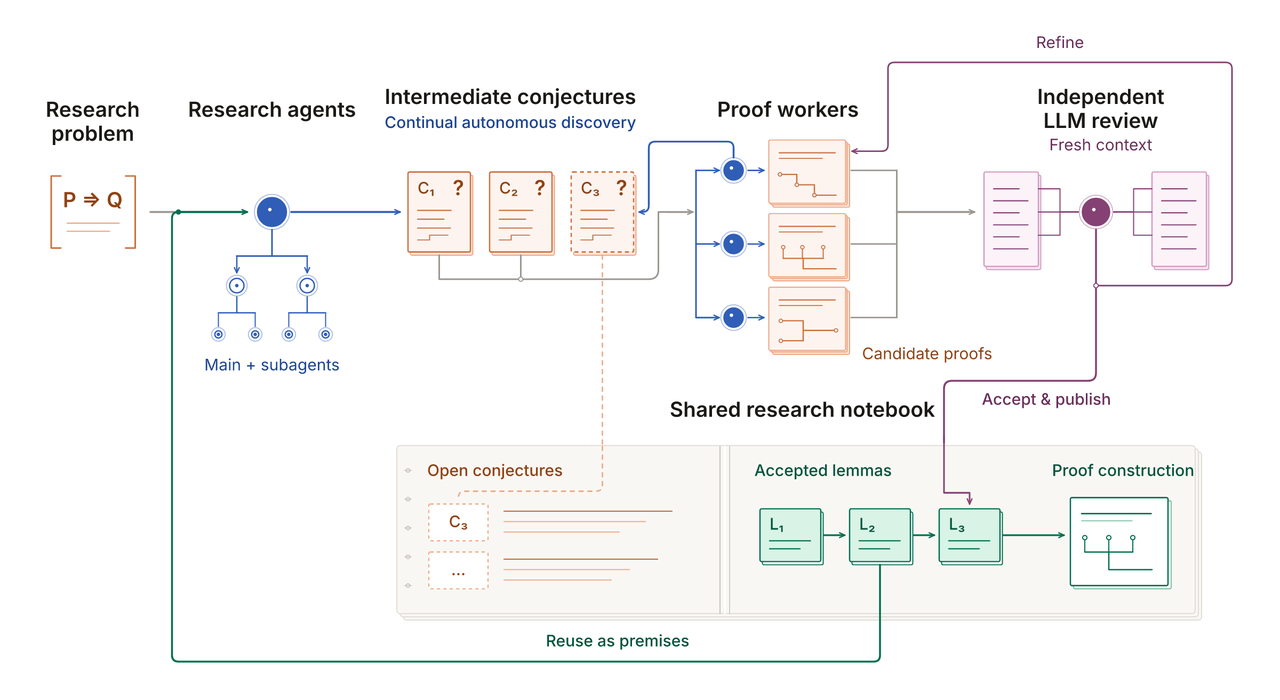
実験は数時間に及び、学習ジョブは数日かかり、研究方向ごとに異なる計算資源と検証方法が必要になることがあります。Hyra 2.0 は、3 層のエージェント、永続的なタスクスケジューリング、構造化された研究記録、独立検証を通じて、これらの要件に対応します。
Overall: Research Coordination and Resource Management
Overall は最上位の調整レイヤーです。人間の研究者と対話し、研究目標との整合を保ち、優先順位を管理し、計算資源を調整します。
その責務には、どのプロジェクトに追加資源を割くべきかの決定や、人間の承認を要する判断の特定が含まれます。したがって Overall は、自律的な研究活動と人間の研究マネジメントの間をつなぐ調整レイヤーとして機能します。
Mission: Long-Term Research Planning
各 Mission は特定の研究課題を担当します。Mission は複数の実験をまたいで研究の方向性を維持し、Worker を編成し、結果を解釈し、仮説をさらに調べる価値があるかを判断します。
また、研究アプローチを改訂または中止すべきタイミングも決定します。これにより、1 つのエージェントセッションに全ての中間操作を保持させることなく、長期プロジェクトの継続性が生まれます。
Worker: Experiment Execution and Independent Exploration
Worker は特化した研究タスクを遂行します。コードの読解、アルゴリズムの実装、実験の実行、障害診断、代替アプローチの提案などを担います。
Worker は Mission の判断に異議を唱えることができ、異なる Worker が異なる基盤 AI モデルを使用する場合もあります。この構造により並列探索が可能となり、単一エージェントの推論経路への依存が低減します。
Persistent Scheduling and Research Board
Hyra 2.0 は研究タスクを永続キューに投入します。スケジューラは、タスクの優先度、依存関係、利用可能な資源を考慮して Worker を起動します。
ある実験が学習結果や人間の承認待ちの間でも、他のタスクは継続可能です。エージェントは、実験終了後の次回起動をスケジュールすることもできます。
Research Board は仮説、発見、証拠、主要な意思決定を記録します。これにより、研究プロジェクトの永続状態が個々のエージェント会話から分離されます。
Independent Verification and Human Approval
Worker の結論は、コードのバージョン、実行ログ、評価結果、オリジナルトレースなどの実験的証拠によって裏付けられなければなりません。
追加の精査が必要な結果については、独立した Review Worker が元の問題と証拠を個別に点検できます。このプロセスは、後続の研究に影響する前に、根拠のない結論や実装ミスを特定するのに役立ちます。
高コストの計算操作やチーム共有知識への変更は、人間の承認の対象のままです。したがって、このアーキテクチャは、自律的な実行と重要な判断に対する明示的チェックポイントを組み合わせます。
Books: Turning Research Experience Into Skills
Hyra 2.0 は情報を 3 つのストレージカテゴリに分けます。
- Project state: タスクキュー、コラボレーション記録、研究進捗。
- Agent memory: 現在の理解、仮説、棄却されたアプローチ、将来計画。
- Books: 研究プロジェクト間で共有される再利用可能な知識。
Books は情報を、観察結果、検証済み知見、規約に分類します。単一の実験は観察結果を生み得ます。独立に再現された知見は検証済み知識になり得ます。チームの行動に影響する規約は人間の確認を要します。
プロジェクトレビューの際、再利用可能な方法はスキルへと変換できます。数値検証手順の成功例や学習不安定性の診断法などは、将来の研究ワークフローの再利用可能なコンポーネントになり得ます。
この仕組みにより、個々のセッションを越えて運用上の改善を保持できます。
What Research Results Has Hyra 2.0 Achieved?
Hyra 2.0 の初期成果は、科学モデル、数学研究、量子計算、ロボティクス、単一細胞解析、ハードウェアエンジニアリングをカバーします。
公式の研究リポジトリには、選抜された実装、重み、レポート、検証アーティファクトが含まれます。以下の概要は Tencent の報告結果を要約するものであり、以降の小節でその試験条件と公開状況を説明します。これは単一の汎用エージェント能力を順位付けするものではなく、異なる科学タスクの成果です。
|
| HyInv | 1.96M パラメータ | ProteinMPNN 比でタンパク質配列生成が 57× 高速 |
| HyPLM-Flash | 650M パラメータ; 学習トークン 726B | H20 1 基で 130,000 残基/秒; 32 タスクで競合水準の品質 |
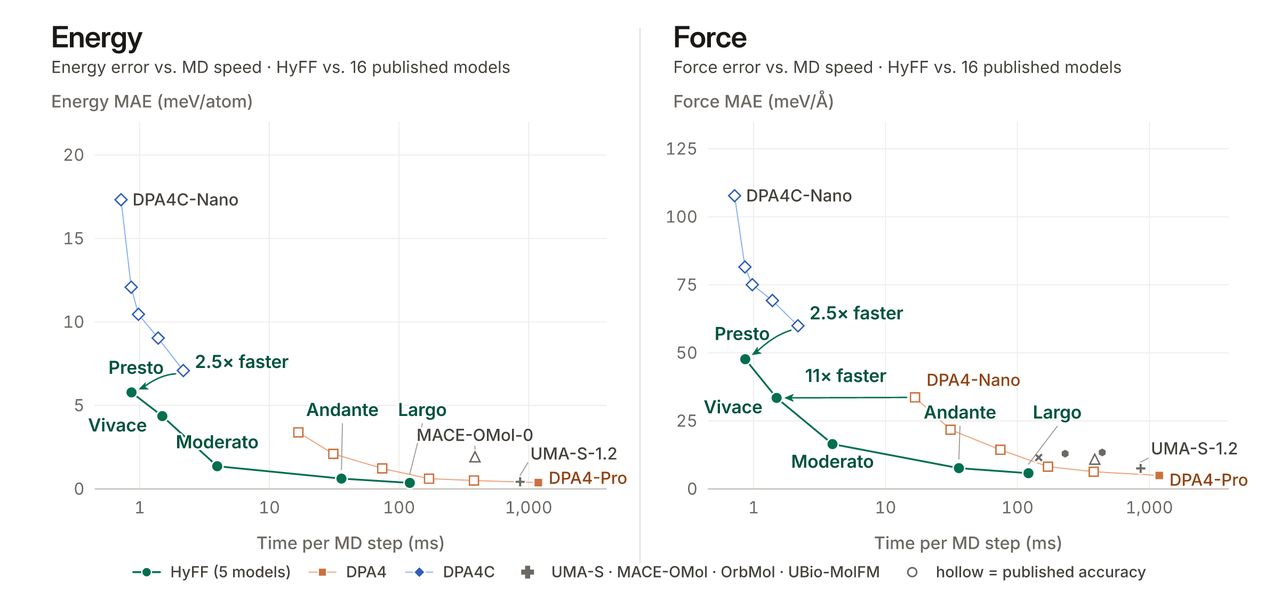
| HyFF | 5 つのモデル; 2.3M–1.2B パラメータ | 16 公開モデルに対する精度-速度のパレート前線 |
| HyCell | 16.1M パラメータ; 512 次元埋め込み | 7 つのホールドアウト細胞アトラスで総合スコア 0.735 |
| HyProver | 数学的証明ワークフロー | Petty の等距離集合予想の 5 次元の場合、および Yau の円作用予想の非制約形への反例 |
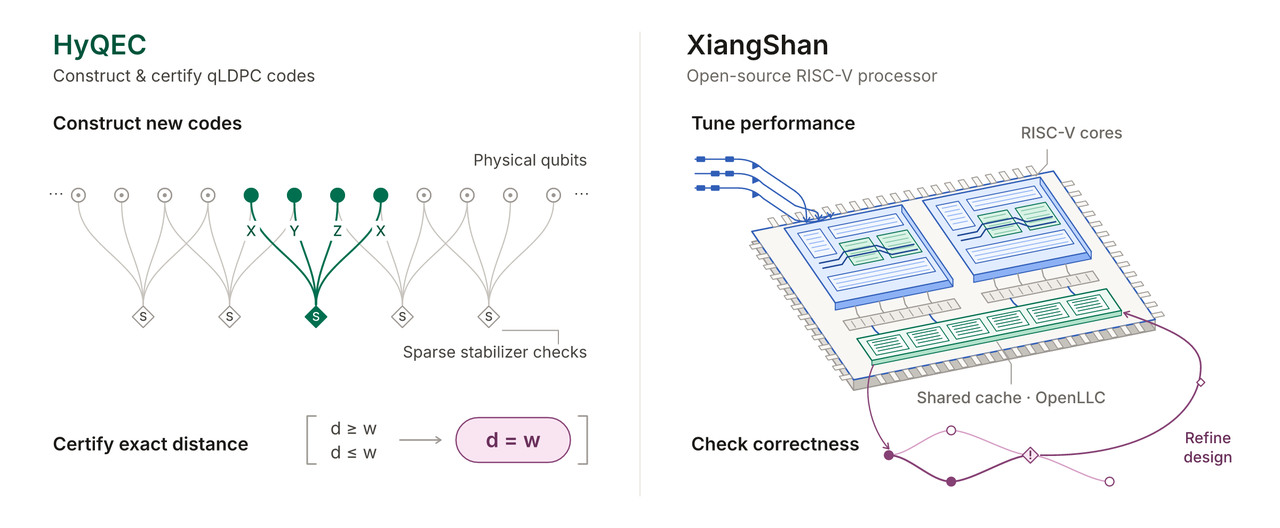
| HyQEC | 量子符号 [[488,123,22]] | 効率指標 122.0; 既存チャレンジリーダー比で約 48% 向上 |
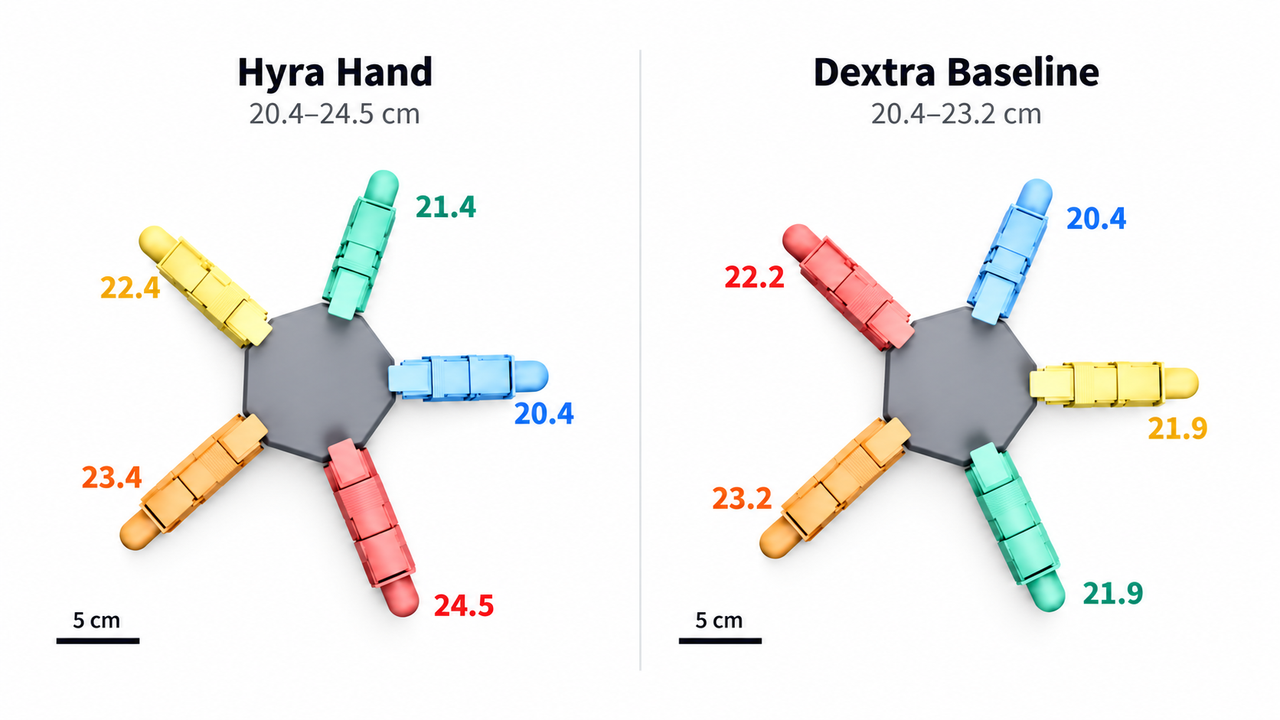
| Spiral Hand | 5 本指ロボット設計 | DR5 シミュレーションで物体回転が 28.6% 高速 |
| XiangShan RISC-V | SPEC CPU2006 性能 | 1 GHz あたりスコアが 5.79% 向上、面積増加 0.3% |
これらの結果は、汎用エージェントスコアではなく、複数種の研究成果を示しています。
HyInv: 57× Faster Protein Inverse Folding
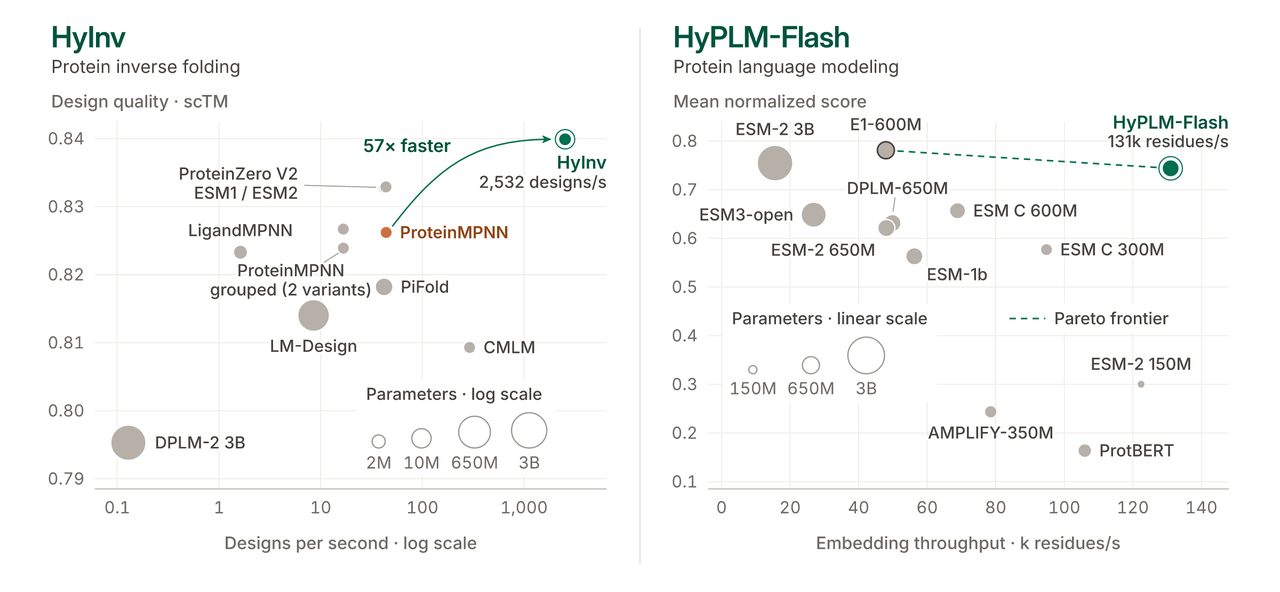
HyInv は、ターゲット骨格に対するタンパク質配列を生成します。1.96M パラメータのモデルは、ProteinMPNN に対して 57× 高速と報告されています。128 デザインで 50.6 ms の報告値は、402 残基の骨格、H20 1 基、BF16、コンパイルおよび CUDA graph capture を除外した条件です。これはウォームアップ後の生成速度として解釈すべきであり、構造スクリーニングは設計サイクル全体の一部として引き続き寄与します。
HyPLM-Flash: High-Throughput Protein Language Modeling
HyPLM-Flash は、726B トークンで学習した 650M パラメータのタンパク質言語モデルです。公開された 28 チェックポイント・32 タスク評価では、ProteinGym スコアが同等のエンコーダーと統計的に同等でした。INT8 推論は H20 1 基で約 130,000 残基/秒に達し、表現の微小差が下流解析に影響する場合は BF16 が望ましいとされます。以下のローンチ図は異なる評価範囲を用いています。
HyFF: Faster Molecular Simulation With Five Model Sizes
HyFF は分子エネルギーと原子力を予測し、2.3M–1.2B パラメータにわたる 5 つのモデルサイズを提供します。報告された OMol25 比較において、Andante は UMA-S-1.2 に近い力誤差(7.65 対 7.55 meV/Å)と 29× 高速な分子動力学を両立します。Largo は DPA4-Pro より低いエネルギー誤差(0.364 対 0.380 meV/atom)と 9.7× 高い速度を報告します。意図する分子で精度と実行時間の両方を検証してサイズを選択してください。
HyCell: A Single-Cell Embedding Model
HyCell は、人間の細胞における遺伝子発現カウントを 512 次元の埋め込みへ写像する 16.1M パラメータのモデルです。7 つのホールドアウト細胞アトラスにおいて、合成スコア 0.735 を達成し、Stack の 0.736 に近い結果です。このスコアは生物学的保存性、バッチ補正、注釈転移を統合したものであり、分類精度ではありません。研究に関連する各構成指標を確認してください。
HyProver: Reusable Workflows for Mathematical Research
HyProver は数学研究を探索・証明開発・レビューに構造化します。報告された結果では、Petty の等距離集合予想の 5 次元の場合を確立し、Yau の円作用予想の非制約形に対する反例を提示しました。これらの結果には境界があります。Petty の予想は全次元で確定したわけではなく、Yau の単連結版は依然として未解決です。
HyQEC: A 48% Improvement in Quantum-Code Efficiency
HyQEC は量子誤り訂正符号を探索し、その距離を検査します。Tencent は、[[488,123,22]] の構成で効率指標 kd²/n が 122.0 を報告しており、提示された制約下で既存のチャレンジリーダーを約 48% 上回ります。これは符号効率を測るものであり、量子ハードウェア性能ではありません。2026 年 11 月 5 日時点の確認では、公式リリースに hyqec-verify と hyqec-check ツールは含まれていますが、この特定構成のコードファイルと証明書は公開予定の証拠として記載されています。公開ツールと、特定の結果に対する公に再現可能な証拠は別個のマイルストーンです。
Spiral Hand: AI-Designed Robotic Morphology
Hyra の Spiral Staircase Hand は、手のひらの周囲にいくにつれて指が段階的に長くなるデザインです。Tencent は、同じポリシー微調整予算後に、DR5 シミュレーションで物体回転が 28.6% 高速、達成ターゲットが 21% 増加したと報告しています。実機ハードウェアでの検証は未了です。
XiangShan RISC-V プロセッサについて、Tencent は SPEC CPU2006 の 1 GHz あたりスコアが 5.79% 向上、コア周波数は不変で面積増加は 0.3% と報告しています。また、これまで報告されていなかった 10 件のバグと、キャッシュコヒーレンスの反例を発見しました。これらの成果は評価対象の設計とワークロードに適用されるものであり、全ての RISC-V システムに当てはまるわけではありません。
How Should Researchers Interpret Hyra 2.0's Benchmarks?
各ベンチマークは、そのワークロードの文脈で読み解いてください。同一の入力、ハードウェア、精度、計測境界を比較し、出力品質を実行時間と併せて評価します。科学的主張については、対応するコード、データ、証明または証明書を確認してください。報告された結果と、独立に再現された結果は、裏付けのレベルが異なります。
Can Developers Use Hyra 2.0 Through an API?
2026 年 11 月 4 日時点で、公開された Hyra 資料は研究成果と選抜リリースを記述しており、一般提供の Hyra 2.0 オーケストレーション API、料金、完全なデプロイメントパッケージを文書化していません。研究発表とダウンロード可能な成果物は、フルシステムのホスト型アクセスとは区別すべきです。
公開資料は研究結果と選抜された成果物に焦点を当てています。開発者は、Hyra により作成された一部のモデル(HyInv、HyPLM-Flash、HyFF、HyCell など)に、関連する研究リポジトリを通じてアクセスできます。
完全な Hyra 2.0 ハーネスは、これらのダウンロード可能な出力とは区別されます。
Hyra 2.0 and Hosted Hunyuan APIs
開発者は、モデル ID hy4 を用いて CometAPI 経由で Tencent Hy4 にアクセスできます。これはコーディング、分析、エージェントワークフローなどの用途に対するホスト型モデル推論を提供しますが、完全な Hyra 2.0 研究ハーネスは提供しません。Hyra により開発された科学モデルは、Tencent の研究リポジトリを通じて別途利用可能です。
What Would Make Hyra 2.0 Useful in a Research Team?
まずは 1 つの公開成果物と小さな参照ワークロードから始めましょう。正常に動作したら、品質閾値と計算予算を固定した上で、代表的なローカルデータで試験します。リポジトリのリビジョン、重み、環境、入力、出力をまとめて保管し、同僚が再現できるようにします。待機時間が長い、依存関係がある、競合する仮説があるといった場合に、永続的なマルチエージェント調整を導入してください。
Conclusion
Hyra 2.0 は、研究計画、実験実行、再利用可能な知識を 1 つの持続的なワークフローに統合します。科学的成果は、さらなる研究の有望な出発点です。研究チームにとっての実践的な試金石は、公開成果物が実際の実験を改善し、他者が検証・再現できる証拠を生み出すかどうかです。
FAQ
研究室が最初の Hyra 成果物トライアルを予算化するには?
3 段階に予算を配分します。再現可能な環境の構築、小さな参照ケースの実行、代表的なローカルワークロードの評価です。アクセラレータ使用だけでなく、準備とレビューの時間も見込みます。開始前に受け入れ基準を定めます(例: 必要な品質水準を維持しつつターンアラウンドを短縮)。初回トライアルは、全面的な研究キャンペーンに必要な資源を投じずに、失敗の原因を切り分けられる規模に留めます。
再現性パッケージには何を含めるべき?
リポジトリのリビジョン、モデル重みの識別子、環境バージョン、入力データの来歴、設定、関連する場合の乱数シード、評価出力を一式で保存します。公開例に変更を加えた場合は記録します。結果が証明や証明書に依存する際は、チェッカーのバージョンとその出力も保存します。パッケージは、ソフトウェアの問題、入力の変更、科学的結果の真の差を他の研究者が区別できるようにする必要があります。
ベンチマークの汚染をどう避けるか?
モデル選定や設定調整に用いたデータと、最終評価に用いるデータを分離します。候補の比較前に最終プロトコルを凍結し、確立可能な範囲で事前学習や開発データとの重複を記録します。新規の科学データセットでは、想定運用に即した分割(例: ホールドアウト研究や実験条件)を用います。評価例が繰り返し系の設計に影響した場合、優れたスコアの情報量は下がります。
エージェント間で結論が食い違う場合の対処は?
多数決で結論を混ぜるのではなく、基になる実験を比較します。エージェントが同じデータセットバージョン、仮定、指標、ソフトウェア設定を使ったかを確認します。差異が説明されるまで両方の知見を保持し、その後、競合する説明を識別できる焦点化された実験を実施します。エージェント間の一致は有用ですが、外部測定や検証可能な論証の代替にはなりません。
いつより単純な研究ワークフローが望ましいか?
短く決定的で、成熟したスクリプトと明確な評価器を備えるタスクは、永続的なマルチエージェント調整の恩恵が小さい場合があります。追加のスケジューリング、記録、レビューの負担が、利得を上回ることがあるためです。実験の依存関係が意味を持つ、待機が長い、複数の競合仮説がある、再利用成果の継続的保守が必要といったときにオーケストレーションを導入します。判断はワークロードの構造と観測された調整コストに従うべきです。