TL;DR
MiMo-V2.6 は Xiaomi の新しいオープンウェイトかつネイティブなマルチモーダル、エージェント指向の推論モデルファミリーです。MiMo-V2.6-Pro はスパース MoE 設計を採用し、総パラメータ数は 1.02 兆、トークンあたり約 420 億のパラメータが有効化されます。MiMo-V2.6-Flash は総パラメータ 3,090 億、トークンあたり約 150 億が有効化されます。両モデルとも 100 万トークンのコンテキストウィンドウとテキスト・画像・動画・音声を含むマルチモーダル入力をサポートします。
要点
- MiMo-V2.6-Pro は 1.02 兆パラメータのスパース MoE モデルで、トークンあたり約 420 億のパラメータが有効化。Flash は総 3,090 億/有効約 150 億。
- 両モデルとも 100 万トークンのコンテキスト、マルチモーダル入力、Xiaomi の API で最大 128K の出力トークンに対応。
- 本ファミリーは推論、ツール使用、ウェブ検索、構造化出力、長期的なエージェントワークフローを念頭に設計。
- Xiaomi は V2.6 をコード、汎用エージェント、視覚タスク、サイバーセキュリティ環境を横断した混合強化学習で訓練。
- 公式発表では Pro が高能力、Flash が低コスト・大量処理向けの位置づけ。ただし実務負荷別の評価は依然として必要。
Xiaomi MiMo-V2.6 とは?
MiMo-V2.6 は Xiaomi の MiMo モデルファミリーの最新世代です。重視しているのは単により良い回答生成ではなく、長い行動列の実行です。環境の観察、ツールの呼び出し、結果の確認、エラー修正、目的達成までの継続を含みます。Xiaomi はリリースを再帰的自己改善(RSI)として位置づけており、これはモデルが繰り返し環境を探索し、より豊かな報酬信号を受け取り、軌跡を比較し、より効果的な戦略を学ぶ RL ループを指します。これはモデルが自律的に後継を改変・訓練することを意味するものではありません。
Pro と Flash と UltraSpeed の違い
| Feature | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.6-Pro-UltraSpeed |
|---|---|---|---|
| Positioning | フラッグシップ級の推論 | 大量処理/高い費用対効果 | 低レイテンシのフラッグシップ |
| Total parameters | 1.02T | 309B | Pro と同一モデル |
| Active parameters | 42B | 15B | Pro と同等の性能 |
| Architecture | Sparse MoE | Sparse MoE | Pro の提供モード |
| Context | 1M | 1M | 1M |
| Max output | 128K | 128K | 128K |
| Text / image / video / audio input | はい | はい | はい |
| Deep reasoning / tool calling | はい | はい | はい |
| Structured output / context caching | はい | はい | はい |
| Main advantage | 最大の能力 | コスト効率 | 最大 20 倍の高速提供 |
MiMo-V2.6-Pro と Flash、どちらを使うべき?
実務上の選択: 困難な長期的エンジニアリング、研究、サイバーセキュリティ、高付加価値のエージェント業務には MiMo-V2.6-Pro を。大量自動化、文書やマルチモーダル処理、コストを重視した反復呼び出しには MiMo-V2.6-Flash を。Pro レベルの推論が必要だがレイテンシが最優先の場合は MiMo-V2.6-Pro-UltraSpeed を。UltraSpeed は別能力のモデルではなく提供ティアであり、標準 Pro の最大 20 倍の出力速度が謳われています。
Xiaomi MiMo-V2.6 はどのように機能するのか?
スパース Mixture-of-Experts アーキテクチャ
MiMo-V2.6 は各トークンで全パラメータを有効化しません。フラッグシップの Pro チェックポイントは総 1.02 兆パラメータですが、トークンあたりに有効なのは約 420 億のみです。Xiaomi のモデルカードでは 70 層の Transformer、384 のルーティング対象エキスパート、同時有効化は 8 エキスパートと説明されています。Flash は大幅に小さく、総 309B/有効 15B、48 層の Transformer、256 のルーティング対象エキスパートです。
| Architecture specification | MiMo-V2.6-Pro | MiMo-V2.6-Flash |
|---|---|---|
| Total parameters | 1.02T | 309B |
| Activated parameters | 42B | 15B |
| Transformer layers | 70 | 48 |
| Hidden size | 6,144 | 4,096 |
| Routed experts | 384 | 256 |
| Experts activated | 8 | 8 |
| Maximum context | 1M | 1M |
| MiMo ViT | 681M パラメータ | 681M パラメータ |
| AudioTokenizer | 308M パラメータ | 308M パラメータ |
| Audio patch encoder | 127M パラメータ | 127M パラメータ |
| Speculative decoder | 5 層 | 5 層 |
本アーキテクチャはスライディングウィンドウ・アテンションとグローバル・アテンション層を組み合わせ、5 層のマルチトークン予測スペキュレイティブ・デコーダを含みます。実務的含意として、見出しのパラメータ数とトークンあたりの計算量は別物です。スパースなルーティングにより、各トークンで全重みを密に推論せずに大規模なエキスパートプールを維持できます。
ネイティブなマルチモーダル理解
MiMo-V2.6 は視覚エンコードに Xiaomi の 681M パラメータの MiMo ViT を用い、専用の音声コンポーネントを組み合わせます。これにより同一エージェントがテキスト指示、スクリーンショット、写真、動画、音声を処理できます。コンピュータ操作エージェントでは、知覚と意思決定が分離されたユーザー向けモデルに分かれることなく、同じ推論ループ内で行える点が重要です。
なぜ MiMo-V2.6 に強化学習が重要なのか?
Xiaomi は、公開 6 日間の訓練実験で Flash と Pro の両方が約 30 の RL ステップと 75 万件程度の軌跡を経たと報告しています。報告された訓練コストは Flash が約 $850,000、Pro が $2.62 million。各アップデートは 1,568 サンプルを使用し、個々の訓練ステップは約 35~37 億トークンに達しました。タスクの混成はコード、汎用エージェント、視覚タスク、サイバーセキュリティ、複数のエージェントハーネスを含みます。
この RL 過程で、Xiaomi はアウトオブサンプルの DeepSWE v1.1 スコアが Flash で 48.8 から 65.7、Pro で 58.4 から 72.6 に上昇したと報告しています。これらの数値はライブ RL 実験を説明するもので、最終チェックポイントのすべてのベンチマークスコアと混同すべきではありません。評価設定が異なる可能性があるためです。
グループ単位のエージェント評価
エージェント訓練において、二値の合否報酬は二つの成功した軌跡間の意味ある差を隠しかねません。ある解は少ないツール呼び出しで素早く終える一方、別の解は数十ステップを浪費する場合があります。そこで Xiaomi は、Groupwise Reward Synthesis と Groupwise Advantage Redistribution を、グループ内で軌跡を比較し、よりクリーンな解に学習信号を再分配する仕組みとして説明します。目的はタスク完了だけでなく、到達経路の効率も高めることです。
エージェント系ベンチマークでの性能は?
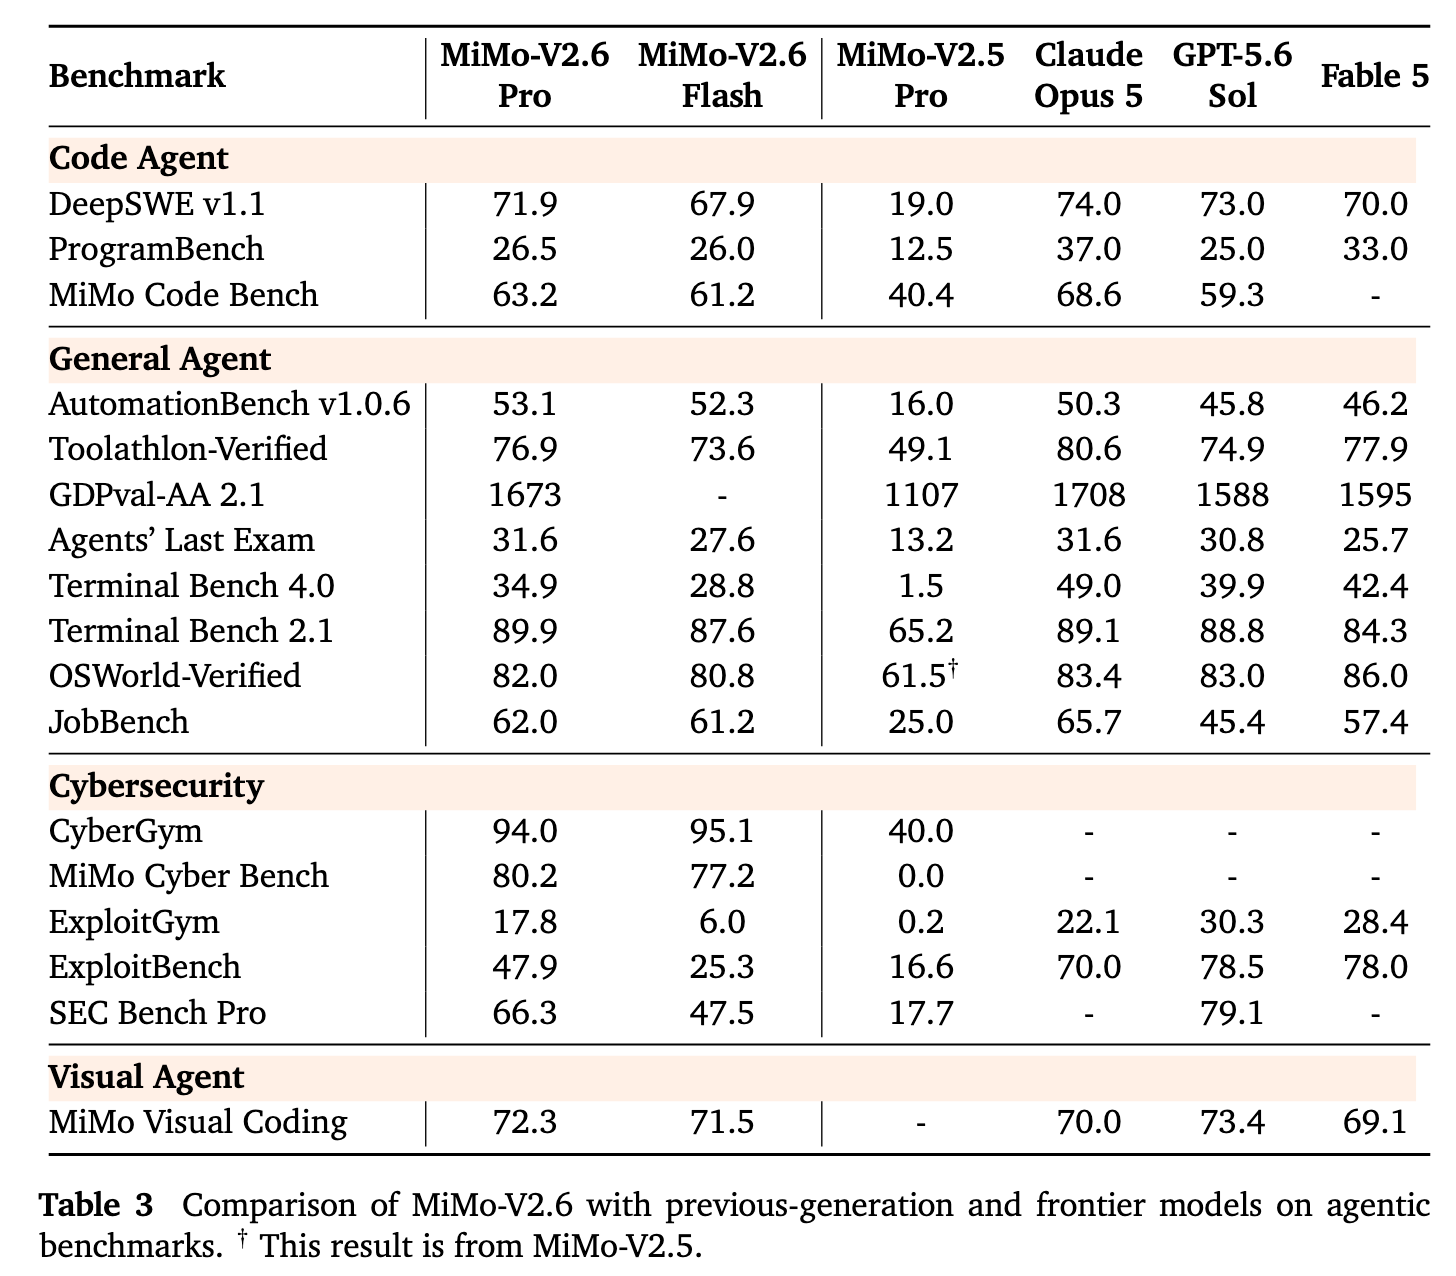
V2.6 の最も強い公開証拠は、従来の多肢選択ではなくエージェント系ベンチマークに集中しています。Xiaomi の公式チャートは、コード、汎用エージェント、サイバーセキュリティ、視覚エージェントのタスクで、Pro と Flash を MiMo-V2.5-Pro、Claude Opus 5、GPT-5.6 Sol、Fable 5 と比較しています。
| ベンチマーク | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 74.0 | 73.0 |
| ProgramBench | 26.5 | 26.0 | 37.0 | 25.0 |
| MiMo Code Bench | 63.2 | 61.2 | 68.6 | 59.3 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 50.3 | 45.8 |
| Toolathlon-Verified | 76.9 | 73.6 | 80.6 | 74.9 |
| Agents' Last Exam | 31.6 | 27.6 | 31.6 | 30.8 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 89.1 | 88.8 |
| OSWorld-Verified | 82.0 | 80.8 | 83.4 | 83.0 |
| JobBench | 62.0 | 61.2 | 65.7 | 45.4 |
| MiMo Visual Coding |
コーディングの進展
コーディングの伸びは長期的実行で最も明瞭です。ライブ RL 実行中、Xiaomi はアウトオブサンプルの DeepSWE v1.1 が Flash で 48.8→65.7、Pro で 58.4→72.6 と改善したと報告。リリースされたクロスモデル表では Pro が DeepSWE v1.1 で 71.9、MiMo Code Bench で 63.2、Flash がそれぞれ 67.9 と 61.2 を記録しています。Pro はすべてのコーディングテストで勝つわけではありません。Claude Opus 5 は DeepSWE、ProgramBench、MiMo Code Bench で依然優位ですが、V2.6 はオープンウェイトと大幅に低い API 価格を伴い、リポジトリ規模の性能で競争力を示します。
推論とエージェントの進展
推論の前進は単一の抽象的知能スコアというより、計画、ツール使用、リカバリの改善として捉えるのが適切です。Pro は Terminal Bench 2.1 で 89.9、AutomationBench で 53.1、Toolathlon-Verified で 76.9。Flash は 87.6、52.3、73.6。Pro は記載の Claude Opus 5 と GPT-5.6 Sol を Terminal Bench 2.1 でわずかに上回り、AutomationBench では両 V2.6 モデルがそれらを上回ります。Xiaomi は、グループ単位の軌跡比較、より豊かな評価、マルチハーネス訓練、より短くクリーンな経路を好む報酬信号を改善要因として挙げています。
ナレッジとリサーチの進展
知識集約的な進展は、従来型の知識試験よりエージェント評価とデモによって裏付けられています。Pro は Agents' Last Exam で 31.6 と Claude Opus 5 に並び、JobBench で 62.0 に到達。Xiaomi は、文献・特許検索、仮説生成、計算ツール呼び出しを含む材料研究ワークフローや、6,000 行超の Lean 4 形式化プロジェクトも報告しています。これらは取得・統合・形式推論・ツールに根差した知識作業の強化を示唆しますが、普遍的な知識優位を独立に証明するものではありません。
総評: V2.6 の進展は広範だが一様ではありません。長期的なコーディングとエージェント実行の改善証拠が最も強く、一般推論や知識に関する主張は特定のベンチマーク、ハーネス、デモに紐づけて捉えるべきです。
ベンチマーク注記:特記なき限り、以下のクロスモデル結果は Xiaomi が MiMo-V2.6 のモデルカードで報告したものです。スコアはベンチマークのバージョン、エージェントハーネス、ツール構成、推論予算、評価手順に依存しうるため、独立再現された順位表と解釈すべきではありません。
MiMo-V2.6 と MiMo-V2.5 の違いは?
| 項目 | MiMo-V2.5 世代 | MiMo-V2.6 のブレークスルー |
|---|---|---|
| 学習の重点 | 強力なマルチモーダルエージェント、長いコンテキスト、トークン効率 | コード、汎用エージェント、ビジョン、サイバーセキュリティ、複数ハーネスにまたがる大規模な混合 RL プログラム |
| エージェント能力 | V2.5-Pro は困難な長期タスクをターゲット | Xiaomi は V2.6-Flash がそのエージェントベンチマークスイートで V2.5-Pro を総合的に上回ると報告 |
| 学習効率 | 以前のプロダクションチェックポイント | 約 30 の RL ステップで 75 万件の軌跡;訓練中のホールドアウト DeepSWE が Flash で約 17 pt、Pro で約 14 pt 改善 |
| オープン性 | オープンウェイトとエコシステムサポート | RL コード、7,000+ のタスク環境、訓練フレームワーク、軽量ハーネス、9B の蒸留チェックポイントを追加 |
| コスト面 | 既存の V2.5 API 価格帯 | 公式 API 価格据え置きのまま、より高い知能を報告し、能力とコストのフロンティアを前進 |
コーディングとエージェント実行
V2.5 と比べ、最も明確な変化はコンテキスト拡張ではなく、より強力なエージェント方策です。Xiaomi は V2.6-Flash がそのエージェントベンチマークスイートで V2.5-Pro を上回ると報告。V2.6 の訓練中、ホールドアウトの DeepSWE v1.1 は Flash で 48.8→65.7、Pro で 58.4→72.6 と改善しました。これら訓練時のスコアは、上のリリース済みベンチマーク表と直接互換ではありません。
推論、知識、訓練の幅
V2.6 はコード、汎用エージェント、ビジョン、サイバーセキュリティ、複数ハーネスに強化学習を拡張。Xiaomi は約 30 の RL ステップで約 75 万軌跡を報告。より広い計画、ツール使用、リカバリを支えますが、これ自体はすべての知識・推論ベンチマークの普遍的な伸びを保証しません。タスクと評価設定を一致させて比較してください。
マイグレーションとオープン性
リリースには RL コード、7,000 以上のタスク環境、訓練インフラ、9B の蒸留チェックポイントも追加。100 万トークンのコンテキストとマルチモーダル入力は V2.5 からの継続であり、V2.6 で新規のブレークスルーではありません。
実務的な変化は、新たなコンテキスト容量ではなく(100 万コンテキストとフルマルチモーダルはすでに V2.5 で実現)、より多くの強化学習計算資源と広い検証可能環境で訓練された、より強いエージェント方策です。Xiaomi は V2.5 と V2.5-Pro のモデル名が 2026 年 10 月 21 日に使用不可になると発表しており、新規導入は V2.6 を対象に、既存導入は移行テストを計画すべきです。
他の最先端モデルとの比較
| 項目 | MiMo-V2.6-Pro | クローズド最先端モデル | その他のオープンウェイトモデル |
|---|---|---|---|
| ウェイト | オープンウェイト | 概ねクローズド | モデル依存 |
| 検証済み MiMo コンテキスト | 100 万トークン | 各公式モデルページで要確認 | 各モデルカードで要確認 |
| 検証済み MiMo モダリティ | テキスト、画像、動画、音声 | プロバイダー依存 | モデル依存 |
| エージェント重視のRL | リリースで強く強調 | モデルやシステムに依存 | モデル/チェックポイントに依存 |
| セルフホスティング | 可(相応のインフラが必要) | 一般に不可 | オープンチェックポイントでは可能なことが多い |
| 主な MiMo の利点 | オープンウェイト、ネイティブなマルチモーダル、低 API コスト | プロバイダーのエコシステムとマネージドツール群 | ライセンス、規模、デプロイスタックに依存 |
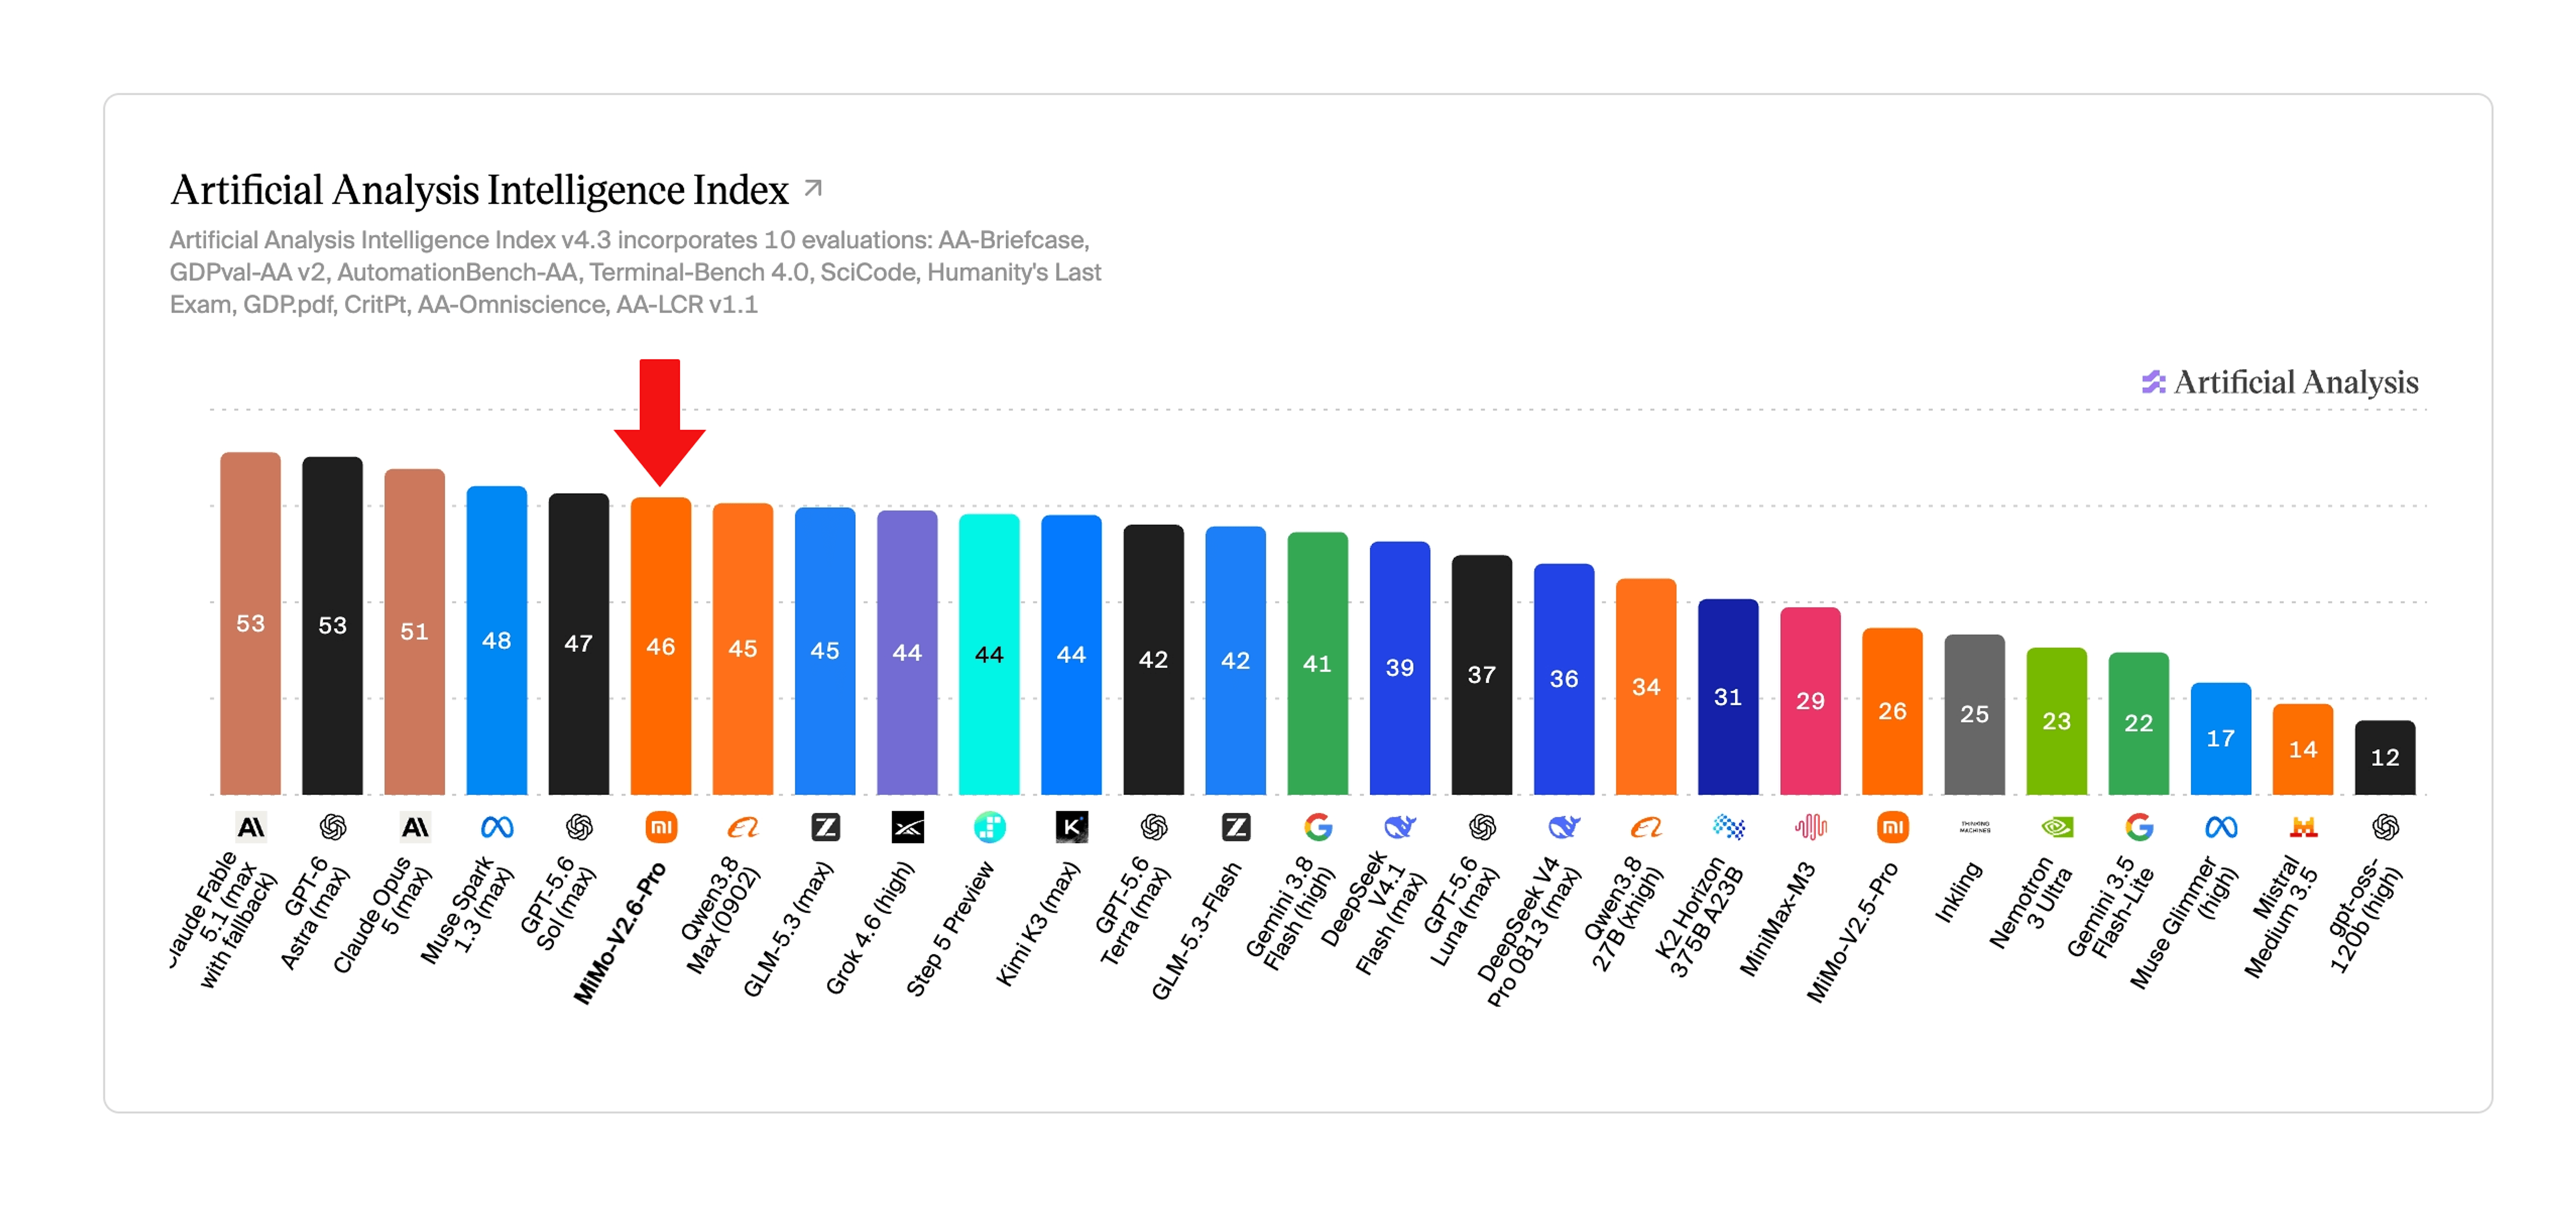
現時点の比較対象として、長時間のエージェント的コーディングには Claude Opus 5.5、最難度の自律作業には Claude Fable 5.1、GPT-6 Sol、Gemini 4 Pro と比較してください。モデルの提供状況と価格は動的に変化するため、実運用の比較ではライブカタログと統一したプロンプト、ツール、予算、受入基準で評価すべきです。
MiMo-V2.6 は実際に何ができるのか?
コーディングとソフトウェアエンジニアリングエージェント
MiMo-V2.6 は長いソフトウェアエンジニアリング軌跡のために設計されています。リポジトリの調査、コード変更、ターミナルツールの使用、テストの実行、失敗の診断、目標達成までの継続です。DeepSWE、Terminal Bench、AutomationBench、Toolathlon の結果は、Xiaomi がコード補完単体ではなく実行に最適化していることを示します。実務にはコーディングエージェント、自動デバッグ、リポジトリのリファクタリング、CI 問題解決、マルチツールのエンジニアリングワークフローが含まれます。
コンピュータ操作
Xiaomi は Computer Use Agent(CUA)を明示的にデモしています。モデルは GUI を解釈し、情報を取得し、編集し、データを処理し、結果を確認し、問題を診断し、視覚的フィードバックに基づいて次のアクションを変更できます。このワークフローでは、モデルの出力が最終成果物ではなく、次のソフトウェアやブラウザ操作を決定する場合があります。
3D ワールドと Blender ワークフロー
「Vibe World」のコンセプトのもと、MiMo-V2.6 はテキスト・画像・動画の参照を受け取り、3D 要件をシーン構築、インタラクションプログラミング、視覚検証のタスクに分解できます。Xiaomi はまた、モデルが Blender を操作して記述や参照画像から 3D オブジェクトやシーンを作成する様子をデモします。これはアプリケーションコードを超え、インタラクティブ環境へと「バイブコーディング」を拡張します。
ロボティクスと身体性エージェント
Xiaomi はマルチビューカメラ画像と Franka Panda ロボットアームを用いた身体性シミュレーション環境で MiMo-V2.6 をデモしています。例として把持、色のマッチング、精密な配置など。これは V2.6 があらゆるロボティクスの基盤モデルであることを示すものではありませんが、ネイティブな視覚と長期意思決定を身体制御ループに結びつける方法を示します。
科学研究と形式推論
Xiaomi は、PFAS 吸着用の金属有機構造体(MOF)に関する材料科学ケースを報告し、文献・特許検索、候補設計、計算ツール呼び出しを MiMo-V2.6-Pro が支援したと述べています。別の実験では、「周期 3 はカオスを意味する」の主要定理を Lean 4 で形式化するのを支援。Xiaomi は Lean カーネルが未証明のプレースホルダーなしで検証した 6,000 行超のプロジェクト完了を報告しています。これらはエージェント的研究ワークフローのデモとして解釈するのが適切で、モデルの自律的な科学的発見の証明ではありません。
ウェブサイト、プレゼン、動画、音楽
MiMo-V2.6 はフロントエンド実装、デザインフロー、スライド、SVG アセット、動画パイプライン、音楽制作ツールを調整できます。Xiaomi は MiMo-V2.5-TTS によるナレーションなど、専門のメディアシステムとのオーケストレーションを示しており、V2.6 自体がすべての画像・動画・音声ジェネレータを置き換えると主張しているわけではありません。したがって本モデルはクリエイティブ制作のオーケストレーターとして自然に適合します。
本節のユースケースは Xiaomi のデモであり、あらゆる導入で同じ結果が再現される独立証拠ではありません。実運用チームは自らのツール、権限、失敗時の回復、評価基準でモデルをテストすべきです。
Xiaomi MiMo-V2.6 のコストは?
| Pricing | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Pro UltraSpeed |
|---|---|---|---|
| Cached input / 1M tokens | $0.0036 | $0.0028 | $0.036 |
| Uncached input / 1M tokens | $0.435 | $0.14 | $4.35 |
| Output / 1M tokens | $0.87 | $0.28 | $8.70 |
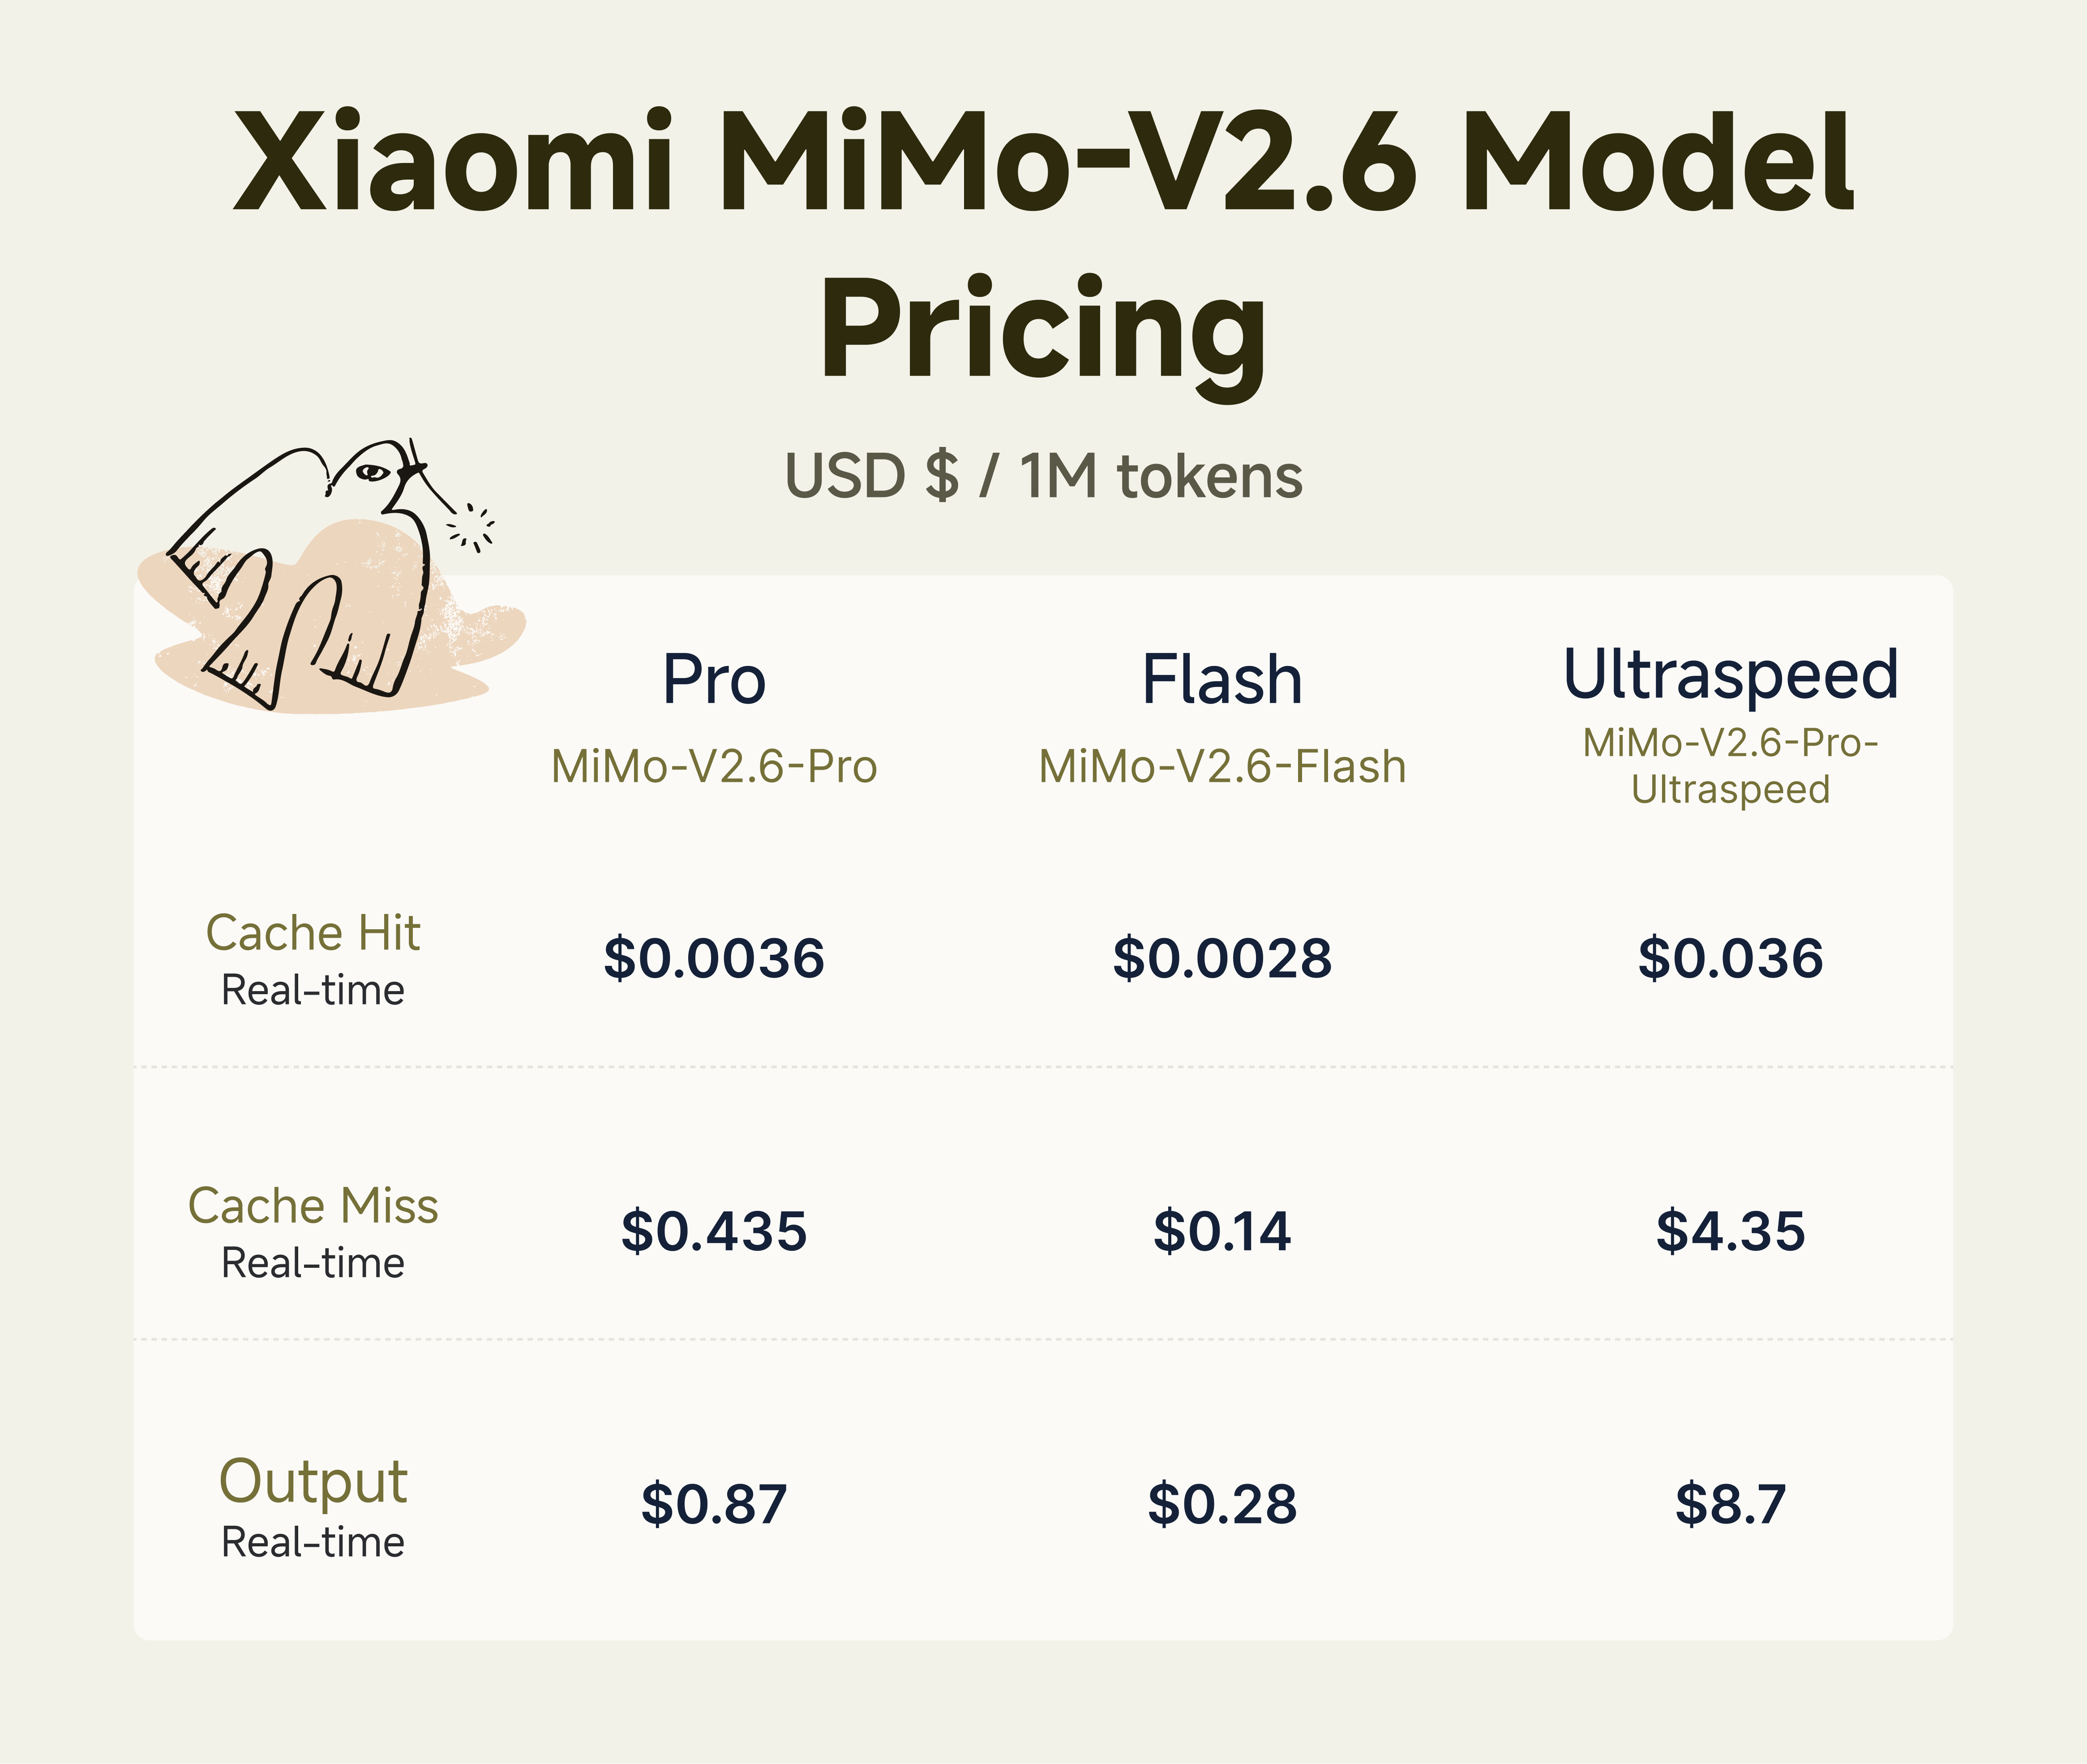
Xiaomi は V2.6 の API 価格を V2.5 世代と同水準に維持しています。Flash は大量処理で特に注目に値し、公式 Xiaomi 価格は未キャッシュ入力 100 万トークンあたり $0.14、出力 100 万トークンあたり $0.28 を示しています。
CometAPI の価格と提供状況
| CometAPI ルート | Input / 1M | Output / 1M | カタログ状況 |
|---|---|---|---|
| mimo-v2.6-pro-ultraspeed | $3.48 | $6.96 | 利用可能;公式の未キャッシュ料金比で 20% 安価 |
| mimo-v2.6-pro | $0.348 | $0.6960 | 利用可能;公式の未キャッシュ料金比で 20% 安価 |
| mimo-v2.6-flash | $0.112 | $0.2240 | 利用可能;公式の未キャッシュ料金比で 20% 安価 |
開発者は Xiaomi MiMo-V2.6 にどうアクセスできるか?
Xiaomi は OpenAI 互換の API を通じてモデルを公開し、公式モデルページで Anthropic プロトコルとの互換性を文書化しています。公式識別子は mimo-v2.6-pro、mimo-v2.6-flash、mimo-v2.6-pro-ultraspeed。Xiaomi はツール呼び出し、構造化出力、ストリーミング、推論制御、コンテキストキャッシング、ウェブ検索を文書化。OpenAI 互換インターフェースは thinking.type に enabled や disabled などの値を用い、V2.6 モデルではデフォルトでディープ思考が有効です。
開発者の実務的なアクセス経路は三つです。第一に、相応の提供要件を前提に、Pro または Flash のオープンウェイトチェックポイントをダウンロードしてセルフホスト統合。第二に、Xiaomi のマネージド API を Xiaomi キーと公式エンドポイントで使用。第三に、CometAPI でサポートされたルートを CometAPI キーとベース URL で利用。これによりマルチモデル評価と課金を簡素化できます。Claude Code などのコーディングアシスタントはサポート時に Anthropic 互換ルートを使用できますが、互換性は想定ではなく検証が必要です。
CometAPI 経由での MiMo-V2.6 へのアクセス
CometAPI はサポートモデル向けに統一エンドポイントと課金レイヤーを提供します。主な運用上の利点は移行の容易さで、使い慣れた SDK を維持しつつ、ベース URL とモデル ID を変更して、同一アカウントで MiMo と他の最先端モデルを比較し、利用状況・価格・可用性の確認を一元化できます。これはマルチモデルルーティング、フォールバック戦略、請求の集約、プロバイダ横断で同一プロンプトを必要とする評価に有用です。
CometAPI はプラットフォームレベルで 3 つのテキストリクエスト形式を文書化しています:OpenAI Chat Completions、Anthropic Messages、OpenAI Responses。SDK が互換であれば、移行は一般にベース URL、API キー、モデル ID の変更で済み、アプリ全体を書き換える必要はありません。エンドポイントやパラメータのサポートはモデルにより異なるため、MiMo-V2.6 の正確なバリアントとリクエスト形式をテストしてから三者互換を主張してください。
2026 年 9 月 23 日時点の確認では、MiMo-V2.6-Pro-UltraSpeed は入力・出力価格が掲載されたカタログルートが利用可能。専用の Pro と Flash のページは、カタログスナップショットに Coming soon と表示される一方で API 健全性パネルでは Available と表示。これはページ上の不整合なシグナルと扱い、実運用の可用性や価格の確証とはみなさないでください。デプロイ前にライブカタログ、ダッシュボード、テストリクエストを確認しましょう。
以下の例は CometAPI 公開の Anthropic-SDK パターンに従い、現時点で掲載されている UltraSpeed ルートを呼び出します。API キーは環境変数に保存してください。
import Anthropic from '@anthropic-ai/sdk';

const client = new Anthropic({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: 'https://api.cometapi.com',
});

const message = await client.messages.create({
  model: 'mimo-v2.6-pro-ultraspeed',
  max_tokens: 4096,
  messages: [{ role: 'user', content: 'Analyze this project and propose the next implementation steps.' }],
});
Xiaomi MiMo-V2.6 はオープンソースか?
Xiaomi はモデルウェイト、技術資料、RL リソース、訓練環境、関連インフラを公開しました。リリースには、ソフトウェアエンジニアリング、脆弱性再現、知識集約作業、ウェブ設計/開発にまたがる 7,000 超の RL タスク環境が含まれます。研究者が小規模で RL パイプラインを検証できるよう、MiMo-V2.6-Distill-Qwen-9B も公開されました。
公式モデルカード: MiMo-V2.6-Pro-RL | MiMo-V2.6-Flash-RL
Xiaomi MiMo-V2.6 の制約は?
1 兆パラメータという見出しは、V2.6 がクローズドな最先端システムより普遍的に強い証拠として扱うべきではありません。Xiaomi 自身のベンチマーク表は混在した様相を示しており、Claude Opus 5 は一部のコーディング、ツール使用、OS ベンチマークで先行し、GPT-5.6 Sol も選択されたテストで優位です。したがって、一律の勝者ラベルよりも、実務負荷別の評価がより有意味です。
Pro のフルチェックポイントをセルフホストすることもインフラ的に重い作業です。オープンウェイトは容易なワークステーション導入を意味しません。さらに、研究、身体制御、3D ワールド、動画制作といった見出しデモの多くは外部ツールやエージェントハーネスに依存します。MiMo-V2.6 は単体のチャットモデルではなく、システムの一要素として評価すべきです。
なぜ Xiaomi MiMo-V2.6 は重要か?
MiMo-V2.6 は、非常に大きなスパース MoE モデル、ネイティブなマルチモーダル、実環境のエージェントを対象とした強化学習という三つの重要な方向性を結合しています。1.02 兆という数字は注目を集めますが、より本質的なのは、反復的な環境相互作用、軌跡評価、ツール使用、自己修正への投資という設計選択です。
このアプローチが継続してスケールするなら、オープンモデルの差別化は静的知識量だけでなく、長いタスクをいかに行動し、評価し、回復し、完了できるかにも拡がるでしょう。MiMo-V2.6 は、単なる「兆パラメータのチャットボット」ではなく、エージェント指向のオープンな基盤モデルとして理解するのが最適です。
結論
MiMo-V2.6 は、ネイティブなテキスト・画像・動画・音声入力、長いコンテキスト、スパース MoE 推論、実環境のエージェントを対象とする強化学習を組み合わせた、実質的なオープンウェイトのリリースです。Pro は難度の高い長期タスクに適し、Flash は大量・コスト重視のワークロードを対象にし、UltraSpeed は有意に高い API 価格と引き換えに低レイテンシを提供します。
このモデルファミリーは、ベンダー報告のエージェント系ベンチマークで競争力がありますが、すべての評価をリードするわけではなく、クローズド最先端モデルの普遍的代替として扱うべきではありません。最も信頼できる採用経路は、想定する実運用ワークフローのツール、レイテンシ目標、故障モード、コストプロファイルに対し、MiMo-V2.6 を直接テストすることです。
FAQ
MiMo-V2.6 を本番導入する前にチームは何をテストすべき?
モデル単体ではなくシステム全体をテストしてください。タスク完了率、ツール呼び出しの正確性、失敗からの回復、レイテンシ、トークン消費、コンテキスト管理、権限境界を測定します。エージェントベンチマークは指針になりますが、社内評価は実際のリポジトリ、ブラウザ、文書、研究ワークフローを模倣すべきです。
スパース構造なのに MiMo-V2.6-Pro のセルフホスティングが難しいのはなぜ?
スパースな有効化は密な兆パラメータモデルに比べトークンあたりの計算量を減らしますが、フルチェックポイントは依然として非常に大きなメモリと分散提供のフットプリントを持ちます。本番配備にはマルチノード推論、エキスパート並列、特化カーネル、慎重なキャパシティ計画が必要になる可能性があります。
Xiaomi のクロスモデル・ベンチマーク表はどう解釈すべき?
ベンダー報告の証拠として扱い、独立再現された普遍的な順位表とはみなさないでください。結果はエージェントハーネス、推論予算、ツール、環境イメージ、サンプリング手法、ベンチマークのバージョンで変わり得ます。複数タスクにわたる傾向を比較し、最も関連するワークロードは社内で再現してください。
どんなときに MiMo-V2.6-Flash が Pro より適している?
呼び出し頻度とコストが支配的な場合、とくに文書処理、マルチモーダル分析、繰り返しのエージェントステップでは Flash がより強いデフォルトです。困難な推論や長期実行が十分なビジネス価値を生むなら、より高価でも Pro が適切です。
100 万トークンのコンテキストウィンドウがあれば、検索やプロンプト管理は不要?
いいえ。コンテキストが大きいほど容量は増えますが、不必要な履歴を送るとレイテンシとコストが上がり、関連証拠が希釈される可能性があります。検索、要約、構造化メモリ、コンテキストの剪定は、信頼できる本番エージェントに引き続き重要です。