워크로드에 맞춰 모델을 선택하세요: 프리미엄 대체에 가장 가까운 것은 Claude Opus 5, 가장 어려운 지속적 추론에는 Claude Fable 5.1, OpenAI 마이그레이션 마찰 최소화에는 GPT-5.6 Sol, 대량 프로덕션에는 Claude Sonnet 5, 저비용 멀티모달 작업에는 Gemini 3.8 Flash, 토큰 비용이 최우선 제약일 때는 DeepSeek V4.1 Flash.
다만 컴퓨터 사용, 자율 실행, 과학적 추론, 사이버보안 성능이 재시도와 인간 개입을 실질적으로 줄여주는 워크로드에는 GPT-6 Astra를 유지하세요.
핵심 요점: GPT-6 Astra를 대체할 때 무엇이 중요한가?
GPT-6 Astra는 가장 강력한 에이전트형 작업에서 대체가 어렵습니다. 공식 GPT-6 Astra 벤치마크 표는 Terminal-Bench 4.0에서 57.9%, FrontierMath Tier 4에서 97.6%, GPQA Diamond에서 96.0%를 기록합니다.
Claude Opus 5는 가장 균형 잡힌 직접 대안으로 먼저 테스트할 가치가 있습니다. Anthropic은 Opus 5를 입력/출력 백만 토큰당 $5/$25로 책정하며, 이는 Astra 기본 토큰 요금의 절반입니다.
Claude Fable 5.1은 예산형 대안이 아닙니다. 이 Astra의 대표 요금과 동일하며, 선택된 지식 및 장기 추론 평가에서는 Fable 5.1이 우세합니다.
DeepSeek V4 Flash는 완전히 다른 비용 등급입니다. 공식 피크/오프피크 요금은 프리미엄 모델보다 훨씬 낮지만, 토큰 비용이 낮다고 해서 동일한 에이전트 성공률이 보장되지는 않습니다.
최상의 프로덕션 지표는 보통 “승인된 완료 작업당 비용”입니다. 재시도, 도구 실패, 지연 시간, 출력 토큰 사용량, 인간 재작업을 포함하세요.
GPT-6 Astra API란?
OpenAI는 GPT-6 Astra를 복잡한 엔드투엔드 작업을 위한 플래그십 모델로 포지셔닝합니다. API 사양에는 1,050,000-token 컨텍스트 윈도우와 128,000-token 최대 출력, 텍스트 및 이미지 입력, reasoning-token 지원, 그리고 다섯 가지 reasoning-effort 설정: low, medium, high, xhigh, max 가 포함됩니다.
Astra는 장시간 실행을 위해 설계되었다는 점에서 일반적인 챗봇과 다릅니다. 공식 기능 개요는 소프트웨어 엔지니어링, 브라우징, 과학, 사이버보안, 복잡한 추론과 함께 컴퓨터 사용 및 전문 업무를 강조합니다.
are repriced for the entire request at $20/M input and $75/M output. Budget these requests separately.
팀들이 GPT-6 Astra 외의 선택지를 찾는 이유
Astra는 추가 역량으로 인해 실패한 시도, 도구 오류, 수동 개입, 더 약한 모델의 반복 호출을 제거할 때 가장 매력적입니다. 요약, 추출, 분류, 일상적인 RAG, 일반 채팅, 표준 코드 생성에는 프리미엄 가격을 정당화하기 어렵습니다.
따라서 팀은 비용 절감, 기존 공급자 생태계 유지, 캐시 경제성 개선, 멀티모달 지원 추가, 혹은 루틴 트래픽에는 더 빠른 모델을 쓰고 Astra는 에스컬레이션용으로 남기기 위해 대안을 평가합니다.
벤치마크 비교와 한계
증거 노트: 표는 OpenAI가 공개한 비교 프레임워크를 사용해 여러 대안을 공통 설정하에서 배치했습니다. 이 벤더 보고 점수는 모델 스냅샷, 프롬프트, 도구, 평가 방법론에 따라 변할 수 있습니다. 이를 후보 단축을 위한 참고로 사용하고, 최종 후보는 대표적인 프로덕션 작업으로 검증하세요.
Benchmark
GPT-6 Astra
GPT-5.6 Sol
Claude Fable 5.1
Claude Opus 5
Gemini 3.8 Flash
Terminal-Bench 4.0
57.9%
37.3%
55.8%
52.6%
19.1%
DeepSWE v1.1
74.1%
72.7%
67.4%
73.7%
73.8%
FrontierCode 1.1 Extended
64.5%
60.6%
63.6%
63.6%
56.3%
GPQA Diamond
96.0%
94.6%
93.7%
93.7%
95.3%
FrontierMath Tier 4
97.6%
83.0%
87.8%
73.2%
—
Humanity’s Last Exam, with tools
57.2%
—
65.0%
63.6%
—
이 결과는 어떤 모델도 보편적인 “Astra 대체”가 아님을 보여줍니다. Astra는 여러 에이전트형·과학적 평가에서 확실한 우위를 보이며, Fable 5.1은 Humanity’s Last Exam에서 더 높은 성능을 보이고, DeepSWE에서는 몇몇 대안이 매우 근접합니다.
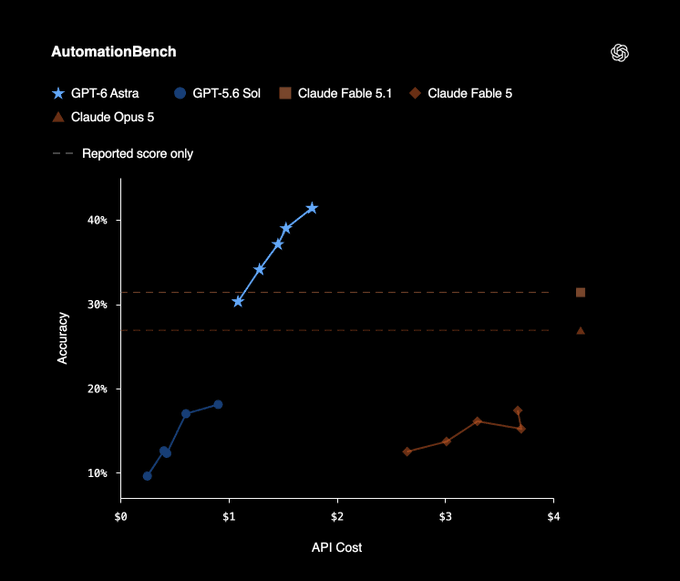
공식 OpenAI AutomationBench 벤치마크 그래픽.
공개 벤치마크 지수는 방법론과 모델 스냅샷이 갱신되면 바뀔 수 있습니다. 후보를 추리는 용도로 사용하되, 워크로드별 평가를 대체해서는 안 됩니다.
GPT-6 Astra 대안
모든 워크로드에서 Astra를 완전히 대체하는 단일 모델은 없습니다. 가장 실용적인 선택은 필요한 역량, 이미 사용하는 공급자 생태계, 실패나 재실행 비용에 따라 달라집니다.
Alternative
Official input / output price per 1M tokens
Context
Best reason to choose it
Claude Opus 5
$5 / $25
1M
최전선에 근접한 종합 프리미엄 대체
Claude Fable 5.1
$10 / $50
1M
가장 어려운 추론과 장기 실행 에이전트
GPT-5.6 Sol
$4 / $20
1.05M
OpenAI 마이그레이션 마찰 최소화
Claude Sonnet 5
$2 / $10
1M
대규모 프로덕션 작업
Gemini 3.8 Flash
$0.75 / $3.75 promotional
1M
저비용 멀티모달 및 배치 워크로드
DeepSeek V4.1 Flash
$0.22–$0.44 / $0.66–$1.32
1M
최소 토큰 비용과 대량 처리
Claude Opus 5
고려 이유
Claude Opus 5는 프리미엄급 추론, 코딩, 전문 업무 성능이 필요하지만 Astra보다 낮은 리스트 요금을 원하는 경우 첫 번째 대안입니다.
가격, 컨텍스트, 캐시
Anthropic은 Claude Opus 5를 입력/출력 백만 토큰당 $5/$25, 1M 토큰 컨텍스트로 제공합니다. 프로덕션 예산 책정 전 최신 캐시 조건을 확인하세요.
강점
코딩, 분석, 전문 글쓰기, 에이전트 워크플로에서 경쟁력 있습니다. 인용된 벤치마크 표에서 DeepSWE와 FrontierCode에서 Astra와 근접합니다.
한계
Astra를 일관되게 능가하지는 않습니다. 컴퓨터 조작, 고급 자율 실행, 사이버보안, OpenAI 네이티브 도구가 제품의 핵심이면 Astra가 더 강력한 후보입니다.
적합 / 비권장
적합: 프리미엄 코딩 에이전트, 복잡한 분석, 전문 글쓰기. 비권장: 워크플로가 Astra 고유 도구나 컴퓨터 사용 능력에 크게 의존할 때.
Claude Fable 5.1
고려 이유
Claude Fable 5.1은 저비용 대체가 아니라, 가장 어려운 추론·리서치·코딩·장기 에이전트 작업을 위한 경쟁 플래그십입니다.
가격, 컨텍스트, 캐시
입력/출력 $10/$50 요금은 Astra와 동일합니다. 1M 토큰 컨텍스트와 $0.25/M 캐시 읽기는 대규모 프롬프트 재사용 시 경제성을 개선할 수 있습니다.
강점
지속적 추론과 캐시 중심 에이전트에 특히 매력적입니다. 인용된 비교에서 Humanity’s Last Exam(with tools)에서 Astra보다 앞섭니다.
한계
대표 토큰 요금을 낮추지 못하며, 여러 에이전트형·과학 벤치마크와 OpenAI 네이티브 툴링에서는 Astra가 우위를 유지합니다.
적합 / 비권장
적합: 최대 수준의 추론 품질과 반복적 장문 컨텍스트 워크플로. 비권장: 표준 토큰 요금을 크게 낮추는 것이 1차 목표일 때.
GPT-5.6 Sol
고려 이유
GPT-5.6 Sol은 OpenAI 호환 동작과 도구를 기반으로 한 애플리케이션에서 마찰이 가장 적은 마이그레이션 경로를 제공합니다.
가격, 컨텍스트, 캐시
인용된 사양은 입력/출력 $4/$20, 1.05M 컨텍스트 윈도우, 128K 최대 출력을 제시합니다. 최종 예산 전 캐시 입력 조건을 확인하세요.
강점
DeepSWE와 GPQA Diamond에서 Astra에 근접하면서 표준 단문 컨텍스트 구간에서는 상당히 저렴합니다.
한계
Terminal-Bench와 FrontierMath로 대표되는 작업에서는 격차가 커질 수 있어, 더 약한 작업 완료로 인한 재시도나 수동 수정이 비용 절감을 상쇄할 수 있습니다.
적합 / 비권장
적합: 기존 OpenAI 애플리케이션과 Astra의 최강 에이전트 능력이 불필요한 일반 워크로드. 비권장: Astra의 큰 벤치마크 격차가 반복적으로 도움이 되는 워크로드.
Claude Sonnet 5
고려 이유
Claude Sonnet 5는 모든 요청에 플래그십이 필요하지 않은 유능하고 반복 가능한 지식 업무의 실용적 프로덕션 기본값입니다.
가격, 컨텍스트, 캐시
영구 요금은 입력/출력 $2/$10, 1M 컨텍스트 윈도우입니다. 프롬프트 재사용이 많은 배포에서는 최신 캐시 조건을 확인하세요.
강점
티켓 분류, 문서 추출, 표준 RAG, 콘텐츠 변환, 코드 설명, 루틴 함수 호출, 구조화 생성에 적합합니다.
한계
모든 장기·최전선 추론 문제에서 Astra를 안정적으로 대체하지는 못합니다.
적합 / 비권장
적합: 대량 프로덕션 트래픽과 일상적 비즈니스 자동화. 비권장: 어려운 에이전트형 작업 실패가 플래그십 모델 프리미엄보다 더 비싼 경우.
Gemini 3.8 Flash
고려 이유
Gemini 3.8 Flash는 문서·미디어·코딩·배치 파이프라인을 위한 멀티모달 입력, 대형 컨텍스트, 낮은 호스팅 API 비용을 결합합니다.
가격, 컨텍스트, 캐시
도입 프로모션 요금은 2026-12-31까지 입력/출력 $0.75/$3.75이며, 1M 컨텍스트와 프로모션 기간 중 할인된 캐시가 제공됩니다.
강점
멀티모달 추출, PDF, 오디오, 비디오, 이미지, 대규모 문서 컬렉션, 배치 분석, 비용 민감 코딩 워크로드에 적합합니다.
한계
프로모션 요금은 기간 제한이 있으며, 가장 어려운 자율 에이전트나 컴퓨터 사용 작업은 Astra 대비 워크로드별 검증이 여전히 필요합니다.
적합 / 비권장
적합: 저비용 멀티모달 및 대량 배치 처리. 비권장: 토큰 비용과 무관하게 가장 강력한 자율 실행이 필요한 경우.
DeepSeek V4.1 Flash
고려 이유
DeepSeek V4.1 Flash는 고스루풋 추론, 코딩, 요약, 추출, 분류, 오프라인 처리에서 비용 우선 옵션입니다.
가격, 컨텍스트, 캐시
공식 피크/오프피크 스케줄은 캐시 적중 입력 $0.007–$0.014/M, 캐시 미스 입력 $0.22–$0.44/M, 출력 $0.66–$1.32/M, 1M 컨텍스트를 제시합니다. 게시 전 최신 V4.1 가격 페이지를 재확인하세요.
강점
토큰 비용이 지배적이고, 라우팅·검증·오프라인 품질 점검으로 변동성을 관리할 수 있는 애플리케이션에 매력적입니다.
한계
훨씬 낮은 토큰 가격이 동일한 자율 작업 성공을 보장하지는 않습니다. 신뢰성, 도구 동작, 지연 시간, 승인율은 대상 워크로드에서 측정해야 합니다.
적합 / 비권장
적합: 검증을 동반한 대규모 비용 민감 처리. 비권장: 토큰 절감보다 한 번의 고가치 자율 실행 실패가 더 큰 손실인 경우.
GPT-6 Astra vs 대안: 카테고리별 최적 모델은?
가격, 아키텍처, 컨텍스트, 벤치마크 근거를 종합하면, 단순 순위보다 유용한 결정 표가 됩니다.
Category
Best choice
Why
Overall Astra alternative
Claude Opus 5
Astra 리스트 가격의 절반으로 최전선에 근접한 종합 성능
Maximum reasoning
Claude Fable 5.1
플래그십급 추론과 강력한 장기 추론 성능
Stay inside OpenAI
GPT-5.6 Sol
유사한 API 생태계에 60% 낮은 토큰 요금
High-volume production
Claude Sonnet 5
$2/$10의 견고한 품질
Multimodal price/performance
Gemini 3.8 Flash
1M 컨텍스트와 매우 낮은 2026 도입 프로모션 가격
Lowest API cost
DeepSeek V4.1 Flash
입력 $0.22–$0.44, 출력 $0.66–$1.32
Computer-use-heavy agents
GPT-6 Astra
Astra의 가장 명확한 차별화 요소 중 하나
Scientific and difficult mathematical workflows
GPT-6 Astra
매우 강한 FrontierMath 및 과학 에이전트 결과
Cache-heavy long agents
Claude Fable 5.1
$0.25/M 캐시 읽기
가장 중요한 결론은 GPT-6 Astra가 여전히 일부 카테고리에서 승리한다는 점입니다. 더 저렴하다고 해서 보편적 대체가 가능하다고 암시해선 안 됩니다. Astra를 전면 배치하면 비싸지만, 더 약한 모델의 여러 시도를 대체할 만큼 작업 완료율이 높다면 오히려 경제적일 수 있습니다.
GPT-6 Astra API를 대체하면 실제로 얼마나 절감할 수 있나요?
캐시 할인, 도구 요금, 재시도, 배치 가격, 장문 컨텍스트 할증을 무시하고, 100만 개의 비캐시 입력 토큰과 20만 개의 출력 토큰을 소비하는 워크로드를 가정해 봅시다:
지연 시간, 작업 성공, 재시도율, 도구 호출 오류, 인간 에스컬레이션 비율과 함께 이 수치를 추적하세요.
CometAPI로 GPT-6 Astra 대안을 테스트하는 방법
멀티 모델 API 레이어의 실용적 이점은 평가가 공급자 통합 프로젝트가 될 필요가 없다는 점입니다. CometAPI는 하나의 모델 카탈로그로 GPT-6 Astra API, GPT-5.6, Claude Fable 5.1, Claude Sonnet 5, Gemini 3.8 Flash, DeepSeek V4.1 Flash를 제공합니다.
OpenAI 호환 클라이언트로 모델을 하드코딩하지 않고 구성 가능하게 만들 수 있습니다:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

model = "claude-fable-5-1"

response = client.chat.completions.create(
    model=model,
    messages=[
        {
            "role": "user",
            "content": "이 마이그레이션 계획을 검토하고 위험이 가장 큰 가정을 세 가지 식별하세요.",
        }
    ],
)

print(response.choices[0].message.content)