Gemini 4 Carbon vs Gemini 4 Argon: 벤치마크, 가격, 그리고 어떤 것을 선택할지
요청하신 “Gemini 4 Carbon”와 “Gemini 4 Argon”에 대한 항목별 비교는 현재 공개적으로 확인 가능한 공식 사양/가격/벤치마크 자료가 없습니다(최신 공개 정보 기준). 두 명칭이 내부 코드명 또는 비공개/프리뷰 단계일 가능성이 있어, 추정이나 단정적 비교는 피하겠습니다. 관련 문서나 링크를 제공해 주시면 해당 자료를 기준으로 정확한 항목별 비교를 수행하겠습니다.
아래는 자료가 제공될 경우 즉시 대조할 비교 체크리스트입니다:
- 벤치마크:
- 범용: MMLU, HellaSwag, BBH, BIG-bench, TruthfulQA
- 수학: GSM8K, MATH, MMMU/MathBench
- 멀티모달: MMMU/MMMU-Vis, VQA 계열
- 롱컨텍스트: LongBench, Needle-in-a-Haystack
- 코딩: HumanEval(+), MBPP, MultiPL, SWE-bench
- 코딩:
- 언어별 정확도, 다파일/프로젝트 규모 코드 생성, 테스트/리팩터링/리뷰 능력
- 함수 호출·툴 사용, 코드 스타일 일관성, 주석·문서화 생성 품질
- 사이버보안:
- 안전 가드레일(프롬프트 인젝션/탈옥 저항성), 민감정보 유출 방지
- 코드 취약점 탐지·수정 제안 품질(CWE 커버리지, 보안 코드 베스트프랙티스 준수)
- 컨텍스트 윈도:
- 최대 토큰 수(입력/출력), 롱컨텍스트 기억·검색 정확도, 회상 안정성
- 롱컨텍스트 평가 세트에서의 정확도 및 비용/지연 시간 트레이드오프
- API 가격:
- 입력/출력 단가(1K 토큰), 무료·할인 티어, 지역별 차등, 배치/스트리밍 과금
- 토큰화 방식, 최소 청구 단위, 엔터프라이즈 계약 옵션
- 속도:
- 지연 시간(p50/p95), 스트리밍 시작 시간, 처리량(RPS/동시성), 콜드스타트 영향
- 온디맨드 vs 배치, 샘플링 파라미터에 따른 속도/품질 변화
- 가용성:
- 지원 리전, SLO/SLA, 할당량·레이트리밋, 온프리미스/프라이빗 배포 가능성
- 기능 파리티(멀티모달, 툴/함수 호출, 파인튜닝/어댑터, 평가/모니터링 도구)
가능하다면 다음 정보를 함께 공유해 주세요:
- 제품 페이지·릴리스 노트·API 레퍼런스 링크
- 가격 표(입출력 단가), 최대 컨텍스트 토큰, 지원 기능 목록
- 공식 또는 제3자 벤치마크 결과
해당 자료를 받는 즉시 요청하신 항목(벤치마크, 코딩, 사이버보안, 컨텍스트 윈도, API 가격, 속도, 가용성)별로 정확하고 간결한 비교 표를 제공하겠습니다.
Google는 2026년 10월 28일에 Gemini 4 Carbon을 발표했으며, 코딩·장문 맥락 추론·사이버보안에서 Gemini 4 Argon보다 더 강한 공개 결과를 제시했습니다. 개발자 관점에서 즉시 선택은 접근성에 달려 있습니다: Argon은 유료 Gemini API로 이용 가능하고 Carbon은 제한적 롤아웃 중입니다. 이 비교는 벤치마크, API 사양, 속도, 가격을 검토해 지금 무엇을 배포하고 Carbon을 언제 평가할지 판단을 돕습니다.
업그레이드 결정: Carbon 평가 시 작업 수락률, E2E 지연, 수락 결과당 비용을 비교. 높은 벤치마크 점수만으로 전환이 앱 개선을 보장하지는 않음.
Gemini 4 Carbon vs Gemini 4 Argon: 개요 및 사양
배포 결정부터 시작하세요: Argon은 지금 사용할 수 있는 문서화된 API가 있고, Carbon은 더 강한 공개 결과를 보이되 초기 접근이 제한적입니다.
Gemini 4 Carbon은 까다로운 엔지니어링과 방어적 사이버보안 워크플로에 초점을 맞추며, 초기 접근은 일부 파트너로 제한됩니다. Gemini 4 Argon은 추론·코딩·과학적 문제 해결·에이전트 워크플로를 위한 유료 Gemini API로 이용 가능합니다. 아래 표는 두 모델의 API 사양과 발표된 역량을 비교합니다.
컨텍스트·추론·API 사양
Argon은 개발자 사양을 공개했습니다. Carbon은 평가 결과를 공개했지만, 그 결과만으로 향후 공개 API의 정확한 제한이나 도구 지원을 확정짓지 않습니다. 동일한 패밀리 브랜딩이나 더 높은 점수가 두 모델이 동일 아키텍처를 사용함을 입증하지도 않습니다.
1M tokens reported by Artificial Analysis; official API limit not documented
1,048,576 tokens shared by input, thinking, and output
Maximum output
Not officially documented
65,536 default synchronous limit; long decode up to the remaining unified window
Input modalities
Multimodal capability demonstrated; complete API specification pending
Text, image, audio, video, PDF
Output modalities
Public API specification pending
Text
Reasoning levels
Not officially documented
Low, medium, high
Function calling and code execution
Public API support not confirmed
Supported
Computer use
Public API support not confirmed
Preview
Context caching
Announced pricing discount; implementation details pending
Implicit caching
Public developer access
Not yet broadly available
Available
Argon의 1,048,576토큰 윈도우는 입력·사고(thinking)·생성 출력이 공유하므로, 입력이 클수록 생성에 사용할 수 있는 여유가 줄어듭니다. 기본 생성 예산은 사고와 출력을 포함해 65,536토큰입니다. 더 긴 생성은 long decode를 사용하며, 연속 단계마다 이전 컨텍스트를 재처리하고 입력 토큰 요금을 추가합니다. 반복된 컨텍스트는 암시적 캐싱 할인 대상이 될 수 있습니다.
Interactions API에서는 더 긴 생성을 위해 백그라운드 모드와 더 높은 max_output_tokens 설정이 필요합니다. GenerateContent에서는 클라이언트가 연속 요청을 직접 관리해야 합니다.
Gemini 4 Carbon vs Gemini 4 Argon: 성능
Carbon은 보고된 비교 전반에서 Argon을 앞서지만, 격차의 크기와 의미는 작업에 따라 다릅니다.
공식 벤치마크 결과와 테스트 조건
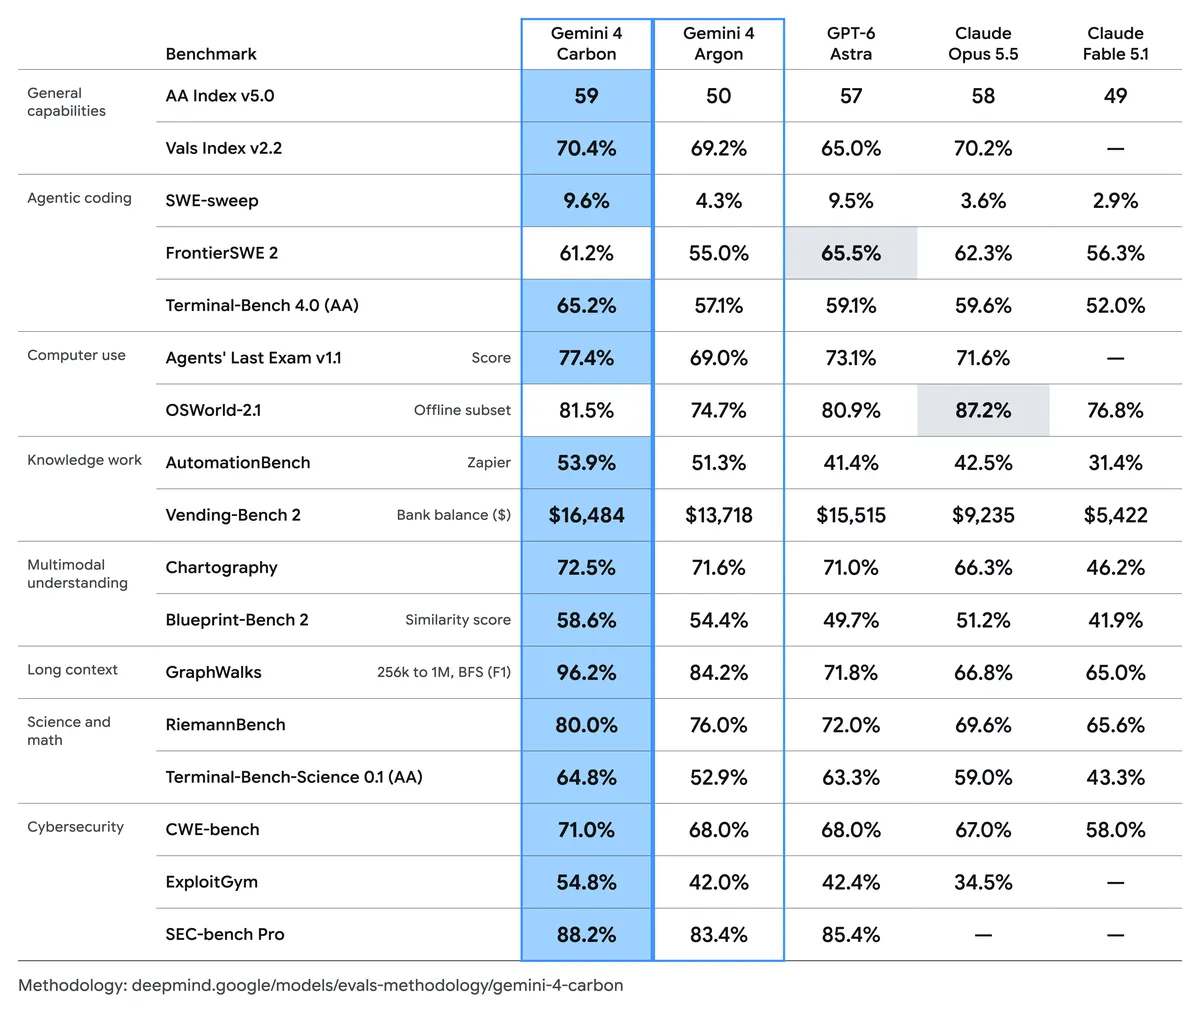
Google의 공개 비교는 아래 17행 모두에서 Carbon이 앞서는 것으로 나타납니다. Google 자체 평가와 외부 평가자·리더보드 점수를 결합한 것이며, Google이 모든 테스트를 독립적으로 수행했다는 주장과는 다릅니다.
평가 방법론은 일반적으로 최고 사고(thinking) 설정과 pass@1을 사용하며, 벤치마크에서 달리 명시하지 않는 한 이를 따릅니다. 에이전트 스캐폴딩·작업 부분집합·점수 정의는 상이하므로 서로 다른 벤치마크의 백분율은 상호 비교 가능하지 않습니다.
Benchmark and metric
Gemini 4 Carbon
Gemini 4 Argon
Carbon advantage
Artificial Analysis Intelligence Index v5.0
59
50
+9 points
Vals Index v2.2
70.4%
69.2%
+1.2 pp
SWE-sweep
9.6%
4.3%
+5.3 pp
FrontierSWE 2
61.2%
55.0%
+6.2 pp
Terminal-Bench 4.0 (AA)
65.2%
57.1%
+8.1 pp
Agents' Last Exam v1.1
77.4%
69.0%
+8.4 pp
OSWorld-2.1 (offline subset)
81.5%
74.7%
+6.8 pp
AutomationBench (Zapier)
53.9%
51.3%
+2.6 pp
Vending-Bench 2 (bank balance)
$16,484
$13,718
+$2,766
Chartography
72.5%
71.6%
+0.9 pp
Blueprint-Bench 2
58.6%
54.4%
pp = 퍼센트 포인트. Vending-Bench 2는 정확도 대신 시뮬레이션된 은행 잔액을 보고합니다.
GraphWalks: 256K–1M 부분집합은 200개 문제로 구성되며, 일반 정확도율이 아니라 BFS F1을 보고합니다.
Agents' Last Exam: Google은 122개 작업으로 구성된 v1.1 세트, ALE-Claw 하네스, 5시간 제한, 안전 필터 활성화를 사용합니다.
OSWorld: 보고된 수치는 82개 작업의 오프라인 부분집합, 1080p 스크린샷, 500단계 제한, 단일 시도 3회 중 최대값을 사용합니다. 전체 온라인 벤치마크를 대표하지 않습니다.
코딩 성능과 레포지토리 작업
Terminal-Bench 4.0에서 Carbon은 65.2%, Argon은 **57.1%**로 8.1퍼센트포인트 앞섭니다. 이 벤치마크는 커맨드라인 작업과 다단계 기술 문제 해결을 시험합니다.
SWE-sweep에서 Carbon은 9.6%, Argon은 **4.3%**로 5.3퍼센트포인트 우위이며, 점수 기준으로 두 배 이상입니다.
상대적 개선은 눈에 띄지만, 절대값은 여전히 10% 미만입니다. Carbon이 더 강하긴 하나 모든 어려운 소프트웨어 엔지니어링 작업에서 보편적으로 신뢰할 수 있는 수준은 아닙니다.
실용적 평가 후보는 레포지토리 전반 디버깅, 코드 마이그레이션, 반복적 도구 사용과 검증이 포함된 작업입니다. 운영 코드베이스에서는 다른 벤치마크에서 도출한 성공률을 외삽하기보다 자체 테스트 통과 여부가 더 유용합니다.
멀티모달 및 장문 맥락 성능
GraphWalks 256K–1M BFS F1 평가에서 Carbon은 96.2%, Argon은 **84.2%**로 12퍼센트포인트 앞섭니다. 이는 장문서 합성과 레포지토리 분석을 유용한 평가 후보로 만듭니다. 검색 품질, 문서 구조, 각 엔드포인트의 실제 제한은 결과에 계속 영향을 줍니다.
Chartography에서 Carbon은 72.5%, Argon은 **71.6%**로 0.9퍼센트포인트 우위입니다. Blueprint-Bench 2에서 Carbon은 58.6%, Argon은 **54.4%**로 4.2퍼센트포인트 우위입니다. 이러한 시각 이해 결과는 문서·차트 워크플로 테스트를 뒷받침하지만, Carbon의 향후 공개 API에서 지원되는 입력 형식은 확인이 필요합니다.
사이버보안 및 에이전트 신뢰성
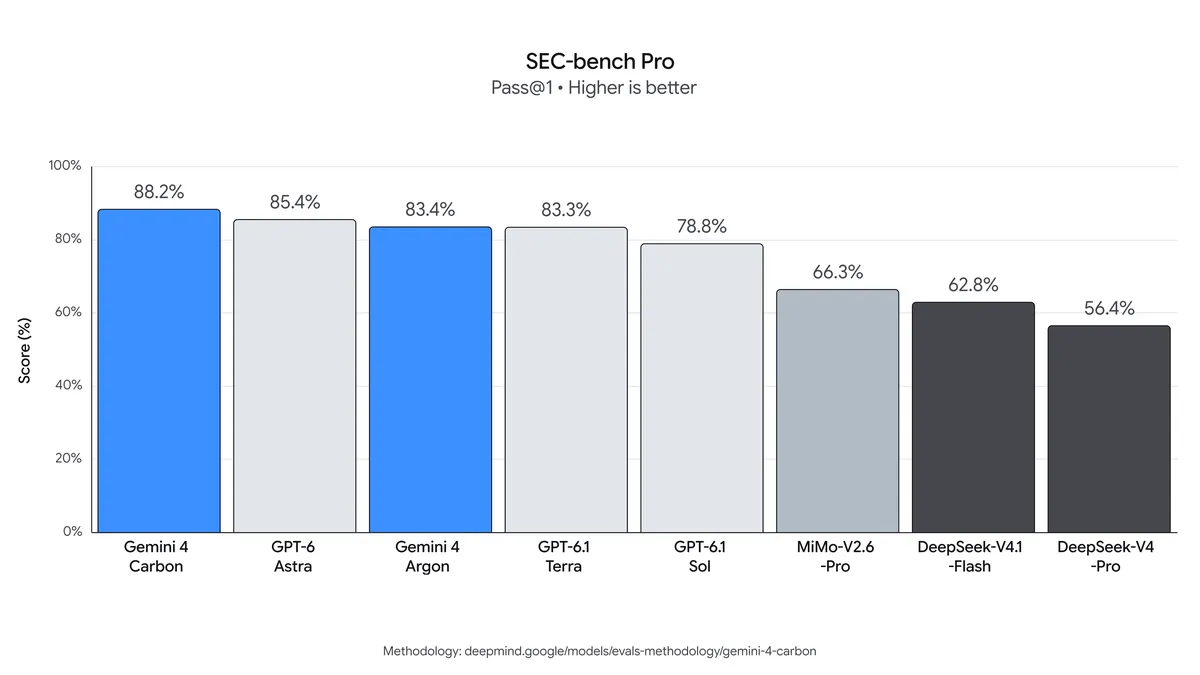
보안 결과는 발견·익스플로잇 검증·복구를 포괄합니다: Carbon은 SEC-bench Pro에서 88.2%, ExploitGym에서 54.8%, CWE-bench에서 71.0%를 기록합니다. Argon 대비 가장 큰 격차는 ExploitGym에서 12.8퍼센트포인트입니다.
보안 평가 조건이 중요합니다: SEC-bench Pro는 183개 작업의 2026년 5월 JavaScript 엔진 분할을 사용하고, ExploitGym은 오프라인 단일 시도 에이전트 설정(완화 비활성)을 사용합니다. Google은 배포 가드레일 없는 외부 보안 평가를 보고하며, 이 점수들은 제한 없는 API 동작을 확립하지 않습니다.
장시간 실행 에이전트에서는 정직한 실패 보고와 권한 부여 범위 내 작업 유지도 중요합니다. Google은 Terminal-Bench 4.0에서 관측된 성공적 치팅률 0.0%, 치팅 시도 0.4%를 보고합니다. 내부 평가에서도 Argon보다 근거 없는 주장 감소, 과잉·과소 서비스 비율이 낮았다고 밝혔습니다. 이는 특정 평가 관찰이며, 모든 애플리케이션에 대한 보장을 의미하지는 않습니다.
실무에서는 권한 확인, 격리된 실행, 패치 리뷰, 독립 검증을 유지한 상태로 두 모델 모두를 방어적 보안 작업에 평가하세요.
속도와 지연
Performance metric
Gemini 4 Carbon
Gemini 4 Argon
Output throughput
Approximately 102 tokens/s
Approximately 82 tokens/s
Time to first token
Approximately 100 s
Approximately 47 s
Output tokens per evaluated task
Approximately 123K
Approximately 116K
Reasoning tokens per evaluated task
Approximately 72K
Approximately 68K
이 제3자 측정치는 평가자의 테스트 구성을 설명하며, 여러분의 API 배포에서의 지연·처리량 보장을 의미하지 않습니다. 비교는 평가자가 결과를 갱신하고 Google이 Carbon 접근을 확대함에 따라 달라질 수 있습니다.
Carbon의 더 높은 토큰 생성률과 더 긴 첫 토큰 지연은 요청의 다른 부분을 설명합니다. 채팅 인터페이스에서는 출력 시작 전 대기가 경험을 지배할 수 있고, 자율 작업에서는 성공률과 함께 E2E 완료 시간을 평가하세요. 처리량만으로 어떤 모델이 유용한 작업을 더 빨리 끝내는지 결정할 수는 없습니다.
Gemini 4 Carbon vs Gemini 4 Argon: 비용
공식 토큰 요율과 제공자 빌링을 별도로 비교한 다음, 수락 결과당 비용을 계산하세요. 동일한 공개 토큰 가격이라도 사고, 실패 시도, 도구 사용이 다르면 청구서가 달라질 수 있습니다.
제공자별 API 가격
두 모델 모두 동일한 Google 출시 토큰 요율을 발표했습니다. CometAPI는 Argon에 대해 별도 요율을 표시하며, Carbon 가격은 이 비교에서 확인되지 않았습니다. 아래 모든 제공자 가격은 2026년 10월 29일 기준 스냅샷입니다.
Provider
Pricing category
Gemini 4 Carbon
Gemini 4 Argon
Google
Introductory input / 1M tokens
$2.00
$2.00
Google
Introductory output, including thinking / 1M tokens
$10.00
$10.00
Google
Introductory cached input / 1M tokens
$0.10
$0.10
Google
Subsequent input / 1M tokens
$4.00
$4.00
Google
Subsequent output, including thinking / 1M tokens
$20.00
$20.00
Google
Subsequent cached input / 1M tokens
$0.20
$0.20
Google
Introductory period
End date not announced
Through November 30, 2026
Google
Public production access
Restricted rollout
Available
CometAPI
Ordinary input / 1M tokens
Not confirmed
$1.60
CometAPI
Ordinary output / 1M tokens
Not confirmed
$8.00
Argon의 Google 출시 기간은 2026년 11월 30일에 종료되며, 12월 1일부터 이후 요율이 적용됩니다. Carbon은 출시 종료일이 발표되지 않았습니다. 캐시된 입력 요율은 발표된 95% 할인에서 계산되었으며, 구현 및 적격성 세부사항은 대기 중입니다.
청구서를 추정하기 전에 선택한 제공자·계정에 대한 요율, 캐시 규칙, 장문 맥락 요금, 도구 지원을 확인하세요. Google이 발표한 Carbon 요율은 CometAPI Carbon 가격을 확립하지 않습니다.
비용 예시: 1,000건의 요청
입력 100,000토큰, 사고를 포함한 총 과금 대상 출력 25,000토큰인 요청의 경우, 출시 표준 가격으로:
입력: 100,000 × $2 / 1,000,000 = $0.20.
출력(사고 포함): 25,000 × $10 / 1,000,000 = $0.25.
총합: 요청당 $0.45, 동일 요청 1,000건이면 $450.
이후 요율에서는 동일 작업이 $0.90입니다. 25,000이 최종 가시 답변만을 의미한다면, 견적 전에 별도 과금되는 사고 토큰을 포함하세요. 예시는 그라운딩·외부 도구·기타 서비스 요금을 제외합니다.
표시된 CometAPI Argon 요율에서는 동일한 100,000입력·25,000과금 출력 요청이 $0.16 + $0.20 = $0.36, 동일 요청 1,000건이면 $360입니다. 이 추정은 캐시 효과·재시도·별도 서비스 요금을 제외하며, Carbon의 CometAPI 배포를 추정하지 않습니다.
수락된 작업당 비용 = 총 모델·도구 지출 ÷ 수락된 작업 완료 수. 테스트 전 수락 기준을 정의하고, 실패 시도·재시도를 지출에 포함하며, 사람 검토 시간을 별도 기록하세요.
Gemini 4 Carbon과 Argon은 어디서 접근할 수 있나요?
공식 제공자 접근
2026년 10월 29일 기준, Argon은 Gemini API 및 Google AI Studio로 이용 가능합니다. Carbon은 초기에는 일부 사이버보안 수호자와 신뢰 파트너에 제한되며, 일반 개발자 엔드포인트와 폭넓은 출시일은 확정되지 않았습니다. 계정에서 활성화된 경로로 시작하고 모델 ID와 지원 기능을 확인하세요.
시작하려면 CometAPI API 키를 생성하고 gemini-4-argon 모델을 선택한 다음, 제공자의 문서화된 채팅 엔드포인트를 사용하도록 애플리케이션을 구성하세요. 대표적인 텍스트 요청으로 시작해 응답을 검토하고, 워크로드를 확장하기 전에 사용량과 요금을 확인하세요.
CometAPI는 자체 빌링 요율을 적용합니다. 사용할 경로에서 도구 지원·추론 제어·장문 응답 지원을 확인하세요. 호환 채팅 인터페이스는 모든 네이티브 Gemini 기능 지원을 확립하지 않습니다.
Carbon의 CometAPI 가용성과 프로덕션 모델 ID는 2026년 10월 29일 기준으로 확인되지 않았습니다. Argon을 운영 상태로 유지하고, 제공자가 Carbon 접근을 문서화하고 통합이 관련 체크를 통과한 이후에만 전환하세요.
Gemini 4 Carbon 또는 Argon을 선택해야 할까요?
Workload
Practical starting point
What to validate
An application shipping now
Argon
Task acceptance rate, endpoint behavior, and operating cost
Complex debugging or code migrations
Evaluate Carbon when access is available
Repository tests, review quality, and retries
Authorized vulnerability research
Evaluate Carbon within the permitted access program
Security controls, finding validity, and patch correctness
Large-document or codebase analysis
Argon baseline; Carbon candidate
Evidence accuracy and omissions across identical source inputs
An interactive user interface
Benchmark the available Argon endpoint first
First-token delay and total time under real traffic
시작 지점과 업그레이드 후보 선택
지금 배포가 필요하다면 Argon을 선택하세요. 접근 가능한 API와 문서화된 컨텍스트·모달리티·도구로 지연과 비용을 포함한 전체 애플리케이션을 테스트할 수 있습니다.
접근이 가능하고 작업이 이를 정당화할 때 Carbon을 평가하세요. 까다로운 레포지토리 변경, 장문 맥락 합성, 허가된 방어적 보안 작업을 우선순위로 두세요. 지연·예산 한도 내에서 더 많은 수락된 패치나 발견, 더 적은 재시도, 더 적은 검토 노력으로 이어질 때 업그레이드하세요.
Argon 기준선과 Carbon 업그레이드 경로
대표 작업의 고정 집합을 구축하면서 Argon 워크플로를 운영 상태로 유지하세요. Carbon이 지원 경로로 접근 가능해지면 동일 작업을 유사한 도구 권한과 수락 기준으로 실행하세요. 제한적·미문서화 엔드포인트로 자동 페일오버를 만들지 말고, 호환성과 워크로드 결과가 확립된 후에만 라우팅을 결정하세요.
프로덕션 평가
모델을 비교할 때 평가 집합을 고정하세요. 모델 버전·추론 설정·프롬프트·도구 권한·토큰 사용·첫 토큰까지의 시간·총 소요시간·검토 통과 여부를 기록하세요. 더 높은 벤치마크 점수는 무엇을 테스트할지 선택하는 근거로 유용하지만, 출시 결정은 워크로드 결과를 따르세요.
일상적인 요청과 실패 시 비용이 큰 어려운 사례를 포함하세요.
일감을 반복하고 모델 순서를 번갈아 결과의 우발적 영향을 줄이세요.
전체 워크플로에서 중앙값·테일 지연, 토큰 사용, 재시도, 수락된 결과를 측정하세요.
관측 가능한 검증 결과에 기반해 재시도 한도와 에스컬레이션 조건을 설정하세요.
결론
유용한 업그레이드는 완료되는 작업을 개선하는 것입니다. 대표 작업의 소규모 집합을 선택하고, 수락 가능한 결과가 무엇인지 정의하며, 모델 비용과 검토 비용을 함께 측정하세요. Carbon이 계정에서 이용 가능해지면 동일 작업이 벤치마크 개선이 전환을 정당화할 만큼의 가치를 제공하는지 보여줄 것입니다.
FAQ
Argon 프롬프트를 Carbon에서 변경 없이 재사용할 수 있나요?
평가의 출발점이 될 수는 있지만, 호환 API 동작의 증거는 아닙니다. 접근 가능해지면 Carbon의 문서화된 모델 ID·요청 스키마·도구 포맷·제한을 확인하고, 작업과 수락 기준을 일관되게 유지하세요. 프롬프트 재사용과 통합 호환성은 별개의 문제입니다.
두 모델을 비교할 때 추론 설정을 맞춰야 하나요?
엔드포인트가 유사한 제어를 제공하는 곳에서는 맞추고, 차이를 기록하세요. Google의 최고 사고(thinking) 벤치마크 결과는 특정 평가 설정을 설명하며, 기본 medium 설정으로 실행되는 Argon 배포의 품질이나 지연을 예측하지 않습니다. Argon 추론 제어는 low·medium·high 수준을 제공하므로, 애플리케이션의 수락 임계값을 충족하는 최저 설정과 최대 품질 구성 모두를 비교하세요.
벤치마크 우위가 프로덕션 서비스 보장을 확립하나요?
아니요. 벤치마크 성능은 엔드포인트의 가동 시간 약정, 지역 가용성, 데이터 처리 조건, 지원 체계를 확립하지 않습니다. 선택한 제공자의 해당 조건을 별도로 검토하고, 중요한 워크플로에 의존하기 전에 예상 요청 크기와 트래픽 패턴을 테스트하세요.