TL;DR: 복잡한 추論 품질과 시각 워크플로가 가장 중요할 때는 GPT-6.1 Terra가 더 강력한 출발점이며, 토큰 비용, 생성 속도, 자체 호스팅을 우선할 때는 DeepSeek V4.1 Flash가 매력적입니다. 본 비교는 DeepSeek의 10월 17일 업데이트(Flash-1017)를 기준으로 합니다.
552B Causal Encoder–Decoder MoE; 입력에 약 8B, 출력에 약 16B 활성 파라미터
컨텍스트 윈도우
1,050,000 tokens
1M tokens
최대 출력
128,000 tokens
384K tokens
입력 모달리티
Text, images
Text, images
출력 모달리티
Text
Text
추론 제어
none, low, medium, high, xhigh, max
생각 모드 토글; Chat Completions에서 low, high, max
도구 호출
Responses API를 통해 지원
지원됨; 엔드포인트와 생각 모드에 따라 동작
공개 가중치
No
Yes, MIT license
아키텍처와 모델 버전
Terra는 파라미터 수가 공개되지 않은 독점 아키텍처를 사용합니다. DeepSeek-V4.1-Flash는 Causal Encoder–Decoder MoE 아키텍처를 사용하며, 입력 처리와 출력 생성에서 서로 다른 활성 파라미터 예산을 둡니다.
DeepSeek의 V4.1 Flash 릴리스는 552B 파라미터의 Causal Encoder–Decoder 혼합 전문가(MoE) 백본을 설명하며, 입력 처리 시 약 8B, 출력 생성 시 약 16B 파라미터가 활성화됩니다. 10월 17일 업데이트는 공개된 코딩, 에이전트, 비전 결과를 개선했습니다.
본 문서 전반에서 Flash-1017은 해당 10월 체크포인트를 의미합니다. 일반 API 별칭은 이후 다른 버전을 가리킬 수 있으므로, 평가 기록에는 실제로 제공된 모델 버전을 포함해야 합니다.
KV 캐시와 배포 요건
DeepSeek는 전역 KV 캐시 풋프린트가 토큰당 약 890바이트로, DeepSeek-V4-Flash의 약 4분의 1이라고 보고합니다. 이는 캐시 효율을 개선하지만, 자체 호스팅 시 여전히 모델 가중치를 위한 상당한 자원이 필요합니다. Terra는 호스팅 서비스로 제공되는 반면, DeepSeek의 다운로드 가능한 가중치는 추가적인 자체 호스팅 옵션을 제공합니다.
추론 제어와 도구 호출
두 모델은 에이전트 워크플로를 지원하지만, 추론 제어와 도구 호출 요건은 다릅니다. Terra의 문서화된 도구 호출 지원은 Responses API를 사용합니다. DeepSeek의 모델 카드는 1부터 100까지의 숫자형 추론 노력 설정을 설명하며, 호스팅 API 제어는 별도 확인이 필요합니다. 모델을 전환할 때는 선택한 엔드포인트에 맞추어 추론 파라미터와 도구 정의를 조정하십시오.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: 성능
아래 비교는 추론, 코딩, 비전, 장문맥 작업을 다룹니다. 독립 평가와 벤더 발표 벤치마크를 구분해 제시하며, 모델 구성과 에이전트 프레임워크와 함께 해석합니다.
Terra의 더 높은 총합 점수는 고난도 추론 작업에서 먼저 테스트할 근거가 됩니다. 특정한 좁은 작업에는, 요구 정확도를 더 낮은 성공 작업당 비용으로 충족한다면 DeepSeek가 더 나은 선택일 수 있습니다.
공식 코딩 및 에이전트 벤치마크
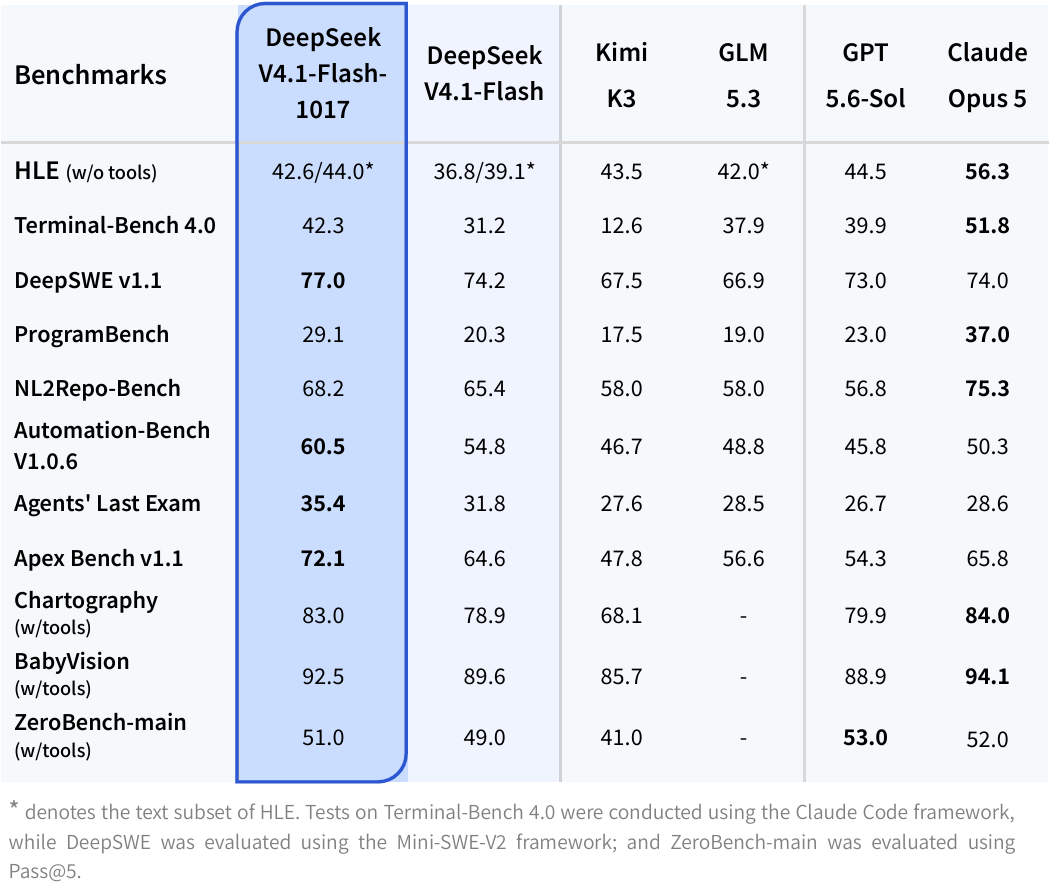
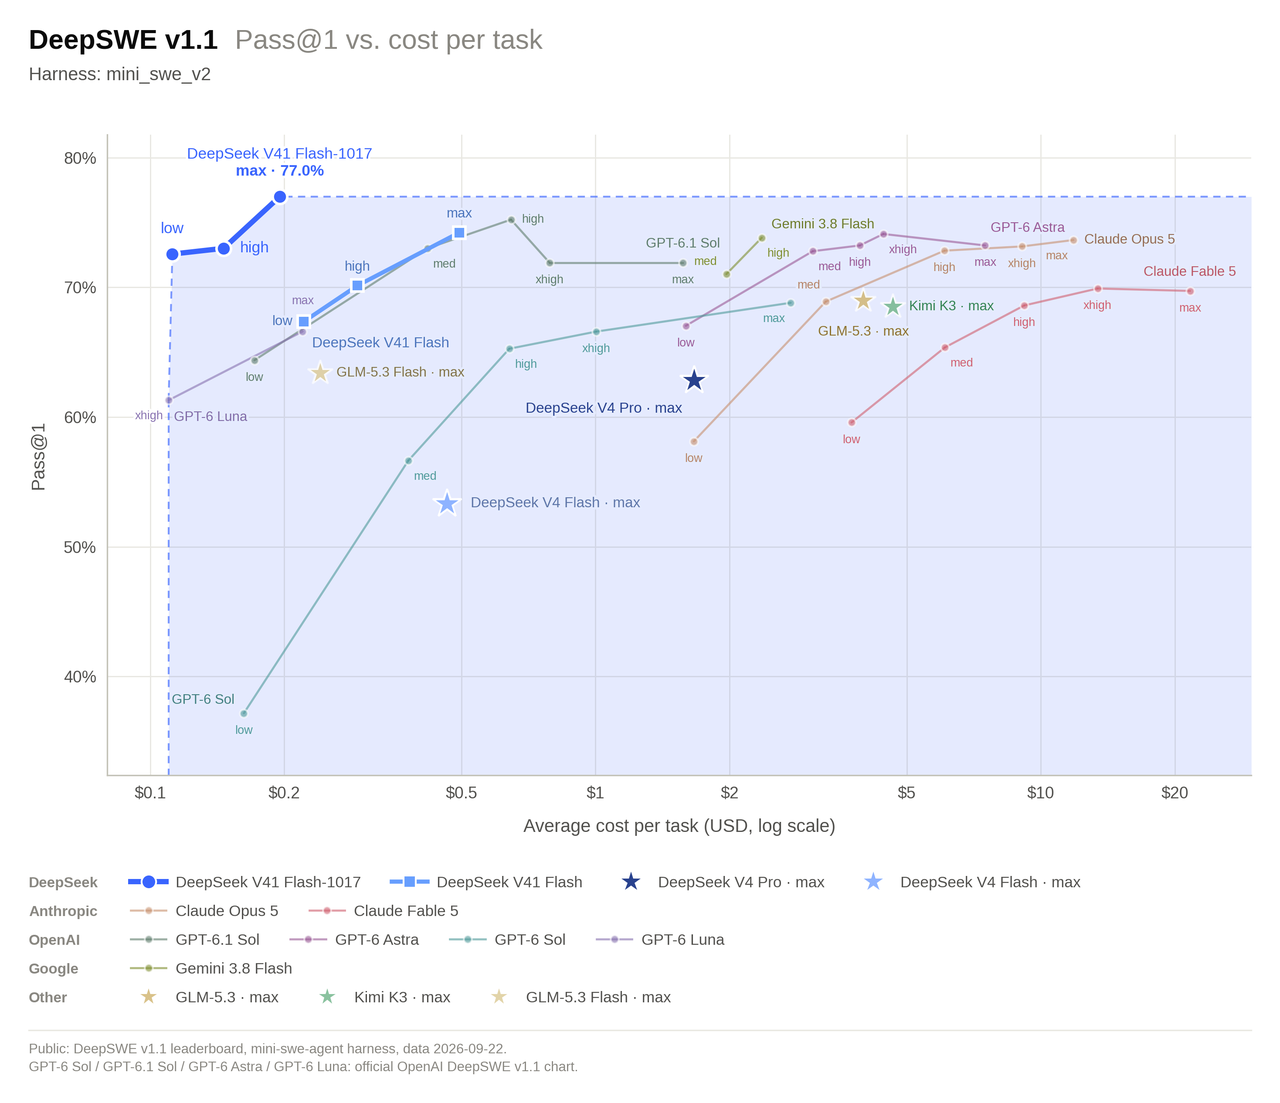
Terminal-Bench 4.0과 DeepSWE v1.1은 코딩 및 에이전트 성능에 대한 근거를 제공합니다. 벤더 결과를 비교할 때, 정확한 모델 버전, 추론 설정, 에이전트 프레임워크, 채점 지표를 명확히 하십시오. 이러한 설정 차이는 점수에 중대한 영향을 줄 수 있습니다.
실무 코딩에서는 각 모델이 기존 테스트를 통과하는 패치를 산출하는지, 공개 인터페이스를 보존하는지, 엣지 케이스를 다루는지, 불필요한 변경을 피하는지 비교하십시오. 도구 호출의 신뢰성과 실행 오류에서의 복구 능력도 에이전트가 완료할 수 있는 작업량에 영향을 줍니다.
DeepSeek의 낮은 공시 토큰 단가는 명확한 승인 기준이 있는 반복적 리포지토리 유지보수에 유용한 후보입니다. 복잡한 변경에는, 승인된 패치, 성공한 작업당 총비용, 그리고 인간 보정 시간을 두 모델 간 비교하십시오.
비전과 컴퓨터 사용
두 모델 모두 이미지 입력을 수용하지만, 이미지 이해와 데스크톱 상호작용에는 서로 다른 역량이 필요합니다. OpenAI의 Terra 출시 자료는 MMMU-Pro와 OSWorld 2.1을 언급하며, DeepSeek의 모델 카드는 Chartography와 BabyVision 등 도구 보조 설정의 시각 과제를 보고합니다.
문서 추출에서는 필드 정확도, 누락 텍스트, 표 구조를 비교하십시오. 데스크톱 자동화에서는 완료된 워크플로, 잘못된 동작, 인터페이스 변경 이후 복구를 비교하십시오. 스크린샷을 정확히 설명하는 모델이라도 해당 애플리케이션을 조작하는 데에는 어려움을 겪을 수 있습니다.
워크플로에 따라 선택하십시오: 문서 처리에는 추출 정확도가 가장 중요하며, 컴퓨터 사용 에이전트에는 신뢰할 수 있는 동작과 복구 능력이 더 중요합니다. 두 모델이 요구 품질 기준을 충족한 이후에야 비용을 비교하십시오.
장문맥 추론과 검색
두 모델은 장문서 워크플로를 지원하지만, 컨텍스트 용량만으로 검색 품질이 결정되지는 않습니다. 동일한 문서 컬렉션에서 중요한 근거를 앞/중/뒤 위치에 배치해 비교하십시오.
답변 정확도, 근거 구절, 문서 간 일관성, 응답 완전성을 평가하십시오. 연구와 문서 분석에서는, 지연 시간과 비용 요건 내에서 관련 근거를 안정적으로 검색하고 연결하는 모델을 선호하십시오.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: 속도
출력 처리량과 작업 완료 시간
지연 시간은 추론 품질과 별도로 다루어야 합니다.
2026년 10월 28일 Artificial Analysis 페이지에서, Flash-1017 (Max) 출력 속도는 초당 173.4 토큰, Terra (Max) 출력 속도는 초당 90.9 토큰으로 표시됩니다. 이 측정치는 평가자의 제공 구성에 대한 설명이며, 모든 제공자에서 보장되는 속도가 아닙니다.
더 빠르게 토큰을 생성하는 모델도, 더 많은 추론을 생성하거나 도구 응답을 기다리거나 재시도하면 끝내는 데 더 오래 걸릴 수 있습니다. 첫 토큰까지의 시간, 총 완료 시간, 승인된 작업의 지연 시간을 별도로 측정하십시오.
사용자 경로에서의 대화형 지연
대화형 제품의 경우, 현실적인 동시성에서 짧은/긴 프롬프트를 테스트하고 중앙값과 95퍼센타일 지연을 기록하십시오. 지역, API 경로, 프롬프트 캐싱, 추론 설정, 재시도 정책을 결과에 포함하십시오. 이 기록은 단일 초당 토큰 수치보다 사용자 경험을 더 잘 보여줍니다.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: 비용
가격은 두 모델 간 가장 뚜렷한 차이 중 하나입니다.
Terra 요금표와 DeepSeek 가격 정책은 2026년 10월 28일 확인된 다음의 1차 요금을 제시합니다. 모든 가격은 백만 토큰당 미화 기준입니다.
공식 API 요금
토큰 범주
GPT-6.1 Terra Standard
DeepSeek Flash 오프피크
DeepSeek Flash 피크
입력, 캐시 미스
$1.00
$0.15
$0.30
입력, 캐시 히트
$0.05
$0.003
$0.006
출력
$5.00
$0.60
$1.20
DeepSeek 피크 요금은 월요일–금요일, UTC 01:00–04:00 및 06:00–10:00에 적용되며, 중국 공휴일은 제외됩니다. 이는 중국 표준시(UTC+8) 기준 09:00–12:00 및 14:00–18:00입니다. 그 외 시간에는 오프피크 요금이 적용됩니다.
Terra에서 272,000 입력 토큰을 초과하는 요청의 경우, OpenAI는 전체 요청에 대해 입력 및 캐시된 입력 요금 2×, 출력 요금 1.5×를 지정합니다. 기준 가격을 유효 가격으로 간주하기 전에 실제 프롬프트 크기와 이 조건을 비교하십시오.
CometAPI 요금
CometAPI 백만 토큰당 기준 요금
GPT-6.1 Terra API
DeepSeek V4.1 Flash API
비캐시 입력
$0.80
$0.12
출력
$4.00
$0.48
캐시된 입력
별도 명시 없음
$0.0024
시간대 가중치
기준 요금에 명시 없음
지정된 피크 시간에 2×
CometAPI는 DeepSeek의 피크 시간을 월요일–금요일 UTC 01:00–04:00 및 06:00–10:00로 표기합니다. 표기된 일정은 DeepSeek 1차 정책과 같은 공휴일 예외를 설정하지 않습니다. 예정 실행 시간에 선택한 경로의 청구 조건을 확인하십시오.
고정 토큰 비용 예시
비캐시 입력 토큰 100,000개를 소모하고 출력 토큰 10,000개를 생성하는 요청을 고려해 봅시다.
이것이 청구되는 토큰의 전체 합이라면, 토큰 요금은 Terra가 $0.150, DeepSeek 오프피크가 $0.021, DeepSeek 피크가 $0.042입니다. 오프피크 절감률은 86%입니다. 예시는 추가 도구 요금, 인프라, 재시도를 제외합니다. 별도로 계산되는 추론 토큰이 있다면 역시 계산에 포함되어야 합니다.
CometAPI 기준 요금을 적용하면, 동일한 100,000 입력과 10,000 출력 토큰의 비용은 Terra $0.120, Flash $0.0168입니다. 표기된 2× 피크 가중치를 적용하면 Flash는 $0.0336가 됩니다. 이는 명시된 토큰 수를 사용한 토큰 기반 계산일 뿐이며, 실제 작업의 측정치는 아닙니다.
추가 출력이 토큰 단가 이점을 상쇄하는 시점
비캐시 입력 100,000 토큰을 유지하고, Terra의 총 청구 출력이 10,000 토큰이라고 합시다. Terra의 표준 토큰 청구액은 $0.150입니다. Flash는 오프피크 기준으로 225,000 청구 출력 토큰, 피크 기준으로 100,000 청구 출력 토큰에서 동일한 청구액에 도달합니다. 이 산술은 출력량만을 고립해 비교합니다. 캐싱, 반복 입력, 도구 요금, 재시도는 비교를 변화시킵니다.
성공한 작업당 비용
고정 배치의 작업을 평가하고, 모든 청구된 API 및 도구 지출을 승인 기준을 통과한 작업 수로 나누십시오. 실패한 시도에 쓴 비용도 포함하십시오. 쉬운 작업만 완료해 모델이 보상받지 않도록 이 비용과 함께 성공률을 보고하십시오.
성공한 작업당 비용 = 총 API 및 도구 비용 / 성공적으로 완료된 작업 수
무엇을 선택할까: GPT-6.1 Terra 또는 DeepSeek-V4.1-Flash?
작업의 품질 요구, 비용 목표, 배포 필요에 따라 선택하십시오. 위의 벤치마크 결과를 활용해 어떤 모델을 먼저 시험할지 결정하십시오.
사용 사례
시작 후보
선택을 좌우할 요소
고난도 추론
GPT-6.1 Terra
대표적 어려운 작업에서의 정확도와 보정 작업량
코딩 에이전트
둘 다 테스트
승인된 패치, 회귀 검증, 도구 실패, 총비용
복잡한 시각 워크플로
GPT-6.1 Terra
완료된 워크플로와 인터페이스 오류에서의 복구
대량 텍스트/이미지 추출
DeepSeek Flash-1017
추출 정확도가 요구 임계값을 충족하는지
장문서 검색
둘 다 테스트
입력 위치 전반에서의 근거 검색과 답변 정확도
자체 호스팅
DeepSeek Flash-1017
가용 하드웨어, 운영 비용, 가중치에 대한 통제
대화형 애플리케이션
둘 다 테스트
선택한 제공 경로에서의 중앙값 및 꼬리 지연
GPT-6.1 Terra를 선택할 때
복잡한 추론이 작업의 핵심일 때 Terra를 우선 평가하십시오. 고난도 비전 또는 컴퓨터 사용 워크플로에서는 테스트 세트에 포함해 완료 작업 수, 오류, 복구를 측정하십시오.
핵심 질문은 Terra가 실패 시도와 수작업 보정을 얼마나 줄여 더 높은 토큰 가격을 정당화하는가입니다.
DeepSeek-V4.1-Flash를 선택할 때
명확한 승인 기준과 빡빡한 비용 목표가 있는 반복적·대량 작업에는 DeepSeek-V4.1-Flash로 시작하십시오. 출력이 요구 품질을 더 낮은 성공 작업당 비용으로 충족한다면 이를 선택하십시오.
DeepSeek의 MIT 라이선스 가중치는 자체 호스팅이 요구될 때 적합한 옵션입니다. 그 결정에는 하드웨어와 운영 비용을 포함하십시오.
두 모델을 모두 테스트할 때
코딩 품질, 도구 신뢰성, 지연, 장문서 정확도가 중요할 때는 두 모델을 모두 테스트하십시오. 동일 입력, 도구, 실행 한도, 승인 기준으로 대표 작업을 사용하십시오.
성공 완료율, 성공한 작업당 총비용, 끝단까지의 지연, 인간 보정 시간을 비교하십시오. 결과가 재현되도록 모델 버전과 추론 설정을 기록하십시오.
하이브리드 구성은 DeepSeek로 일상 작업을 시작하고, 선택된 실패를 Terra로 승급할 수 있습니다. 추가 모델 호출이 가치 있는지 전체 워크플로의 비용과 완료율을 측정해 확인하십시오.
접근 방법: GPT-6.1 Terra와 DeepSeek V4.1 Flash
Terra는 OpenAI의 호스팅 API, Flash는 DeepSeek의 호스팅 API를 사용하십시오. 통합 전에 현재 모델 식별자, 계정 한도, 지원 엔드포인트를 확인하십시오. Flash-1017의 다운로드 가능한 가중치는 별도의 자체 호스팅 옵션을 제공합니다.
CometAPI를 통한 접근
CometAPI는 멀티 모델 애플리케이션 개발을 단순화할 수 있는 OpenAI 호환 인터페이스를 제공합니다.
하나의 텍스트 클라이언트로 두 모델을 시험하려면, CometAPI 키와 https://api.cometapi.com/v1 엔드포인트를 사용해 OpenAI Python SDK를 사용하십시오. 키는 환경 변수에 보관하고, 동일한 프롬프트를 gpt-6.1-terra와 deepseek-v4.1-flash 라우트에 전송해 반환된 답변과 토큰 사용량을 비교하십시오.
예를 들어, 타임아웃된 요청을 idempotency key 없이 재시도하고 전체 요청 본문을 로깅하는 결제 워크플로 검토를 각각의 모델에 요청해 보십시오. 답변이 신뢰성 및 프라이버시 위험을 얼마나 명확히 식별하고 실용적 수정을 설명하는지 비교하십시오. 공용 프롬프트는 응답을 비교하기 쉽게 하지만, 기본 텍스트 요청은 추론 예산을 동등화하거나 성능 순위를 확립하지 않습니다. 각 라우트가 제공한 체크포인트를 확인한 뒤에야 해당 결과를 Flash-1017에 대한 근거로 간주하십시오.
결론
GPT-6.1 Terra는 현재 종합 추론 결과가 더 강력하고, DeepSeek Flash-1017은 더 낮은 토큰 가격, 더 빠른 측정 출력 생성, 오픈 가중치 배포를 결합합니다. 유용한 선택은 품질과 지연 요구를 가장 낮은 총비용으로 충족하는 모델입니다.
대표 작업 세트로 시작해, 도구 환경과 승인 기준을 고정하고, 성공 완료의 비용을 비교하십시오. CometAPI의 공용 텍스트 통합은 이 평가를 쉽게 만들 수 있지만, 모델별 기능은 여전히 별도 구성이 필요합니다.
FAQ
왜 동일한 작업이 Terra와 Flash-1017에서 서로 다른 토큰 청구를 만들 수 있나요?
텍스트 프롬프트가 두 모델에서 동일한 토큰 수가 되리라 보장되지 않습니다. 생성된 답변과 추론 길이도 다를 수 있습니다. 두 가격표를 하나의 추정 토큰 수에 적용하기보다, 동일 작업에 대해 각 라우트가 보고한 사용량(캐시 및 과금되는 추론 토큰 포함)을 비교하십시오.
GPT-6.1 Terra와 DeepSeek V4.1 Flash가 프롬프트 캐시를 공유할 수 있나요?
애플리케이션에서 프롬프트 텍스트를 재사용할 수는 있지만, 한 모델이나 제공자를 위해 생성된 캐시가 다른 쪽의 청구액을 줄인다고 가정하지 마십시오. 캐시 적격성과 회계는 경로별로 다릅니다. 각 응답의 사용량 필드를 확인하고 반복 요청을 테스트한 뒤에야 절감 효과를 예측에 반영하십시오.
Terra와 Flash-1017의 구조화 출력은 어떻게 검증해야 하나요?
모델 선택 전에 애플리케이션에서 필요한 필드와 타입을 정의하십시오. 라우트가 JSON 또는 스키마 제약 출력을 제공한다면, 지원하는 정확한 모드를 확인한 뒤 응답을 파싱하고 스키마에 대해 검증하십시오. 누락 필드, 잘못된 값, 출력 잘림, 거부를 별도 결과로 취급하십시오. 유효한 JSON만으로 추출된 사실의 정확성이 보장되지는 않습니다.