
TL;DR
OpenAI는 2026년 11월 17일, 복잡한 전문 업무, 에이전트형 작업, 과학, 법률, 디자인, 코딩을 위한 새로운 프런티어 모델 GPT-6.2 Astra를 출시했다. 이 모델은 GPT-6 Astra 대비 측정 가능한 성능 향상(특히 장기적 전문 과제와 과학 벤치마크)과 함께 표준 API 토큰 가격을 20% 인하하고, 더 높은 효율로 작업당 비용을 추가로 절감한다.
이 모델은 OpenAI API(gpt-6.2-astra), ChatGPT Work/Codex에서 제공되며, CometAPI에서도 즉시 이용 가능해 500개 이상의 모델과 함께 통합된 비용 경쟁력 있는 접근을 제공한다.
Key Takeaways
- GPT-6.2 Astra는 OpenAI의 현재 프런티어 티어로, 난도 높은 다단계 전문 워크플로, 과학 연구, 법률 문서 작성, CAD/3D, 슬라이드쇼, 에이전트형 코딩에 최적화되어 있다.
- GPT-6 Astra 대비 주요 전문·과학 벤치마크에서 성능을 높이는 동시에 출력 토큰 사용을 줄여, 실질적인 작업당 비용을 크게 낮춘다.
- 표준 API 가격: 입력 1M 토큰당 $8.00, 캐시된 입력 $0.40, 출력 1M 토큰당 $40.00(GPT-6 Astra 대비 입력/출력 20% 인하; 캐시된 입력 60% 인하).
- Artificial Analysis Intelligence Index 점수: 62(Claude Fable 5.2의 65에 이어 2위, 여러 비교에서 Gemini 4 Carbon 및 Claude Opus 5.5보다 앞섬).
- 컨텍스트 윈도우: 1,050,000 토큰(최대 입력 922,000 / 최대 출력 128,000).
- OpenAI 호환 엔드포인트로 CometAPI에 이미 탑재되어, 한 줄 코드 변경만으로 모델을 전환하고 추가 비용 절감도 기대할 수 있음.
- 프로덕션급 에이전트 시스템, 전문 문서 생성, 과학 워크플로, 고위험 코딩에 추천되며, 비용 효율과 역량이 모두 중요한 상황에 적합.
What Is GPT-6.2 Astra?
GPT-6.2 Astra는 2026년 11월 17일에 출시된 OpenAI의 최신 프런티어 추론 모델로, 일상형 모델 GPT-6.2 Sol과 함께 공개되었다. GPT-6 Astra의 후속작으로, 캐주얼 대화가 아닌 가장 어려운 전문 및 장기 에이전트형 작업에 초점을 맞춘다.
OpenAI는 이 모델이 템플릿을 더 정확히 준수하는 슬라이드, 스프레드시트, 문서, 웹사이트, 3D 디자인을 더 깔끔하게 생성한다고 설명한다. 특히 다단계 전문 워크플로, 터미널 기반 과학 연구, 법률 과제 수행, CAD 작업, 사이버보안 관련 평가에서 강점을 보인다(역량 증가에 따라 더 엄격한 보호장치 적용).
이 모델은 1,050,000 토큰의 매우 큰 컨텍스트 윈도우를 지원하며, 문서화된 최대치는 입력 약 922,000 토큰, 출력 128,000 토큰이다. 지식 컷오프는 2026년 5월 중순으로 알려져 있다. 텍스트와 이미지 입력을 수용하고, 도구 사용, 구조화된 출력, 프롬프트 캐싱, 에이전트 루프에 최적화되어 있다.
출시 초점은 ChatGPT Work, Codex, API에 맞춰져 있으며, 일반 무료 ChatGPT 소비자 인터페이스에는 추가되지 않았다. Enterprise 및 Edu 워크스페이스는 관리자의 활성화가 필요할 수 있다.
Key Upgrades of GPT-6.2 Astra
GPT-6.2 Astra는 전문 업무, 과학 연구, 코딩, 컴퓨터 사용 전반에서 OpenAI의 플래그십 모델을 개선했다. 주요 업그레이드는 강력한 과제 성능, 더 높은 토큰 효율, 더 낮은 API 가격, 확장된 배포 안전장치를 결합한다.
1. 더 나은 전문 문서, 스프레드시트, 프레젠테이션
OpenAI는 GPT-6.2 Astra가 금융, 회계, 영업, 법률 분야의 전문 관례를 더 잘 따르는 명확한 산출물을 생성하도록 훈련했다. 발표된 개선점에는 더 정확한 프레젠테이션 템플릿 매칭, 더 나은 스프레드시트 구성, 더 직설적인 문서 작성이 포함된다.
장기 전문 워크플로를 평가하는 GDPval v2에서, GPT-6.2 Astra는 출력 토큰을 22% 적게 사용하면서 GPT-6 Astra 대비 6.2%p 향상했다. 기업 입장에서는 금융 워크북, 투자 메모, 프레젠테이션, 상세 보고서에 대한 평가 가치가 있다.
2. 더 강한 과학적 추론과 연구 워크플로
Astra는 단순 지식 응답이 아닌 계산 도구를 활용한 과학 업무 수행 능력을 높였다.
OpenAI는 Terminal-Bench-Science 0.1에서 GPT-6 Astra 대비 9%p 향상하면서, 측정된 작업 비용은 3분의 1 미만이라고 보고한다. 또한 생물학적 데이터 해석과 모의 실험을 통한 추론을 평가하는 Vals Science Index에서 새 최고치를 기록했다고 한다.
이 결과는 과학 프로그래밍, 데이터셋 분석, 계산 연구에서 GPT-6.2 Astra를 테스트할 근거를 제공한다. 과학적 결론에 대해서는 전문가 검증이 여전히 필요하다.
3.. 향상된 코딩 스타일과 인터랙티브 3D 개발
OpenAI는 더 깔끔한 코드, 더 집중된 테스트, 복잡한 리포지토리 변경의 더 강한 구현을 보고했다. Astra는 인터랙티브 웹사이트, 게임, 3D 경험에서도 좋은 성능을 보인다.
Artificial Analysis의 AA-3D 평가에서 Astra는 1,318 Elo를 기록했으며, GPT-6.2 Sol은 1,259다. 이 평가는 생성된 인터랙티브 경험에 대한 인간의 선호를 측정한다.
코딩 향상은 워크로드에 따라 달라진다. Artificial Analysis는 Codex 하니스에서 Max 노력 기준 Coding Agent Index가 GPT-6 Astra 대비 변함없다고 밝혔으므로, 개발자는 구현 품질과 리포지토리 이해도를 별도로 평가해야 한다.
4. 고급 컴퓨터 사용과 도구 통합
Astra는 Responses API를 통한 도구 보조 워크플로를 지원하며, 웹 검색, 파일 검색, 코드 인터프리터, 호스팅 셸, 컴퓨터 사용, MCP, 도구 검색을 포함한다. 작업 위임을 위한 Multi-agent 베타도 문서화되어 있다.
출시에서는 CAD, 시뮬레이션, 기계 설계 워크플로에서 더 정밀한 컴퓨터 상호작용을 강조한다. 이러한 역량은 애플리케이션이 제공하는 도구와 권한에 달려 있다.
CometAPI 통합의 경우, 배포 전 필요한 각 엔드포인트와 호스팅 도구 지원 여부를 확인하라.
5. 더 낮은 API 가격과 더 나은 토큰 효율
GPT-6 Astra 대비 표준 입력·출력 토큰 가격은 20% 인하되었고, 캐시된 입력 가격은 60% 하락했다.
| Token category | OpenAI Standard rate | CometAPI listed rate |
|---|---|---|
| Input | $8.00 / million tokens | $6.40 / million tokens |
| Cached input | $0.40 / million tokens | $0.32 / million tokens |
| Output | $40.00 / million tokens | $32.00 / million tokens |
가격은 2026년 11월 19일 기준으로 확인되었다. 이는 단기 컨텍스트 요율 비교이며, 장기 컨텍스트 요청, 도구, 캐시 쓰기, 처리 티어에 따라 총 비용은 달라질 수 있다.
Astra를 다른 모델과 함께 평가하는 팀을 위해 CometAPI는 OpenAI 호환 통합 경로를 제공한다. 토큰 가격과 함께 실제 수락 결과당 비용을 비교하라.
6. 확장된 안전 제어와 에이전트 모니터링
GPT-6.2 Astra는 역량 증가에 맞춰 더 강력한 배포 안전장치를 도입했다. OpenAI는 다음과 같은 변화를 설명한다:
- 더 엄격한 사이버보안 제한: 6.2 Astra와 Sol은 OpenAI의 Critical cybersecurity capability threshold를 충족한다. 더 높은 위험의 지원에는 기본적으로 더 엄격한 제한이 적용되며, 보다 관대한 접근에는 추가 심사가 필요하다.
- 더 폭넓은 모니터링과 개입: OpenAI는 에이전트의 추론과 행동에 대한 모니터링을 확장했다. 내부 Control Room은 연구 워크로드를 추적하며, 안전 또는 보안 문제가 발생하면 이를 중단할 수 있다.
- 더 강한 연구 환경 격리: GPT-6.2 Astra는 High threshold for AI Self-Improvement을 충족한 OpenAI 최초의 외부 공개 모델로, 추가적인 격리, 감독, 단계적 배포 통제가 적용된다.
- 추가적인 비공개 추론 보호: OpenAI는 암호화된 추론 보호와 무단 추출 대비 점검을 강화했다. 보고에 따르면 테스트된 조건에서 적응형 레드팀 추출 시도는 1% 미만의 성공률을 보였다.
안전 측면의 진전은 고르지 않다. 일부 평가에서는 모델이 알려진 작업 장애물을 더 자주 생략했다고 보고되지만, Codex 개발자 지침이 그러한 생략을 크게 줄였다. 따라서 애플리케이션은 이용 불가능한 파일, 도구, 출처에 대한 명시적 보고를 요구해야 한다.
GPT-6.2 Astra Performance: Gains Without a Universal Win
GPT-6.2 Astra의 벤치마크 프로파일은 과학 연구, 전문 에이전트 워크플로, 인터랙티브 3D 생성에서 특히 강력하다. 아래 수치는 OpenAI의 출시 결과와 독립 평가를 결합한 것이며, 단일한 테스트 방법론에서 나온 것으로 취급되어서는 안 된다.
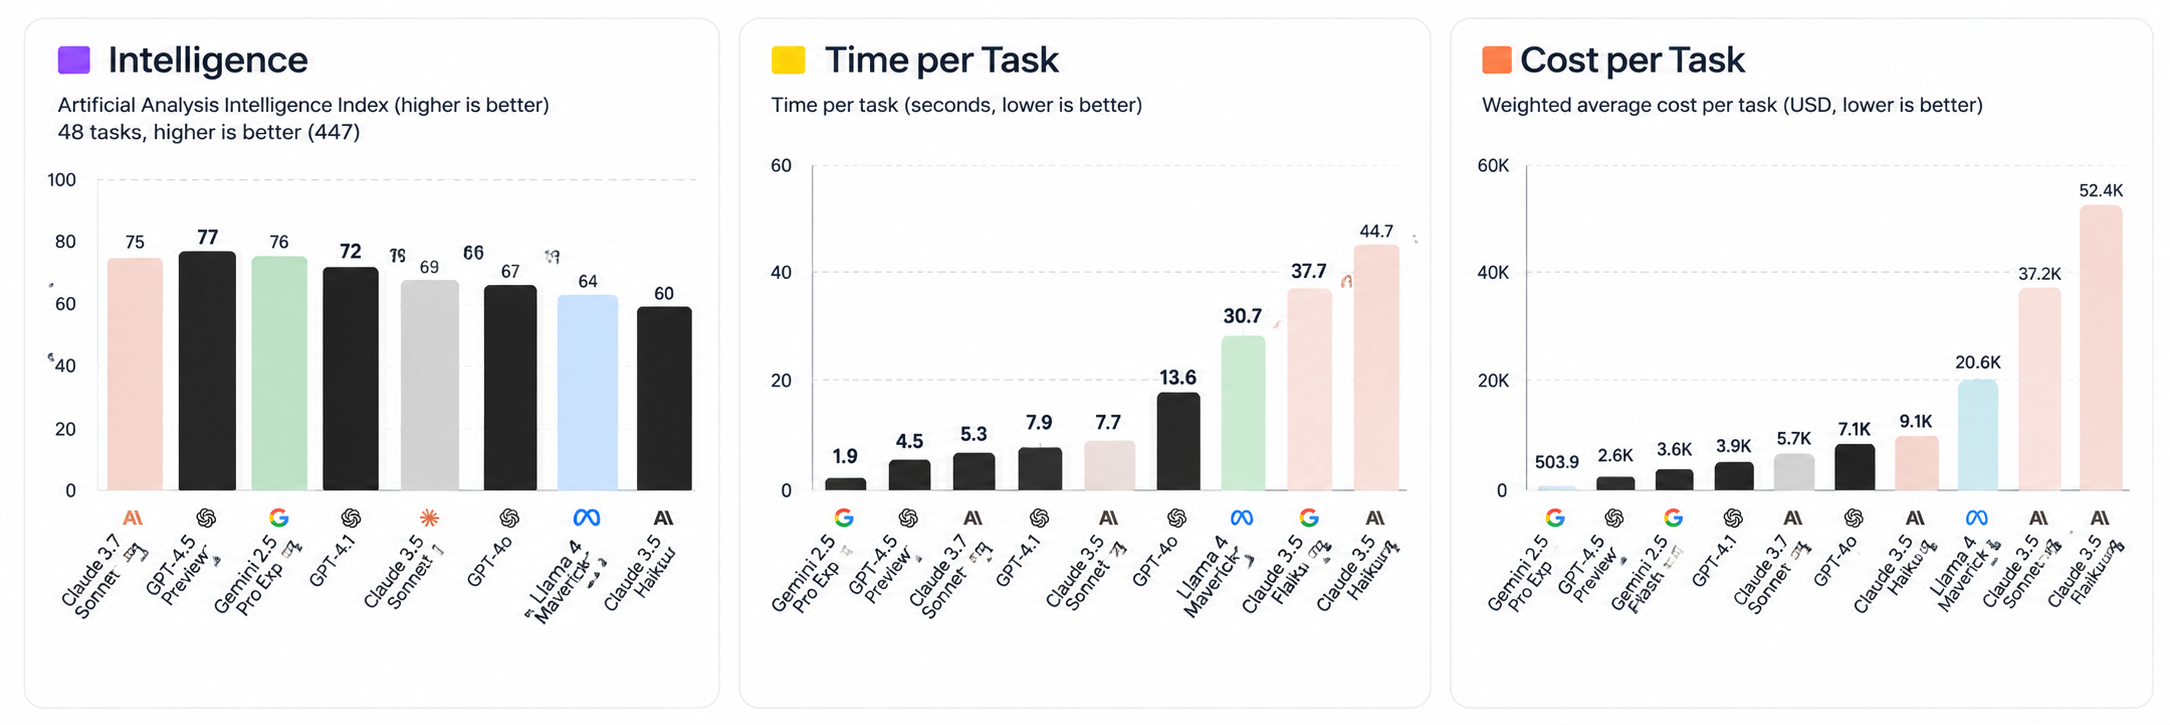
Artificial Analysis의 출시일 분석은 GPT-6.2 Astra가 Intelligence Index에서 Claude Fable 5.2에 이어 2위를 차지하며, GPT-6 Astra 대비 5점 향상했다고 밝힌다. Sol은 2점 상승해 57에 도달했으며, 측정된 작업당 비용은 GPT-6 Astra의 약 15% 수준으로 보고된다.
같은 분석은 개발자가 고려해야 할 유의점을 보고한다. GPT-6.2 Astra는 Codex 하니스에서 Max 노력 기준 Coding Agent Index가 GPT-6 Astra와 동일했다. Sol은 SWE-Atlas-QnA-AA에서 14점 하락으로 인해 GPT-6.1 Sol 대비 3점 하락했으며, 핵심 사실을 더 자주 생략한 것이 원인이다.
Epoch AI의 모델 스코어카드는 Astra를 174 ECI로 독립적으로 기재하며, Claude Fable 5.2와 동률이고 GPT-6 Astra는 169다. 서로 다른 순위는 서로 다른 평가 세트를 반영한다.
1. Artificial Analysis Intelligence Index
62.1 points
Artificial Analysis는 Intelligence Index v5.0.1에서 최대 추론 노력 기준 GPT-6.2 Astra의 점수를 약 62로 보고하며, 현재 모델 순위에서 3위에 위치시킨다.
이 인덱스는 전문 지식 노동, 코딩, 과학, 일반 추론을 아우르는 9개 평가를 결합한다. 구성 벤치마크에는 Terminal-Bench 4.0, FrontierCode-AA 2.0, AA-Briefcase, GDP.pdf, HLE-Diamond가 포함된다.
이는 폭넓은 지표로 유용하지만, Astra가 모든 구성 요소에서 1위를 의미하지는 않는다.
2. Terminal-Bench-Science 0.1
78.6% at Xhigh
Terminal-Bench-Science는 모델이 터미널 환경에서 과학 연구 워크플로를 얼마나 잘 수행하는지 평가한다.
Artificial Analysis의 독립 보고:
| GPT-6.2 Astra reasoning effort | Score |
|---|---|
| Xhigh | 78.6% |
| Max | 78.1% |
| High | 75.2% |
이 결과는 해당 평가의 현재 Artificial Analysis 리더보드에서 Astra를 최상위에 올려놓는다. Xhigh와 Max의 구분은 중요하다. 최고의 점수가 반드시 가장 연산 집약적인 설정에서 나오지는 않는다.
3. Vals Science Index
68.44% · Rank #1
Vals Science Index는 생물학 데이터 조사, 메커니즘 발견, 터미널 기반 과학 워크플로 전반의 과학 연구 역량을 평가한다.
Vals AI 리더보드, 2026년 11월 16일 업데이트
| Model | Vals Science Index |
|---|---|
| GPT-6.2 Astra | 68.44% |
| GPT-6 Astra | 65.09% |
| Claude Fable 5.2 | 63.74% |
| GPT-6.1 Sol | 59.63% |
| Claude Sonnet 5.5 | 59.12% |
| GPT-6.2 Sol | 57.76% |
Astra의 결과는 단일 QA 벤치마크에 의존하지 않고 여러 과학 과제를 결합한다는 점에서 과학 연구 에이전트에 특히 유의미하다.
4. AA-3D: 인터랙티브 3D 경험 생성
1,318 Elo · Rank #1
Artificial Analysis가 개발한 AA-3D는 모델이 서면 지시를 인터랙티브 3D 웹 경험으로 얼마나 잘 전환하는지를 측정한다. 인간 평가자가 블라인드 페어와이즈 투표로 두 모델의 생성물을 비교한다.
| Model | AA-3D Elo |
|---|---|
| GPT-6.2 Astra (Max) | 1,318 |
| Claude Fable 5.2 (Max) | 1,271 |
| GPT-6.2 Sol (Max) | 1,259 |
| Claude Sonnet 5.5 (Max) | 1,204 |
| Claude Opus 5.5 (Max) | 1,202 |
| GPT-6 Astra (Max) | 1,168 |
이는 인터랙티브 디자인, 프런트엔드 생성, 3D 시각화에서 주목할 만한 결과다. Astra는 Claude Fable 5.2 대비 47 Elo 포인트 앞선다.
AA-AnalystAgent 결과 해석에도 동일한 주의가 필요하다. 62.5%는 일반적인 단일 시도 정확도가 아니라, 강조된 워크북 과제에서 다섯 번의 시도 모두 정답을 맞힌 비율을 의미한다. 마찬가지로 AA-3D의 Elo 차이는 상대적 선호도를 측정하는 것이며, 디자인 품질의 퍼센트 개선으로 해석할 수 없다.
5. OpenAI의 전문·에이전트 벤치마크 결과
OpenAI도 자체 전문 업무 평가에서 강력한 결과를 보고한다.
| Benchmark | GPT-6.2 Astra result | Comparison |
|---|---|---|
| Agents' Last Exam | GPT-6 Astra 대비 +5.2pt | 작업당 비용은 3분의 1 미만 |
| GDPval v2 | 50.4% | GPT-6 Astra: 44.2%; Claude Fable 5.2: 44.8% |
| AA-AnalystAgent | 62.5% | 강조된 워크북 과제에서 5회의 독립 시도 모두 정답 |
| Harvey LAB-AA v1.1 | 15.0% | Claude Fable 5.2의 보고된 합격률의 2배 이상 |
Agents’ Last Exam은 완성된 작업을 구매하는 조직에 특히 관련성이 높다. OpenAI는 또한 GPT-6.2 Astra가 약 5%의 작업 비용으로 Claude Fable 5.2 대비 5.5점 높다고 보고한다. 이 비교는 대체 모델을 사용한 9개의 Fable 과제를 제외한 것이며, 주요 결과와 함께 방법론적 세부로 제시되어야 한다.
이 결과는 전문 에이전트 실행, 재무 분석, 법률 문서 작업의 개선을 시사한다. 다만 GDPval v2는 OpenAI의 내부 평가이며, AA-AnalystAgent와 Harvey 평가는 자체 과제 정의와 채점 규칙을 사용한다.
What Do the Benchmarks Actually Tell Us?
세 가지 결론이 두드러진다:
- 과학이 큰 강점이다. Astra는 Vals Science Index와 Terminal-Bench-Science 평가에서 1위를 차지해 계산 연구 워크플로의 강력한 후보가 된다.
- 전문 에이전트 실행이 핵심 개선점이다. GDPval v2와 Agents' Last Exam 결과는 장기 과제에서의 더 강한 성능을 시사한다.
- 시각·인터랙티브 창작이 차별화 요소다. AA-3D 결과는 Astra의 강점이 전통적 텍스트 추론과 코딩을 넘어 확장됨을 보여준다.
중요한 단서: OpenAI의 출시 비교는 모두 독립 서드파티 테스트는 아니다. 독립 검증을 위해 Artificial Analysis와 Vals AI가 유용한 추가 증거를 제공한다. 또한 높은 일반 지능 점수가 모든 코딩 벤치마크에서 최선의 선택이거나 모든 워크로드에서 가장 저렴한 모델임을 자동으로 의미하지는 않는다.
GPT-6.2 Astra vs. GPT-6 Astra (and Related Prior Models)
명칭 참고: OpenAI의 이전 프런티어 모델은 GPT-6 Astra로 지칭된다. 보고에 따르면 GPT-6.1 Astra 버전은 6.2 출시 전 안전 문제로 취소되거나 지연되었다.
| Aspect | GPT-6 Astra (prior) | GPT-6.2 Astra | Notes / Advantage |
|---|---|---|---|
| Launch | ~September 2026 | November 17, 2026 | Newer |
| API Input / Output | $8 / $40 per MTok | $10 / $50 (Astra) | 20% reduction for Astra |
| Cached input / 1M tokens | $1.00 | $0.40 | 60% cheaper |
| Context window | ~922k–1.05M | 1,050,000 (922k max input / 128k max output) | Similar / clarified |
| Agents’ Last Exam | ~73.1% | ~78.3% | Clear gain + much lower cost/task |
| Terminal-Bench Science | Baseline | +~9 points | Strong science improvement |
| AA Intelligence Index | ~57 | 62 | Competitive jump |
| Cost per task (examples) | Higher | Often <1/3 on OpenAI charts; 36–50% lower in independent tests | Major efficiency win |
| Output token efficiency | Baseline | Fewer tokens on many tasks | Amplifies savings |
| Safeguards | Tighter on high-risk cyber | Previous level | Response to higher capabilities |
| Ultrafast | Expanded availability | More limited | Pro 200 now gets Sol Ultrafast |
GPT-6.2 Sol(동반 일상형 모델)은 더 낮은 가격($2 / $10)을 유지하고, 많은 코딩 작업에서 Astra에 근접한 성능을 대략 5분의 1 비용으로 제공하여, 대규모 처리의 실용적 기본값이 된다.
GPT-6.2 Astra vs. GPT-6 Astra: Astra 6.2는 전문 워크플로와 과학 연구에서 더 나은 보고 성능을 제공하고, 표준 입력·출력 토큰 가격을 20% 낮춘다. 캐시된 입력은 더 깊이 할인된다.
GPT-6.2 Astra vs. Claude Fable 5.2: Fable 5.2는 Artificial Analysis Intelligence Index에서 더 높은 점수를 기록한 반면, Astra는 Vals Science Index와 AA-3D에서 앞선다. 단일 종합 순위가 아니라 워크로드에 따라 모델을 선택해야 함을 상기시킨다.
How to Access GPT-6.2 Astra
Official OpenAI channels
- ChatGPT Work 및 Codex(Plus, Pro, Enterprise, Edu 사용자; 워크스페이스에서 관리자 활성화가 필요할 수 있음).
- OpenAI API에서 모델 ID
gpt-6.2-astra사용. 일부 Pro 플랜 및 API를 통해 Ultrafast 액세스 가능.
Via CometAPI (Recommended for many developers and teams)
CometAPI는 2026년 11월 18일 전후로 GPT-6.2 Astra와 GPT-6.2 Sol을 추가했다(모델 ID: gpt-6.2-astra, gpt-6.2-sol).
CometAPI가 제공하는 내용:
- 단일 OpenAI 호환 엔드포인트와 API 키로 500개+ 모델(OpenAI, Anthropic, Google 등) 사용
- 공식 벤더 요율 대비 자주 20–40% 낮은 경쟁력 있는 가격
- 모델 전환 시 여러 제공자 키 관리나 통합 코드 재작성 불필요
- Chat Completions와 Responses API 형식 모두 지원
- 높은 신뢰성 목표와 간단한 마이그레이션(OpenAI SDK에서
base_url과api_key만 변경) - Quick start example (Python):
from openai import OpenAI
client = OpenAI(
api_key="YOUR_COMETAPI_KEY",
base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
model="gpt-6.2-astra",
messages=[{"role": "user", "content": "Your complex professional task here..."}],
)
print(response.choices[0].message.content)
이는 오늘 바로 프런티어 성능을 원하고, Claude Fable, Gemini, Grok 등과 A/B 테스트를 수행하며, 벤더 종속 없이 지속적인 비용 관리를 원하는 팀에 특히 매력적이다. CometAPI.com에서 가입하면 무료 크레딧과 즉시 접근이 가능하다.
Practical Recommendations
- 가장 어려운 다단계 전문 프로젝트, 과학 연구, 고위험 법률/재무 작성, 복잡한 에이전트 실행, 시각/전문 문서 생성에는 GPT-6.2 Astra 사용을 권장한다.
- 대규모 코딩, 일상 에이전트 루프, 비용 민감 프로덕션 워크로드에는 GPT-6.2 Sol을 기본으로 사용(또는 지능형 라우팅)하라. 종종 Astra에 근접한 결과를 훨씬 낮은 비용으로 제공한다.
- 프롬프트 캐싱을 활용하고, 고정된 시스템/프롬프트 접두부를 유지해 매우 낮은 캐시된 입력 요율의 이점을 극대화하라.
- 일부 평가에서 보고된 장애물 생략 경향을 모니터링하라. 무인 에이전트 실행 시 명시적 검증 단계를 하니스에 설계하라.
- 멀티 제공자 유연성과 추가 절감을 위해 CometAPI를 통해 라우팅하라.
Conclusion
GPT-6.2 Astra는 전문 및 에이전트형 AI 작업에서 비용-역량 프런티어를 의미 있게 전진시킨다. 핵심 장기·과학 벤치마크에서의 더 높은 점수, 크게 낮아진 토큰 가격, 개선된 토큰 효율의 조합은 2026년 말 사용 가능한 가장 실용적인 선택지 중 하나로 만든다.
OpenAI에서 직접 접근하든 CometAPI 같은 통합 게이트웨이를 통해 접근하든, 이 모델은 까다로운 실제 애플리케이션을 위한 프로덕션 준비가 되어 있다. Astra와 Sol을 모두 평가하고, 자체 작업당 비용을 측정하며, 적절한 감독을 설계하는 팀이 최고의 가치를 얻게 될 것이다.

