
TL;DR
DeepSeek-V4.1-Flash는 오픈 웨이트이며 자가 호스팅이 가능하지만, “로컬”이 “게이밍 PC에서”를 의미하진 않는다. DeepSeek는 이를 Causal Encoder-Decoder 아키텍처를 사용하는 552B-parameter Mixture-of-Experts 백본으로 설명하며, 프롬프트 처리 중에는 8B, 생성 중에는 16B의 파라미터만 활성화된다. 전체 모델은 여전히 프런티어급 배포를 전제로 한다.
현재 vLLM 배포 레시피 기준 체크포인트는 디스크 약 511 GB, 최소 VRAM 약 614 GB로 산정되므로, 소비자용 워크스테이션보다 H200 8장급 서버 또는 유사한 대용량 메모리 시스템이 현실적이다.
가중치 수준의 제어가 아니라 접근성만 필요하다면, CometAPI의 DeepSeek V4.1 Flash API가 멀티 GPU 추론 서버를 유지하는 것보다 훨씬 단순하다.
핵심 요점
- DeepSeek-V4.1-Flash는 552B MoE 백본을 사용하며, 프리필 시 8B, 디코드 시 16B의 활성 파라미터를 사용한다. 활성 파라미터 수는 상주 메모리 요구량을 의미하지 않는다.
- 1,048,576토큰 컨텍스트와 토큰당 890바이트의 글로벌 KV 캐시로 캐시 압박은 줄었지만, 용량 계획에서 모델 가중치가 여전히 지배적이다.
- 공식 체크포인트는 디스크 약 511 GB 수준이다. vLLM 레시피는 모델 로딩 및 런타임 오버헤드를 포함한 최소 예산으로 총합 약 614 GB의 사용 가능한 VRAM을 제시한다. 이는 기준 추산치이며, 모든 배치 크기·컨텍스트 길이·멀티모달 설정에 대한 보장은 아니다.
- vLLM이 가장 명확한 프로덕션 서빙 경로이며, SGLang은 고급 분산 추론을 목표로 한다. Ollama의 현재 경로는 완전 로컬 추론이 아닌 클라우드 기반이다.
- 자가 호스팅은 프라이버시, 에어갭, 가중치 연구, 지속적 클러스터 활용에 특히 매력적이다. 대부분의 개발자에게는 호스팅 API가 더 단순하다.
DeepSeek-V4.1-Flash란? 아키텍처, 파라미터, 모델 크기
DeepSeek는 2026년 9월 10일 V4.1-Flash를 새로운 아키텍처 패밀리 중 가장 작은 모델로 공식 발표했으며, 네이티브 비전 이해를 지원한다. “Flash”라는 이름과 달리, 작은 덴스 모델은 아니다.
핵심 아키텍처 변화는 Causal Encoder-Decoder(CED) 디자인이다. 이 모델은 프롬프트 수용과 토큰 생성 사이의 연산을 비대칭으로 나누어, 매우 큰 전문가 풀을 유지하면서도 활성 연산을 줄인다.
| 사양 | DeepSeek-V4.1-Flash |
|---|---|
| 아키텍처 | Multimodal MoE with Causal Encoder-Decoder |
| 백본 파라미터 | 552B |
| 활성 파라미터(입력) | 8B |
| 활성 파라미터(출력) | 16B |
| 트랜스포머 레이어 | 40: 인코더 20 + 디코더 20 |
| 컨텍스트 윈도우 | 1,048,576 tokens |
| 글로벌 KV 캐시 | 890 bytes/token |
| 모달리티 | 텍스트 + 이미지 입력, 텍스트 출력 |
| 가중치 라이선스 | MIT |
| 권장 샘플링 | Temperature 1.0; top_p 0.95 or 1.0 |
| 공식 가중치 | Hugging Face |
| 대표 로컬 서빙 옵션 | vLLM, SGLang, DeepSeek reference inference |
활성 파라미터와 상주 파라미터의 구분은 필수적이다. MoE 라우팅은 개별 토큰에 사용되는 연산량을 줄이지만, 서버는 선택될 수 있는 전문가 가중치에 접근할 수 있어야 한다. 따라서 “8B 활성” 모델이라도 저장소 및 가속기 메모리를 수백 GB 요구할 수 있다.
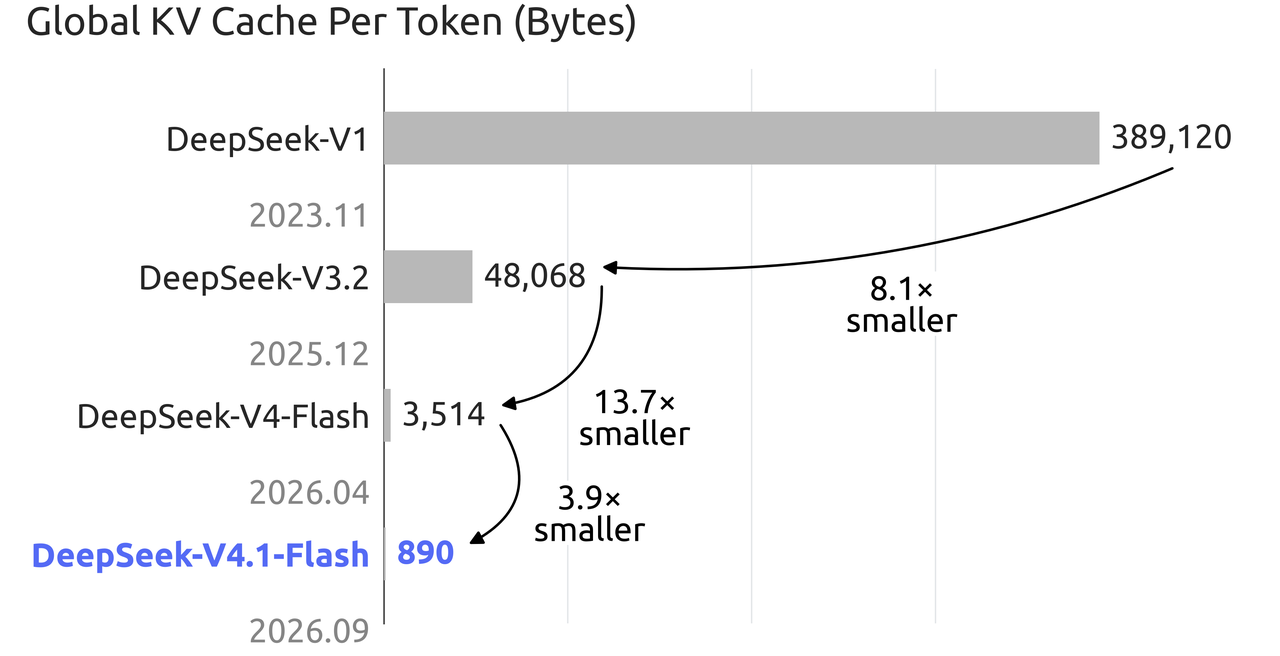
DeepSeek의 공식 KV 캐시 차트에 따르면, 글로벌 캐시는 V4 Flash의 토큰당 3,514바이트에서 V4.1 Flash의 890바이트로 약 3.9배 감소했다. 이는 백만 토큰 추론에 중요하지만, 모델 가중치가 만드는 훨씬 큰 메모리 요구를 제거하지는 않는다.
배포 전에 DeepSeek-V4.1-Flash의 성능은 어느 정도인가?
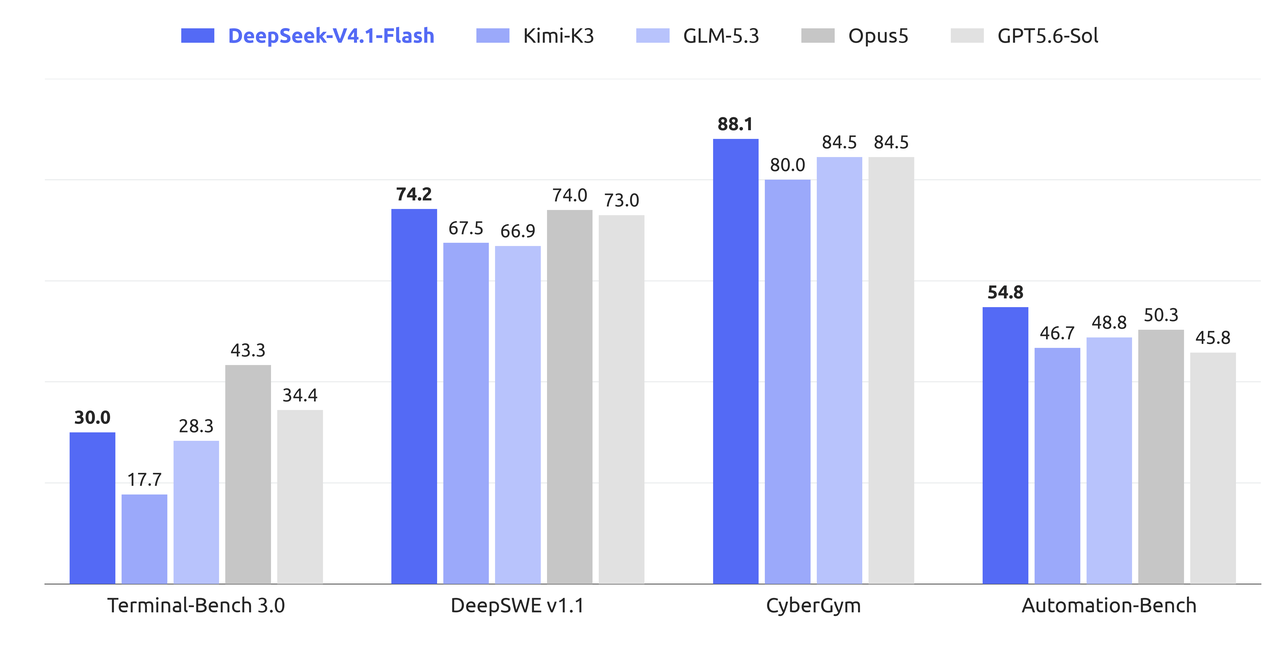
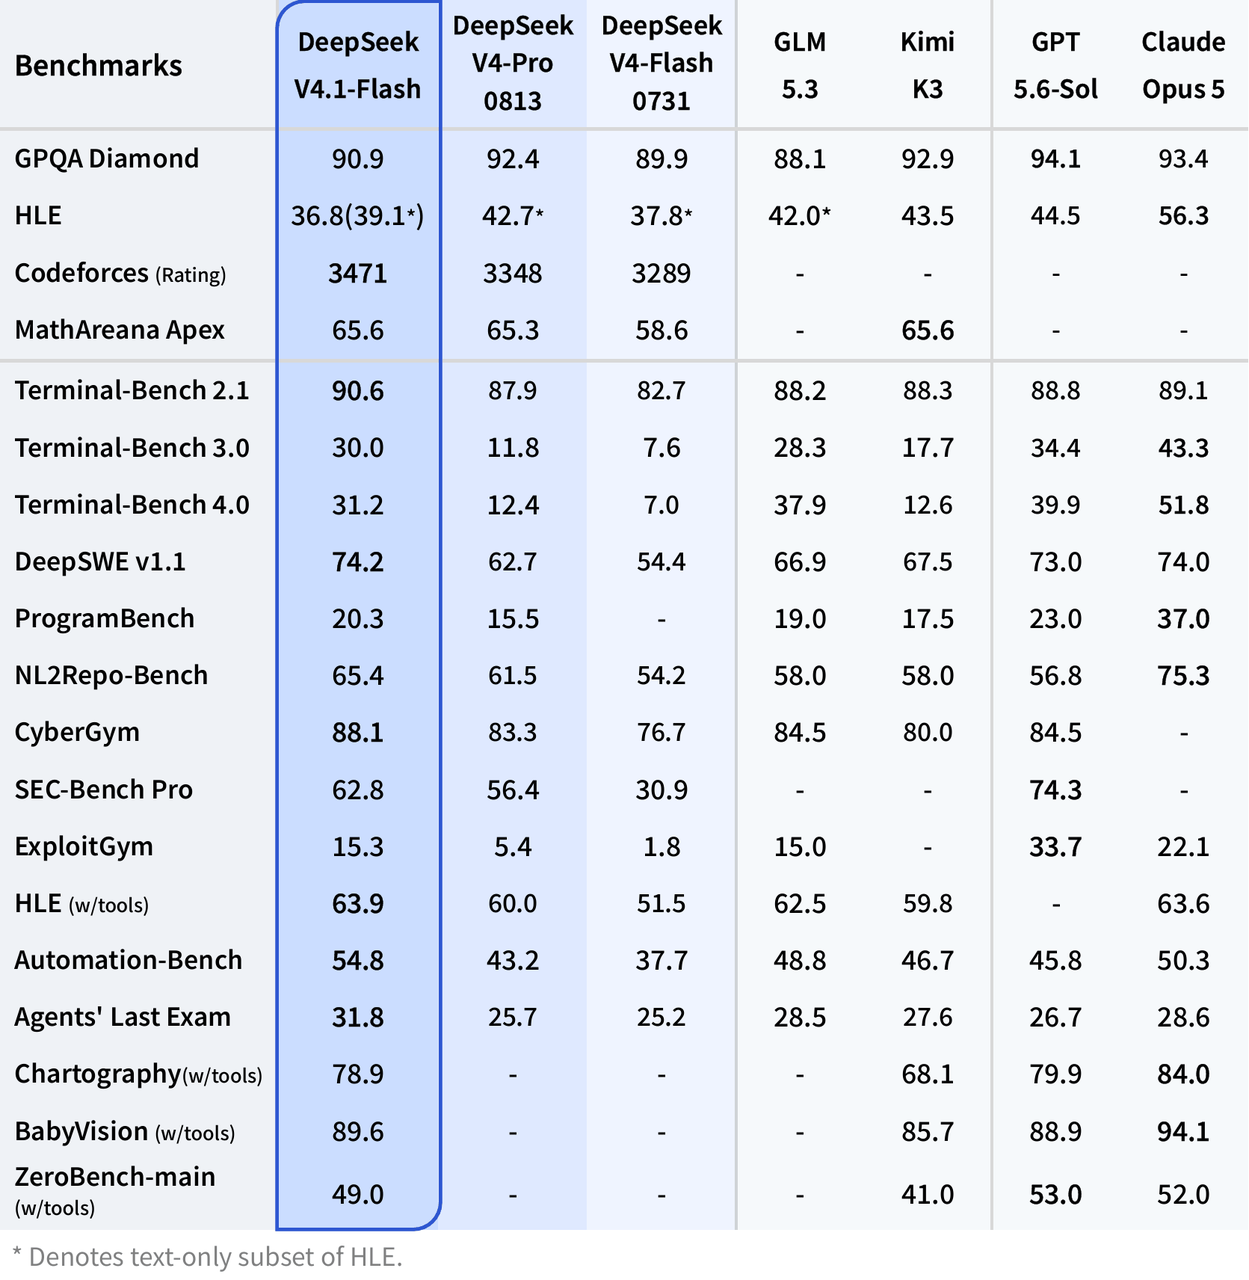
DeepSeek의 공개된 벤치마크 표는 V4.1-Flash를 주로 에이전트형 코딩, 터미널 작업, 자동화, 소프트웨어 엔지니어링 워크로드에서의 대규모 업그레이드로 위치시킨다. 이는 벤더 발표 벤치마크 결과이므로, 보장된 애플리케이션 성능이 아닌 참고 측정값으로 취급해야 한다.
재현 가능성을 위해 공식 모델 카드는 temperature 1.0과 top_p 0.95를 권장하며, 추론 노력과 토큰 예산은 평가별로 다르다. 아래 수치는 벤더가 실행한 참고 결과이며, 하드웨어 중립적 성능 보장이 아니다. 재현 전에는 각 벤치마크의 하니스 세부 사항을 확인해야 한다.
| 벤치마크 | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 | DeepSeek V4 Flash 0731 |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Codeforces Rating | 3471 | 3348 | 3289 |
| MathArena Apex | 65.6 | 65.3 | 58.6 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| Terminal-Bench 3.0 | 30.0 | 11.8 | 7.6 |
| Terminal-Bench 4.0 | 31.2 | 12.4 | 7.0 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| CyberGym | 88.1 | 83.3 | 76.7 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
개별 점수보다 패턴이 더 중요하다. V4.1-Flash는 모든 벤치마크에서 선두를 차지하진 않지만, V4 Flash 0731 대비 Terminal-Bench, DeepSWE, 자동화, 보안 워크로드에서 특히 큰 폭의 상승이 보인다. 이는 비공개 코딩 에이전트, 리포지토리 규모 분석, 내부 자동화, 에어갭 에이전트 인프라에 로컬 배포가 특히 유의미함을 시사한다.
정말로 DeepSeek-V4.1-Flash를 로컬에서 실행할 수 있는가?
가능하다. 다만 “로컬”의 의미를 명확히 해야 한다. 최신 vLLM DeepSeek-V4.1-Flash 레시피는 체크포인트가 약 절반 테라바이트이며, 런타임 오버헤드를 포함하면 훨씬 더 큰 VRAM 예산을 권장한다.
| 구성 요소 | 대략적 저장 크기 |
|---|---|
| 라우티드 + DSpark 전문가 | 259.5 GiB |
| Engram 테이블 | 183.1 GiB |
| 어텐션, 밀집 프로젝션 및 라우터 | 6.9 GiB |
| 임베딩, LM 헤드 및 노름 | 3.9 GiB |
| UE8M0 블록 스케일 | 21.9 GiB |
| 전체 체크포인트 | ~476 GiB / ~511 GB |
| vLLM 권장 최소 VRAM 예산 | ~614 GB |
놀라운 점은 V4.1-Flash가 이미 내부적으로 강하게 압축되어 있다는 것이다. 라우티드 전문가 가중치는 저정밀 형식을 사용하므로, 공식 체크포인트는 손쉬운 4비트 변환을 기다리는 거대한 BF16 모델이 아니다.
DeepSeek-V4.1-Flash 하드웨어 요구사항
| 하드웨어 구성 | 현실적 상태 | 비고 |
|---|---|---|
| 1× RTX 4090 / 5090 | 불가 | 모델 메모리 풋프린트에 한참 미달 |
| 2–4장 소비자용 GPU | 공식 풀 체크포인트 기준 불가 | 총합 VRAM이 여전히 불충분 |
| 128 GB 워크스테이션 | 불가 | 활성 파라미터가 상주 가중치 메모리를 결정하지 않음 |
| 256 GB 워크스테이션 | 공식 서빙 경로 기준 불가 | 공식 체크포인트 풋프린트에 한참 미달 |
| 512 GB 시스템 RAM + GPU 오프로딩 | 실험적 | 커뮤니티/오프로딩 영역으로, 검증된 프로덕션 서빙과 동등하지 않음 |
| 4× 대용량 데이터센터 GPU | 하드웨어 의존 | 충분히 큰 최신 가속기라면 가능; 런타임 레시피 확인 필요 |
| 8× H200 | 가능(문서화된 클래스) | 총합 약 1,128 GB HBM |
| GB200 NVL4급 시스템 | 가능 | vLLM은 768 GB 트레이가 모델을 수용한다고 명시 |
중요: 8B 활성 파라미터가 8 GB VRAM을 의미하지 않는다. “활성”은 토큰의 연산에 참여하는 MoE 네트워크의 양을 의미한다. 전체 전문가 세트는 여전히 추론 엔진이 접근 가능한 곳에 저장되어야 한다.
DeepSeek-V4.1-Flash에는 어떤 런타임을 써야 하나?
| 런타임 | 현재 V4.1-Flash 상태 | 최적 용도 |
|---|---|---|
| vLLM | 현재 배포 레시피 제공; 최신 이미지 필요 | OpenAI 호환 프로덕션 서빙 |
| SGLang | 최신 DeepSeek-V4.1 배포 빌드로 지원 | 고성능 분산 추론 |
| DeepSeek reference inference | 공식 TP8 레퍼런스 구현 | 아키텍처 연구 및 검증 |
| Transformers | Hugging Face에서 모델 통합 노출 | 개발/실험; 여전히 하드웨어 필요 |
| Ollama | 공식 라이브러리 경로는 현재 :cloud 사용 | 편리한 클라우드 호출, 자가 호스팅과는 다름 |
프로덕션 자가 호스팅을 위해서는 vLLM이 현재 가장 명확한 시작점이다. SGLang 배포 가이드는 고급 분산 추론을 위한 또 다른 지원 경로를 제공한다.
vLLM으로 DeepSeek-V4.1-Flash를 로컬에서 실행하는 방법
멀티 GPU Linux 서버를 위한 실용적 경로다.
아래 모든 명령 예시는 언어별 코드 블록으로 재정렬되며 간결한 영어 설명을 포함한다.
1단계: 환경 점검
- Linux
- Docker
- NVIDIA Container Toolkit
- 수백 GB 수준의 여유 SSD 공간
- 지원되는 멀티 GPU 구성
- 현행 공식 가중치 서빙 프로파일 기준 총합 약 614 GB의 사용 가능한 가속기 메모리
- 모델이 로컬에 캐시되어 있지 않다면 빠른 네트워크
2단계: DeepSeek-V4.1-Flash 가중치 다운로드
공식 가중치는 MIT 라이선스로 DeepSeek-V4.1-Flash Hugging Face 리포지토리에 호스팅되어 있다.
python -m pip install -U huggingface_hub
hf download deepseek-ai/DeepSeek-V4.1-Flash
~/.cache/huggingface를 담는 파일시스템에 511 GB를 상당히 초과하는 여유 공간이 있는지 확인하라. 임시 파일과 추가 엔진 산출물이 피크 디스크 사용량을 늘릴 수 있다.
3단계: vLLM으로 DeepSeek-V4.1-Flash 시작
현재 vLLM 레시피 기준 DeepSeek-V4.1 지원에는 충분히 최신의 vLLM 이미지가 필요하다. 텍스트 전용 8 GPU 시작 구성 예시는 다음과 같다.
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  vllm/vllm-openai:nightly \
  deepseek-ai/DeepSeek-V4.1-Flash \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 8 \
  --language-model-only \
  --tokenizer-mode deepseek_v41 \
  --tool-call-parser deepseek_v41 \
  --reasoning-parser deepseek_v41 \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.90 \
  --max-model-len 131072
여기에는 두 가지 의도적 선택이 있다. 첫째, --language-model-only는 텍스트 전용 워크로드를 위해 비전 인코더를 비활성화한다. 둘째, 처음부터 백만 토큰 컨텍스트를 활성화하기보다는 131,072 토큰에서 시작하는 것이 안전하다. 서버가 안정화되면 다음처럼 늘릴 수 있다.
--max-model-len 1048576
적절한 텐서 병렬 설정은 가속기 토폴로지에 따라 달라지므로, 모든 서버에 --tensor-parallel-size 8을 그대로 복사하지 말라.
4단계: 로컬 DeepSeek-V4.1-Flash 엔드포인트 테스트
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "What is 17 * 19? Return only the integer."
      }
    ]
  }'
323
5단계: Python으로 로컬 DeepSeek-V4.1-Flash 서버 호출
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Explain the difference between TCP and UDP in three bullets."
        }
    ],
    temperature=1.0,
    top_p=0.95
)

print(response.choices[0].message.content)
로컬에서 DeepSeek-V4.1-Flash의 Thinking 모드를 어떻게 활성화하나?
V4.1-Flash는 챗 템플릿을 통해 명시적 추론 제어를 지원한다. 예시는 다음과 같다.
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Find the most efficient algorithm for this scheduling problem."
        }
    ],
    extra_body={
        "chat_template_kwargs": {
            "thinking": True,
            "reasoning_effort": 50
        }
    }
)

print(response.choices[0].message.content)
작은 max_tokens 값에서 최종 출력이 거의 없거나 비어 보인다면, Thinking 모드가 생성 예산을 소모하고 있는지 확인하라. 배포가 고장났다고 단정하기 전에 이를 점검해야 한다.
레퍼런스 코드로 DeepSeek-V4.1-Flash를 실행하려면?
DeepSeek는 모델 리포지토리 내에 최소 TP8 추론 구현도 포함한다. 이는 고처리량 프로덕션 서버라기보다 가독성 높은 레퍼런스 코드에 가깝다.
cd inference
python -m pip install -r requirements.txt
export HF_CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-HF
export SAVE_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

python convert.py \
  --hf-ckpt-path "${HF_CKPT_PATH}" \
  --save-path "${SAVE_PATH}" \
  --model-parallel "${MP}" \
  --expert-dtype fp4 \
  --tokenizer-path "${HF_CKPT_PATH}"
export CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

torchrun --nproc-per-node "${MP}" generate.py \
  --ckpt-path "${CKPT_PATH}" \
  --config config.json \
  --interactive \
  --temperature 0.6
이 경로는 CED, MoE 라우팅, Engram 메모리, 예측 디코딩 및 관련 구현 세부 사항을 살펴보는 데 유용하다. 일반적인 프로덕션 서빙에는 vLLM 또는 SGLang이 운영이 더 쉽다.
Ollama로 DeepSeek-V4.1-Flash를 로컬에서 실행할 수 있나?
일반적인 7B 또는 32B Ollama 모델을 실행하는 것과 같은 의미는 아니다. Ollama는 현재 V4.1-Flash를 다음을 통해 노출한다.
ollama run deepseek-v4.1-flash:cloud
중요한 부분은 :cloud다. 현재 Ollama 라이브러리 항목은 클라우드 경로를 사용하므로, 이 명령은 전체 모델을 다운로드해 전적으로 로컬 머신에서 추론하는 것과 동일하지 않다.
DeepSeek-V4.1-Flash 로컬 배포 vs API: 어떤 선택이 합리적인가?
| 차원 | 로컬 DeepSeek-V4.1-Flash | 호스팅 API |
|---|---|---|
| 초기 하드웨어 | 매우 높음 | 없음 |
| 가속기 메모리 | ~614 GB(현행 공식 목표치) | 제공업체가 관리 |
| 모델 제어 | 완전 | 제한적 |
| 데이터 온프레미스 유지 | 예 | 아니오 |
| 가중치 수정 | 가능 | 불가 |
| 유지보수 | 직접 책임 | 제공업체 관리 |
| 설정 복잡도 | 높음 | 낮음 |
| 확장성 | 인프라 필요 | API 기반 |
| 최적 용도 | 에어갭, 프라이빗, 연구, 고이용률 클러스터 | 대부분의 개발자 및 프로덕션 앱 |
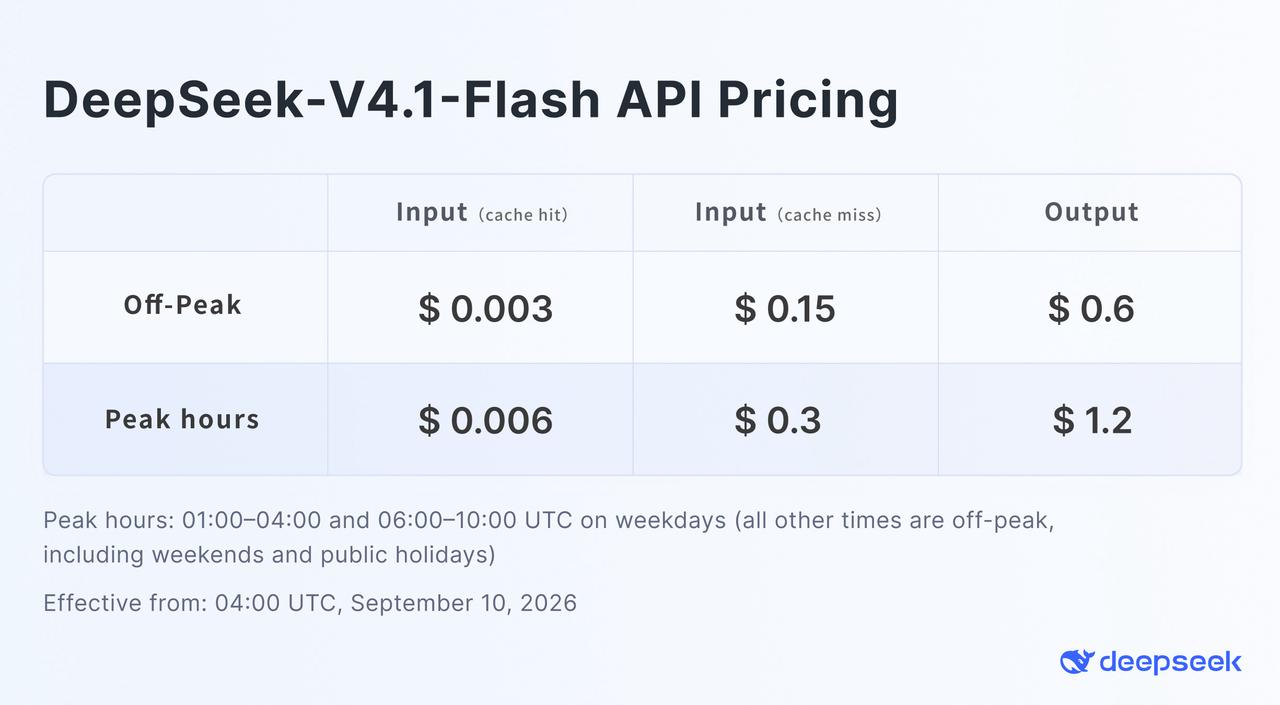
DeepSeek의 공식 오프피크 요금은 V4.1-Flash 가격 그래픽에 표시되어 있다. 가중치의 실물 보유가 필요하지 않다면, CometAPI의 DeepSeek V4.1 Flash API는 다른 AI 모델과 함께 OpenAI 호환 대안을 제공한다.
아래 예시는 CometAPI의 모델 식별자를 사용한다. 이는 DeepSeek 공식 API의 식별자와 동일하지 않다.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Review this Python function and identify possible race conditions."
        }
    ]
)

print(response.choices[0].message.content)
실무적인 결론은 명확하다. 프라이버시, 에어갭, 가중치 수준 실험, 예측 가능한 고부하 사용, 규제 요구가 인프라 비용을 상쇄하는 경우 로컬 배포가 설득력을 갖는다. 일반적인 애플리케이션 개발에는 수백 GB의 모델 관리와 멀티 GPU 오케스트레이션을 피할 수 있는 호스팅 엔드포인트가 적합하다.
로컬에서 DeepSeek-V4.1-Flash 실행 시 겪을 수 있는 문제
생성 시작 전에 서버가 메모리를 소진한다
전체 체크포인트가(8B/16B 활성 파라미터가 아니라) 메모리 요구를 대부분 결정한다. 텐서 병렬, GPU 메모리 활용률, 비전 로딩 여부, 사용 가능한 HBM을 확인하라.
DeepSeek-V4.1-Flash 시작이 오래 걸린다
절반 테라바이트급 체크포인트는 다운로드, 매핑, 초기화, 샤딩에 시간이 걸린다. 이 등급의 모델에서 긴 엔진 준비 타임아웃은 정상이다.
응답이 비어 있거나 finish_reason=length로 끝난다
Thinking 모드가 생성 예산을 소모 중일 수 있다. max_tokens를 늘리거나, reasoning effort를 낮추거나, 단순 요청에는 Thinking을 비활성화하라.
도구 호출이 제대로 파싱되지 않는다
서버가 DeepSeek V4.1 토크나이저, 도구 호출 파서, 추론 파서, 자동 도구 선택 플래그를 사용 중인지 확인하라.
비전 입력이 동작하지 않는다
--language-model-only로 시작했다면 의도적으로 비전 인코더를 비활성화한 것이다. 이미지를 테스트하기 전에 멀티모달 지원을 활성화하여 재시작하라.
DeepSeek-V4.1-Flash를 로컬로 실행해야 할까?
DeepSeek-V4.1-Flash는 아키텍처가 토큰당 연산과 KV 캐시 비용을 크게 줄였다는 점에서 자가 호스팅 관점에서 이례적으로 흥미롭다. 그러나 이것이 프런티어급 오픈 웨이트 모델을 데스크톱 모델로 바꾸는 것은 아니다.
연구소, 엔터프라이즈 AI 플랫폼, 프라이빗 코딩 에이전트 스택, 에어갭 환경이라면 vLLM과 SGLang으로 자가 호스팅이 기술적으로 현실적이다. 1~2장 GPU를 가진 개발자에게는 풀 모델 배포 대상이 실용적이지 않다. 이 경우 CometAPI를 통한 DeepSeek V4.1 Flash가 대규모 인프라 프로젝트 없이 모델에 접근하는 방법을 제공한다.
자주 묻는 질문(FAQ)
DeepSeek-V4.1-Flash는 오픈 소스인가?
모델 가중치와 리포지토리는 MIT 라이선스 하에 공개되어 있으며, 라이선스 조건을 준수하는 광범위한 사용, 수정, 재배포가 가능하다.
RTX 4090 또는 RTX 5090에서 DeepSeek-V4.1-Flash를 실행할 수 있나?
공식 풀 모델은 불가하다. 단일 소비자용 GPU는 전체 체크포인트가 요구하는 메모리의 일부만 제공한다.
8B 활성 파라미터가 DeepSeek-V4.1-Flash에 8 GB VRAM만 필요하다는 뜻인가?
아니다. 8B 수치는 프롬프트 처리 중에 참여하는 파라미터를 설명한다. 전체 전문가 네트워크와 지원 상태는 여전히 저장되고 접근 가능해야 한다.
DeepSeek-V4.1-Flash는 VRAM을 얼마나 필요로 하나?
현행 vLLM 레시피는 공식 체크포인트와 런타임 오버헤드를 포함해 계획 수치로 약 614 GB를 사용한다. 실제 필요량은 하드웨어, 배치 크기, 컨텍스트, 비전 지원, 서빙 구성에 따라 달라진다.
DeepSeek-V4.1-Flash의 디스크 크기는 어느 정도인가?
현재 vLLM 분해 기준 체크포인트는 대략 476 GiB, 약 511 GB다.
DeepSeek-V4.1-Flash는 로컬에서 100만 토큰 컨텍스트를 실행할 수 있나?
아키텍처는 최대 1,048,576토큰을 지원하지만, 실제 메모리 사용은 배치 크기, 런타임 버퍼, 비전 상태, 기타 오버헤드에도 좌우된다.
Ollama로 DeepSeek-V4.1-Flash를 로컬에서 실행할 수 있나?
현재 Ollama 항목은 :cloud 경로를 사용하므로, 전체 가중치를 내려 받아 온전히 로컬에서 추론하는 것과 동일하지 않다.
DeepSeek-V4.1-Flash에는 vLLM과 SGLang 중 어떤 것이 더 나은가?
둘 다 고성능 서빙을 목표로 한다. vLLM은 특히 V4.1 전용의 상세 레시피를 제공하며, SGLang도 고급 분산 배포에 적합하다.
로컬 하드웨어 없이 DeepSeek-V4.1-Flash를 가장 쉽게 사용하는 방법은?
호스팅 API를 사용하라. DeepSeek는 자체 API를 제공하며, CometAPI는 다른 AI 모델과 함께 OpenAI 호환 DeepSeek-V4.1-Flash 엔드포인트를 제공한다.