Hy4는 금융 리서치와 대량 텍스트 생성에 강한 출발점이며, GPT-6.1 Terra는 터미널 코딩과 디버깅에 강한 출발점입니다. 두 모델 모두 텍스트와 이미지를 입력받고 도구 사용을 지원합니다. 가장 분명한 차이는 작업 성능, 출력 용량, 그리고 가격입니다. 아래 터미널 코딩 테스트에서는 Terra가 앞서고, 금융 및 리서치 테스트에서는 Hy4가 앞서며 CometAPI 표시 요율 기준 비용도 더 낮습니다.
Key Takeaways
워크로드에 따라 선택: 리서치와 출력량 많은 애플리케이션에는 Hy4, 터미널 코딩과 디버깅에는 Terra.
두 모델 모두 대략 백만 토큰급 컨텍스트 윈도우 제공. Terra는 더 큰 최대 출력 예산 제공.
Terra는 Terminal-Bench 4.0에서 10.10 퍼센트포인트 앞섬; Tencent 모델은 Vals AI 결과에서 Finance Agent v2.1에서 8.74포인트 앞섬.
CometAPI 예시의 1,000만 입력 토큰과 200만 출력 토큰 비용은 표시된 기본 요율에서 각각 $10.672 vs. $16.00.
Hy4 vs GPT-6.1 Terra: Specifications and Capabilities
Hy4는 텍스트와 이미지 이해를 추론 및 도구 사용과 결합하며, 커맨드라인과 그래픽 인터페이스를 가로지르는 워크플로를 포함합니다. GPT-6.1 Terra는 시각적 추론, 컴퓨터 사용, 글쓰기를 지원하며, 명시적인 추론 노력 설정과 더 큰 출력 예산을 제공합니다. 아래 표는 Tencent와 OpenAI의 사양을 비교합니다.
Official API Specifications
Specification
Hy4 · Tencent Cloud official specifications
GPT-6.1 Terra · OpenAI official specifications
Developer
Tencent
OpenAI
API model ID
hy4
gpt-6.1-terra
Input / output
Text and images / text
Text and images / text
Context window
1024K tokens (Tencent notation)
1,050,000 tokens
Maximum output
64K tokens (Tencent notation)
128,000 tokens
Tool calling
Supported (Function Calling)
Supported; requires Responses API
Structured outputs
Supported
Supported
Main applications
Software engineering, financial analysis, and long-running agent tasks
Visual reasoning, computer use, writing, and scoped code tasks
두 모델 모두 대규모 문서 컬렉션과 코드베이스로 작업할 수 있습니다. 긴 프롬프트의 경우 응답을 위한 예산도 확보해야 합니다. Tencent는 Hy4의 최대 입력을 960K로 명시합니다. 광고된 컨텍스트 용량의 작은 차이보다, 각 모델이 제공한 자료를 얼마나 정확히 활용하는지가 선택에 더 유용합니다.
Terra는 최대 128,000 출력 토큰으로 더 긴 응답에 여유가 있습니다. 이는 보고서나 코드 산출물을 하나의 응답에 담아야 할 때 유용합니다. 추론 토큰 역시 Terra의 출력 예산을 소모합니다.
Reasoning Controls
Terra는 none, low, medium, high, xhigh, max의 여섯 가지 추론 노력 설정을 제공하며 기본값은 medium입니다. 이를 통해 애플리케이션은 작업별로 추론 예산을 명시적으로 조정할 수 있습니다. 분류 요청과 어려운 디버깅 작업이 동일한 예산을 사용할 필요는 없습니다.
Tencent의 출시 자료는 시각적 인식과 도구 사용이 결합된 추론을 설명하지만, 동등한 6단계 제어를 정의하지는 않았습니다. 추론 파라미터는 엔드포인트별로 다르므로, 한 제공자의 노력 설정을 다른 요청에 복사해 같은 의미로 가정하지 마십시오.
Hy4 vs GPT-6.1 Terra: Performance
Vals AI는 코딩, 금융, 법률 리서치, 세무 작업 전반에 걸쳐 두 모델의 직접적인 결과를 제공합니다. 이 점수는 각 모델이 귀하의 워크로드에 적합한 후보인지 보여줍니다.
Independent Benchmark Results and Test Conditions
다음 Vals Index v2.2 결과는 2026년 11월 10일에 확인했습니다. 점수가 높을수록 좋습니다.
Benchmark or metric
Hy4: Vals AI results
GPT-6.1 Terra: Vals AI results
Interpretation
Vals Index
59.35% ± 1.08
60.54% ± 0.99
Terra +1.19 percentage points
Terminal-Bench 4.0
39.39%
49.49%
Terra +10.10 points
Vibe Code Bench v1.1
81.01%
84.00%
Terra +2.99 points
Finance Agent v2.1
64.70%
55.96%
Tencent model +8.74 points
Legal Research Bench
41.35%
25.96%
Tencent model +15.39 points
Tax Agent Bench
34.40%
17.08%
Tencent model +17.32 points
Vals AI는 Hy4에 대해 temperature 0.9, top_p 1.0, 65,536 토큰의 출력 한도를 사용합니다. Terra는 최대 추론 노력과 128,000 토큰의 출력 한도를 사용합니다. 설정이 다르므로, 동등 예산 실행이 아니라 테스트된 구성의 비교로 결과를 해석하십시오.
Terra의 리드는 코드 생성보다 터미널 작업에서 더 큽니다. Terminal-Bench 4.0에서 10.10 퍼센트포인트, Vibe Code Bench에서는 2.99포인트입니다. 이는 디버깅과 커맨드라인 개발이 Terra 평가를 시작하기 가장 명확한 영역임을 시사합니다.
Hy4는 Finance Agent, Legal Research Bench, Tax Agent Bench에서 각각 8.74, 15.39, 17.32 퍼센트포인트 앞섭니다. 증거를 수집하고 도메인 규칙을 적용하는 리서치 워크플로는 Hy4를 시작점으로 삼기에 유망합니다.
전체 격차는 1.19 퍼센트포인트이며, 공표된 불확실성 구간이 겹칩니다.
Tencent’s Hy4 Launch Benchmarks
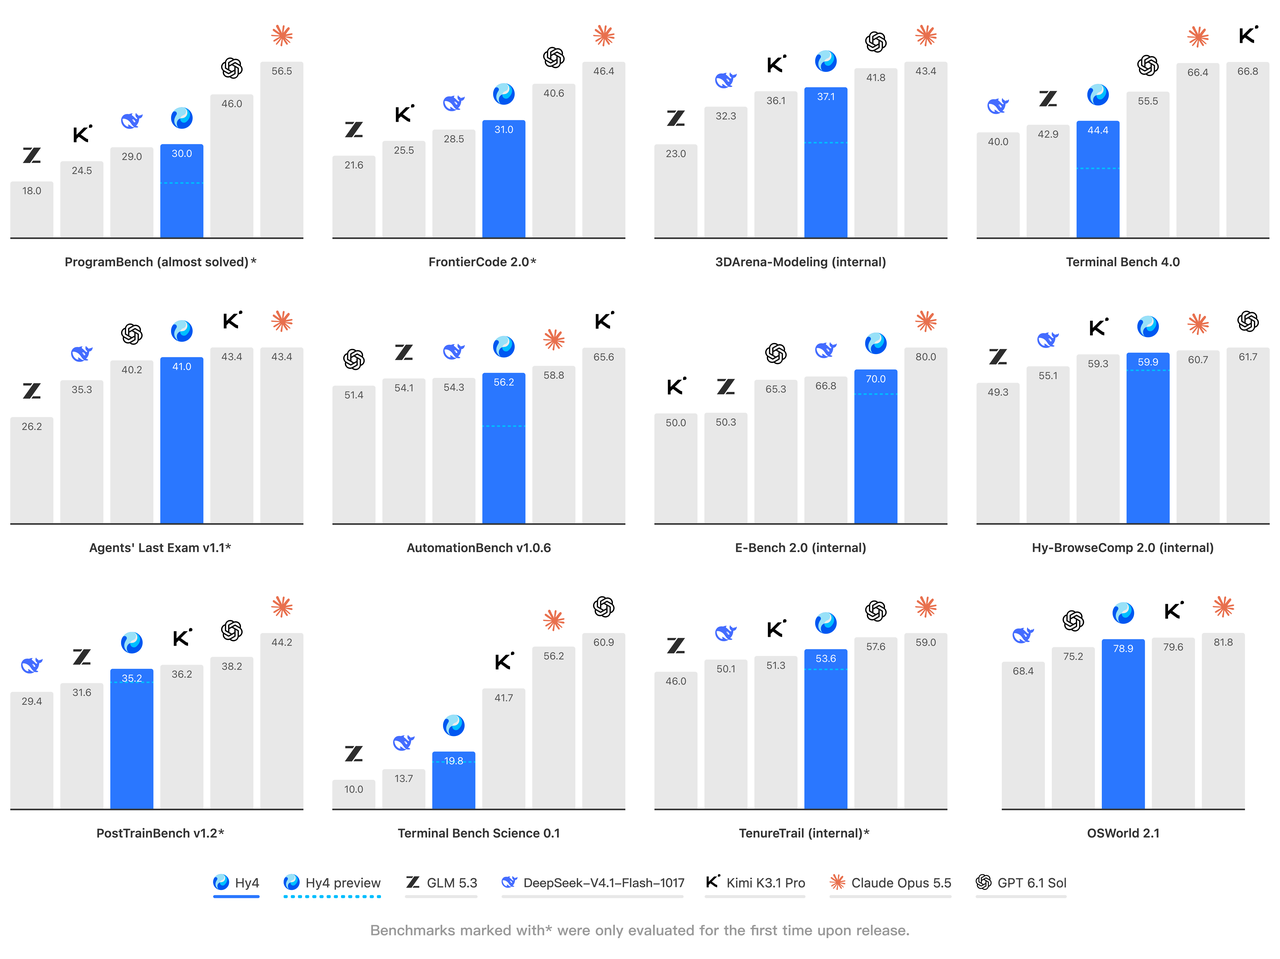
Tencent의 출시 차트는 코딩과 컴퓨터 사용에 대한 결과를 추가로 제공합니다. 이는 Hy4와 GPT-6.1 Sol을 비교하므로, GPT-6.1 Terra와의 직접 비교는 위 Vals AI 표를 사용하십시오.
Tencent가 보고한 Hy4 벤치마크 결과, 2026년 11월. 표시된 OpenAI 모델은 GPT-6.1 Sol입니다.
Tencent 출시 차트에서 Hy4는 Terminal Bench 4.0에서 44.4, OSWorld 2.1에서 78.9를 기록합니다. 이 수치는 Tencent의 평가 설정을 설명하며, 위 Vals AI 점수와는 별개입니다.
Vision and Computer-Use Workflows
Tencent는 공식 릴리스에서 이미지 이해를 소개하고, 커맨드라인 도구, 그래픽 인터페이스, Blender, CAD를 아우르는 워크플로 훈련을 설명합니다. 이는 차트 분석과 시각적 소프트웨어 작업을 핵심 포지셔닝으로 만듭니다.
OpenAI는 자사 모델을 화면 기반 워크플로, 간결한 글쓰기, 범위가 제한된 코드 수정에 맞춰 포지셔닝합니다. 카탈로그 애플리케이션에서는 제품 사진 매칭을, 기술 작업에서는 작은 라벨과 치수가 있는 도면을, 데스크톱 자동화에서는 저장 파일과 애플리케이션 상태를 검증해 보십시오.
좋은 시각 테스트 세트는 읽기와 행동을 구분해야 합니다. 먼저 모델이 올바른 값을 추출하거나 정확한 인터페이스 요소를 식별하는지를 측정합니다. 그다음 잘못된 클릭, 누락된 파일, 불필요한 인간 개입 없이 완전한 워크플로가 요구 결과에 도달하는지 측정합니다.
Speed and End-to-End Latency
채팅에서는 답변이 얼마나 빨리 시작되고 얼마나 오래 걸려 끝나는지가 관련 속도 지표입니다. 에이전트의 경우 도구 실행과 수정까지 포함한 전체 작업을 측정하십시오.
예상 동시성에서 전형적·고난도 작업 모두에 대해 두 모델을 비교하세요. 성공적 완료와 함께 중앙값 및 꼬리 지연 시간을 추적하십시오. 빠른 응답은 작업을 실제로 끝낼 때에만 유용합니다.
Hy4 vs GPT-6.1 Terra: Cost
먼저 토큰 요율을 비교하고, 다음으로 사용 가능한 결과를 얻는 데 필요한 작업량을 고려하십시오. 아래 가격은 백만 토큰당 미화 기준 CometAPI 기본 요율이며, Vals AI가 보고한 테스트당 비용과는 별개입니다.
CometAPI Input and Output Pricing
Cost item
Hy4 API in CometAPI
GPT-6.1 Terra API in CometAPI
Input per million tokens
$0.6672
$0.80
Output per million tokens
$2.00
$4.00
아래 표는 CometAPI에 표시된 백만 토큰당 미화 기준 기본 요율을 사용합니다. 입력과 출력을 별도로 비교한 다음, 전형적인 요청의 비용을 계산하십시오.
Example Cost for 10,000 Requests
각각 1,000개의 캐시 미적용 입력 토큰과 200개의 과금 대상 출력 토큰을 사용하는 10,000건의 요청을 가정해 봅시다. 전체로는 1,000만 입력 토큰과 200만 출력 토큰입니다. 위 CometAPI 기본 가격을 적용하면:
이 예시에서 Hy4는 약 33.3% 더 저렴합니다. 이 추정은 캐시 미적용 입력과 과금 대상 출력을 포함합니다. 전체 워크플로 예산에는 캐시, 도구, 재시도 비용을 추가하십시오.
Direct-Provider Billing and Long-Context Requests
OpenAI의 직접 API에서 긴 문서의 경우, 입력 토큰 272K를 초과하는 프롬프트는 전체 요청에 대해 입력 및 캐시 요율 2×, 출력 요율 1.5×가 적용됩니다. 사용하는 서비스의 과금 규칙을 적용하십시오. 위 CometAPI 예시는 CometAPI 기본 요율을 사용합니다. OpenAI 요금 상세.
Cost per Accepted Task
승인된 작업은 애플리케이션의 품질 및 완료 검사를 통과한 작업을 의미합니다. 그 결과에 도달하기 위해 필요한 모든 시도, 도구 사용, 검토 작업을 모두 계산하며, 실패한 시도에 대한 지출도 포함합니다.
Cost per accepted task = total model, retry, tool, and human-review costs ÷ tasks that pass acceptance checks.
더 비싼 호출이라도 여러 번의 수정 시도를 제거한다면 경제적일 수 있습니다. 반대로 더 저렴한 모델이 품질 기준을 충족한다면, 모든 작업에 더 높은 요율을 지불하는 가치는 크지 않을 수 있습니다.
Which Model Should You Choose: Hy4 or GPT-6.1 Terra?
주요 워크로드의 강점과 맞는 모델부터 시작하십시오. 다음 선택지를 사용해 후보를 추리고, 완료된 작업의 품질과 비용을 비교하십시오.
When to Choose Hy4
금융 리서치, 법률 또는 세무 문서 분석, 대량 텍스트 생성 애플리케이션에는 Hy4를 먼저 선택하십시오. 세 가지 도메인 벤치마크에서의 우위는 증거 중심 리서치에 유용한 후보임을 보여줍니다. 표시된 CometAPI 요율에서 출력 단가는 Terra의 절반이므로, 대량 작성 및 보고에서는 비용 차이가 의미 있을 수 있습니다.
리서치 작업에서는 소스 정확성, 계산, 질문 범위 충족 여부로 최종 답을 평가하십시오. 검토와 재시도를 포함한 총비용이 더 낮으면서 요구 사항을 충족한다면 Hy4가 더 적합합니다.
When to Choose GPT-6.1 Terra
터미널 코딩, 디버깅, 코드 수정에는 GPT-6.1 Terra를 먼저 선택하십시오. Terminal-Bench에서의 10.10포인트 리드는 본 비교에서 가장 강한 코딩 신호입니다. 더 큰 출력 예산도 긴 보고서와 대량 코드 응답 테스트 가치가 있습니다.
Terra는 패치가 테스트를 통과하는지, 산출물이 완전한지로 평가하십시오. 시각 또는 데스크톱 작업에서는 실제 화면, 차트, 파일로 두 모델을 비교하고 최종 저장 결과를 확인하십시오.
Routing Research and Coding to Different Models
혼합 워크로드는 두 모델을 함께 사용할 때 이점이 있을 수 있습니다. 금융 분석 도우미는 리서치와 보고서 작성에는 Hy4를, 분석 스크립트 디버깅이 필요할 때는 Terra를 호출할 수 있습니다:
증거 수집과 보고서 작성은 Hy4로 보냅니다.
보고서를 승인하기 전에 인용, 출처 값, 계산을 확인합니다.
실패한 분석 스크립트를 코드, 오류 출력, 기대 동작과 함께 Terra로 라우팅합니다.
수정된 스크립트를 실행하고 동일한 증거 검사를 거쳐 최종 결과를 반환합니다.
두 번째 모델이 최종 결과를 충분히 개선해 추가 비용과 통합 작업을 상쇄할 때에만 사용하십시오.