Linux GPU 서버에 Kimi K3.1 Pro를 배포한 뒤, 로컬 애플리케이션을 해당 추론 엔드포인트에 연결하세요. 본 가이드는 vLLM을 사용하는 8-GPU NVIDIA B300 단일 노드를 예시로 합니다. 서버에 대한 셸 접근, 호환 드라이버, 전체 체크포인트 저장 공간이 필요합니다. 먼저 짧은 텍스트 요청 하나를 성공한 뒤, 더 긴 입력이나 에이전트 워크플로를 테스트하세요.
적절한 GPU가 없다면, 애플리케이션은 로컬에서 실행하고 공식 Kimi API 또는 CometAPI 같은 서드파티 제공자에 연결할 수 있습니다.
핵심 요점
모델의 활성 파라미터 104B는 전체 저장 요구사항을 의미하지 않습니다.
하드웨어 호환성은 GPU 메모리, 인터커넥트, 양자화 지원, 추론 커널을 모두 포함합니다.
강한 벤치마크 결과는 시험할 가치가 있음을 시사하지만, 귀하의 애플리케이션에서 동일 성능을 보장하지는 않습니다.
동작하는 추론 엔드포인트가 브라우저, 코드 샌드박스, 완전한 에이전트 런타임을 자동으로 포함하는 것은 아닙니다.
Kimi K3.1 Pro는 Moonshot AI의 코드, 문서 분석, 도구 사용을 위한 오픈웨이트 멀티모달 모델입니다. 주요 사양은 공식 모델 카드 를 기반으로 아래에 정리했습니다.
사양
공개된 구성
아키텍처
MoE; 총 2.8T 파라미터, 활성 104B
어텐션
93 레이어: 69 KDA + 24 Gated DSA
전문가(Experts)
896 라우팅; 토큰당 16개 선택; 2개 공유
컨텍스트
1,048,576 토큰
입력
텍스트와 이미지; MoonViT-V2 비전 인코더
양자화
MXFP4 가중치 / MXFP8 활성값; 혼합 정밀도 체크포인트
권장 엔진
vLLM, SGLang, TokenSpeed
모델은 토큰당 104B 파라미터를 활성화하지만, 배포에는 여전히 전체 2.8T 파라미터 체크포인트가 필요합니다. 추론 엔진은 KDA 및 Gated DSA 레이어와 MXFP4 양자화를 지원해야 합니다.
로컬에서 Kimi K3.1 Pro를 실행하려면 어떤 하드웨어가 필요한가요?
아래 표는 본 가이드와 관련된 vLLM 구성을 요약한 것입니다. 본 walkthrough는 8-GPU B300 단일 노드를 사용합니다. GB300과 AMD 배포는 각자의 전용 구성을 사용해야 합니다.
하드웨어
문서화된 경로
계획 메모
NVIDIA B300
8-GPU 단일 노드, TP8
아래 walkthrough의 기준
NVIDIA GB300
두 트레이에 걸친 8-GPU, TP8
멀티 노드 구성 및 인터커넥트 설정 필요
AMD MI355X
AMD 전용 구성의 8-GPU 노드
ROCm/AITER 경로 사용; NVIDIA 환경 설정 재사용 금지
단일 24–32 GB 소비자용 GPU
전체 체크포인트 직접 로딩에는 불충분
본 튜토리얼의 실용적 대상이 아님
규모 감을 위해, 2.8T 파라미터는 대략 BF16에서 약 5.6 TB, 8비트에서 2.8 TB, 이상화된 4비트에서 1.4 TB를 차지합니다. 이는 원시 파라미터 저장 계산치로, 실제 체크포인트 크기나 런타임 VRAM 최소 요구사항이 아닙니다. 혼합 정밀도와 메타데이터는 파일 크기를 바꾸며, 캐시와 런타임 할당은 서빙 요구량을 증가시킵니다.
전체 다운로드, 임시 파일, 롤백 사본을 위한 NVMe 용량을 확보하세요. 멀티 노드 시스템에서는 모델 로딩 전에 통신을 검증하세요.
Kimi K3.1 Pro를 배포하는 방법
적합한 하드웨어가 있다면 자체 호스팅을 사용하세요. 그렇지 않다면 호스팅된 API로 시작하세요. 아래 단계는 vLLM을 사용하며, 마지막에 SGLang 대안을 제공합니다. 작동하는 요청을 확보한 후 호스팅 비용을 비교하세요.
설정, 다운로드, 실행, 초기 검증 명령은 GPU 서버의 Bash 셸에서 실행하세요. 노트북에서 작업 중이라면 먼저 해당 서버에 SSH로 연결하세요. 이후 Python 클라이언트는 아래 연결 지침을 사용해 어느 쪽 머신에서나 실행할 수 있습니다.
이 walkthrough는 공식 배포 레시피를 따릅니다. 이 글에서 독립적으로 테스트되지는 않았습니다.
1. GPU 가시성, 스토리지, 연결성 확인
기본 인프라를 다음으로 점검하세요:
nvidia-smi
nvidia-smi topo -m
df -h
대상 GPU가 모두 보이는지, 모델 디렉터리에 충분한 공간이 있는지 확인하세요. 다운로드 캐시, 로그, 향후 체크포인트 버전을 위한 추가 스토리지를 예산에 포함하세요.
멀티 노드 배포에서는 모델 시작을 시도하기 전에 노드 간 통신을 검증하세요.
첫 마일스톤은 좁게 유지하세요: 체크포인트를 로드하고 짧은 텍스트 요청 하나를 완료합니다. 이렇게 하면 장애 진단이 쉬워집니다.
2. 서빙 환경 준비
이 단일 노드 예시는 8개의 B300 GPU를 갖춘 Linux 호스트를 사용합니다. 공개된 레시피와 호환되는 CUDA 환경에서 격리된 환경을 만들고 서빙 도구를 설치하세요:
kimi-local 이름은 애플리케이션이 보는 별칭입니다. 이후 요청에서도 같은 이름을 사용하세요.
32,768 토큰 설정은 이 walkthrough를 위한 보수적 출발점이며, 모델의 최대 지원 컨텍스트가 아닙니다.
--trust-remote-code 옵션은 저장소의 커스텀 코드를 로드하도록 허용합니다. 검토된 체크포인트 리비전을 고정해서 함께 사용하세요.
여기서 127.0.0.1은 클라이언트를 실행하는 머신을 가리킵니다. 아래 curl 점검은 GPU 서버에서 실행되며, 해당 서버의 추론 프로세스에 도달합니다. 노트북에서 Python 클라이언트를 사용하려면, 별도의 노트북 터미널에서 SSH 터널을 열고 유지하세요:
ssh -N -L 8000:127.0.0.1:8000 user@gpu-server
user@gpu-server를 귀하의 SSH 로그인과 서버 주소로 바꾸세요. 이 터널이 열린 상태라면, 노트북 클라이언트는 http://127.0.0.1:8000/v1. 을 사용할 수 있습니다. 노트북에서 8000 포트가 이미 사용 중이라면, 다른 로컬 포트를 선택하고 클라이언트 URL을 업데이트하세요.
추론이 생성 예산의 일부를 소모할 수 있습니다. 요청이 최종 답변을 생성하기 전에 한도에 도달했다면, 예산을 늘리고 재시도한 뒤 서버에 문제가 있다고 결론내리세요.
6. 로컬 Python 애플리케이션 연결
python -m pip install openai
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8000/v1",
    api_key="EMPTY",
    timeout=300.0,
    max_retries=1,
)
response = client.chat.completions.create(
    model="kimi-local",
    messages=[{"role": "user", "content": "Write a Python function that removes duplicate filenames while preserving order."}],
    reasoning_effort="low",
    max_tokens=2048,
)
print(response.choices[0].message.content)
print(response.choices[0].finish_reason)
EMPTY는 API 키 인증이 없는 이 루프백 전용 서버를 위한 플레이스홀더입니다. 인증된 엔드포인트에는 구성한 자격 증명을 사용하세요. 이미지를 입력하고 도구 실행을 검증한 뒤 에이전트에 연결하세요.
SGLang 대안
SGLang의 경우 공식 하드웨어별 요리책을 사용하세요. 단일 노드 walkthrough와 가장 유사하게 B300, Unified, Low-Latency(TP8)를 선택합니다. 표시되는 검증 상태를 확인하세요. 생성된 구성이라고 해서 반드시 테스트가 완료된 구성은 아닙니다.
GPU 서버에서 Docker를 설치하고 NVIDIA Container Toolkit을 구성한 뒤, 다운로드한 체크포인트를 /models/Kimi-K3.1-Pro에 마운트한 컨테이너를 생성하세요. 두 엔진이 같은 GPU를 두고 경쟁하지 않도록 먼저 vLLM을 중지하세요.
컨테이너 내부에서, 선택한 구성에 대해 요리책이 생성한 전체 실행 명령을 붙여넣으세요. 모델 경로는 /models/Kimi-K3.1-Pro로 바꾸고, 서비스 호스트를 0.0.0.0, 포트를 30000으로 설정하며, 하드웨어별 플래그는 유지하세요. Docker 포트 포워딩이 동작하려면 컨테이너가 자신의 네트워크 인터페이스에서 리슨해야 합니다. 위의 호스트 측 포트는 루프백에 바인딩된 상태로 유지됩니다. 서비스 준비 메시지를 기다린 뒤 테스트하세요.
GPU 서버의 두 번째 셸에서 제공 중인 모델을 나열하고, 그다음 models 응답에서 반환된 정확한 모델 ID로 요청을 제출하세요:
curl http://127.0.0.1:30000/v1/models

MODEL_ID="replace-with-id-from-models-response"
curl http://127.0.0.1:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d "{\"model\":\"$MODEL_ID\",\"messages\":[{\"role\":\"user\",\"content\":\"Explain database indexes in three sentences.\"}],\"reasoning_effort\":\"low\",\"max_tokens\":2048}"
성공적인 응답에는 최종 답변이 포함되어야 합니다. 시작이 실패하면 컨테이너 로그를 검사하고, 선택한 하드웨어 레시피와 이미지가 일치하는지 확인하세요. 노트북 접근을 위해서는 포트 30000으로 같은 SSH 터널 패턴을 사용하세요. 컨테이너 전제조건은 SGLang Docker 설치 가이드를 참고하세요.
Kimi K3.1 Pro는 벤치마크에서 어떤 성능을 보이나요?
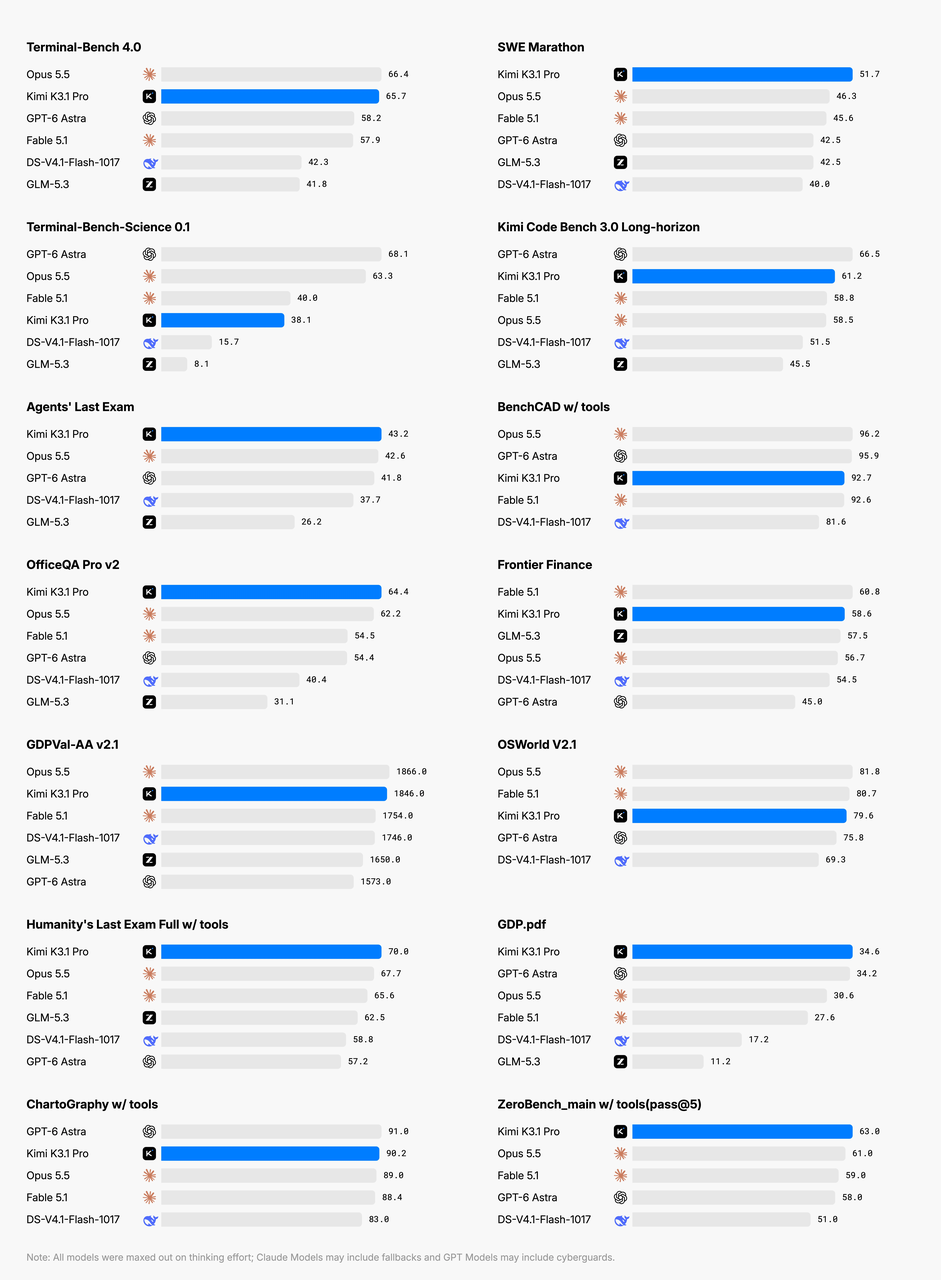
배포 테스트에 사용할 작업을 선택하기 위해 아래 공식 평가 결과를 참조하세요. 이 점수는 본 가이드에서 구성한 로컬 서버를 측정한 것이 아니라, 공개된 평가 설정을 설명합니다.
아래 표는 일부 결과와 모델 카드에 공개된 비교 집합 내 위치를 보여줍니다.
벤치마크 및 공식 결과
모델 점수
해당 비교 내 순위
Terminal-Bench 4.0
65.7
2위
SWE Marathon v1.1
51.7
1위
Program Bench
31.5
4위
OfficeQA Pro v2
64.4
보고된 결과 중 1위
Frontier Finance
58.6
2위
이 결과는 확장된 엔지니어링 작업과 문서 워크플로에서 모델을 시험할 근거를 제공합니다. Kimi K3.1 Pro는 SWE Marathon에서 선두지만 ProgramBench에서는 4위를 기록하므로, 두 벤치마크 모두 애플리케이션별 테스트에 유용합니다.
이 순위는 공식 비교 표 내부에서 산출된 것이며, 실시간 글로벌 리더보드가 아닙니다. 벤치마크마다 평가 하네스, 도구, 추론 예산, 샘플 선택이 다릅니다.
배포 결정을 위해 실제 업무에서 소규모 평가 세트를 구성하세요: 리포지토리 수정, 문서 간 질의, 다단계 도구 작업 등. 완성 품질, 인적 수정, 경과 시간을 측정하세요. 공개 점수는 후보군을 추리는 데 유용하며, 최종 가치는 애플리케이션 테스트가 결정합니다.
Kimi K3.1 Pro 로컬 추론을 어떻게 최적화할 수 있나요?
컨텍스트와 동시성 제어
짧은 요청이 동작하면 긴 문서, 이미지, 멀티턴 대화, 도구 호출을 각각 별도로 테스트하세요.
의도한 컨텍스트 길이와 동시성에서 첫 토큰 지연, 초당 출력 토큰, 피크 GPU 메모리를 추적하세요. 또한 작업 성공률과 성공 과금당 비용을 기록해, 더 빠른 출력이 더 많은 재시도나 인적 수정을 가리지 않도록 하세요.
주요 변수를 한 번에 하나씩만 변경하세요. 컨텍스트 길이, 동시성, 최적화 설정을 동시에 늘리면 성능 회귀의 원인 분석이 어려워집니다.
추론 노력과 캐시 설정을 신중히 선택
작업에 따라 low, high, max 추론 노력을 사용하세요. 인터페이스 점검은 low로 시작하고, 난이도 높은 작업에서는 high와 max를 모두 비교하며 완성 품질과 경과 시간을 함께 봅니다. 더 긴 추론 로그가 더 나은 결과의 증거는 아닙니다.
긴 세션에서는 추측 디코딩이나 더 높은 동시성을 추가하기 전에 캐시 용량과 접두사 재사용을 평가하세요. 검증된 기준선을 유지하고 한 번에 한 설정만 바꾸세요.
배포 후 도구 호출이 실패하는 이유는?
애플리케이션은 도구 호출을 실행하고 그 결과를 반환한 뒤 대화를 이어갑니다. reasoning_content와 tool_calls를 포함해 전체 assistant 메시지를 보존하고, 각 도구 결과를 일치하는 tool_call_id와 함께 반환하세요.
멀티턴 처리도 중요합니다. 모델 사용 지침은 최종 텍스트만 보관하는 대신 전체 assistant 메시지를 추론 및 도구 호출 필드까지 포함해 보존할 것을 요구합니다.
증상
1차 점검 사항
모델 아키텍처를 인식하지 못함
런타임 버전, 커스텀 코드, 구성
로딩 중 메모리 부족
GPU 용량, 병렬화, 경쟁 프로세스
짧은 요청은 동작하나 긴 요청이 실패
컨텍스트 한도, 캐시 용량, 동시성
도구 호출을 파싱할 수 없음
파서 설정과 도구 스키마
도구를 요청한 뒤 에이전트가 멈춤
애플리케이션 실행과 도구 결과 처리
멀티턴 답변이 일관성을 잃음
누락된 assistant 메시지 필드
각 실패를 최소 재현 요청으로 분리하세요. 동작이 확인되면 애플리케이션의 추가 설정을 하나씩 다시 도입하세요.
자체 호스팅과 호스티드 API 중 무엇을 선택해야 하나요?
가중치, 인프라, 데이터 위치를 통제해야 하고 GPU를 유의미하게 가동할 수 있다면 자체 호스팅을 선택하세요. 초기 평가나 변동 수요에는 공식 Kimi API와 CometAPI를 동일한 프롬프트와 합격 기준으로 비교하세요. 각 서비스의 모델 접근, 지원 파라미터, 쿼터, 데이터 처리 약관을 확인하세요.
비용 또는 운영 요소
자체 호스팅
공식 Kimi API / CometAPI
용량 비용
유휴 시간을 포함한 GPU 구매 또는 임대
API 사용량 과금; 제공자별 최신 요율 확인
스토리지와 네트워킹
체크포인트 스토리지, 캐시, 네트워크 비용
애플리케이션 측 스토리지와 네트워크 비용
운영
배포, 모니터링, 업그레이드, 복구
통합, 쿼터 관리, 요청 모니터링
재시도
재시도에 소요된 GPU 시간 포함
재시도의 토큰 또는 호출이 API 청구에 포함됨
인적 검토
동일한 단가로 수정 시간 계상
동일한 단가로 수정 시간 계상
최적 적합
안정적 수요와 인프라 통제
평가 및 변동 수요
유용한 비교식:
성공 과금당 비용 = (GPU 연산 또는 API 요금 + 스토리지와 네트워킹 + 운영 + 인적 수정) / 성공적으로 완료된 작업 수.
동일한 측정 기간의 비용과 성공 작업 수를 사용하세요. 실패와 재시도를 한 번만 연산 또는 API 합계에 포함하고, 재시도를 이중으로 추가하지 마세요. 하이브리드 워크플로라면 연산과 API 비용을 모두 포함하세요. 요청 시도가 아니라 고유한 완료 작업을 집계하세요.
이론적 처리량이 우수해도 활용도가 낮은 서버는 비용이 높을 수 있습니다. 반대로, 기존 인프라, 안정적 수요, 엄격한 데이터 요구를 가진 팀은 자체 호스팅으로 큰 가치를 얻을 수 있습니다.
배포 경로를 비교할 때 프롬프트와 합격 기준을 동일하게 하세요. 의사결정에는 종단 간 지연과 출력 품질을 포함하세요.
가중치를 로드하지 않고 호스티드 엔드포인트를 시험해 보기
공식 Kimi API 퀵스타트는 아래 엔드포인트를 사용합니다. 환경 변수로 MOONSHOT_API_KEY를 설정하고 계정에서 모델 접근을 확인하세요. 이 요청은 제공자 인프라에서 실행됩니다.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["MOONSHOT_API_KEY"],
    base_url="https://api.moonshot.ai/v1",
)
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Explain database indexes in three sentences."}],
    reasoning_effort="low",
    max_completion_tokens=2048,
)
print(response.choices[0].message.content)
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_API_KEY"],
    base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Explain database indexes in three sentences."}],
    max_tokens=2048,
)
print(response.choices[0].message.content)
동일한 합격 기준으로 로컬 엔드포인트와 결과를 비교하세요. 프로덕션 비용 추정 전 현재 라우트 가격과 지원 파라미터를 확인하세요.
결론
Kimi K3.1 Pro는 지원되는 GPU 구성과 일치하는 추론 환경이 있다면 자체 호스팅이 실용적입니다. 위 배포 단계를 통해 동작하는 엔드포인트를 확보한 뒤, 귀하의 워크로드에서 작업 품질, 지연, 비용을 측정하세요. 애플리케이션을 아직 검증 중이거나 적합한 하드웨어가 없다면 호스티드 API를 선택하세요.
자주 묻는 질문
일반 노트북으로 전체 모델을 실행할 수 있나요?
원본 체크포인트의 용량 요구사항을 고려할 때 일반 노트북은 실용적인 대상이 아닙니다. 대신 자체 추론 서버나 호스티드 API에 연결하는 클라이언트로 사용할 수 있습니다.
데스크톱 애플리케이션 설치가 로컬 배포를 의미하나요?
애플리케이션의 설치 위치는 추론이 어디서 실행되는지와 별개입니다. 자체 호스팅은 귀하가 통제하는 인프라에서 모델 가중치와 추론 프로세스가 실행되어야 합니다.
활성 파라미터가 104B인데 왜 메모리가 그렇게 많이 필요한가요?
토큰마다 선택되는 전문가가 달라질 수 있습니다. 활성 파라미터는 연산에 참여하는 양을 말하며, 배포는 여전히 전체 가중치 집합을 저장하고 접근해야 합니다.
백만 토큰 컨텍스트를 바로 활성화할 수 있나요?
대상 동시성에서 GPU 메모리 사용을 측정하며 컨텍스트 길이를 점진적으로 늘리세요. 모델은 1,048,576 토큰을 지원하지만, 사용 가능한 서빙 용량은 캐시와 병렬화 설정에 따라 달라집니다.
로컬 배포가 공개된 벤치마크 점수를 재현하나요?
자동으로 그렇지는 않습니다. 양자화, 추론 예산, 도구, 프롬프트, 평가 프레임워크가 모두 결과에 영향을 줄 수 있습니다. 귀하의 작업에 맞춰 구성을 검증하세요.
하드웨어를 구매하기 전에 API로 먼저 테스트해야 하나요?
모델이 품질 요구를 충족하는지 확정하지 못했다면, API 테스트가 인프라 작업을 줄이며 초기 기준선을 제공합니다. 적합한 하드웨어가 있고 명확한 데이터 거주 요건이 있다면 통제된 자체 호스팅 평가로 바로 진행할 수 있습니다.