
TL;DR
Meta는 2026년 10월 12일 Muse Wonder와 Muse Wonder Full을 출시했다. Wonder는 Meta Model API와 Muse Code에서 제공되며, Full은 Muse Code의 Power Usage 및 Maximum Usage 구독을 통해 제공된다. Full은 일부 공개 벤치마크에서 앞서지만, 실제 선택은 API 접근성, 작업 품질, 비용에 달려 있다. 본 비교는 공개 출처를 검토한 것이며 독립적인 직접 테스트는 포함하지 않는다.
Key Takeaways
- Wonder는 API 통합을 지원하며, Full은 Muse Code의 Power Usage 및 Maximum Usage 구독으로 이용 가능하다.
- Meta의 런칭 차트는 Artificial Analysis Intelligence Index에서 Wonder 52, Full 56을 보고한다. 4포인트 격차는 작업 성능의 보편적 퍼센트 향상을 의미하지 않는다.
- Wonder는 1,048,576-토큰 컨텍스트 윈도우와 텍스트·이미지·오디오·비디오·PDF 입력, 텍스트 출력을 지원한다.
- Meta 표준 API 요금은 입력 $4, 캐시된 입력 $0.20, 출력 $20(각 100만 토큰 기준)이며, Full은 공개된 토큰 당 Model API 요금이 없다.
- 최대 추론 노력 설정을 선택해도 Full이 선택되는 것은 아니다. 애플리케이션에는 Wonder로 시작하고, Muse Code에서의 고난도 인터랙티브 작업에는 Full을 평가하라.
Muse Wonder vs Muse Wonder Full: Overview and Specifications
제품이나 자동화 워크플로에 호출 가능한 모델이 필요할 때는 Wonder로 시작하라. Muse Code를 사용하고 그 벤치마크 강점이 작업과 관련 있을 때 Full을 평가하라. 액세스에는 Power Usage 또는 Maximum Usage 구독이 필요하며, 플랜 한도의 적용을 받는다. 실질적 차이는 우선 접근성, 그다음 벤치마크 성능이다.
| Decision factor | Muse Wonder | Muse Wonder Full |
|---|---|---|
| Start testing with | 프로덕션 API, 커스텀 에이전트, 배치 처리 | Muse Code에서의 난이도 높은 인터랙티브 코딩 및 전문 작업 |
| Provider access | Meta Model API 및 Muse Code | Muse Code Power Usage 또는 Maximum Usage |
| Public Meta API model ID | muse-wonder-1.0 | 공개 Model API 식별자 없음 |
| Context window | 1,048,576 tokens | 모델 카드에 추론 시 1M tokens |
| Input and output | 텍스트·이미지·오디오·비디오·PDF 입력; 텍스트 출력 | 모델 카드 수준의 텍스트·이미지·오디오·비디오 입력 및 텍스트 출력; Muse Code 지원 여부 확인 |
| Meta API input / cached input / output per 1M tokens | $4 / $0.20 / $20 | 공개된 토큰 당 Model API 가격 없음 |
| CometAPI access status | 제공됨; 계정 라우트와 빌링 확인 | 2026년 10월 16일 기준 곧 제공 예정 |
| Primary selection criterion | 수용된 작업 품질, 신뢰성, 총 작업 비용 | 지원 제품 및 구독 할당량 내 수용된 작업 품질 |
이 표는 아래에서 논의하는 사양, 공개 결과, 상업 조건을 요약한다. 모델 수준의 모달리티는 모든 엔드포인트에서 동일한 지원을 보장하지 않는다. Full의 모델 카드에 명시된 컨텍스트 한도는 공개 API 계약이 아니다.
두 변형 모두 복잡한 코딩과 개인/전문 에이전트형 작업을 목표로 한다. 문서화된 주요 차이는 공개 성능과 접근 옵션이다: Wonder는 Meta Model API와 Muse Code에서 제공되고, Full은 적격 Muse Code 구독을 통해 제공된다.
Muse Wonder for Programmable Workflows
Meta는 지속적 추론, 도구 사용, 소프트웨어 엔지니어링, 난이도 높은 지식 작업에 중점을 둔 개인 및 전문 에이전트형 워크플로를 위한 최전선 AI 시스템으로 Muse Wonder 모델 패밀리를 소개했다.
Muse Wonder는 Meta의 Model API와 Muse Code를 통해 접근 가능한 표준 모델이다. 코딩 어시스턴트, 문서 분석, 멀티모달 시스템, 장시간 실행 에이전트를 설계하는 개발자에게 적합하다. API 인터페이스는 직접적인 워크로드 측정, 사용량 기반 과금, 프로덕션 소프트웨어와의 통합을 가능하게 한다.
Muse Wonder Full for Demanding Interactive Work
Muse Wonder Full은 특히 까다로운 워크플로에 최적화된 더 강력한 변형이다. Meta의 출시 자료는 이를 전문 분석과 장기적 코딩과 연계한다. 출시 시점에는 공개 API의 별도 요금이 아닌 적격 Muse Code 구독 플랜에 액세스가 묶여 있다.
API 명세는 Wonder의 멀티모달 입력, 정확한 컨텍스트 한도, 추론 제어를 문서화한다. Full은 패밀리 수준의 모델 카드 설명이 있지만, 이에 상응하는 공개 API 계약은 없다. 패밀리 공통 기능이 있다고 해서 엔드포인트 매개변수나 제품 업로드 한도가 동일하다는 뜻은 아니다.
Active Memory, Active Focus, and Reasoning Settings
Meta는 유용한 컨텍스트를 보존하고 어려운 작업에서 목표 지향적 진행을 유지하도록 설계된 두 메커니즘으로 Active Memory와 Active Focus를 설명한다. 이는 애플리케이션 수준의 검증, 권한, 휴먼 오버사이트의 필요를 제거하지 않는다.
Wonder를 최대 추론 노력 수준으로 설정해도 Wonder Full로 바뀌지 않는다. 차이는 요청 내 토글이 아니라 모델 접근의 차이다.
Muse Wonder vs Muse Wonder Full: Performance
Published Benchmarks and Source Boundaries
Wonder Full이 보고된 종합 지수에서 앞서지만, 벤치마크 점수는 선택된 평가에서의 성능을 측정할 뿐, 보편적 퍼센트 향상을 의미하지 않는다. 배포 결론을 내리기 전 동일한 벤치마크 버전, 추론 설정, 평가 날짜를 비교하라.
| Evaluation | Muse Wonder | Muse Wonder Full | Metric / reported setting |
|---|---|---|---|
| AA Intelligence Index v4.3 | 52 | 56 | 종합 지수; Artificial Analysis; 최대 노력 |
| AutomationBench-AA | 39.1 | 45.4 | 엄격한 pass@1; 시뮬레이션된 비즈니스 워크플로; Artificial Analysis |
| SWE-Marathon | 53.1 | 57.5 | pass@1; 프로젝트 테스트; Abundant AI; Full은 xhigh |
| Terminal-Bench 4.0-AA | 52.0 | 57.1 | 정확도; 실행 검증이 가능한 독립 터미널 작업; Artificial Analysis |
| DeepSWE 1.1 | 78.8 | 79.0 | pass@1; 기능 및 회귀 테스트; Datacurve 결과 |
| MemoryBench | 85.6 | 85.5 | 내부 대화 메모리 벤치마크; LLM 판정 리콜 |
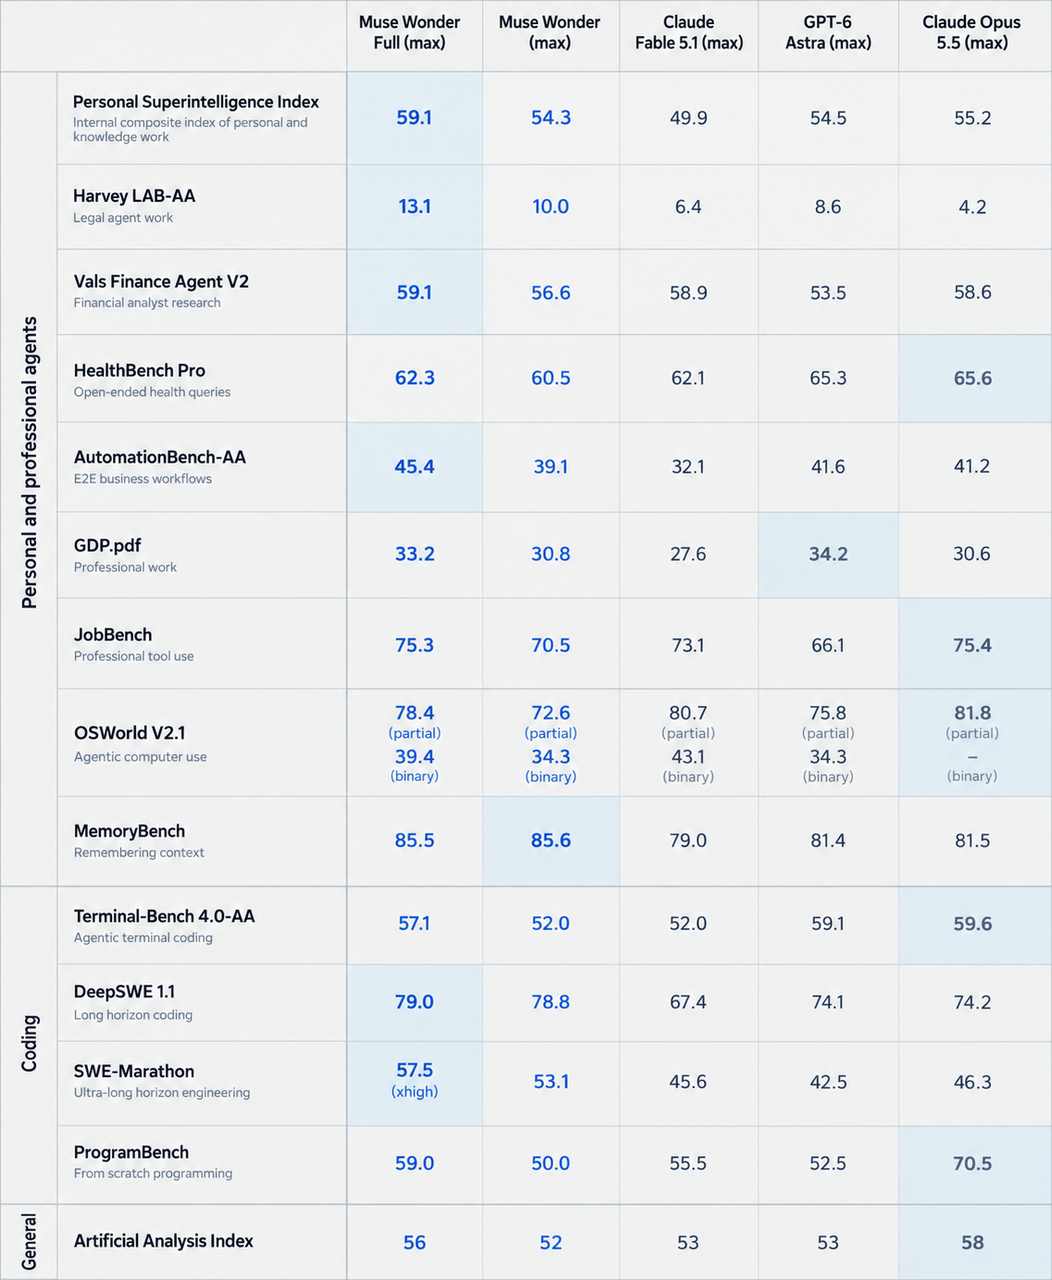
공식 Meta 모델 카드 스코어카드(재도식 없이 재현). 동반된 방법론은 결과 출처와 설정을 식별한다.
Evaluation Conditions
Meta의 평가 방법론은 별도 표기가 없으면 최대 추론을 사용한다. SWE-Marathon은 모든 모델에 대해 통제된 공통 하니스가 아닌 벤더가 보고한 환경을 사용한다. 이는 Meta가 요약한 서드파티 결과이며, 네 가지가 동일하게 통제된 내부 테스트가 아니다. 릴리스 스냅샷은 라이브 리더보드가 아닌 2026년 10월 12일 기준이다.
DeepSWE는 기능 및 회귀 테스트를 사용해 장기 저장소 작업을 측정한다. MemoryBench는 LLM 판정을 통해 64K~100K 토큰 대화에서의 리콜을 측정한다. 이 점수들은 서로 다른 행동을 평가하며 상이한 채점 체계를 사용한다. 보고된 0.1포인트 MemoryBench 격차는 평가 변동성 정보를 모르면 실용적 순위를 뒷받침하기에 너무 작다.
Coding and Software Engineering
인용된 코딩 결과에서 Full이 앞서지만, 격차의 크기는 다르다: DeepSWE는 0.2포인트, SWE-Marathon은 4.4, Terminal-Bench는 5.1 차이다. 이 패턴은 어려운 장기 작업에서 Full을 테스트할 근거가 되지만, 모든 코드 리뷰나 짧은 구현에 Full이 필요함을 보여주지는 않는다. API 가용성은 별도의 배포 제약으로 남는다.
Memory and Long-Running Agents
보고된 모든 지표에서 Full이 앞서는 것은 아니다. 공식 스코어카드에서 MemoryBench는 Full 85.5, Wonder 85.6이다. 이 근소한 동률은 실제 메모리 동작(정정된 사실, 오래된 지시사항, 프로젝트 격리 포함)을 테스트할 이유로 보라. 종합 지수가 더 높다고 해서 더 나은 지속성을 보장한다고 가정하지 말고, Active Focus를 엔드투엔드 완성과 실패 단계에서의 회복을 통해 평가하라.
Latency and Reliability
인용 자료는 Wonder API와 Muse Code의 Full 사이에서 일치하는 지연 순위를 확립하지 않는다. 유용한 출력까지의 시간, 중앙값 및 95백분위 작업 소요, 타임아웃 빈도, 재시도, 휴먼 개입 없이 완료를 측정하라. 제품 수준 비교가 모델만의 실험으로 제시되지 않도록 각 면의 도구, 추론 설정, 런타임, 작업 한도를 기록하라.
Muse Wonder vs Muse Wonder Full: Cost
Official API Prices and Subscription Units
Meta는 Wonder API 표준 요금으로 입력 $4, 캐시된 입력 $0.20, 출력 $20(각 100만 토큰 기준)을 게시한다. Full은 구독 기반 접근 모델을 사용하므로 동일한 토큰 가격 계산이 적용되지 않는다.
Meta의 Power Usage와 Maximum Usage 플랜은 Muse Code에서 Wonder와 Full 모두를 포함한다. 혜택과 가용성은 지역에 따라 다를 수 있으므로, 예산 수립 전 현재 제공 내용과 계정 할당량을 확인하라. 이 구독은 제한된 인터랙티브 사용을 제공하며, 무제한 프로덕션 API 호출을 포함하지 않는다.
토큰 비용 예시: 캐시되지 않은 입력 토큰 100,000개는 $0.40, 출력 토큰 20,000개는 $0.40으로 총 $0.80이다. 다단계 에이전트 실행은 요청 간 추가 토큰 사용과 도구 비용이 발생할 수 있다.
Meta는 토큰 요금과 별도로 웹 검색 그라우딩을 1,000건의 검색 쿼리당 $2.50로 명시한다.
CometAPI Billing Conditions
Muse Wonder는 CometAPI에서 제공되며, 계정별·라우트 수준 가격이 적용된다. 프로덕션 트래픽을 보내기 전에 Meta의 게시 단가와 별도로 입력, 출력, 캐시된 입력 및 기타 과금 조건을 확인하라. 2026년 10월 16일 기준 Muse Wonder Full은 Coming soon으로 표시되므로, 이는 사용 가능한 API 라우트나 가격 견적, 출시 약속이 아니다.
Cost per Accepted Task
수용된 산출물을 먼저 정의한 다음 비용을 측정하라. 청구된 모델 및 도구 비용(과금되는 재시도와 폴백 포함)의 합을 수용된 산출물 수로 나누라. 검토 작업은 별도로 기록하거나 명시적 시급을 적용하라. Full의 경우 구독 할당량 내에서 완료된 유용한 작업도 추적하라. 월 정액과 토큰 당 요금은 서로 다른 단위이므로, 헤드라인 가격만으로 더 저렴한 워크플로를 판별할 수 없다.
Muse Wonder vs Muse Wonder Full: Comparison and Selection
Capability and Workload-Based Selection
프로덕션 API 통합, 배치 문서 처리, 커스텀 에이전트, 재현 가능한 A/B 테스트에는 Muse Wonder를 선택하라. 호출 가능한 API와 사용량 기반 과금은 워크플로 자동화, 도구 동작 점검, 회귀 테스트 실행, 수용된 작업 당 비용 측정을 가능하게 한다. 배포 통제와 반복 가능성이 핵심 요구일 때 여기서 시작하라.
적격 구독이 있고 보고된 벤치마크 강점이 어려운 장기 과제에 부합한다면, Muse Code에서 복잡한 인터랙티브 리팩터링과 전문 분석에는 Muse Wonder Full을 선택하라. 그 장점이 자동으로 프로덕션 API 애플리케이션으로 이전되는 것은 아니다.
Application and Automation Workflows
Muse Wonder는 리포지토리 Q&A, 스크립트 기반 코드 리뷰, 문서 추출, 검색 결합 어시스턴트, 커스텀 에이전트에 합리적인 선택이다. API 접근은 팀이 지연을 모니터링하고, 도구 동작을 추적하며, 회귀를 자동화하고, 비용 한도를 설정할 수 있게 한다.
서비스나 배치 파이프라인의 경우 지원되는 Wonder API 라우트를 먼저 평가하라. 애플리케이션이 요청, 도구 실행, 재시도, 미터링을 명시적으로 통제할 수 있게 해준다. 작업이 Muse Code에서만 제공되는 기능에 의존한다면, 그 작업은 운영 제약을 별도로 갖는 인터랙티브 워크플로로 평가하라.
Interactive Coding and Professional Analysis
여러 파일에 걸친 장시간 코딩 세션, 대규모 리팩터링, 복잡한 전문 분석에서는 여러 공개 벤치마크에서 더 높은 점수를 보인 Full을 평가할 가치가 있다. 접근 제약 때문에 그 이점이 프로덕션 API 애플리케이션에 자동으로 전이되는 것은 아니다.
대표적인 리팩터, 조사, 완성 산출물을 사용해 Full이 교정 반복이나 리뷰 노력을 줄이는지 테스트하라. 반복 작업의 의존성으로 삼기 전에 실제 구독 할당량을 확인하라. 작업에서의 개선 폭이 작다면, 표준 변형만으로도 이미 수용 기준을 충족할 수 있다.
Production Evaluation Criteria
실용적 평가를 위해 최소 세 가지 증거를 수집하라: 엔드투엔드 작업 완료, 완성 산출물의 품질, 재시도와 휴먼 리뷰를 포함한 총 소모 노력. 종합 지수 4포인트 우위는 복잡한 에이전트에서는 중요할 수 있지만, 단순 분류 작업에서는 눈에 띄는 차이가 없을 수도 있다.
Where Can You Access Muse Wonder and Muse Wonder Full?
Official Provider Access
표준 Wonder는 Meta Model API를 사용하거나 Muse Code 내에서 접근하라. Full은 적격 Muse Code 구독이 필요하며, 표준 모델을 최대 노력으로 설정해도 선택된 변형이 바뀌지 않는다. 테스트 전에 정확한 계정 권한, 지원 요청 기능, 사용 한도를 확인하라.
CometAPI 통합은 Muse Code를 통한 Wonder Full 접근과는 별개다. Muse Code 구독이 재사용 가능한 프로덕션 API 자격증명이나 무제한 처리량을 제공한다고 가정해서는 안 된다.
CometAPI Access
개발자는 CometAPI에서 Muse Wonder API를 사용할 수 있다: https://www.cometapi.com/models/meta/muse-wonder/ . Muse Wonder Full API는 2026년 10월 16일 기준 Coming soon으로 표시되어 있으며, 이는 출시일이나 호출 가능한 엔드포인트를 확정하지 않는다: https://www.cometapi.com/models/meta/muse-wonder-full/ . 배포 전에 계정 가격과 지원 필드를 확인하라.
CometAPI 요청의 경우 선택한 라우트에 문서화된 모델 식별자를 사용하라. 다단계 작업을 시작하기 전에 지원되는 메시지 형식, 도구 의미론, 상태 처리를 확인하라. 라우팅 변경으로 작업 완료에 필요한 정보가 조용히 유실되지 않도록 애플리케이션에서 검증된 작업 상태를 보존하라.
Conclusion
Muse Wonder와 Muse Wonder Full은 밀접하게 관련되어 있지만 상업적·운영적으로 다르다. Wonder는 애플리케이션 구축을 위한 문서화된 멀티모달 장문맥 API를 제공하고, Full은 더 강한 보고 성능을 제공하지만 더 좁은 인터랙티브 접근을 제공한다. 종합 점수는 유용한 근거이되 보편적 의사결정 규칙은 아니다. 실제 배포 가능한 버전을 자신의 작업, 제약, 지연, 비용에 대해 테스트하라.
FAQ
How should teams compare Muse Wonder API with Full in Muse Code?
동일한 리포지토리 스냅샷, 작업 지침, 수용 테스트, 리뷰 루브릭을 사용하라. 각 면의 도구 접근, 추론 설정, 경과 시간, 재시도, 휴먼 개입을 기록하라. 결과를 워크플로 비교로 취급하라: API 에이전트와 Muse Code는 서로 다른 도구와 실행 루프를 제공할 수 있으므로, 품질 차이를 모델 가중치만으로 자동 귀속할 수 없다.
What happens when a Muse Wonder Full subscription reaches its limit?
Meta의 구독 규칙은 한도에 도달하면 사용자에게 업그레이드 또는 리프레시 대기를 요구한다(https://dev.meta.ai/docs/muse-code/subscriptions). Maximum Usage 구독자는 리셋을 기다려야 한다. 추가 API 키는 종량제 별도 과금이며, Full은 공개 Model API로 제공되지 않는다. 구독이 무제한 처리량을 제공한다고 가정하지 말고 계정의 실제 할당량에 맞춰 인터랙티브 작업을 계획하라.
Can Muse Wonder API persist business records across independent requests?
패밀리 수준 메모리 기능을 애플리케이션 데이터 스토어의 대체로 사용하지 마라. 작업에 내구성 있는 기록이 필요하면 이를 명시적으로 보존하고, 관련 자료를 검색해 지원되는 요청 인터페이스로 전달하라. 실제 제공자 라우트에서 격리, 보존, 검색 동작을 테스트하라. 모델의 컨텍스트 용량만으로는 요청 간 지속성이 보장되지 않는다.
How should teams estimate the cost of a Muse Wonder agent task?
실패 시도와 재시도를 포함한 전체 도구 루프 전반의 입력, 캐시된 입력, 출력 사용량을 측정하라. 도구 비용과 휴먼 리뷰 시간을 더한 뒤, 수용된 산출물 당 비용을 비교하라. Full의 경우 구독 할당량 대비 완료된 유용한 작업과 소요 시간도 추적하라. 토큰 단가와 월 구독료는 서로 다른 구매 단위이므로, 어느 하나만으로 더 저렴한 워크플로를 결정할 수 없다.