프롬프트 캐싱은 언어 모델이 동일한 입력 계산을 반복하는 대신, 이전에 처리된 프롬프트 프리픽스(앞부분)를 재사용하도록 합니다. 특히 에이전트 워크플로, 고객 지원, RAG, 대규모 문서 분석에서 입력 토큰 비용을 낮추고 지연시간을 개선할 수 있습니다. 2026년 기준으로 OpenAI는 자동 캐싱과 최신 명시적 캐시 제어를 제공하고, Claude는 자동 및 블록 수준 캐시 브레이크포인트를 지원하며, Gemini는 최신 모델에서 암시적 캐싱을 강조합니다. 공급자는 캐시 쓰기, 읽기, 그리고 해당되는 경우 저장에 대해 서로 다른 요금을 부과합니다. 만료는 다시 쓰기 또는 전체 입력 비용을 유발할 수 있으므로, 실제 절감 효과는 재사용 빈도와 측정된 캐시 적중률에 따라 달라집니다.
이 가이드는 반복 입력을 사용하는 애플리케이션을 구축하는 개발자를 위해 GPT-6.1 Sol, Claude Opus 5.5, Gemini 4 Argon의 프롬프트 캐싱을 비교합니다. 캐시 제어, 가격, 재사용 검증 방법에 초점을 둡니다.
Key Takeaways
프롬프트 캐싱은 이전 응답을 재사용하는 것이 아니라, 처리된 입력을 재사용합니다.
OpenAI 프롬프트 캐싱은 안정적인 프리픽스, 지원되는 모델 기능, 모델별 최소 요건과 보존 설정에 따라 달려 있습니다.
Claude 프롬프트 캐싱은 5분 및 선택적 1시간 TTL을 제공하며, 자동 및 명시적 캐시 제어를 제공합니다.
Gemini 컨텍스트 캐싱은 최신 모델에서 암시적으로 동작합니다. 명시적 캐시 리소스 지원은 모델에 따라 다릅니다.
프롬프트 캐싱 절감 효과는 캐시 쓰기, 읽기, 저장 및 실제 적중에 따라 달라집니다. CometAPI 사용 시 엔드포인트 지원과 캐시된 토큰 과금 방식을 확인하세요.
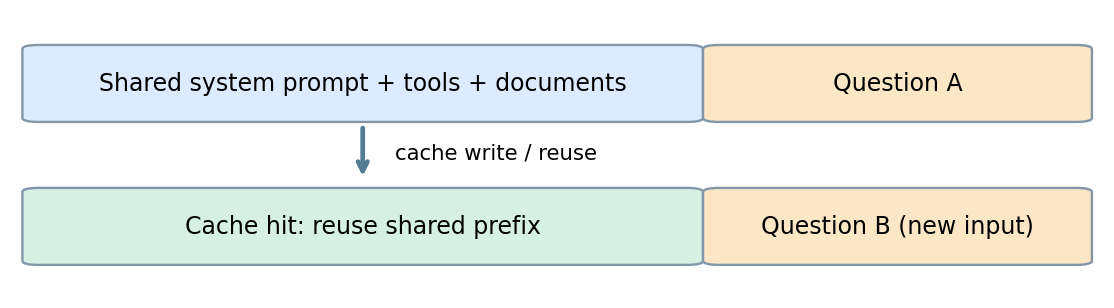
프롬프트 캐싱은 이전에 처리된 프리픽스에서 도출된 연산 상태를 재사용하게 해주는 추론 최적화입니다. 프롬프트에는 흔히 안정적인 지침, 도구 정의, 문서가 포함되고, 그 뒤에 변경되는 사용자 질문이 따라옵니다. 이후 요청에서 해당 가능한 프리픽스를 반복하면, 공급자는 캐시된 키-값(KV) 상태를 재사용하고 캐시되지 않은 나머지 부분만 처리할 수 있습니다. 응답 캐싱과 달리, 이전 답변을 재생하지 않습니다. 모델은 현재 요청에 대해 새로운 응답을 생성합니다.
프롬프트 캐싱 워크플로:
첫 요청: 큰 규모의 반복 가능한 프리픽스와 특정 질문을 보냅니다.
캐시 생성: 공급자가 해당 가능한 중간 연산 상태를 저장합니다.
다음 요청: 동일한 프리픽스를 재사용하고 질문을 교체합니다.
캐시 읽기: 이전에 처리된 토큰을 재사용하고 새 토큰은 정상 처리됩니다.
원고와 함께 제공된 개념적 일러스트: 반복되는 프롬프트 자료 뒤에 변경되는 질문이 이어집니다. 이는 공식 제공자 아키텍처 다이어그램이 아닙니다.
공통 설계 원칙은 프리픽스의 안정성입니다. API 계약, 해당 모델군, 캐시 수명, 요금은 서로 호환되지 않습니다.
OpenAI, Claude, and Gemini Caching at a Glance
동일한 안정적 프리픽스 원칙이 공급자 전반에 적용되지만, 아래 제어는 본 가이드에서 사용하는 모델에 특화되어 있습니다. 설정을 복사하기 전에 모델과 엔드포인트를 함께 확인하세요.
Parameter
OpenAI: GPT-6.1 Sol
Claude: Opus 5.5
Google: Gemini 4 Argon
Cache activation
암시적 매칭; 명시적 브레이크포인트 지원
요청 수준 또는 콘텐츠 블록 cache_control로 옵트인
기본적으로 암시적 캐싱 활성화
Minimum prefix
1,024개의 보이는 입력 토큰
캐시 경계 전 512 토큰
4,096 입력 토큰
Lifetime controls
Responses API: prompt_cache_options.ttl; 기본 30m 또는 12h
기본 5분; 선택적 1시간 TTL
공급자 관리형 암시적 수명
Where to place stable content
선행 지침, 도구, 참고 자료
브레이크포인트 이전의 안정적인 도구 정의, 시스템 콘텐츠, 메시지 블록
프롬프트 시작부에 큰 공유 콘텐츠
Usage to inspect
input_tokens_details.cached_tokens 및 보고된 cache-write 사용량
cache_creation_input_tokens 및 cache_read_input_tokens
prompt_cache_key는 회계를 분리할 수 있으나, Sol의 자동 라우팅에 필수는 아님
브레이크포인트는 변경되지 않는 콘텐츠 끝에서 종료되어야 함
Argon에는 명시적 캐시 리소스 없음; 이전 지원 모델은 별도 인터페이스 제공
Prompt Caching Controls and Python Examples
각 예시는 동일한 참고 자료를 두 개의 다른 질문과 함께 보냅니다. 공유 콘텐츠를 변경하지 말고, 요청을 순차적으로 실행한 뒤 사용량을 확인하여 두 번째 요청이 실제로 캐시된 입력을 재사용했는지 확인하세요.
OpenAI: Cache Controls and Python Example
OpenAI는 캐시 적합 프롬프트 프리픽스를 자동으로 매칭하며, 지원되는 최신 모델에서는 명시적 브레이크포인트 및 보존 구성도 허용합니다. 긴 시스템 지침, 도구 스키마, 저장소 컨텍스트가 요청 간 반복될 때 캐시 재사용이 특히 유용합니다. 필요한 프리픽스 길이와 토큰 가격 계수는 모델 세대와 선택한 보존 티어에 따라 달라집니다.
openai SDK를 설치하고 OPENAI_API_KEY를 설정하세요. 안정적인 프리픽스에 최소 1,024개의 보이는 토큰을 사용하세요. 두 요청을 순차적으로 실행하고, input_tokens_details.cached_tokens와 사용량의 cache_write_tokens를 확인하세요. 캐시된 토큰 수가 양수이면 캐시 읽기 요금이 청구되었음을 의미하며, 모든 요청에서 낮은 지연시간을 보장하는 것은 아닙니다.
예제를 실행하려면 관련 Python SDK를 설치하고, 공급자의 API 키를 설정한 뒤 해당 모델의 캐싱 최소 요건을 충족하는 충분한 안정적 콘텐츠를 담은 UTF-8 reference.txt 파일을 생성하세요.
from pathlib import Path
from openai import OpenAI

client = OpenAI()  # Reads OPENAI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
questions = ["Summarize the architecture.", "Identify the main technical risks."]
for question in questions:
    response = client.responses.create(
        model="gpt-6.1-sol",
        instructions="Use the following reference material.\n" + shared,
        input=question,
        prompt_cache_key="docs-assistant-v1",
        prompt_cache_options={"mode": "implicit", "ttl": "30m"},
    )
    print(response.output_text)
    print(response.usage)
Claude: Cache Controls and Python Example
Claude Messages API에서 프롬프트 캐싱은 옵트인입니다. 요청 수준에서 cache_control을 추가하여 자동 브레이크포인트 배치를 사용하거나, 콘텐츠 블록에 첨부하여 명시적 브레이크포인트를 표시할 수 있습니다. 개발자는 안정적인 지침, 문서, 선택된 프롬프트 블록을 표시하면서 이후 사용자 입력을 변경할 수 있습니다. 표준 단기 캐시는 5분이며, 적합한 워크로드에 대해 1시간 옵션이 있습니다.
anthropic SDK를 설치하고 ANTHROPIC_API_KEY를 설정하세요. Claude Opus 5.5의 경우, 캐시 경계 이전에 최소 512 토큰을 제공하세요. 요청 간 시스템 블록을 동일하게 유지하세요. 캐시 엔트리는 첫 번째 응답이 시작될 때 사용 가능해집니다. 이 예시는 시연을 단순화하기 위해 전체 응답을 기다립니다. 캐시 생성 및 읽기 수치를 확인하세요. 짧은 프리픽스는 오류 없이 둘 다 0을 반환할 수 있습니다.
from pathlib import Path
import anthropic

client = anthropic.Anthropic()  # Reads ANTHROPIC_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=1024,
        system=[{
            "type": "text",
            "text": shared,
            "cache_control": {"type": "ephemeral"},
        }],
        messages=[{"role": "user", "content": question}],
    )
    print(response.content)
    print(response.usage.cache_creation_input_tokens)
    print(response.usage.cache_read_input_tokens)
Gemini: Implicit Caching and Python Example
Google은 이를 컨텍스트 캐싱이라고 부릅니다. Gemini 4 Argon은 암시적 캐싱을 사용하며 명시적 캐시 리소스를 지원하지 않습니다. 일부 이전 모델군은 구성 가능한 TTL과 함께 명시적 캐시를 지원합니다. 모든 Gemini 모델이 동일한 제어를 제공한다고 가정하지 말고, 각 모델의 계약에서 캐싱 인터페이스를 선택하세요.
google-genai를 설치하고 GEMINI_API_KEY를 설정하세요. Gemini 4 Argon의 경우, 선행 공유 콘텐츠를 최소 4,096 토큰으로 사용하고, 첫 번째 요청 직후 두 번째 요청을 보내세요. 존재할 경우 usage_metadata의 cached_content_token_count를 확인하세요. 암시적 캐싱은 프리픽스가 적합하더라도 누락될 수 있습니다.
from pathlib import Path
from google import genai

client = genai.Client()  # Reads GEMINI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.models.generate_content(
        model="gemini-4-argon",
        contents=shared + "\nQuestion: " + question,
    )
    print(response.text)
    print(response.usage_metadata)
How Much Does Prompt Caching Cost Across OpenAI, Claude, and Gemini?
캐싱 비용은 쓰기, 읽기, 그리고 일부 명시적 캐시 시스템에서는 보존 또는 저장을 조합해 평가해야 합니다. 아래 계수는 일반적인 설계를 예시할 뿐, 모델 버전 전반에 대한 보편적 가격 보증이 아닙니다.
Cost category
OpenAI
Claude
Gemini
Uncached input
일반 입력 토큰 요율
일반 입력 토큰 요율
일반 입력 토큰 요율
Cache write
최신 모델에서 쓰기 프리미엄 가능
5분/1시간 프리미엄
모델별 암시적 또는 명시적
Cache read
모델별로 낮춘 요율
모델별로 낮춘 요율
모델별로 낮춘 요율
Cache lifetime
모델별
5분 / 1시간
암시적 관리 / 명시적 구성 가능
Additional storage
모델에 따라 다름
대개 쓰기 티어에 반영
명시적 저장 요금이 적용될 수 있음
예시: 10,000-토큰 프리픽스를 N개의 요청에 재사용하고, 초기 캐시 쓰기 비용이 일반 입력의 1.25배, 이후 캐시 읽기 비용이 일반 입력의 0.1배라고 가정합니다. 기본 입력 가격이 백만 토큰당 $2이고, 첫 요청 후 완벽한 캐시 적중이라고 가정합니다.
Number of requests
Without caching
With caching
Savings on reused prefix
10
$0.200
$0.043
78.50%
100
$2.000
$0.223
88.85%
공식: Cached prefix cost = 1.25P + (N − 1) × 0.1P, 여기서 P는 공유 프리픽스를 한 번 처리하는 일반 비용입니다. 이 예시는 동적 입력, 출력, 만료, 미스, 저장 및 기타 서비스를 제외합니다.
위 예시는 10% 읽기 요율을 예시로 사용하며, 이는 GPT-6.1 Sol의 현재 요율이 아닙니다. Sol의 표준 단기 컨텍스트 가격은 캐시되지 않은 입력 토큰 백만 개당 $2, 캐시된 입력 토큰 백만 개당 $0.10, 기본 보존 기간에서 작성된 토큰 백만 개당 $2.50입니다. 실제 모델, 티어, 엔드포인트 청구를 사용해 예시를 재계산하세요.
더 긴 보존 기간은 충분히 반복 쓰기나 캐시되지 않은 요청을 방지해 그 가격을 상쇄할 때만 가치가 있습니다. Claude의 5분 및 1시간 쓰기는 각각 기본 입력의 1.25배와 2배로 청구됩니다. 지원되는 구형 모델에서 Gemini의 명시적 캐시는 저장 요금을 발생시킬 수 있습니다. 연속 호출의 폭발적 트래픽뿐 아니라 실제 유휴 간격 전반에 걸쳐 재사용을 측정하세요.
미스, 만료, 출력 생성을 비용의 일부로 간주하세요. 프리픽스가 재사용되기 전에 만료되면, 다음 요청은 다시 쓰기 또는 전체 입력 처리가 필요할 수 있습니다. 짧은 프롬프트는 전혀 적합하지 않을 수 있고, 긴 답변은 강한 캐시 재사용에도 불구하고 출력 토큰이 가장 큰 비용이 될 수 있습니다. 더 많은 캐싱 복잡도를 추가하기 전에 완료된 작업당 총 비용을 비교하세요.
Which Prompt Caching API Is Best for Different Workloads?
코딩 에이전트와 고객 지원의 경우, 안정적인 도구 정의, 저장소 컨텍스트, 정책, 지식을 변경되는 작업보다 앞에 배치하세요. OpenAI와 Claude는 재사용 가능한 경계를 정의하는 데 도움이 되는 브레이크포인트 제어를 제공합니다. 반복된 텍스트가 캐시되었다고 가정하지 말고, 엔드포인트의 실제 캐시 읽기를 평가하세요.
문서 분석 및 멀티모달 작업의 경우, 소스 문서 또는 지원되는 미디어를 질문 앞에 유지하세요. Gemini의 암시적 접근은 캐시 관리 작업을 줄이며, Claude는 안정 블록을 직접 표시할 수 있습니다. 재사용에 의존하기 전에 특정 미디어 유형과 모델 지원을 확인하세요.
긴 대화의 경우, 처음을 반복해서 다시 쓰기보다 새 턴을 덧붙이세요. 그리고 턴 간 간격에 맞는 사용 가능한 수명을 선택하세요. 명명된 캐시 리소스가 필요하여 애플리케이션이 이를 생성하고 명시적으로 참조해야 한다면, 해당 인터페이스를 지원하는 Gemini 모델을 평가하세요. Argon은 이를 지원하지 않습니다.
보편적인 승자는 없습니다. 실제 트래픽 패턴에서 캐시 적중률, 작업당 비용, 지연시간을 비교하세요.
How Does Prompt Caching Affect Latency and Performance?
캐시 적중은 반복 입력 처리를 줄여 첫 토큰까지의 시간을 단축할 수 있습니다. 이는 본질적으로 답변 품질을 개선하거나 출력 생성 속도를 높이지 않으며, 캐시된 입력은 여전히 컨텍스트 윈도우를 점유합니다. 유사한 요청에서 첫 토큰 지연과 전체 응답 시간을 모두 측정하세요. 캐시 적중만으로 사용자가 최종 답변을 더 빨리 받았다고 볼 증거가 되지 않습니다.
How to Optimize Prompt Caching and Troubleshoot Misses
Start with a Stable, Useful Prefix
재사용 가능한 지침, 도구 정의, 정책, 문서를 앞에 두고, 타임스탬프, 요청 ID, 변경되는 컨텍스트, 사용자 질문은 뒤에 배치하세요. 도구 순서와 스키마를 안정적으로 유지하세요. 명시적 캐싱을 사용할 때는 브레이크포인트를 마지막으로 변경되지 않는 블록 끝에 두세요. 과제에 도움이 될 때 유용한 참고 자료를 추가하고, 캐시 지표를 위해 모든 요청을 과도하게 부풀리지 마세요.
If Cached Tokens Stay at Zero
프롬프트를 바꾸기 전에 적합성을 확인하세요. 정확한 모델, 엔드포인트, 최소 토큰 길이, 필요한 캐시 제어 설정을 확인합니다. 그런 다음 동일한 공유 콘텐츠로 두 개의 연속 요청을 전송하세요. 캐시 생성과 캐시 읽기를 별도로 확인하세요. 첫 요청이 이후 요청이 재사용할 엔트리를 생성할 수 있습니다. 암시적 캐시는 적중할 수 있는 자격이 있을 뿐, 보장되지는 않습니다.
Claude의 경우, 최소 기준 미만의 요청은 오류 없이 캐시 생성과 캐시 읽기 토큰이 0을 반환할 수 있습니다. 캐시 엔트리는 첫 번째 응답이 시작되면 사용 가능합니다. 브레이크포인트 배치와 변경된 요청 설정이 재사용에 어떤 영향을 주는지 Claude 캐싱 가이드에서 설명합니다.
If Hits Disappear Between Requests
프롬프트 템플릿만이 아니라 실제 페이로드를 비교하세요. 문서 텍스트 변경, 도구 재정렬, 스키마 변경, 초기 대화 턴 재작성, 재사용 경계 이전에 삽입된 동적 필드를 확인하세요. 이전 요청 이후 경과 시간과 선택한 수명이 이를 커버하는지도 확인하세요. 한 번에 한 변수만 변경하고 결과 사용량을 기록하세요.
If Hits Do Not Produce Savings
캐시된 입력, 쓰기, 캐시되지 않은 입력, 출력, 저장 요금을 분리하세요. 유휴 간격 이후 반복 쓰기, 낮은 재사용, 긴 생성된 답변은 입력 할인 효과를 상쇄할 수 있습니다. 측정된 사용량과 엔드포인트의 실제 요율로 위 비용 계산을 적용하세요. 총 작업 비용이나 사용자 체감 지연시간을 개선하는 경우에만 최적화를 유지하세요.
Check Endpoint Support and Data Boundaries
호환성 엔드포인트는 요청을 수락하더라도 네이티브 API와 동일한 캐시 제어나 사용량 필드를 제공하지 않을 수 있습니다. 파라미터 지원을 확인하고, 재사용을 절감으로 간주하기 전에 반환된 사용량과 계정 청구를 비교하세요. 테넌트 격리와 액세스 제어를 유지하고, 공급자의 보존 및 데이터 처리 정책을 준수하세요. 캐싱은 이러한 제어를 대체하지 않습니다.
How Can You Use Prompt Caching with CometAPI?
CometAPI는 모델 패밀리 전반의 요청 테스트를 위한 단일 통합 지점을 제공합니다. 캐싱과 관련해서는 선택한 엔드포인트가 어떤 공급자별 제어를 수용하는지와 캐시된 입력이 사용량과 청구에 어떻게 나타나는지 확인하세요. 개발자는 모델 테스트를 중앙화하면서도 캐싱 동작과 회계를 별도로 검증할 수 있습니다. 네이티브 제공자 옵션이 프록시 또는 호환 엔드포인트 전반에서 동일하다고 보장되지 않기 때문입니다.
openai SDK를 설치하고 COMETAPI_KEY를 설정하세요. 이 예시는 CometAPI의 OpenAI 호환 Chat Completions 인터페이스를 통해 반복 프리픽스 요청을 전송합니다. 모델 가용성을 확인한 뒤, 반환된 사용량과 계정 청구에서 캐시 재사용의 증거를 확인하세요. 확인 없이 Responses API 캐시 파라미터를 이 엔드포인트에 복사하지 마세요.
import os
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.chat.completions.create(
        model="gpt-6.1-sol",
        messages=[
            {"role": "system", "content": shared},
            {"role": "user", "content": question},
        ],
    )
    print(response.choices[0].message.content)
    print(response.usage)
Conclusion
반복이 많은 AI 애플리케이션에서 프롬프트 캐싱은 추론 경제성에 실질적인 차이를 만들 수 있습니다. OpenAI는 점점 더 정교한 프롬프트 및 보존 제어를 제공하고, Claude는 편리한 자동 및 블록 수준 제어를 제공하며, Gemini는 최신 모델에서 암시적 재사용을 간편하게 합니다. 올바른 구현은 안정적인 프롬프트 분량, 적중률, 만료, 총 비용에 달려 있습니다. 명확한 공유 프리픽스를 설정하고 사용량 텔레메트리를 확인한 다음, 실제 운영과 유사한 측정치를 바탕으로 보존과 공급자 선택을 최적화하세요.
FAQ
How can I compare caching providers fairly?
동일한 유용한 소스 문서와 동등한 질문을 재생하되, 각 공급자의 토큰 수와 실제 청구 요율을 사용하세요. 출력 요구사항을 유사하게 유지하고, 성공한 요청뿐 아니라 실패한 요청도 보고하세요. 고정 문자 수가 동일한 토큰 수를 의미하지 않으므로, 캐시 적중 측정과 함께 완료된 작업당 비용을 비교하세요.
Should I cache every document in a changing knowledge base?
문서를 변경 빈도와 재사용 빈도에 따라 그룹화하세요. 자주 업데이트되는 문서는 큰 공유 프리픽스를 반복적으로 무효화할 수 있습니다. 안정적인 정책 자료를 먼저 배치하고 변경되는 자료를 나중에 배치하면 이러한 노출을 줄일 수 있습니다. 소스 자료를 의도적으로 버전 관리하고, 정확성이 필요할 때 갱신하세요. 그렇게 하면 캐시 재사용이 줄더라도 갱신을 수행해야 합니다.