TL;DR: Alibaba는 2026년 11월 16일 Qwen4 세대의 플래그십 모델인 Qwen4-Max를 출시했다. 공식 평가에 따르면 Qwen3.8-Max 대비 업계 과제 성능이 향상되고 실행 비용이 낮아졌으며, 이는 토큰 효율 개선과 API 가격 인하를 반영한다.
핵심 요점
- Model size: Qwen4-Max의 백본 파라미터는 2.4 trillion이며, 토큰당 71 billion이 활성화된다.
- Context window: Qwen4-Max는 one-million-token 컨텍스트 윈도우를 지원한다.
- Multimodal support: Qwen4-Max는 텍스트, 이미지, 비디오 입력을 수용하고 텍스트를 생성한다.
- Developer features: Qwen4-Max는 함수 호출, 구조화된 출력, 컨텍스트 캐싱, 웹 검색을 지원한다.
- Access options: 사용자는 지원되는 Qwen 애플리케이션, 사용량 기반 QwenCloud API, Token Plan 구독을 통해 Qwen4-Max에 액세스할 수 있다.
Qwen4-Max란 무엇인가?
Alibaba의 공식 발표에서 Qwen은 Qwen4-Max를 업무, 창작, 탐색을 위한 AI 동료로 설명한다. 이 모델의 역량은 목표 이해, 도구 운용, 실행 피드백에 대한 응답, 다단계에 걸친 결과 전달에 초점을 맞춘다.
이러한 워크플로에서 모델은 추론과 조정을 제공한다. 연결된 애플리케이션, 도구, 실행 환경이 실제 작업을 수행한다.
Qwen4-Max 사양
official QwenCloud model page에는 다음 사양이 나열되어 있다:
| Specification | Qwen4-Max |
|---|---|
| Model ID | qwen4-max |
| Backbone parameters | 2.4 trillion |
| Activated parameters per token | 71 billion |
| Context window | 1 million tokens |
| Input / output | Text, images, and video / Text |
| Standard mode limits | Maximum input: 991K; maximum output: 131K tokens |
| Thinking mode limits | Maximum input: 983K; maximum output: 262K tokens |
| Maximum reasoning length | 262K tokens |
| Developer capabilities | Function calling, structured outputs, context caching, and web search |
| API compatibility | OpenAI and Anthropic API protocols |
컨텍스트 크기, 입력 제한, 출력 제한은 서로 다른 제약을 의미한다. 애플리케이션은 이들을 동시에 충족하고, 생성되는 답변과 추론을 위한 충분한 용량을 예약해야 한다.
Qwen4-Max의 주요 기능은 무엇인가?
Qwen4-Max의 역량은 여러 문서, 도구, 실행 단계를 아우르는 작업에서 특히 유용하다. 긴 컨텍스트는 작업 배경을 보존하고, 비주얼 이해는 활용 가능한 증거를 확장하며, 에이전트 기능은 작업을 결과 전달을 향해 추진한다.
one-million-token 컨텍스트와 네이티브 비주얼 이해
대형 컨텍스트 윈도우는 관련 자료를 공유된 작업 컨텍스트 내에서 처리할 수 있게 한다. 실제 활용 예로 계약 비교, 코드 파일 간 의존성 분석, 보고서와 보조 문서의 병행 검토가 있다.
네이티브 비주얼 이해는 이를 스크린샷, 다이어그램, 스캔 문서, 비디오로 확장한다. 사용자는 엔지니어링 도면이나 인터페이스 스크린샷을 제공하고 모델이 서면 요구사항과 함께 이를 해석하도록 요청할 수 있다.
문서가 많은 작업에서는 파일명, 날짜, 섹션 레이블을 보존하는 것이 증거를 정리하고 결과 분석의 검증을 쉽게 한다.
코딩 및 전문 도구 활용
Qwen4-Max는 함수 호출을 지원하여 개발자가 데이터베이스, 검색 서비스, 파일 작업, 비즈니스 시스템과 연결할 수 있도록 한다. 구조화된 출력은 모델 결과를 이후 소프트웨어 프로세스로 전달하는 데 도움이 된다.
공식 데모는 더 넓은 소프트웨어 워크플로를 보여준다. 게임 개발에서는 Unity, Unreal Engine, Godot 등의 엔진을 사용해 장면을 구축하고, 게임플레이를 구현하며, 테스트를 통해 결과를 다듬는다. Blender에서는 기하, 머티리얼, 조명, 렌더링을 조율한다.
이러한 워크플로를 재현하려면 해당 소프트웨어, 에셋, 실행 권한이 필요하다. 데모는 그 환경에서 모델이 달성할 수 있는 범위를 보여준다.
장기 지평 에이전트와 Live Delivery
사용자가 완료 시점까지 진행 상황을 확인할 수 없으면 장기 작업은 관리하기 어려워진다. Qwen4-Max의 Live Delivery 접근법은 초기 사용 가능한 결과를 제시하고 이후 연속적인 업데이트를 제공한다.
연구 과제의 경우, 에이전트가 먼저 예비 결과와 출처 목록을 제공한 뒤, 분석을 확장하고 차트를 추가할 수 있다. 사용자는 각 버전을 검토하고 이후 작업의 방향을 조정할 수 있다.
Qwen은 Qwen-Live-Delivery-Plugin도 공개했다. 수 시간 이상의 워크플로에서 단계적 전달은 품질 검토와 방향 수정의 실질적인 체크포인트를 만든다.
아키텍처와 토큰 효율성
Qwen4-Max는 희소 mixture-of-experts 아키텍처에 여러 변화를 도입했다:
- Gated DeltaNet and Qwen Sparse Attention: 과거 정보 압축과 관련 컨텍스트에 대한 선택적 어텐션을 결합해 장문 시퀀스 계산을 줄인다.
- Gated Residual: 네 개의 병렬 잔차 브랜치와 동적 게이트를 사용해 정보 전달과 학습 안정성을 개선한다.
- N-gram Embedding: 조회 기반 연산으로 로컬 토큰 패턴을 표현하기 위해 328 billion 임베딩 파라미터를 추가하여 비교적 낮은 추가 연산으로 용량을 확장한다.
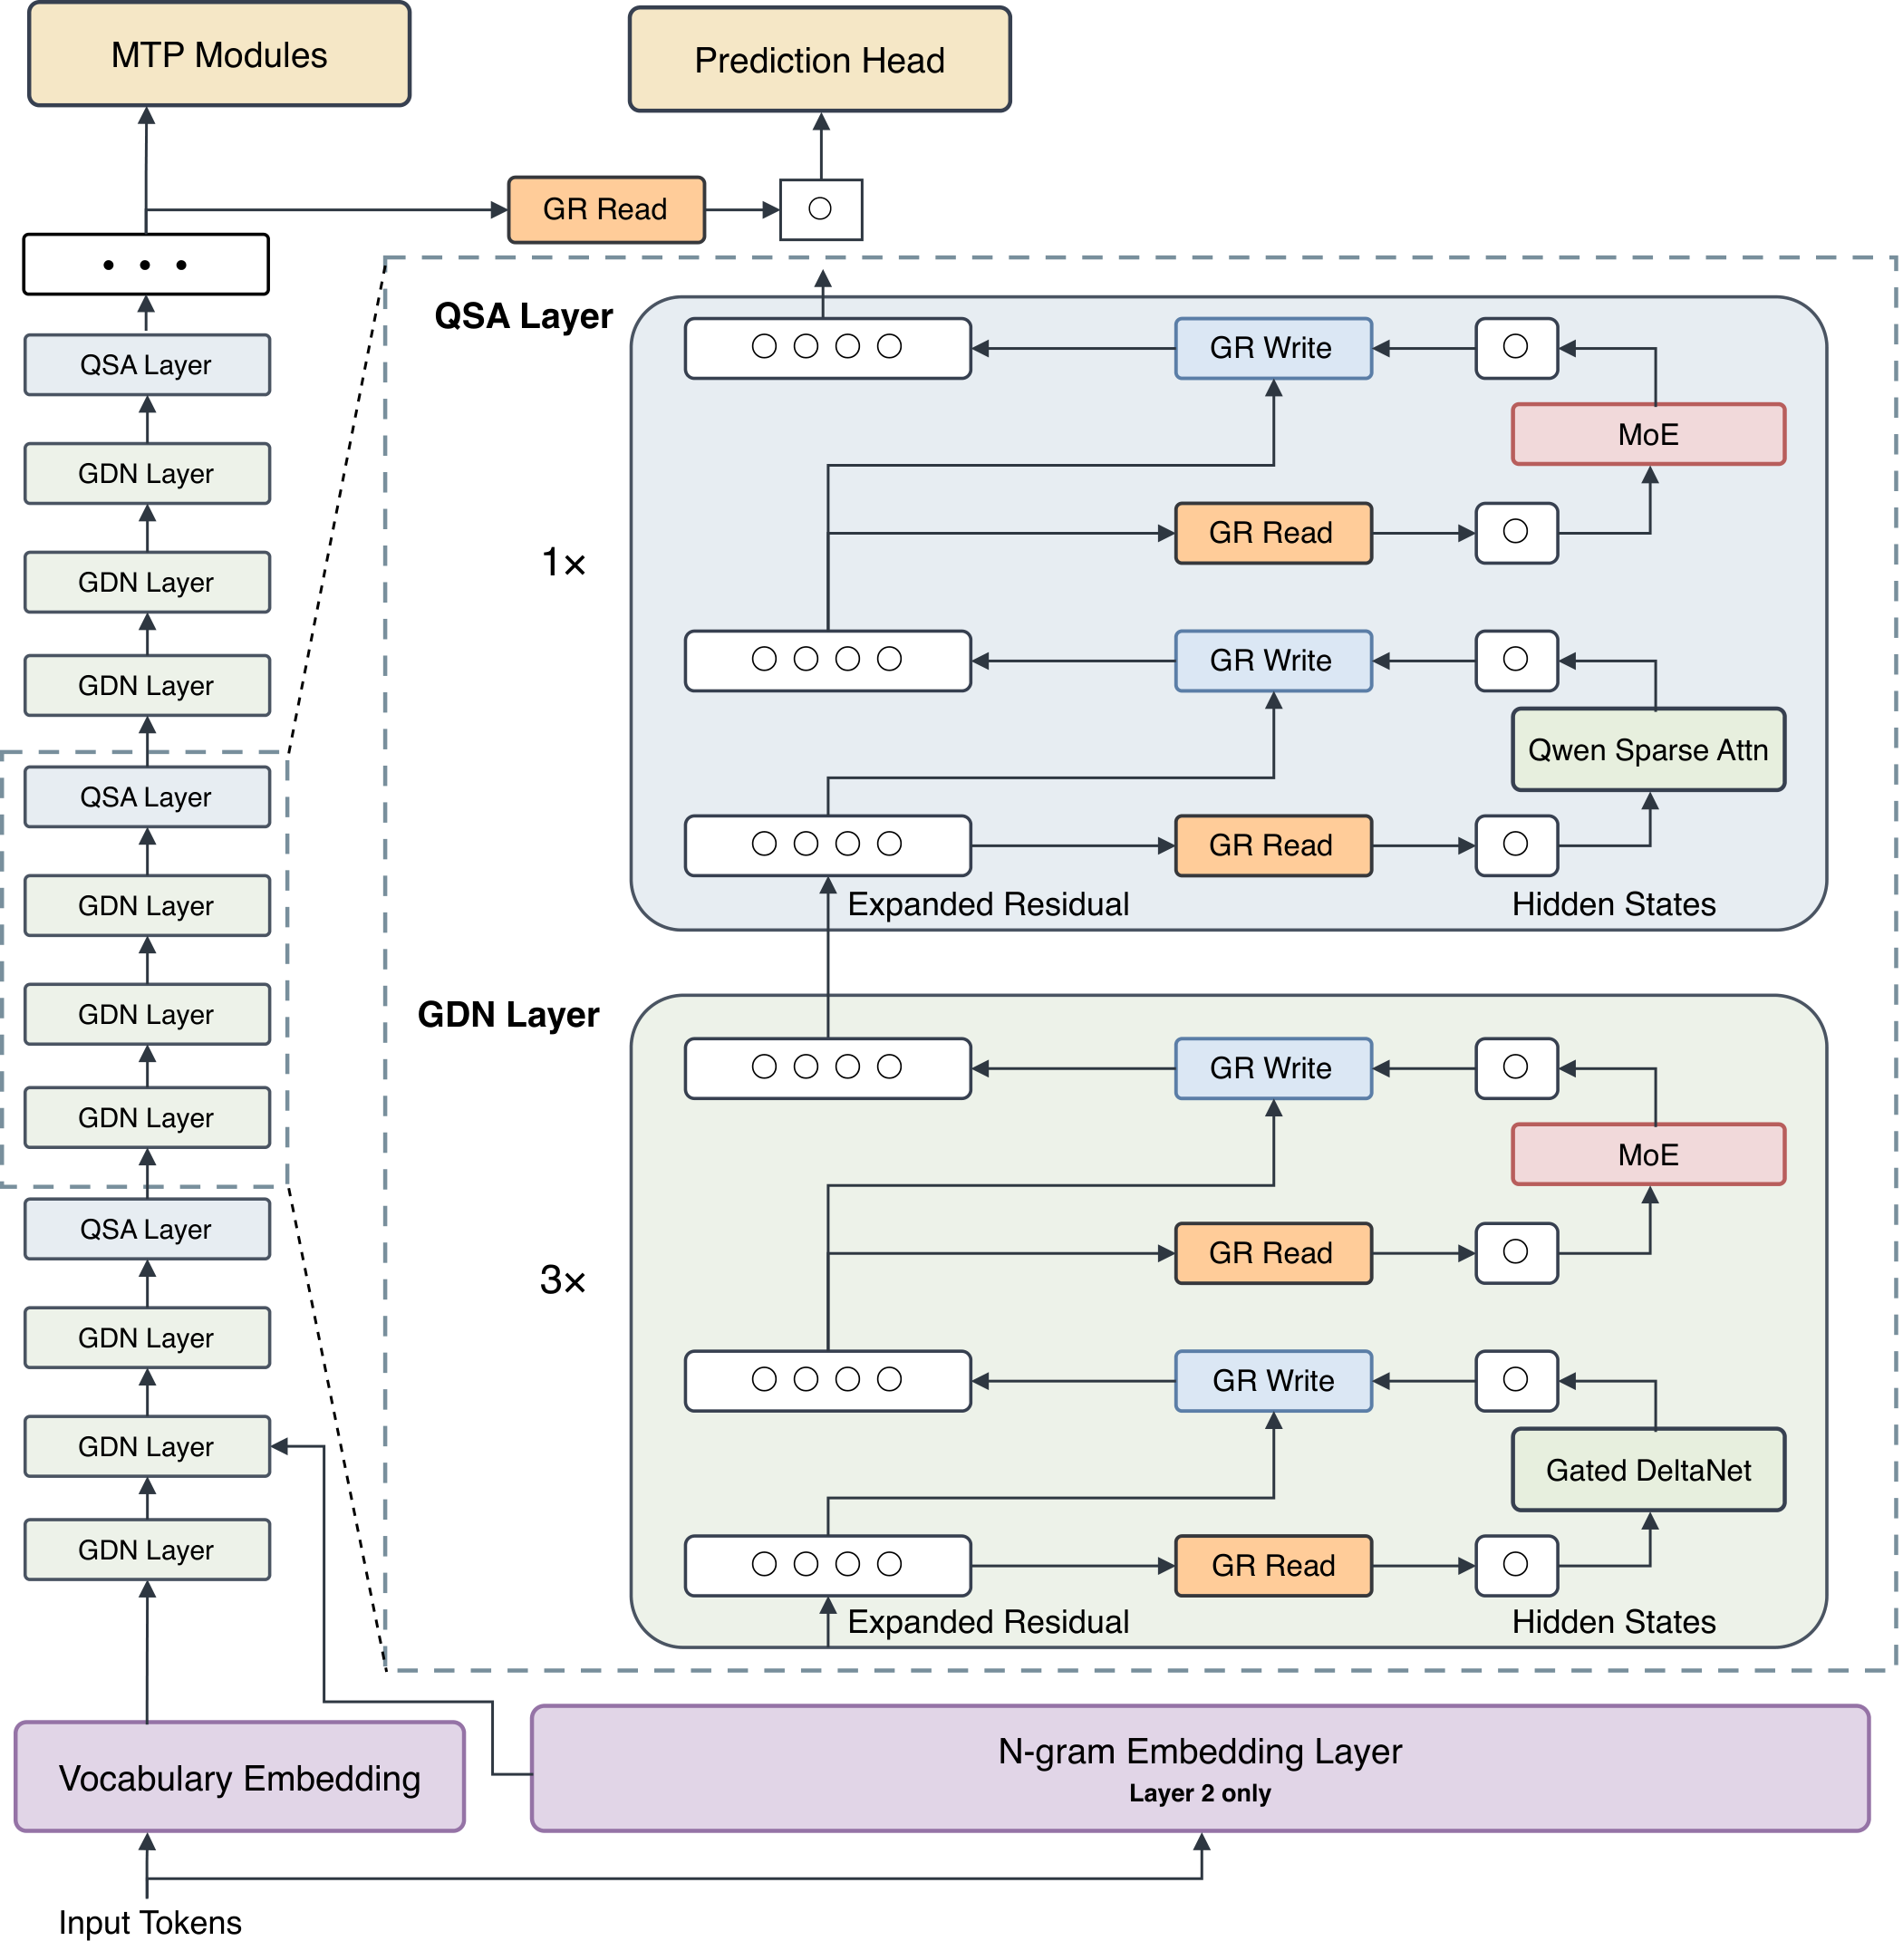
사용자 관점에서 실질적인 시험은 이러한 변화가 수용 가능한 결과를 내는 데 필요한 리소스를 줄이는지 여부다. Qwen이 공개한 토큰 소비 측정치는 평가된 작업에서의 개선을 보여준다.
성능은 어떤가? 공식 벤치마크와 사례
Qwen이 공개한 벤치마크는 작업 성능, 토큰 소비, 실행 비용을 측정하고, 데모는 실제 워크플로를 보여준다.
Qwen4-Max 벤치마크 결과
다음 결과는 Qwen4-Max와 Qwen3.8-Max를 비교한다:
| Metric | Qwen4-Max vs. Qwen3.8-Max |
|---|---|
| Work360 score | 47.74에서 52.69로 증가 |
| Work360 token consumption | Xhigh에서 약 24%, High에서 약 35% 감소 |
| Terminal-Bench 4.0 token consumption | Xhigh에서 약 48%, High에서 약 49% 감소 |
| Average Work360 task cost | RMB 26.58에서 RMB 11.16으로 하락, 약 58% 낮아짐 |
비용 감소는 토큰 소비 감소와 API 가격 조정이 결합된 결과다.
도구 호출이 반복되는 애플리케이션에서는 토큰 가격만이 아니라 성공적으로 작업을 완료하는 데 드는 과업당 비용이 더 유용한 비교 지표다. 요청 단가가 낮더라도 워크플로가 광범위한 재시도나 수동 수정이 필요하면 절감 효과가 제한적이다.
금융 리서치와 제조 사례
여러 공식 사례는 구체적인 산출물과 측정 가능한 결과를 제공한다.
금융 리서치에서 이 모델은 시장 데이터 도구와 검색을 결합해 Excel 작업 문서와 편집 가능한 PowerPoint 보고서를 생산한다. 소스 링크와 정렬된 차트를 통해 검토자는 보고서의 결론을 근거 데이터까지 추적할 수 있다.
제조 사례에서는 파라미터화 모델링, 공구 경로 생성, 시뮬레이션 피드백을 결합한다. 한 가공물에 대한 보고된 인간 프로그래밍 노력은 약 475분에서 24분으로 감소했다. 이 결과는 시연된 가공물과 도구 환경을 설명하며, 유사한 공정 평가를 위한 유용한 출발점을 제공한다.
결과 해석 방법
Qwen4-Max의 Work360 점수는 47.74에서 52.69로 4.95포인트 상승했다. 이는 평가된 업계 과제 전반에서 성능이 강화되었음을 의미하지만, 개별 과제 결과는 변동될 수 있다. 토큰 소비 감소는 별도의 효율성 지표를 제공하며, High와 Xhigh 추론 설정에서 절감 폭이 다르다.
보고된 평균 Work360 과업 비용 58% 감소는 토큰 소비 감소와 API 가격 조정이 결합된 결과다. 개발자에게 중요한 질문은 이러한 절감이 재시도와 수동 수정 이후에도 성공적으로 완료된 과업의 총비용에 그대로 반영되는지 여부다.
애플리케이션 데모는 특정 워크플로와 산출물에 대한 추가 증거를 제공한다. 이를 활용해 테스트할 가치가 있는 작업을 식별한 뒤, 동일한 도구 조건에서 완료 품질, 검토 노력, 총비용을 비교하라.
Qwen4-Max 가격: API 비용과 Token Plan 옵션
Qwen4-Max는 사용량 기반 API 과금과 Token Plan 구독을 통해 제공된다. 어떤 옵션이 적절한지는 애플리케이션을 구축하는지, 상호작용형 AI 도구를 사용하는지에 따라 달라진다.
공식 사용량 기반 API 가격
QwenCloud는 싱가포르 리전 가격을 다음과 같이 안내한다:
| Billing Item | Price per 1 Million Tokens |
|---|---|
| Standard input | $1.50 |
| Output | $4.50 |
| Implicit cache input | $0.075 |
| Explicit cache read | $0.075 |
명시적 캐시 생성 비용은 5분 캐시에 대해 1 million tokens당 $1.875, 1시간 캐시에 대해 $3.00이다.
캐시되지 않은 입력 토큰 100,000개와 과금 대상 출력 토큰 10,000개를 사용하는 작업의 모델 토큰 비용은 추가 유료 도구나 서비스 제외 시 $0.195이다.
캐시된 입력은 표준 입력 대비 95% 낮게 가격이 책정된다. 동일한 지침, 도구 정의, 문서 접두부를 반복 전송하는 애플리케이션은 캐시 활용을 개선해 입력 비용을 줄일 수 있다.
Token Plan 동작 방식
Token Plan은 구독 과금과 Credits 차감 방식을 사용한다. 현재 지원 모델 목록에 qwen4-max가 포함되어 있다.
2026년 11월 17일 기준, 싱가포르 리전 페이지에는 다음과 같은 개별 월간 플랜이 표시된다:
| Plan | Monthly Price | Monthly Credits |
|---|---|---|
| Lite | $6 | 20,000 |
| Essential | $10 | 45,000 |
| Standard | $18 | 80,000 |
| Pro | $43 | 200,000 |
해당 페이지는 $3부터 시작하는 신규 사용자 프로모션도 홍보한다. 적격 여부와 최종 금액은 결제 시점에 표시된다.
Credits는 직접적인 토큰 할당이 아닌 구독 과금 단위다. 소비량은 적용되는 모델과 도구 규칙에 따라 달라진다.
Token Plan documentation에 따르면, 이 서비스는 호환되는 AI 도구에서의 상호작용형 사용을 위해 설계되었으며 현재 싱가포르 리전에서 제공된다.
Qwen4-Max에 액세스하는 방법
실용적 경로는 세 가지다: Qwen 제품을 사용, QwenCloud를 통해 직접 연결, 호환 AI 도구를 구성. 각 경로는 자격 증명과 엔드포인트 등 설정 요구사항이 다르다.
Qwen 애플리케이션 사용
공식 발표는 Qwen Studio, Qwen 앱, QwenWork, Qoder를 액세스 채널로 나열한다.
이들 제품은 문서 분석, 코딩 지원, 오피스 워크플로를 테스트하기에 편리한 출발점을 제공한다. 요청, 도구, 결과 처리를 직접 제어해야 하는 개발자는 API 직접 통합으로 전환할 수 있다.
QwenCloud API 사용
Qwen4-Max에 액세스하려면 QwenCloud에 로그인하고 선택한 리전에 대한 API 키를 발급받은 뒤, 모델 ID qwen4-max로 해당 엔드포인트를 구성한다. QwenCloud는 OpenAI 호환 액세스를 제공한다. 프리뷰에서 마이그레이션하는 사용자는 요청 매개변수와 과금 구성을 함께 검토해야 한다.
코딩 및 에이전트 도구 구성
Token Plan 문서는 Qwen Code, Cline, Cursor, OpenCode 등을 포함한 도구의 통합 가이드를 제공한다.
구성에는 일반적으로 전용 API 키, 적절한 Base URL, 모델 이름이 필요하다. Token Plan은 별도의 엔드포인트 도메인 **token-plan.maas.qwencloudapi.com**을 사용하며, 해당 키는 사용량 기반 API 키와 교차 사용이 불가능하다.
선택한 도구의 가이드를 따르고, 읽기 자료, 작업 수행, 결과 확인이 포함된 태스크로 설정을 검증하라.
누가 Qwen4-Max를 사용해야 하나?
Qwen4-Max는 광범위한 컨텍스트, 다수의 도구, 검증 가능한 산출물이 필요한 반복 워크플로에서 평가할 가치가 있다.
- 개발자는 다중 파일 코드 변경, 프런트엔드 개발, 외부 도구를 사용하는 에이전트에 Qwen4-Max를 평가할 수 있다.
- 오피스 및 리서치 팀은 문서 분석, 데이터 정리, 출처 추적 가능한 보고서 작성에 활용할 수 있다.
- 디자인 및 콘텐츠 팀은 전문 소프트웨어에 연결된 3D 모델링, 게임 프로토타이핑, 비디오 워크플로에서 테스트할 수 있다.
- 엔터프라이즈 팀은 정의된 데이터 액세스, 도구 인터페이스, 승인 기준을 갖춘 반복 프로세스를 평가할 수 있다.
금융, 법률, 의료 워크플로에서는 증거 처리와 분석 지원에 활용하고, 중대한 결론은 자격 있는 전문가가 검토해야 한다.
FAQ
Qwen4-Max의 출력 제한이 one million tokens인가?
아니다. 컨텍스트 윈도우와 최대 출력 길이는 별도의 제한이다. QwenCloud는 표준 모드에서 최대 131K 토큰, 사고 모드에서 최대 262K 토큰의 출력을 안내한다. 요청은 적용 가능한 입력 및 컨텍스트 제한도 함께 충족해야 한다.
Qwen4-Max API와 Token Plan 중 무엇을 선택해야 하나?
애플리케이션이나 백엔드 서비스에 Qwen4-Max를 통합할 때는 사용량 기반 API를 선택하라. Token Plan은 호환 AI 도구에서의 상호작용형 사용을 위한 것으로, 구독 기반 Credits를 사용한다. 두 옵션은 자격 증명과 엔드포인트가 서로 다르다.
Qwen4-Max를 무료로 사용할 수 있나?
공식 API 액세스와 Token Plan은 유료 서비스다. Qwen 애플리케이션을 통한 무료 액세스가 제공되는 경우 각 제품의 계정 및 사용 규칙을 따른다. 이는 무료 API 할당을 의미하지 않는다.
Qwen4-Max를 로컬 배포를 위해 다운로드할 수 있나?
2026년 11월 17일 기준으로 Qwen은 Qwen4-Max의 오픈 웨이트를 제공하지 않았기 때문에, 공식 릴리스에는 로컬 배포용 다운로드 가능한 모델이 포함되지 않는다. Qwen은 Qwen4 시리즈의 더 작은 모델을 점진적으로 오픈소스로 공개할 계획을 발표했다.
결론
Qwen4-Max는 장문 문서 분석, 복잡한 코딩, 다수의 도구가 포함된 워크플로에 강력한 후보이다. 공식 평가에 따르면 보고된 워크로드에서 Qwen3.8-Max 대비 더 높은 점수와 더 낮은 과업 비용을 보인다.
이미 명확한 승인 기준이 있는 대표 작업부터 시작하라. 출력 품질, 수동 수정 시간, 실행 시간, 총비용을 비교하라. 이러한 지표 전반의 개선은 유사 워크플로로 Qwen4-Max를 확대 적용할 실질적 근거가 된다.