
TL;DR
Claude Haiku 5.5는 대량·지연 민감 작업을 위한 Anthropic의 표준 속도 기준 최속 소형 모델입니다. 100만 토큰 컨텍스트 윈도우, 128K 표준 출력 한도, 적응형 추론, 그리고 백만 입력 토큰당 $0.10·백만 출력 토큰당 $0.50의 기본 가격을 결합합니다. 프롬프트가 100,000 토큰을 넘으면 요율이 상승합니다. 복잡한 코딩과 장기 에이전트 작업에는 Sonnet 5.5와 Opus 5.5가 여전히 더 강력한 선택입니다. CometAPI Standard 가격은 공식 요율 대비 20% 낮아, 백만 입력 토큰당 $0.08, 백만 출력 토큰당 $0.40에서 시작합니다. CometAPI 모델 페이지는 라이브 상태이며 프로덕션 API 액세스를 보고합니다.
Key Takeaways
- 공식 출시: 2026년 10월 7일; Claude API 모델 ID: claude-haiku-5-5.
- 시작 API 요율: 100K 토큰 이하 프롬프트에 대해 입력 $0.10, 출력 $0.50/백만 토큰. CometAPI: 공식 Standard의 80%로 입력 $0.08, 출력 $0.40/백만 토큰.
- 컨텍스트와 출력: 1M 토큰 컨텍스트와 128K 토큰 표준 출력.
- 초점: 분류, 문서 추출, 라우팅, 지원, 위임된 에이전트 작업.
- 새로운 토크나이저는 동일 텍스트에서 약 30% 더 많은 토큰을 셉니다; 토큰당 가격만이 아니라 승인된 작업당 비용으로 평가하세요.
What Is Claude Haiku 5.5?
Claude Haiku 5.5는 현재 Claude 제품군의 경량 모델로, 응답성과 운영 경제성이 핵심인 대량 요청에 맞춰 개발되었습니다. 주요 적용 분야는 문서 처리, 대화형 지원, 정보 추출, 컴팩트 서브에이전트 작업입니다. Anthropic의 모델 개요는 출시일, 기능, 플랫폼 식별자를 확인합니다.
Claude Haiku 5.5는 최초로 구성 가능한 effort 레벨을 지원하는 Haiku 모델로, 개발자가 동일 모델 내에서 추론 깊이, 지연 시간, 토큰 사용량 간 트레이드오프를 조정할 수 있습니다.
What Are the Key Features of Claude Haiku 5.5?
Adaptive thinking and adjustable effort
Haiku 5.5는 언제 얼마나 사고할지 스스로 결정할 수 있으며, effort 파라미터는 개발자에게 응답 품질, 지연 시간, 토큰 사용을 균형 잡는 수단을 제공합니다. 기본 effort는 medium입니다. 단순 분류에는 low effort가 바람직할 수 있고, 모호한 추출이나 도구 계획 단계에는 더 높은 설정이 정당화될 수 있습니다.
Large-context processing
1M 토큰 컨텍스트 윈도우로 긴 문서와 상당한 대화 이력을 단일 요청에 담을 수 있습니다. 다만 적절한 경우 검색, 절단, 캐싱을 계속 활용해야 합니다: 긴 컨텍스트는 불필요한 비용과 정확도 트레이드오프를 초래할 수 있으며, 특히 100K 가격 임계값을 넘는 구간에서 그렇습니다.
Low-cost high-throughput processing
새로운 $0.10/$0.50 시작 요율은 이전 Haiku 세대 대비 토큰 기준으로 반복적인 짧은 요청 비용을 크게 낮춥니다. 다만 Anthropic은 변경된 토크나이저를 문서화했으며: 동일 텍스트가 Haiku 4.5 대비 약 30% 더 많은 토큰을 생성합니다. 따라서 실제 작업 단위의 절감 효과는 요율 인하만큼 크지 않을 수 있습니다.
Computer use and delegated agent tasks
공개된 평가에 따르면 컴퓨터 상호작용 및 도구 보조 작업에서 이전 Haiku 모델보다 성능이 높습니다. 이는 Haiku 5.5가 경계가 분명한 에이전트 단계에 유용함을 시사하지만, 성공적인 자동화는 여전히 강한 도구 권한, 오류 복구, 위험한 작업에 대한 인간 승인에 달려 있습니다.
How Does Claude Haiku 5.5 Perform on Benchmarks?
Anthropic은 전문 지식 작업, 컴퓨터 사용, 코딩, 추론 전반에서 뚜렷한 향상을 보고합니다. 아래 결과는 보고된 평가 설정을 사용한 것입니다; 서로 다른 벤치마크의 점수를 하나의 “지능 점수”로 결합해서는 안 됩니다.
| 벤치마크 | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 735 | 1,620 | 1,840 |
| AA-Briefcase v1.1 (Elo) | 614 | 1,578 | 1,824 |
| OSWorld 2.1, 오프라인 서브셋, 부분 점수 | 15.7% | 72.4% | 83.9% |
| Humanity's Last Exam, 도구 없음 | 10.2% | 45.9% | 56.9% |
| Humanity's Last Exam, 도구 사용 | 18.7% | 57.4% | 64.5% |
| Terminal-Bench 4.0 | 0.0% | 39.2% | 70.6% |
| Chartography, 도구 없음 | 6.4% | 46.4% | 61.6% |
시스템 카드의 표준 Haiku 5.5 평가 구성은 별도 표기가 없는 한 최대 effort의 적응형 사고, 기본 샘플링, 5회 트라이얼을 사용합니다; 제품 기본은 medium이므로, 헤드라인 점수가 기본 설정을 보장하지는 않습니다. OSWorld는 82개의 오프라인 작업, 인터넷 접근 불가, 1080p, 500-액션 제한을 사용합니다. 72.4%는 부분 점수이며, 엄격 통과율은 37.1%입니다. GDPval-AA와 AA-Briefcase는 독립 실행된 Artificial Analysis 평가에서 Anthropic이 보고한 값입니다.
Terminal-Bench 4.0은 보호장치가 활성화된 --bare 모드의 Claude Code를 사용합니다. Haiku 5.5는 최대 effort, 폴백 모델 없음, 인터넷 이그레스 없음, 작업당 10회 트라이얼을 사용합니다; Sonnet 5.5는 5회 트라이얼과 일부 플래그된 요청에 대한 폴백을 사용합니다. Haiku 4.5는 고정 63,999-토큰 사고 예산을 사용합니다. 이러한 구성 차이는 39.2% 대 70.6%를 해석할 때 중요합니다.
Anthropic의 공개된 벤치마크 결과는 위 점수를 제공합니다. OSWorld는 오프라인 서브셋을 사용하고; Humanity's Last Exam은 도구 사용/비사용을 분리하며, Chartography는 도구 미사용입니다. 이는 보편적 구성하에서의 독립 측정이 아닌 벤더 보고 결과입니다. Anthropic은 Haiku 5.5 시스템 카드에서 평가 세부를 제공합니다; 비교 시 관련 effort, 도구, 스캐폴드, 예산 설정을 재현하세요. 출시 요약은 모든 행에 대한 완전 공통 테스트 환경을 지정하지 않습니다.
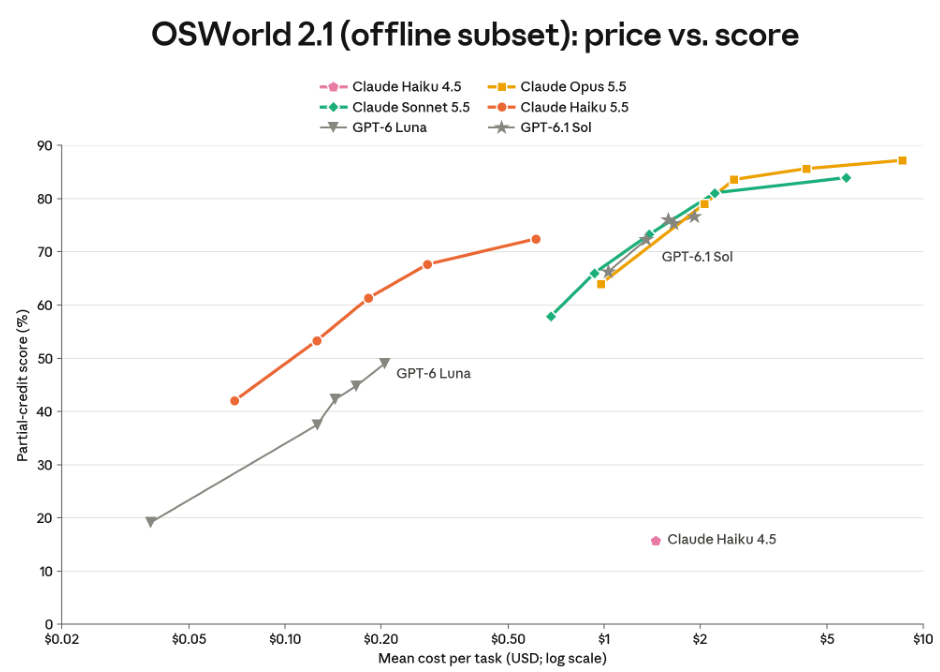
위 Anthropic 공식 평가 그래픽은 시스템 카드에서 재현한 것입니다. 평가 구성에 관한 추가 증거를 제공할 뿐, 이 글을 위해 새로 제작된 벤치마크가 아닙니다.
Benchmark Interpretation
OSWorld의 개선은 Haiku 5.5가 구조화된 그래픽 작업에서 상당히 더 유용해졌음을 시사합니다. 그러나 Terminal-Bench에서 Sonnet 5.5의 70.6%와 Haiku 5.5의 39.2% 비교는 대형 모델의 에이전트형 코딩이 여전히 우위를 유지함을 의미합니다. 실제 워크플로의 실패 비용과 난이도에 따라 모델을 선택하세요.
Claude Haiku 5.5 vs Haiku 4.5 vs Sonnet 5.5
| 차원 | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| 컨텍스트 | 200K | 1M | 1M |
| 최대 표준 출력 | 64K | 128K | 128K |
| 표준 입력 / MTok | $1 | $0.10 (100K 이하); $0.50 초과 | $2 |
| 표준 출력 / MTok | $5 | $0.50 (100K 이하); $2.50 초과 | $10 |
| 추론 | 고정 토큰 예산의 확장 사고 | 적응형; 기본 medium | 적응형; 기본 high |
| 상대적 지연 | 빠름 | 표준 속도에서 최속 | 빠름 |
| 코딩 심도 | 제한된 작업 | 더 강한 서브에이전트 | 더 복잡한 코딩 |
| 일반적 용도 | 레거시 소형 모델 배포 | 대량 워크플로 | 복잡한 프로덕션 워크플로 |
공통 사양: 세 모델 모두 텍스트·이미지 입력을 받아 텍스트 출력을 생성합니다. Claude API 및 지원 파트너 플랫폼을 통해 액세스할 수 있으며, 모델 식별자와 계정 액세스는 제공자에 따라 다릅니다. 인용된 제품 문서는 파라미터 수나 상세 아키텍처를 확정하지 않습니다.
Haiku 5.5는 검증 가능하고 반복적인 작업에 합리적인 첫 선택입니다. 반복 실패 호출, 도구 재시도, 인간 수정이 줄어드는 상황에서는 Sonnet 5.5가 더 나은 경제성을 제공할 수 있습니다. 특히 까다로운 다단계 과제에는 Opus 5.5가 옵션입니다.
비교 지연 라벨은 표준 속도 모드를 기준으로 합니다. Anthropic의 속도 자격은 Opus Fast Mode를 최속 모델 주장에서 제외합니다. 매개변수 수 같은 아키텍처 세부는 이 제품 티어로 확정되지 않습니다. 텍스트+이미지 입력과 텍스트 출력은 이미지 생성과 구분됩니다.
기능 비교는 Anthropic의 모델 사양을 따릅니다. 플랫폼 액세스는 선택한 제공자와 계정에 따라 달라지며; 어떤 모델 티어도 공개된 파라미터 수를 의미하지 않습니다.
Workload Selection
| 워크로드 | 실무 기본값 | 이유 |
|---|---|---|
| 이메일 분류 | Haiku 5.5 | 짧고 반복적이며 검증 가능한 결정 |
| 문서 필드 추출 | Haiku 5.5 | 비용 효율적인 구조화 처리 |
| 지원 티어링 | Haiku 5.5 | 빠른 응답과 에스컬레이션 |
| 코딩 서브에이전트 | Haiku 5.5 | 저비용 파일 검색 및 제한된 편집 |
| 복잡한 디버깅 | Sonnet 5.5 | 더 강한 코딩 벤치마크 성능 |
| 고위험 다단계 추론 | Opus 5.5 | 상위 티어 모델의 더 높은 역량 |
| 혼합 워크로드 | Haiku + Sonnet | 난이도와 신뢰도 기준 라우팅 |
How Much Does Claude Haiku 5.5 Cost?
Why is Haiku 5.5 advertised as “around 75% cheaper” if its token price is 90% lower?
90% 수치는 100,000 토큰 이하 프롬프트에 대한 Standard 입력·출력 요율 인하를 설명합니다; 더 긴 프롬프트는 50% 인하를 받습니다. Anthropic은 요청 길이 분포와 작업당 토큰 사용 변화까지 고려하면 Haiku 5.5의 평균 운영 비용이 약 75% 낮다고 보고합니다. 토크나이즈가 한 요인입니다: 동일 입력 텍스트가 약 30% 더 많은 토큰으로 계산될 수 있으므로, 비용 추정은 새 모델로 측정한 카운트를 사용해야 합니다.
Anthropic의 공식 가격은 두 개의 프롬프트 길이 구간을 가집니다. 아래 표의 요율은 공식 USD 기준 백만 토큰당 가격이며; CometAPI 비교는 공식 Standard 입력·출력 요율에 0.8을 곱한 값입니다.
| 요율 카테고리 | 100K 이하 프롬프트 | 100K 초과 프롬프트 |
|---|---|---|
| 입력 | $0.10 | $0.50 |
| 출력 | $0.50 | $2.50 |
| 5분 캐시 쓰기 | $0.125 | $0.625 |
| 1시간 캐시 쓰기 | $0.20 | $1.00 |
| 캐시 읽기 | $0.01 | $0.05 |
| 배치 입력 (50% 할인) | $0.05 | $0.25 |
| 배치 출력 (50% 할인) | $0.25 | $1.25 |
공식 Standard, 캐시, 배치 요율은 2026년 10월 8일에 확인되었습니다. 프롬프트 길이가 가격 구간을 결정하며; 더 높은 구간은 100K 초과분만이 아니라 요청 전체에 적용됩니다. 아래 CometAPI Standard 요율은 해당 공식 Standard 요율에 0.8을 곱한 값과 같습니다. 이 비교는 게이트웨이 할인과 배치·캐싱 할인이 중복 적용된다고 가정하지 않습니다.
| 프롬프트 길이 | 토큰 카테고리 | 공식 Standard / MTok | CometAPI / MTok |
|---|---|---|---|
| 100K 토큰 이하 | 입력 | $0.10 | $0.08 |
| 100K 토큰 이하 | 출력 | $0.50 | $0.40 |
| 100K 토큰 초과 | 입력 | $0.50 | $0.40 |
| 100K 토큰 초과 | 출력 | $2.50 | $2.00 |
Example: 100,000 short requests per month
각 요청이 2,000 입력 토큰과 500 출력 토큰을 사용한다고 가정하고; 각 요청은 100K 임계값 아래에 머뭅니다. 프롬프트 캐싱, 도구, 재시도는 무시하며, 예시를 위해 모델 간 동일 토큰 수를 가정합니다.
| 모델 / 제공자 | 월간 입력 | 월간 출력 | 월 합계 |
|---|---|---|---|
| Haiku 4.5 — 공식 Standard | $200 | $250 | $450 |
| Haiku 5.5 — 공식 Standard | $20 | $25 | $45 |
| Sonnet 5.5 — 공식 Standard | $400 | $500 | $900 |
| Haiku 5.5 — CometAPI | $16 | $20 | $36 |
이 예시에서 100,000건 요청은 2억 입력 토큰과 5천만 출력 토큰을 사용합니다. CometAPI 입력 비용은 200 × $0.08 = $16이고 출력 비용은 50 × $0.40 = $20으로, 월 $36이며 공식 $45 대비 $9 절감, 즉 20%입니다. 시나리오는 캐싱, 도구, 재시도를 제외하고 고정 토큰 수를 사용합니다; 새로운 토크나이저가 토큰 수를 변경하므로 대표 입력에서 승인된 작업당 비용을 측정하세요.
$450에서 $45로의 비교는 동일 토큰 수를 가정한 90% 요율 인하의 예시일 뿐, 동등한 실제 워크로드에서 90% 절감을 보장하지 않습니다. 출시 공지에서 Anthropic은 요청 길이와 토큰 사용 변화까지 고려한 평균 실행 비용이 약 75% 낮다고 보고합니다. 대표 입력을 재계수하고, 자체 절감을 추정하기 전에 완료된 작업 비용을 측정하세요.
Where Can You Access Claude Haiku 5.5?
공식 액세스 및 클라우드 플랫폼
Haiku 5.5는 Anthropic의 가용성 공지에 따라 Claude API와 Amazon Web Services, Google Cloud, Microsoft Azure의 지원 플랫폼을 통해 이용할 수 있습니다. 직접 Claude API 모델 ID는 claude-haiku-5-5이며; Amazon Bedrock에서는 anthropic.claude-haiku-5-5를 사용합니다. 선택한 제공자가 발급한 자격 증명을 사용하고, 현재 계정 액세스 요건을 확인하세요.
CometAPI를 통한 서드파티 액세스
CometAPI 모델 페이지는 claude-haiku-5-5의 가용을 표시하며, 100K 이하 프롬프트에 대해 Standard 요율이 백만 입력 토큰 $0.08, 백만 출력 토큰 $0.40에서 시작해 해당 공식 Standard 요율 대비 20% 낮습니다. CometAPI의 엔드포인트와 요청 포맷을 사용하며 CometAPI가 발급한 키가 필요합니다; 이는 직접 Anthropic API 액세스와는 별도 경로입니다. 가용성, 가격 구간, 통합 세부는 라이브 페이지를 확인하세요.
제공자를 전환하거나 Haiku 4.5에서 업그레이드할 때는 모델 ID를 확인하고, 토큰을 재계수하며, 응답 한도와 대화 처리 방식을 테스트하세요. 구현 세부와 호환성 변경은 Anthropic의 마이그레이션 가이드를 참조하세요.
Migration Validation
- 모델 ID를 업데이트하고 엔드포인트별 요청 필드를 검증하세요.
- 새로운 토크나이저로 토큰을 재계수하세요. 안정 프리픽스와 도구 정의를 포함합니다.
- 적응형 사고 설정, 지연 분포, 응답 블록 파싱을 테스트하세요.
- 도구 호출, 실패 복구, 저장된 사고 블록의 계정 제한을 점검하세요.
- p50/p95 지연, 승인된 작업률, 총 과금 토큰을 비교하세요.
- 비즈니스 크리티컬 워크플로에는 단계적 롤아웃과 롤백 경로를 사용하세요.
- Assistant prefill은 금지됨
Haiku 5.5 마이그레이션 가이드는 토크나이저 동작, ID, 요청 호환성을 설명합니다. temperature, top_p, top_k를 생략하세요. 명시적으로 제공하는 경우 temperature는 1이어야 하고 top_p는 0.99여야 합니다; 어떤 top_k 값이든, 또는 temperature와 top_p를 모두 제공하면 400 오류가 반환됩니다.
What Are the Limitations of Claude Haiku 5.5?
Haiku 5.5는 대형 모델을 보편적으로 대체하지 않습니다. 복잡한 코딩과 장기 추론은 Sonnet과 Opus의 의미 있는 차별화 요소로 남아 있습니다. 더 긴 프롬프트는 비용도 증가하므로 1M-토큰 윈도우는 선별적으로 사용해야 합니다. 적응형 추론은 생성 토큰과 지연의 분산을 유발할 수 있습니다; 벤치마크는 개별 비즈니스 워크플로에 대한 보장을 확립하지 않습니다.
위험 민감 자동화는 구조화 출력의 검증, 외부 도구 권한 제한, 감사 로그 유지, 중대한 조치 전 검토를 요구해야 합니다. Haiku의 낮은 기본 토큰 가격에만 의존하기보다, 불확실한 작업은 더 강한 모델로 라우팅하세요.
Conclusion
명확한 수용 기준을 가진 대량 처리에서는 Claude Haiku 5.5가 매력적인 업그레이드입니다: 낮은 진입 가격, 더 큰 컨텍스트, 적응형 추론, 더 강한 공개 평가. 복잡한 프로그래밍과 모호한 의사결정에서는 Sonnet 5.5나 Opus 5.5가 재시도와 수정 감소를 통해 더 나은 전체 경제성을 제공할 수 있습니다. 승리 전략은 전체 워크플로를 벤치마크하고 난이도에 따라 요청을 라우팅하는 것입니다.
FAQ
How does Haiku 5.5's 100K pricing boundary affect a cached workflow?
프롬프트 길이가 적용 요율 구간을 결정합니다; 신규 텍스트만으로 비용을 추정하거나 초과 토큰에만 높은 요율이 적용된다고 가정하지 마세요. 선택한 모델에 대해 요청을 계수할 때 히스토리와 도구 정의를 포함하고, 관련 구간에 따라 입력, 캐시 쓰기, 캐시 읽기, 출력 사용량을 대조하세요. 프로덕션 예산을 설정하기 전에 대표적인 캐시된 요청으로 청구서를 비교하세요.
Can Haiku 5.5 thinking blocks be replayed across accounts?
해당 블록은 생성한 계정 또는 연결된 계정에서만 작동합니다. 관련 없는 계정이 저장된 사고 블록을 보내면, 모델이 보기 전에 API가 이를 폐기합니다; 그럼에도 요청은 해당 추론 없이 성공할 수 있습니다. 공식 마이그레이션 가이드를 참조하세요. 대화 블록을 보존하고, 도구 워크플로를 이어갈 때는 생성 계정 또는 연결된 계정을 사용하세요. 게이트웨이나 계정 변경은 반드시 별도로 테스트해야 합니다; 모델 이름이 같다고 해서 저장된 사고 블록이 계속 사용 가능하다는 보장은 없습니다.
Why can Haiku 5.5 truncate a response that Haiku 4.5 completed?
새 토크나이저가 동일 텍스트에서 더 많은 토큰을 계산할 수 있어, 변경 없는 max_tokens 한도가 동등한 출력량을 덜 담을 수 있습니다. 적응형 사고가 출력 예산을 소모할 수도 있습니다. stop_reason과 usage를 확인하고, 새 모델로 프롬프트를 재계수한 뒤, 레거시 한도를 그대로 복사하지 말고 실제 작업에서 출력 허용치를 재조정하세요.
How should Haiku 5.5 routing thresholds be selected?
실제 워크로드의 라벨링된 샘플을 사용해 승인된 작업률, 수정 비용, 지연을 측정하세요. 명시적 검증에 실패하거나 테스트된 작업 범위를 초과하는 요청은 더 강한 모델로 라우팅하세요. 재시도와 에스컬레이션을 포함한 전체 워크플로 비용에 맞춰 임계값을 튜닝하고, 프롬프트·도구·effort 변경 이후에도 모니터링하세요.