
TL;DR
Muse Ember는 라우팅, 추출, 도구 호출, 집중형 코딩 등 대량 에이전트 작업을 위해 구축된 Meta의 가장 작은 멀티모달 추론 모델이다. Meta는 2026년 11월 9일 Muse Ember를 공개했다.
1,048,576 토큰 컨텍스트 윈도우는 방대한 소스 자료를 수용한다. Meta는 Model API와 Muse Code를 통해 액세스를 제공하며, CometAPI에는 muse-ember가 등재되어 있고 활성화 상태는 아래에서 다룬다. 출력 검증이 가능한 반복 작업부터 시작한 다음, 추론, 도구 사용, 재시도 비용을 포함해 성공한 결과당 비용을 비교하라.
Key Takeaways
- 역할: Muse Ember는 분류, 추출, 도구 호출, 제한된 코딩 작업을 포함한 반복적 에이전트 실행에 최적화되어 있다.
- 입력과 용량: Muse Ember는 텍스트, 이미지, 오디오, 비디오를 수용하며 1M 토큰 컨텍스트 윈도우와 최대 512K 출력 토큰을 지원한다.
- 성능: Meta의 결과는 여러 에이전트 벤치마크에서 Muse Ember에 유리하지만, 독립 분석 테스트는 낮은 토큰 단가가 항상 최저 작업 비용을 의미하지는 않음을 보여준다.
- 가격: 입력 토큰 200K를 초과하면 더 높은 가격 구간에 들어간다. 총 작업 비용은 추론과 도구 사용에도 좌우된다.
- 액세스: Meta Model API와 Muse Code로 사용할 수 있다. CometAPI 목록은 현재 모델 상태를 Coming soon으로 표시하고 있다.
What Is Muse Ember Best Used For?
Muse Ember는 큰 모델이 기획을 담당하는 동안 에이전트 워크플로의 실행 단계를 처리한다. 명확한 입력, 제한된 범위, 애플리케이션이 검증할 수 있는 결과를 가진 대량 작업에 적합하다. 핵심 역할은 다음과 같다:
- 분류 및 라우팅: 요청에 레이블을 부여하고 적절한 큐나 서비스로 전달.
- 추출: 문서와 미디어를 출처 증거와 함께 구조화된 필드로 변환.
- 도구 호출: 애플리케이션이 실행할 함수를 선택하고 인자를 제공.
- 배치 처리: 파일이나 레코드 전반에 반복 가능한 작업을 적용.
Support-Ticket Routing
실용적인 지원 워크플로에서 Ember에게 주문 참조를 추출하고, 범주를 지정하며, 누락된 정보를 표시하도록 요청할 수 있다. 라우팅 전에 애플리케이션은 자신의 기록에 대해 참조를 검증할 수 있다. 환불, 계정 변경 등 중대한 작업은 애플리케이션 자체의 권한 검사 뒤에 유지하라.
Document Extraction with Evidence
청구서나 계약 처리에서는 추출된 값과 이를 뒷받침하는 페이지 또는 구절을 함께 요청하라. 부재 또는 판독 불가 필드를 추측 대신 명시적 결과로 취급하라. 이렇게 하면 검토자가 모든 문서를 다시 읽지 않고도 레코드를 점검할 수 있다.
Focused Coding Work
코딩 작업자에게 작은 소유 범위를 부여하라: 변경 가능한 파일, 보존해야 할 동작, 완료를 정의하는 테스트. Meta의 parallel code-migration 예시는 이러한 작업 분할을 보여준다. 주변 에이전트가 명령을 실행하고 결과를 점검한다. 모델의 응답만으로 변경이 테스트를 통과했다는 증거가 되지 않는다.
Meta의 Muse Ember 출시 비주얼은 실행 모델과 더 큰 기획 모델을 결합하는 가이드를 함께 제공한다.
Meta에 따르면 Muse Ember는 Muse Wonder Full을 사용해 훈련된 최초의 모델로, 더 큰 모델을 활용해 특화 모델을 개발하는 전략을 확장한다.
Muse Ember Specifications
핵심 사양은 다음과 같다:
| 사양 | Muse Ember |
|---|---|
| 개발사 | Meta Superintelligence Labs |
| 발표일 | November 9, 2026 |
| 모델 카테고리 | Multimodal reasoning and agent execution |
| 컨텍스트 윈도우 | 1,048,576 tokens |
| 최대 출력 | 524,288 tokens |
| 입력 모달리티 | Text, images, audio, video |
| 파일 입력 | Supported through the Responses API |
| 출력 모달리티 | Text |
| 추론 강도 | Minimal, Low, Medium, High, XHigh, Max |
| 기본 추론 강도 | Max |
| 도구 호출 | Supported |
| 구조화된 출력 | Supported |
| 검색 그라운딩 | Supported through the Model API |
Meta는 Muse Ember의 가중치를 공개하지 않았으며 파라미터 수를 밝히지 않았다. 요청 및 토큰 제한은 팀별로 적용되며, 해당 팀의 모든 API 키가 모델 할당량을 공유한다.
Context and Multimodal Inputs
PDF 워크플로에서 Meta는 처음 100페이지의 텍스트와 처음 50페이지의 이미지를 추출하므로 처리 전에 더 긴 파일은 분할하라. 작업에 필요한 자료만 전송하라. 추론 토큰은 최종 답변과 함께 524,288 출력 토큰 할당을 공유한다.
레이아웃이 중요한 경우 스크린샷, 문서 추출에는 스캔, 회의 분석에는 오디오, 시간에 따라 전개되는 이벤트에는 비디오를 사용하라. 텍스트 요약만 필요하다면 전사본으로 충분하다. 파일은 Responses API를 통해 지원되며 결과는 텍스트로 반환된다.
Configurable Reasoning Effort
Muse Ember는 여섯 단계의 추론 강도를 제공한다: Minimal, Low, Medium, High, XHigh, Max. Meta의 기본값은 Max이며, none은 지원되지 않아 HTTP 400을 반환한다. 라우팅과 분류 같은 일상 작업은 낮은 수준에서 시작하고, 승인된 답변 증가가 추가 지연과 출력 토큰 비용을 정당화할 때만 상향하라.
Tool Calling and Structured Output
Muse Ember는 도구 호출과 구조화된 출력을 지원한다. 도구 호출은 모델의 결정을 애플리케이션 함수에 연결하고, 구조화된 출력은 추출된 필드를 검증하고 다음 단계로 전달하기 쉽게 만든다.
다음의 지원 티켓 예시는 라우팅 애플리케이션에 범주, 우선순위, 검토 플래그를 제공한다:
{
  "category": "billing",
  "priority": "high",
  "requires_human_review": true
}
Meta Model API는 검색 그라운딩과 컴퓨터 사용 워크플로도 지원한다. 연결된 애플리케이션이 도구를 제공하고, 작업을 실행하며, 권한을 제어한다.
How Does Muse Ember Perform on Benchmarks?
Meta의 출시 결과는 최대 추론 강도를 사용한다. Agents’ Last Exam은 Meta 내부 평가의 Linux 서브셋을 다루며, Terminal-Bench는 각 모델의 최적 공개 하네스를 사용한다. 외부 보고된 Artificial Analysis 결과를 Meta의 내부 평가와 결합한다. Personal Superintelligence Index는 Meta의 내부 합성 지표로 독립 리더보드가 아니다.
Muse Ember Benchmark Results
| 벤치마크 | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| AutomationBench-AA | 37.8 | 13.9 | 20.2 |
| Agents' Last Exam | 61.6 | 57.0 | 57.1 |
| Personal Superintelligence Index | 46.8 | 36.1 | 37.0 |
| Terminal-Bench 4.0 | 40.9 | 39.2 | 16.4 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA | 27.2 | 34.9 | 25.2 |
| GDP.pdf-AA | 22.8 | 20.8 | 22.8 |
| OSWorld 2.1 (partial score) | 69.5 | 68.9 | 50.5 |
| OSWorld 2.1 (binary score) | 33.8 | 27.8 | 17.0 |
| PerceptionBench (with tools) | 80.6 | 78.6 | 62.8 |
| Artificial Analysis Intelligence Index | 36 | 36 | 28 |
Terminal-Bench 4.0은 Muse Ember에 mini-swe-agent, Haiku 5.5에 Claude Code, GPT-6 Luna에 Codex를 사용한다. 동일한 실행 환경이 아니다. OSWorld 2.1은 부분 점수와 이진 점수를 모두 보고하며, PerceptionBench에는 도구가 포함된다. Artificial Analysis Intelligence Index 결과는 2026년 11월 9일 게시된 버전 5에서 가져왔다.
Muse Ember Benchmark Analysis
에이전트 실행이 Muse Ember의 가장 강한 영역이다.
AutomationBench-AA에서 Muse Ember는 37.8점을 기록하며 Haiku 5.5의 13.9, GPT-6 Luna의 20.2와 대비된다. 이는 Muse Ember를 엔드 투 엔드 비즈니스 워크플로와 반복 에이전트 작업용 모델로 포지셔닝하는 Meta의 관점을 뒷받침한다.
코딩 성능은 경쟁력이 있으나 보편적으로 우월하지는 않다.
Muse Ember는 Terminal-Bench 4.0에서 40.9, Coding Agent Index-AA에서 46점을 얻었다. 그러나 FrontierCode 2.0-AA에서는 27.2점으로 Haiku 5.5의 34.9보다 낮다. 이는 Muse Ember가 제한된 코딩 하위 작업에 유용한 후보임을 시사하며, 더 어려운 엔지니어링 작업은 더 강력한 대안과 비교 테스트가 필요함을 의미한다.
멀티모달 및 컴퓨터 사용 결과가 유망하다.
Muse Ember는 도구 포함 PerceptionBench에서 80.6, OSWorld 2.1 부분 점수에서 69.5를 기록했다. 이는 시각적 이해와 컴퓨터 상호작용이 포함된 워크플로에 적합하다는 포지셔닝을 뒷받침한다.
일반 지능은 Haiku 5.5와 비슷하다.
Muse Ember와 Haiku 5.5는 모두 Artificial Analysis Intelligence Index에서 반올림 시 36을 기록하며, GPT-6 Luna의 28을 앞선다. 선택 결정을 위해 위의 과업별 결과와 함께 이 폭넓은 비교를 고려하라.
Muse Ember Intelligence vs. Cost Per Task
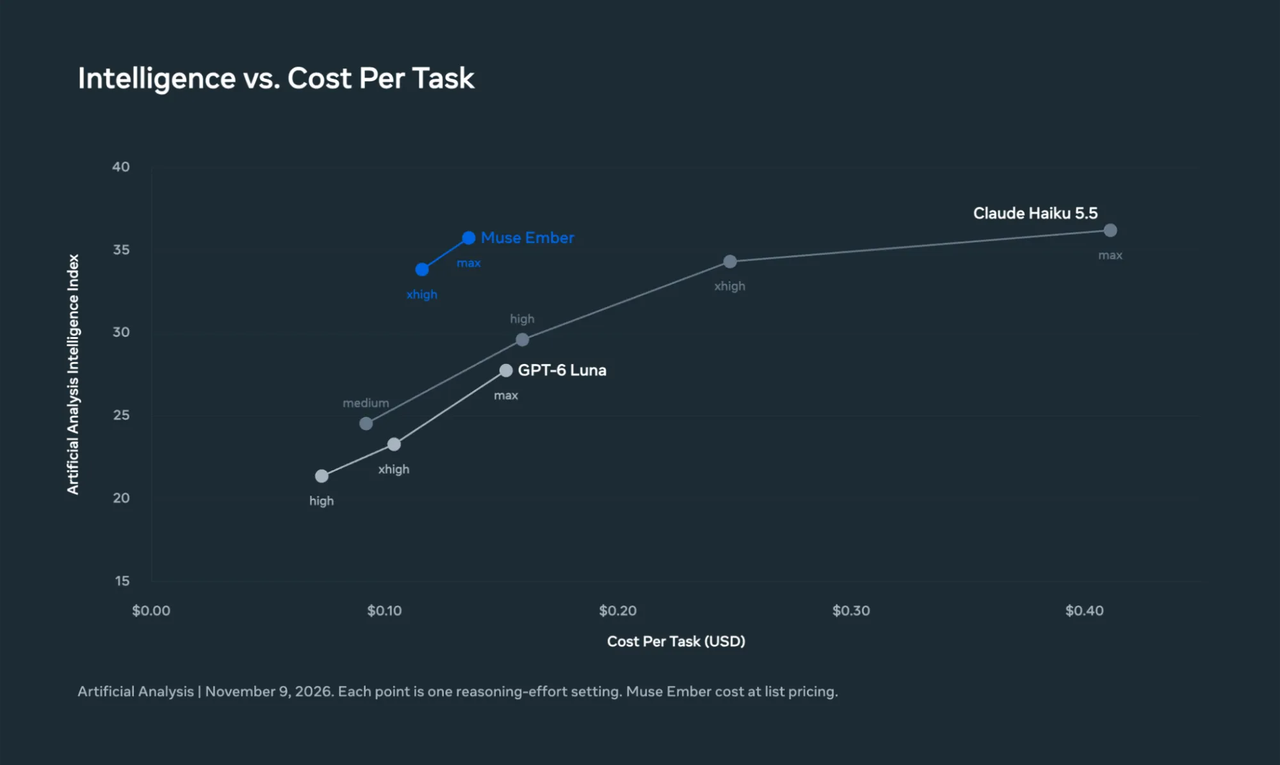
Meta의 차트는 서로 다른 추론 강도 설정에서 Artificial Analysis Intelligence Index 점수와 추정 작업당 비용을 비교한다.
최대 추론 강도에서 Muse Ember는 Artificial Analysis Intelligence Index에서 35.8점을 기록하며 추정 작업당 비용은 $0.136이다. Haiku 5.5는 36.2점에 $0.411, GPT-6 Luna는 27.8점에 $0.152다. 이 벤치마크에서 Ember는 Haiku 점수에 근접하면서 작업당 비용은 약 3분의 1 수준이고, Luna보다 약간 낮은 비용으로 더 높은 점수를 기록한다.
이 추정치는 벤치마크 토큰 소비와 공시 가격을 사용한다. 다음 평가는 특정 워크플로 선택 시 도구 활동이 왜 중요한지 보여준다.
Independent Data-Analysis Results
Plotly의 2026년 11월 10일 데이터 분석 평가는 Plotly Studio Embedded에서 합성 풍력 에너지 데이터셋을 대상으로 43개 질문을 테스트했다. Muse Ember는 OpenRouter를 통해 실행되었고, 보고된 비용은 각 모델 실행 시점의 가격을 사용했다. 이는 워크로드별 결과이며 Meta 네이티브 API 결제 테스트가 아니다.
| 평가 지표 | Muse Ember | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|
| 통과한 질문 수 | 38/43 | 38/43 | 37/43 |
| 전체 테스트 비용 | $1.04 | $0.13 | $0.38 |
| 질문당 중앙 응답 시간 | 28 seconds | 18 seconds | 14 seconds |
이 데이터 분석 워크로드에서 GPT-6 Luna는 동일한 38/43 통과 수를 Ember보다 총 비용의 8분의 1로 달성했으며, 중앙 응답 시간도 더 짧았다. Haiku는 질문당 14초로 가장 빨랐고 37/43을 기록했다. 유사한 비용 민감형 분석 워크플로의 시작 후보로는 Luna가 더 강력하다. Ember의 낮은 토큰 단가만으로 더 저렴하다고 할 수는 없다.
Plotly는 숨겨진 패턴이 포함된 질문에서 Muse Ember가 평균 78개의 쿼리를 수행했으며, 테스트된 모델의 중앙값은 25였다고 밝혔다. 추가 도구 활동은 토큰 소비와 총 비용을 증가시켰다.
테스트는 또한 강점을 보여줬다. Muse Ember는 명확히 정의된 분석 질문 20개, 모호한 질문 5개, 불가능한 요청 5개, 데이터 품질 점검 3개를 모두 정확히 답했다. 가장 어려워한 것은 데이터의 숨겨진 패턴이었다.
Plotly는 각 모델을 한 번씩 실행했으며, 다른 모델에서 최대 세 문항의 변동을 관찰했다. 38 대 37의 통과 수는 근소한 차이로 보라. 여기서 더 분명한 차이는 도구 사용량과 총 비용이다.
Muse Ember vs Muse Wonder vs Muse Spark
책임 범위에 따라 Muse 모델을 선택하라: 기획, 메인 에이전트 루프, 또는 반복 실행.
| 항목 | Muse Wonder | Muse Spark 1.3 | Muse Ember |
|---|---|---|---|
| 기본 역할 | Frontier reasoning and complex engineering | Main coding and agent model | High-volume execution |
| 주요 강점 | 기획, 장시간 작업, 복잡한 코딩 | 코딩 및 에이전틱 워크플로 | 반복 하위 작업과 도구 호출 |
| 전형적 워크로드 | 리포지토리 규모 엔지니어링 | 메인 에이전트 실행 | 분류, 라우팅, 추출 |
| API 모델 ID | muse-wonder-1.0 | muse-spark-1.3 | muse-ember-1.0 |
| 컨텍스트 윈도우 | 1M tokens | 1M tokens | 1M tokens |
| 기본 추론 | Max | High | Max |
| 표준 입력 가격 / 1M | $4.00 | $1.25 | $0.10 |
| 표준 출력 가격 / 1M | $20.00 | $4.25 | $0.50 |
표는 Meta의 Standard 모드 토큰 가격을 사용한다. 여기서 Ember의 가격은 200K 입력 토큰 이하 요청에 적용된다. Wonder와 Spark에는 Ember의 장문맥 프리미엄이 없다.
Muse Model Selection
어려운 기획, 리포지토리 전반의 엔지니어링, 여러 단계에 걸친 복구에는 Wonder를 선택하라. 메인 코딩 또는 에이전트 루프에는 Spark를 선택하라. 라우팅, 추출, 특정 파일 변경과 같이 독립적으로 검증 가능한 반복 하위 작업에는 Ember를 선택하라.
예를 들어 리포지토리 마이그레이션에서는 종속성 분석을 더 큰 모델에 맡기고, 좁게 범위를 한정한 파일 변경을 Ember에 할당할 수 있다. 인수인계에는 파일, 예상 동작, 수용 기준을 명시해야 한다. 이 분할은 작은 작업을 조정·검토하는 비용이 메인 모델로 전체 작업을 완료하는 것보다 저렴할 때만 유용하다.
후보 간 선택을 위해 동일한 대표 작업을 동일한 수용 기준으로 실행하라. 필수 성공률이나 지연 목표를 놓치는 구성은 먼저 배제하라. 통과한 구성 중에서 재시도와 도구 호출을 포함한 총 지출을 승인된 결과 수로 나눈 값을 비교하라. Ember가 그 비용을 낮추는 작업 유형에 배정하고, 해결되지 않은 사례는 Spark나 Wonder로 다시 라우팅하라.
How Much Does Muse Ember Cost?
표는 Meta의 공식 요금과 USD 기준 CometAPI 20% 할인 추정을 백만 토큰당으로 병기한다. 각 셀은 Meta / 할인 추정을 보여준다. CometAPI 목록은 아직 실시간 요금을 게시하지 않았다. 예산 계획에는 할인 추정치를 사용하라.
| 백만 토큰당 요금 (Meta / 20% 할인 추정) | 200K 입력 이하 | 200K 입력 초과 |
|---|---|---|
| 입력 | $0.10 / $0.08 | $0.30 / $0.24 |
| 캐시된 입력 | $0.004 / $0.0032 | $0.012 / $0.0096 |
| 출력 | $0.50 / $0.40 | $1.50 / $1.20 |
요청의 총 입력 토큰(캐시된 입력 포함)이 구간을 결정한다. 200K 입력 토큰을 초과하는 요청은 출력까지 포함해 전체 요청에 높은 요금 구간이 적용된다. Meta의 previous_response_id를 사용할 경우 저장된 대화 이력은 입력 총량에 포함된다.
Typical Muse Ember Request Costs
캐시되지 않은 입력과 추론을 포함한 20K 청구 출력 토큰이 있는 200K 입력 요청은 Meta 요금으로 $0.0300, 20% 할인 시나리오로 $0.0240이다. 입력을 220K로 늘리면 전체 요청이 더 높은 구간으로 이동한다. 동일한 20K 출력에서 총액은 Meta 요금으로 $0.0960, 할인 적용 추정으로 $0.0768이 된다. 별도의 도구 요금은 제외되어 있다. 관련 컨텍스트를 낮은 구간에 유지하는 것이 20% 할인 이상의 절감 효과를 낼 수 있다.
| 시나리오 | 입력 토큰 | 청구 출력 토큰 | Meta 비용 | CometAPI 비용 |
|---|---|---|---|---|
| 표준 요청 | 200K | 20K | $0.0300 | $0.0240 |
| 장문맥 요청 | 220K | 20K | $0.0960 | $0.0768 |
추론 토큰은 청구 출력으로 계산된다. Meta 네이티브 API에서 웹 검색 그라운딩은 1,000건당 $2.50의 추가 비용이 발생하며, Ember에는 Contributor 모드 변형이 없다. 위의 토큰 가격 비교는 별도 도구 요금에 20% 할인을 적용하지 않는다.
How to Access Muse Ember
CometAPI listing: the model page는 모델을 muse-ember로 표시하지만, 2026년 11월 16일 기준 카탈로그 상태는 Coming soon이다. 해당 페이지를 팔로우하여 활성화 및 요금을 확인하라. 현재 액세스는 Meta Model API 또는 Muse Code를 사용하라.
Through Meta Model API: https://api.meta.ai/v1.에서 muse-ember-1.0을 사용하라. 네이티브 API는 Responses, Chat Completions, Messages 형식을 지원한다. 파일 입력은 Responses를 사용한다. 클라이언트 구성 시 공급자 엔드포인트와 모델 식별자를 함께 유지하라.
Native API limits and other access: Meta는 팀당 분당 3,000 요청, 분당 4,000,000 토큰을 게시했으며, 팀의 API 키가 이를 공유한다. Muse Ember는 Muse Code에서도 사용할 수 있다. 배치 크기 산정 시 선택한 경로의 제한을 확인하고, 네이티브 API 설정에는 Meta의 통합 가이드를 사용하라.
What Are the Limitations of Muse Ember?
다음 세 가지 요인이 Ember가 워크플로에 적합한지 결정한다:
- 복잡한 엔지니어링은 여전히 워크로드에 따라 달라진다. Ember는 Terminal-Bench에서 더 강하지만, FrontierCode 2.0-AA에서는 Haiku 5.5에 뒤처진다. 좁은 코딩 승리가 모든 리포지토리 규모 변경에 대한 적합성을 보장하지는 않는다.
- 긴 컨텍스트와 낮은 토큰 가격이 낮은 작업 비용을 보장하지 않는다. 큰 요청은 높은 가격 구간으로 이동하고, 반복된 도구 사용은 낮은 토큰 단가를 상쇄할 만큼의 토큰을 소비할 수 있다.
- 도구 지원에는 여전히 애플리케이션이 필요하다. 주변 시스템이 호출을 실행하고 권한을 제어하며 결과를 검증한다. 모델이 작업을 요청하는 능력만으로 신뢰할 수 있는 워크플로가 보장되지는 않는다.
Conclusion
수용 기준이 충분히 명확해 측정 가능한 곳에서 Ember를 도입하라. 유용한 첫 배치는 이미 결과가 검증된 대량 단계로, 라벨이 있는 티켓 라우팅이나 검토된 문서에서 필드 추출과 같은 작업이다. 현재 모델과 비교해 성공한 작업당 비용, 오류율, 지연을 비교한 뒤 역할을 확대하라. 그 근거가 Ember가 필요한 품질을 유지하면서 워크플로 비용을 낮추는지 알려줄 것이다.
FAQ
Muse Ember 추출 결과는 어떻게 검증해야 하나?
누락 필드, 판독 불가 스캔, 상충 값이 포함된 문서를 인간 검증 답안과 함께 기준 세트로 구축하라. 모든 유효한 JSON 응답을 성공으로 처리하기보다 필드별 정확도를 측정하라. 각 추출 값이 인용된 출처 구절로 뒷받침되는지 확인하고, 불일치는 검토로 보낸다. 이렇게 하면 형식적 신뢰성과 사실적 신뢰성을 구분할 수 있다.
Muse Ember 하위 작업은 언제 메인 에이전트로 돌아가야 하나?
실행 전에 에스컬레이션 조건을 정의하라. 필수 파일이 할당 범위를 벗어나거나, 출처가 상충하거나, 수용 검사에 반복적으로 실패하거나, 작업자가 권한을 부여받지 않은 결정을 요구하는 경우다. 증거, 시도한 단계, 미해결 질문을 메인 에이전트로 반환하라. 모호하게 범위를 넓히도록 허용하는 것보다 명확한 인수인계가 더 유용하다.
프로덕션에서 Muse Ember를 테스트할 때 무엇을 로깅해야 하나?
정확한 제공자와 모델 식별자, 추론 설정, 입력 및 청구 출력 토큰, 캐시된 토큰, 도구 호출 횟수, 재시도, 지연, 최종 수용 결과를 기록하라. 검증 결과를 사용량 기록과 함께 보관하여 승인된 작업당 비용을 계산할 수 있도록 하라. 유사한 작업 유형별로 비교하라. 라우팅, 코딩, 장문서 작업을 평균으로 합치면 모델이 도움이 되는 곳과 비용을 추가하는 곳이 가려질 수 있다.
Muse Ember 워크플로에서 중복 작업을 어떻게 방지하나?
애플리케이션이 작업 정체성과 완료 상태를 책임지게 하라. 티켓 생성 같은 작업에는 안정적인 작업 키를 부여하고, 이미 완료되었는지 확인하며, 대상 API의 멱등성 지원을 사용할 수 있으면 사용하라. 타임아웃 후에는 재시도 전에 작업 상태를 점검하라. 이렇게 하면 불확실한 응답을 원작업이 발생하지 않았다는 증거로 잘못 간주하는 것을 피할 수 있다.