
요약
Step 5 Preview는 소프트웨어 엔지니어링, 금융 리서치, 복합 에이전트 워크플로우를 위해 설계된 StepFun의 대표 AI 모델이다. 벤치마크별로 결과 변동이 있지만, 경쟁력 있는 작업 성능과 비용 효율적인 추론을 결합한다. 개발자는 예산, 인프라, 성능 요구에 따라 호스티드 API를 통해 접근하거나 공개된 가중치를 배포해 사용할 수 있다.
핵심 요점
- 아키텍처: Step 5 Preview는 총 600B 파라미터, 토큰당 27B 활성 파라미터의 희소 MoE 아키텍처를 사용해 모델 용량과 추론 효율을 균형 있게 제공한다.
- 컨텍스트 및 멀티모달 지원: 호스티드 API를 통해 1M-token 컨텍스트 윈도우, 텍스트·이미지·비디오 입력, 최대 64K 출력 토큰을 지원한다.
- 벤치마크 성능: Step 5 Preview는 DeepSWE v1.1에서 67.7%, FrontierFinance에서 66.4%를 기록했으며, Terminal-Bench v4에서는 일부 경쟁 모델에 뒤처진다.
- API 가격: StepFun은 uncached 입력 1M 토큰당 $1.00, cached 입력 $0.10, 출력 $2.70를 부과한다.
- 배포 유연성: 개발자는 StepFun 호스티드 API를 사용하거나 vLLM, SGLang, Transformers 등 호환 프레임워크로 공개 가중치를 자체 호스팅할 수 있다.
Step 5 Preview란?
Step 5 Preview는 StepFun(阶跃星辰)이 개발한 대규모 멀티모달 추론 모델이다. 장기 추론, 반복적 도구 실행, 방대한 정보 집합을 가로지르는 분석이 필요한 워크로드를 목표로 한다. StepFun은 호스티드 API 액세스를 제공하고, 다운로드 가능한 모델 가중치를 공개한다.
일반적인 대화형 응답에 최적화된 범용 어시스턴트와 달리, Step 5 Preview는 도구 사용, 중간 결과 점검, 오류 수정, 복잡한 목표를 향한 지속적 진행 등 에이전트적 실행 능력에 중점을 둔다.
주요 사양
공식 모델 카드는 희소 아키텍처, 파라미터 수, 배포 구성 등을 문서화한다. 호스티드 API 사양은 지원 입력, 생성 한도, 서빙 기능을 별도로 정의한다. 이는 배포 계약의 서로 다른 계층이다.
호스티드 API는 최대 64k 토큰 출력을 문서화하고, 모델 카드는 최대 1M 토큰의 시퀀스 생성 능력을 기재한다. 후자는 호스티드 엔드포인트가 1M 토큰 완성 출력을 허용한다는 약속이 아니다. 자체 호스팅 vLLM 예시에서는 구성된 1M 토큰 시퀀스 예산이 입력과 출력을 합산하며, 사용 가능한 KV 캐시 메모리와 동시성이 실사용 가능 용량을 줄일 수 있다.
600B/27B MoE 아키텍처는 어떻게 동작하나
일반적인 조밀(dense) 트랜스포머는 추론 중 대부분의 파라미터를 활성화한다. Step 5 Preview는 대신 희소 라우팅으로 관련 전문가를 선택한다. 대략 600B 중 27B 파라미터만 활성화되어, 전형적인 토큰 계산에 전체 파라미터의 약 4.5%가 참여한다.
이 차이는 모델의 비용 효율 전략을 설명한다. 다만 27B 활성화가 27B 배포 풋프린트를 의미하진 않는다. 전체 전문가 가중치는 여전히 저장되고 접근되어야 하므로 GPU 메모리 용량, 전문가 병렬화, 인터커넥트 대역폭이 핵심 고려사항이다.
지원 입력과 출력 한도
호스티드 API는 텍스트, 이미지, 비디오 입력을 수용하며, 최대 1M 토큰 컨텍스트 윈도우와 64k 토큰 최대 출력을 제공한다. 이는 리포지토리 분석, 금융 문서 리서치, 시각적 해석 같은 작업을 지원한다. 자체 호스팅의 경우 사용 가능한 시퀀스 길이는 런타임 구성, 가용 메모리, 동시성에 따라 달라진다.
멀티모달 지원과 API 기능은 호스티드와 자체 배포 구성 간에 다를 수 있다.
벤치마크에서의 Step 5 Preview 성능은?
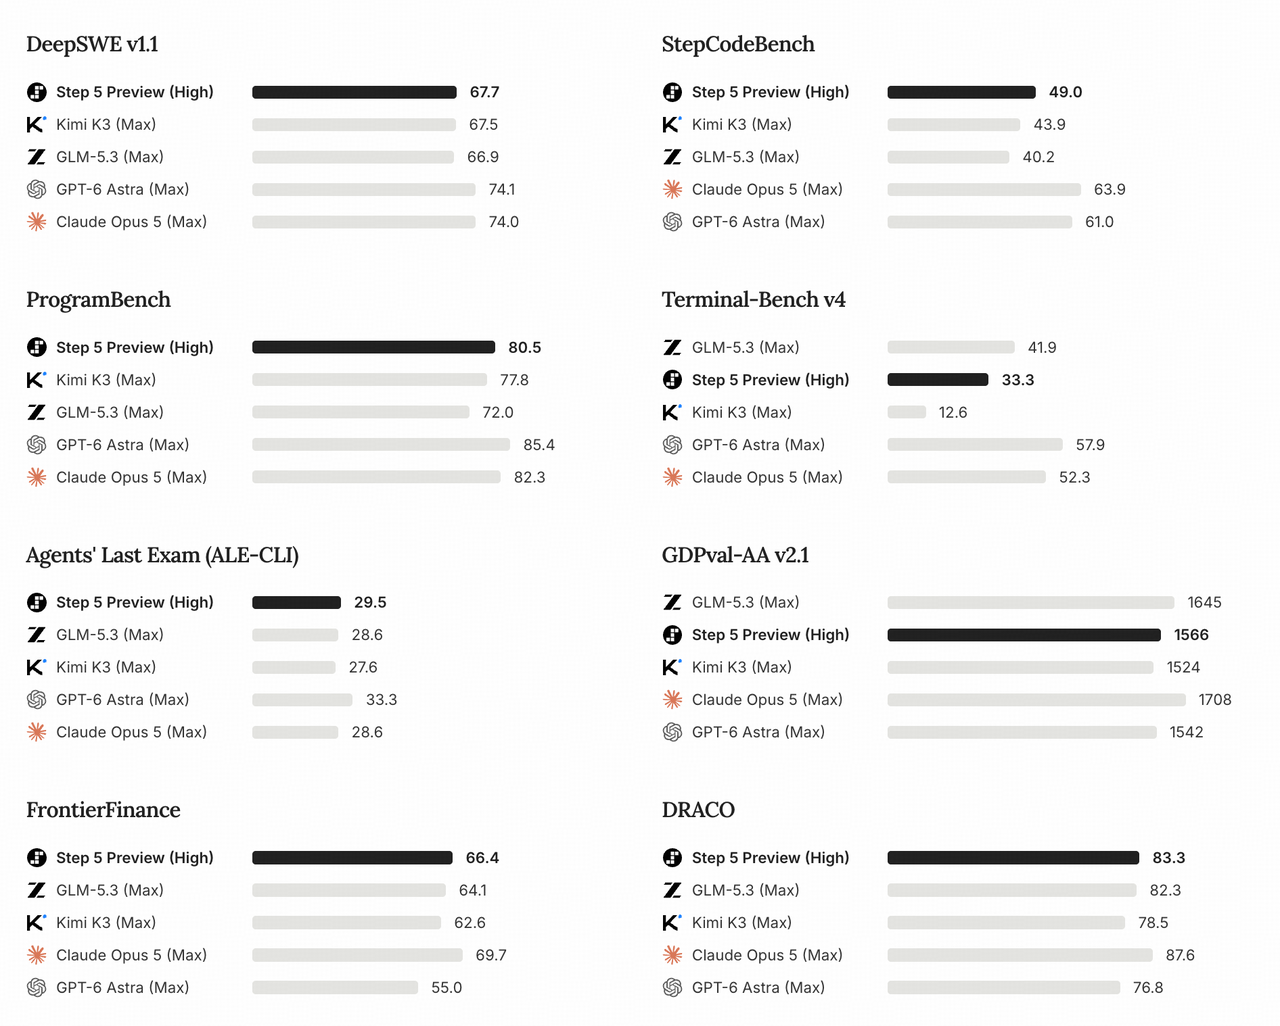
아래는 StepFun이 보고한 결과다. Step 5 Preview는 High 추론 설정을 사용하며, 비교 모델은 Max를 사용한다. 라벨명을 일치시킨다고 동일 연산량을 보장하진 않으며, 공개된 점수는 애플리케이션 지연시간이나 성공당 비용을 측정하지 않는다.
원본 공식 차트는 게시자의 평가 결과를 요약한다. 아래 표는 본 분석과 관련된 코딩, 추론, 금융 점수를 발췌한 것이다.
코딩 및 에이전트 성능
점수는 백분율이며, 높을수록 해당 벤치마크에서 더 나은 성능을 의미한다. DeepSWE v1.1은 SWE-agent 하네스에서 temperature=1.0, top_p=0.95를 사용한다. StepCodeBench는 avg@4, ProgramBench는 통과율을 보고한다. 각 벤치마크는 자체 평가 설정하에 서로 다른 과업을 측정하므로, 백분율을 상호 대체 가능한 정확도로 간주할 수 없다. 또한 공개된 비교는 모델 간 동일한 하드웨어 또는 실행 예산을 확립하지 않는다.
DeepSWE v1.1에서 Step 5 Preview는 67.7%로 Kimi K3와 GLM-5.3을 소폭 상회한다. 이는 리포지토리 기반 코딩 에이전트와 자동화된 소프트웨어 엔지니어링 작업에서 경쟁력을 시사한다.
ProgramBench도 긍정적 신호다. Step 5 Preview는 80.5%에 도달하며, Kimi K3의 77.8%, GLM-5.3의 72.0%와 비교해 우세하다.
그러나 Terminal-Bench v4는 의미 있는 한계를 드러낸다. Step 5 Preview의 33.3%는 GLM-5.3의 41.9%에 뒤처지며, GPT-6 Astra는 57.9%에 이른다. 이는 Step 5 Preview가 리포지토리 중심의 소프트웨어 엔지니어링에서는 경쟁적이지만, 터미널 기반 실행과 복잡한 디버깅에서는 상대적 우위가 균일하지 않음을 시사한다.
추론 및 지식 성능
Step 5 Preview는 GPQA Diamond에서 93.5%로 Kimi K3와 동률이며 GPT-6 Astra의 96.1%에 소폭 뒤진다. AA-LCR v1.1에서는 88.3%로 Kimi K3의 88.7%에 근소하게 뒤지고 GPT-6 Astra의 80.7%를 상회한다. Humanity’s Last Exam과 CritPt에서는 Kimi K3와 GPT-6 Astra에 뒤처진다. 결과적으로 지식과 장문맥 추론이 경쟁적이며, 과업에 따라 상대적 강점이 다르게 나타난다.
금융 리서치 및 가치평가 성능
금융 리서치는 Step 5 Preview의 가장 특징적인 적용 분야 중 하나다. 이 모델은 정량 추론, 증거 검색, 구조화 분석을 결합하도록 설계되었다. 이러한 능력은 가치평가, 금융 문서 해석, 투자 리서치에 특히 적합하다.
StepFun은 정보 수집에서부터 방어 가능한 결론 도출까지 여러 단계를 평가하기 위해 FinStepBench를 도입했다.
점수가 높을수록 더 강한 벤치마크 성능을 의미한다. FinStepBench는 StepFun이 개발했으므로, 독립적인 검증이 특히 중요하다.
Step 5 Preview는 FrontierFinance에서 66.4%로, 보고된 구성 하에서 Kimi K3, GLM-5.3, GPT-6 Astra를 상회한다. 다만 Claude Opus 5(69.7%)가 여전히 앞선다.
FinStepBench DeepResearch 결과는 특히 주목할 만하다. Step 5 Preview는 55.8%로 Kimi K3의 48.9%, GLM-5.3의 53.3%보다 높다. 이는 검색, 종합, 장기 분석이 필요한 금융 리서치 워크플로우에 모델이 잘 맞을 수 있음을 시사한다.
반면 CorporateValuation 점수는 보다 미묘한 그림을 보여준다. 60.6%로, GPT-6 Astra의 77.3%에 상당 폭 뒤진다. 따라서 Step 5 Preview를 금융 분석에 보편적으로 우월하다고 간주해선 안 된다. DeepResearch에서는 상대 순위가 강하지만 CorporateValuation에서는 그렇지 않아, 광범위한 우월 주장보다 과업별 평가를 뒷받침한다.
프로덕션 애플리케이션에서는 여전히 독립적으로 검증된 계산, 문서화된 가정, 추적 가능한 근거가 필요하다.
Step 5 Preview와 다른 AI 모델 비교
Step 5 Preview는 호스티드 대안과 독점 프런티어 서비스 모두와 경쟁한다. 벤치마크 결과는 후보 모델 식별에 도움을 주고, API 접근성, 입력 지원, 배포 통제, 실제 워크로드 비용이 프로덕션 적용에 적합한 후보를 결정한다.
CometAPI는 Kimi K3, GLM-5.3, GPT-6 Astra, Claude Opus 5 접근을 제공한다. 이 대안들은 워크로드 품질, 지연시간, 비용을 비교하는 유용한 기준점이 된다.
Step 5 Preview는 문서화된 600B/27B 희소 MoE 체크포인트와 자체 호스팅 옵션을 제공한다. 대안의 경우 가중치 제공 여부, 파라미터 수, 컨텍스트 한도, 허용 입력은 모델과 엔드포인트에 따라 다르다. 공개된 벤치마크는 후보군을 좁히는 데 도움을 주며, 대표 코딩·리서치 작업이 각 서비스의 실제 동작을 보여준다.
Step 5 Preview vs Kimi K3
Step 5 Preview는 DeepSWE v1.1, ProgramBench, FrontierFinance에서 소폭 우세하다. Kimi K3는 추론 및 일부 기술 평가에서 여전히 경쟁력 있다. 실무적 차이는 결정적 지능 우위라기보다 비용, 서빙 조건, 과업별 신뢰성에 더 가깝다.
Step 5 Preview vs GLM-5.3
Step 5 Preview는 여러 금융 및 소프트웨어 개발 평가에서 GLM-5.3을 앞선다. 그러나 GLM-5.3의 더 높은 Terminal-Bench v4 점수는 보고된 터미널 지향 과업에서의 강점을 시사한다. 코딩 에이전트 비교에서는 단일 종합 점수에 의존하기보다 리포지토리 수정 성공, 도구 호출 오류, 실행 시간, 패치 정확도를 비교하라.
Step 5 Preview vs GPT-6 Astra 및 Claude Opus 5
독점 프런티어 모델은 가장 어려운 소프트웨어 엔지니어링 벤치마크에서 대체로 더 나은 성능을 보인다. Step 5 Preview의 주된 매력은 특정 워크로드에서 경쟁적 역량에 접근하면서 공개 가중치 배포 옵션과 비교적 접근 가능한 API 가격을 제공한다는 점이다.
실패 비용이 높고, 증분 정확도 향상이 추가 비용을 정당화할 때는 프리미엄 모델을 선택하라. 가격, 배포 통제, 반복적 에이전트 실행이 더 중요할 때는 Step 5 Preview를 고려하라.
Step 5 Preview API 비용은?
Step 5 Preview의 가치는 과업 역량과 운영 비용 모두에 좌우된다. 에이전트 워크플로우는 수십 번의 호출, 반복 문서 검색, 재시도를 수반할 수 있어, 낮은 토큰 단가가 도움이 되려면 모델이 과업을 신뢰성 있게 완료해야 한다. 아래 요율과 함께 성공당 비용을 고려하라.
API 가용성과 토큰 가격
이 2026년 10월 19일 스냅샷은 모델 비교 섹션에 링크된 CometAPI 요율과 StepFun의 네이티브 API 요율을 대비한다. 모든 가격은 1M 토큰당 미화 달러다. 서비스마다 청구, 캐시, 엔드포인트 조건이 다르며, “표기 없음”은 본 문서의 소스 스냅샷에 캐시 입력 요율이 없음을 의미한다.
GPT-6 Astra의 short-context tier는 최대 272,000 토큰에 적용되며, 인용된 장문맥 요율은 입력 $16, 출력 $60(각 1M 토큰 기준)이다. 기재 요율은 도구, 재시도, 인프라를 제외한다. 이 비교는 CometAPI를 통한 Step 5 Preview의 가용성을 확립하지 않으며, 아래 예시는 StepFun의 네이티브 엔드포인트를 사용한다.
캐시 적중 입력 요율은 uncached 요율보다 90% 낮다. uncached 가격에는 캐시에 신규 콘텐츠를 기록하는 비용이 포함되며, 출력 청구에는 추론과 최종 답변 토큰이 모두 포함된다. 반복되는 프롬프트 텍스트는 서비스가 적격 캐시 적중을 보고할 때에만 낮은 요율을 적용받으며, 보이는 답변 길이만으로는 청구되는 출력량을 과소평가한다.
예시 비용 계산
비용 공식: C = (Tu × Pu + Tc × Pc + To × Po) / 1,000,000, 여기서 Tu/Tc/To는 각각 uncached 입력, cached 입력, 청구 대상 출력 토큰 수, Pu/Pc/Po는 해당 1M 토큰당 가격이다.
동일한 100,000 입력 토큰과 20,000 청구 대상 출력 토큰을 가진 두 가지 StepFun 요청을 고려해보자:
- 캐시 미스: 100,000 입력 토큰 전부가 uncached. 비용 = (100,000 × $1.00 + 20,000 × $2.70) / 1,000,000 = $0.154.
- 캐시 히트: 90,000 입력 토큰이 캐시 요율에 해당하고 10,000은 여전히 uncached. 비용 = (10,000 × $1.00 + 90,000 × $0.10 + 20,000 × $2.70) / 1,000,000 = $0.073.
캐시 적중 예시는 동일한 입력·출력량에서 $0.081, 즉 약 52.6%를 절감한다. 절감액은 서비스가 적격 캐시 적중을 보고하는지에 달려 있다. 두 예시는 외부 도구, 재시도, 인프라 비용을 제외한다.
토큰 가격만으로 최적 가치를 결정할 수 없다. 여러 차례 재시도가 필요한 에이전트는, 한 번에 성공하는 더 높은 가격의 모델보다 더 비쌀 수 있다. 신뢰할 수 있는 비용 비교를 위해서는 토큰 요율과 함께 성공적으로 완료된 과업당 비용을 사용하라.
Step 5 Preview는 오픈 소스인가? 로컬 실행이 가능한가?
StepFun은 공식 Hugging Face 리포지토리를 통해 FP8, BF16, NVFP4 변형의 다운로드 가능한 가중치를 공개한다(2026년 10월 19일 기준). 가중치 접근은 자체 배포를 가능하게 하지만, 모델을 메모리 요구 측면에서 작은 조밀 모델과 동일하게 만들지는 않는다.
사용 가능한 파일에는 Step 5 Preview 체크포인트, BF16 버전, NVFP4 버전이 포함된다.
용어가 중요하다. Step 5 Preview는 StepFun Model License 1.0에 따라 공개 가중치를 제공한다. 라이선스에는 모델 고유의 출처 표기 및 상업적 사용 조건이 포함된다. 배포 전 계획된 사용 및 배포에 대해 해당 조건을 검토하라.
로컬 배포 요구사항
공식 모델 카드는 다음 기준 구성을 기재한다:
- vLLM의 FP8: NVIDIA B300 4개 또는 NVIDIA H200 8개, OpenAI 호환 API 서빙
- vLLM의 BF16: NVIDIA B300 8개 또는 NVIDIA H200 16개, OpenAI 호환 API 서빙
- SGLang의 FP8: NVIDIA B300 4개, OpenAI 호환 API 서빙; Transformers의 FP8: 오프라인 생성을 위한 NVIDIA H200 8개
이는 기준 구성일 뿐, 모든 체크포인트, 런타임, 컨텍스트 길이, 동시성 설정에 대한 최소 보장을 의미하지 않는다. 희소 활성화는 연산을 줄이지만, 전문가 가중치 저장과 KV 캐시 메모리는 여전히 주요 고려사항이다.
600B 모델은 메모리 용량을 넘어 다중 GPU 통신, 프레임워크 호환성, 체크포인트 로딩, 장문맥 처리량 등 추가 과제를 제시한다. 대규모 GPU 클러스터가 없는 팀에게는 호스티드 API가 대개 더 실용적인 출발점이다.
개발자는 Step 5 Preview API를 어떻게 사용할 수 있나?
StepFun은 OpenAI 호환 Chat Completions 인터페이스를 지원한다. 아래 파이썬 예시를 실행하기 전에 환경 변수에 STEPFUN_API_KEY를 설정하라. max_tokens는 이 요청의 생성 출력 한도를 제한한다. 선택한 지역 플랫폼의 API 키와 청구 조건을 사용하라. 이 예시는 api.stepfun.ai 엔드포인트를 유지하며, 위의 달러 가격은 StepFun 국제 플랫폼 기준이다.
파이썬 예시: 제한된 텍스트 요청을 StepFun API에 전송하고 반환된 답변을 출력한다.
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["STEPFUN_API_KEY"],
    base_url="https://api.stepfun.ai/v1",
)
response = client.chat.completions.create(
    model="step-5-preview",
    messages=[{
        "role": "user",
        "content": (
            "모놀리식 애플리케이션을 마이크로서비스로 마이그레이션할 때의 아키텍처적 리스크를 분석하세요."
        ),
    }],
    max_tokens=4000,
)
print(response.choices[0].message.content)
프로덕션 사용 전에는 선택한 StepFun 엔드포인트의 허용 파라미터와 생성 한도를 확인하라. 추론 노력 설정, 프롬프트 캐싱, 도구 스키마, 출력 예산은 신뢰성, 지연시간, 최종 청구에 모두 영향을 줄 수 있다.
에이전트 워크플로우에서의 Step 5 Preview
- 리포지토리 문서와 관련 파일을 읽는다.
- 요청된 변경을 식별하고 계획을 제안한다.
- 선택한 코드를 수정하고 외부 도구를 통해 테스트를 실행한다.
- 실패를 점검하고 구현을 수정한다.
- 검증된 변경 사항에 대한 최종 설명을 생성한다.
모델은 추론과 도구 요청을 생성하고, 애플리케이션은 실제 파일 접근, 실행 환경, 권한, 안전 점검을 제공한다. 모델 역량만으로 자율 실행이 보장되지는 않는다.
CometAPI의 대체 모델 API
CometAPI는 위에 링크된 대체 모델에 대해 공통 통합 서비스를 통해 접근을 제공한다. 각 모델의 문서화된 엔드포인트와 요청 형식을 선택한 다음, 동일 워크로드에서 성공률, 토큰 사용량, 재시도, 종단 간 지연시간을 비교하라.
위 예시는 StepFun의 네이티브 엔드포인트를 사용한다. 게이트웨이로 전환하려면 Step 5 Preview의 가용성, 게이트웨이의 문서화된 모델 식별자, 엔드포인트, 청구 조건을 확인해야 한다.
언제 Step 5 Preview를 선택해야 하나?
- 리포지토리 코딩과 문서 중심 리서치에서 대표 테스트가 신뢰할 만한 결과를 확인해 줄 때 선택하라. 긴 컨텍스트와 공개된 코딩·금융 점수는 후보로서의 근거를 제공하며, 터미널 과업 및 가치평가 결과는 왜 워크로드별 테스트가 중요한지 보여준다.
- 대규모 GPU 클러스터 운영 없이 시작하려면 호스티드 API를 선택하라. 승인된 과업당 비용, 캐시 적중률, 재시도, 지연시간을 비교하라. 큰 컨텍스트 윈도우가 빠른 응답이나 낮은 총비용을 보장하지는 않는다.
- 배포 통제가 하드웨어·운영 부담을 정당화할 때 자체 호스팅을 선택하라. 전체 전문가 가중치 저장, KV 캐시, 다중 GPU 통신, 라이선스 요구 사항을 예산에 반영하라. 중대한 금융·엔지니어링 작업에는 소스 검증, 오류 탐지, 휴먼 리뷰를 포함하라.
FAQ
Step 5 Preview의 추론 노력 수준은 어떻게 선택해야 하나?
대표 과업 소수로 시작해 동일한 승인 기준으로 low, medium, high를 비교하라. 정답률, 청구 대상 출력량, 지연시간, 도구 실패를 기록하라. 품질 임계치를 꾸준히 충족하는 가장 낮은 설정을 사용하라. 공개된 High 벤치마크 점수는 low나 medium의 동작을 예측하지 못한다. 구성 가이드를 따르고 비교 시 Chat Completions에서 reasoning_effort를 명시적으로 설정하라.
왜 Step 5 Preview 요청이 64k 출력 토큰 전에 멈출 수 있나?
문서화된 최대치는 상한일 뿐 목표 길이가 아니다. 요청은 max_tokens 예산에 도달했거나, 자연스러운 종료를 반환했거나, 애플리케이션이 처리해야 하는 도구 호출을 생성했기 때문에 더 일찍 멈출 수 있다. 자동 재시도 전에 반환된 종료 이유와 도구 요청을 점검하라. 더 짧게 완료된 답변은 컨텍스트 윈도우 실패를 의미하지 않는다.
Step 5 Preview의 비디오 입력은 어떻게 테스트해야 하나?
검증 가능한 질문과 함께 짧고 대표적인 클립으로 시작하라. 호스티드 API의 비디오 입력 사양은 URL, Base64, stepfile 참조로 비디오를 수용하며, 문서화된 형식에는 MP4, QuickTime, Matroska가 포함된다. URL 입력의 경우, 문서는 128 MB 이하의 개별 MP4 파일을 명시하고 5분 미만을 권장한다. 배치 전 형식과 크기 제한을 확인하고, 단일 프레임 인식뿐 아니라 시간적 질문도 테스트하라.
어떤 지표가 Step 5 Preview의 실제 에이전트 비용을 드러내나?
승인된 과업 완료 수, 모든 턴에 걸친 총 입력·출력 토큰, 캐시 적중, 재시도, 외부 도구 비용, 경과 시간을 측정하라. 총 실행 비용을 성공적 완료 수로 나누되, 성공 기준은 모델 간에 고정하라. 이는 더 많은 시도가 필요한 저렴한 호출과, 초기 실패를 줄이는 더 높은 노력 실행의 경제적 효과를 포착한다.
결론
Step 5 Preview는 장문맥 처리, 반복적 도구 사용, 모델 배포 통제가 필요한 애플리케이션에서 평가할 가치가 있다. StepFun이 공개한 결과는 리포지토리 코딩과 금융 리서치에서 후보임을 시사하며, Terminal-Bench v4와 CorporateValuation은 일부 대안이 더 높은 점수를 보이는 영역을 보여준다. 고정된 승인 기준, 성공당 총비용, 종단 간 지연시간으로 모델을 비교하라. 자체 호스팅을 선택한다면 인프라 비용과 라이선스 요구 사항을 의사결정에 포함하라.