Spesifikasi Teknikal Qwen3.8-Flash
| Spesifikasi | Qwen3.8-Flash |
|---|---|
| Penyedia | Alibaba / Qwen |
| Keluarga model | Qwen3.8 |
| ID model | qwen3.8-flash |
| Jenis model | Model penaakulan multimodal |
| Modaliti input | Teks, imej, video |
| Modaliti output | Teks |
| Tetingkap konteks | 1,000,000 tokens |
| Output maksimum | 128,000 tokens |
| Bajet penaakulan maksimum | 262,144 tokens |
| Mod pemikiran | Disokong |
| Panggilan fungsi | Disokong |
| Alat terbina dalam | Disokong |
Dokumentasi API Qwen semasa menyenaraikan qwen3.8-flash sebagai model Qwen3.8 produksi dengan tetingkap konteks 1M token dan output maksimum 128K. Ia menyokong input teks, imej dan video, panggilan fungsi, alat terbina dalam dan output berstruktur.
Bagi beban kerja visual, had yang didokumenkan termasuk sehingga 16 megapiksel setiap imej, sehingga 2,048 URL imej atau 250 imej Base64, dan sehingga 64 video, dengan video sehingga 2 jam.
Apakah Qwen3.8-Flash?
Qwen3.8-Flash ialah model penaakulan multimodal yang menjimatkan kos oleh Alibaba dalam keluarga Qwen3.8, direka untuk pengekodan, aliran kerja beragen, analisis konteks panjang dan pemahaman visual. Ia menyediakan kelas konteks 1M token yang sama seperti Qwen3.8-Max sambil menyasarkan kos API yang jauh lebih rendah. Panduan pembangun Qwen sendiri dengan jelas mengesyorkan Qwen3.8-Flash apabila pengguna mahukan keupayaan serupa pada harga yang lebih rendah, manakala Qwen3.8-Max diposisikan sebagai pilihan penaakulan yang lebih kuat.
Model ini amat menarik kerana "Flash" tidak bermaksud model kecil yang ringkas. Model API produksi ini menggabungkan penaakulan konteks panjang, input multimodal, penggunaan alat dan output berstruktur dalam titik akhir yang relatif murah.
Apakah Ciri Utama Qwen3.8-Flash?
- Konteks 1M token: Qwen3.8-Flash boleh memproses dokumen dan pangkalan kod yang sangat panjang, menjadikannya sesuai untuk analisis repositori dan sesi agen yang berjalan lama.
- Pemahaman multimodal: API menerima teks, imej dan video, membolehkan pembangun menggabungkan kod, tangkapan skrin, carta, dokumen dan video dalam satu aliran kerja.
- Mod penaakulan: Model ini menyokong mod pemikiran Qwen, dengan bajet penaakulan maksimum yang didokumenkan sebanyak 262,144 token.
- Sokongan agen dan alat: Panggilan fungsi dan alat terbina dalam disokong, termasuk keupayaan seperti carian web, pelaksanaan kod dan alat berkaitan yang dihoskan oleh Qwen.
- Output berstruktur: Pembangun boleh meminta respons berstruktur, menjadikan model lebih mudah diintegrasikan ke dalam aplikasi yang memerlukan JSON atau hasil terhad skema.
- Pemahaman video panjang: Dokumentasi API visual menyenaraikan input video sehingga dua jam, menjadikan Qwen3.8-Flash berguna untuk analisis video dan bukan hanya tugasan kapsyen imej pendek.
Apakah Kes Penggunaan Terbaik untuk Qwen3.8-Flash?
Pengekodan dan Kejuruteraan Perisian
Konteks 1M token berguna untuk repositori besar, sesi nyahpepijat yang panjang dan analisis kod berbilang fail. Sokongan panggilan fungsi dan penaakulan model ini juga menjadikannya sesuai untuk agen pengekodan dan bukan sekadar pelengkapan kod.
Aliran Kerja Beragen
Qwen3.8-Flash menyokong panggilan fungsi dan alat terbina dalam, membolehkan aplikasi membiarkan model mendapatkan maklumat, melaksanakan kod atau berinteraksi dengan sistem luaran.
Analisis Dokumen Panjang
Konteks sejuta token menjadikan model sesuai untuk kontrak besar, dokumentasi teknikal, koleksi penyelidikan dan pangkalan pengetahuan perusahaan di mana pemecahan maklumat berulang sebaliknya diperlukan.
Analisis Video dan Visual
Qwen3.8-Flash menerima kedua-dua imej dan video. Had API visual semasa membenarkan video sehingga dua jam, menjadikannya relevan untuk rakaman mesyuarat, tutorial, kuliah, demonstrasi dan analisis kandungan visual bentuk panjang.
AI Pengeluaran Sensitif Kos
Ini boleh dikatakan kelebihan komersial terbesar model ini. Qwen secara jelas mengesyorkan Flash sebagai alternatif kos lebih rendah kepada Qwen3.8-Max, menjadikannya sesuai untuk aplikasi volum tinggi di mana penaakulan pada tahap flagship tidak diperlukan bagi setiap permintaan.
Apakah Had Qwen3.8-Flash?
Qwen3.8-Flash tidak seharusnya ditafsir sebagai model berprestasi tertinggi dalam keluarga Qwen3.8 semata-mata kerana ia berkongsi tetingkap konteks 1M dengan Qwen3.8-Max.
Pertukaran utama ialah keupayaan berbanding kos: Qwen sendiri mengesyorkan Qwen3.8-Max apabila prestasi penaakulan terkuat diperlukan.
Pertimbangan kedua ialah tetingkap konteks 1M tidak bermakna setiap permintaan harus mengandungi sejuta token. Konteks besar meningkatkan keperluan pemprosesan, dan pembangun wajar menggunakan pengambilan, cache dan pengurusan konteks apabila keseluruhan konteks tidak diperlukan.
Akhir sekali, pembangun harus membezakan qwen3.8-flash yang dihoskan daripada Qwen3.8-Flash-Next dengan berat terbuka. Yang terakhir ialah pratonton seni bina dan mempunyai berat serta seni bina yang didokumenkan secara berasingan; model API produksi harus didokumenkan mengikut spesifikasi API tersendiri.
Adakah Qwen3.8-Flash Sesuai untuk Aplikasi API Pengeluaran?
Ya, terutama apabila aplikasi memerlukan penaakulan multimodal, konteks panjang, penggunaan alat dan kos token yang agak rendah.
Ia merupakan calon produksi yang lebih kukuh berbanding Flash-Next apabila keperluannya hanyalah memanggil API Qwen yang dihoskan, kerana qwen3.8-flash dinyatakan dengan jelas sebagai model produksi dalam dokumentasi API Qwen dengan had konteks, output, alat dan multimodal yang ditakrif.
Untuk kualiti penaakulan maksimum, Qwen3.8-Max kekal sebagai pilihan yang lebih sesuai. Untuk beban kerja volum tinggi di mana kos dan kadar aliran lebih penting, Qwen3.8-Flash ialah pilihan yang lebih ekonomik.
Parameter API Qwen3.8-Flash
Permintaan serasi OpenAI standard boleh menggunakan parameter seperti:
| Parameter | Tujuan |
|---|---|
| model | qwen3.8-flash |
| messages | Perbualan dan input multimodal |
| temperature | Kawalan pensampelan |
| max_tokens | Output terjana maksimum |
| stream | Penstriman respons |
| tools | Definisi fungsi/alatan |
| tool_choice | Tingkah laku pemilihan alat |
| response_format | Konfigurasi output berstruktur |
| enable_thinking | Mendayakan mod penaakulan dalam API Qwen yang disokong |
Dokumentasi mula pantas menggunakan OpenAI SDK dengan pengecam model qwen3.8-flash. Contoh tersebut mendayakan penaakulan dengan extra_body={"enable_thinking": True}.
Cara Menggunakan API qwen3.8-flash dalam CometAPI
Langkah 1: Dapatkan Akses API
Log masuk ke cometAPI. Jika anda belum menjadi pengguna kami, sila daftar terlebih dahulu. Log masuk ke konsol CometAPI. Dapatkan kunci API kelayakan akses bagi antara muka. Klik “Add Token” pada token API di pusat peribadi, dapatkan kunci token: sk-xxxxx dan serahkan.
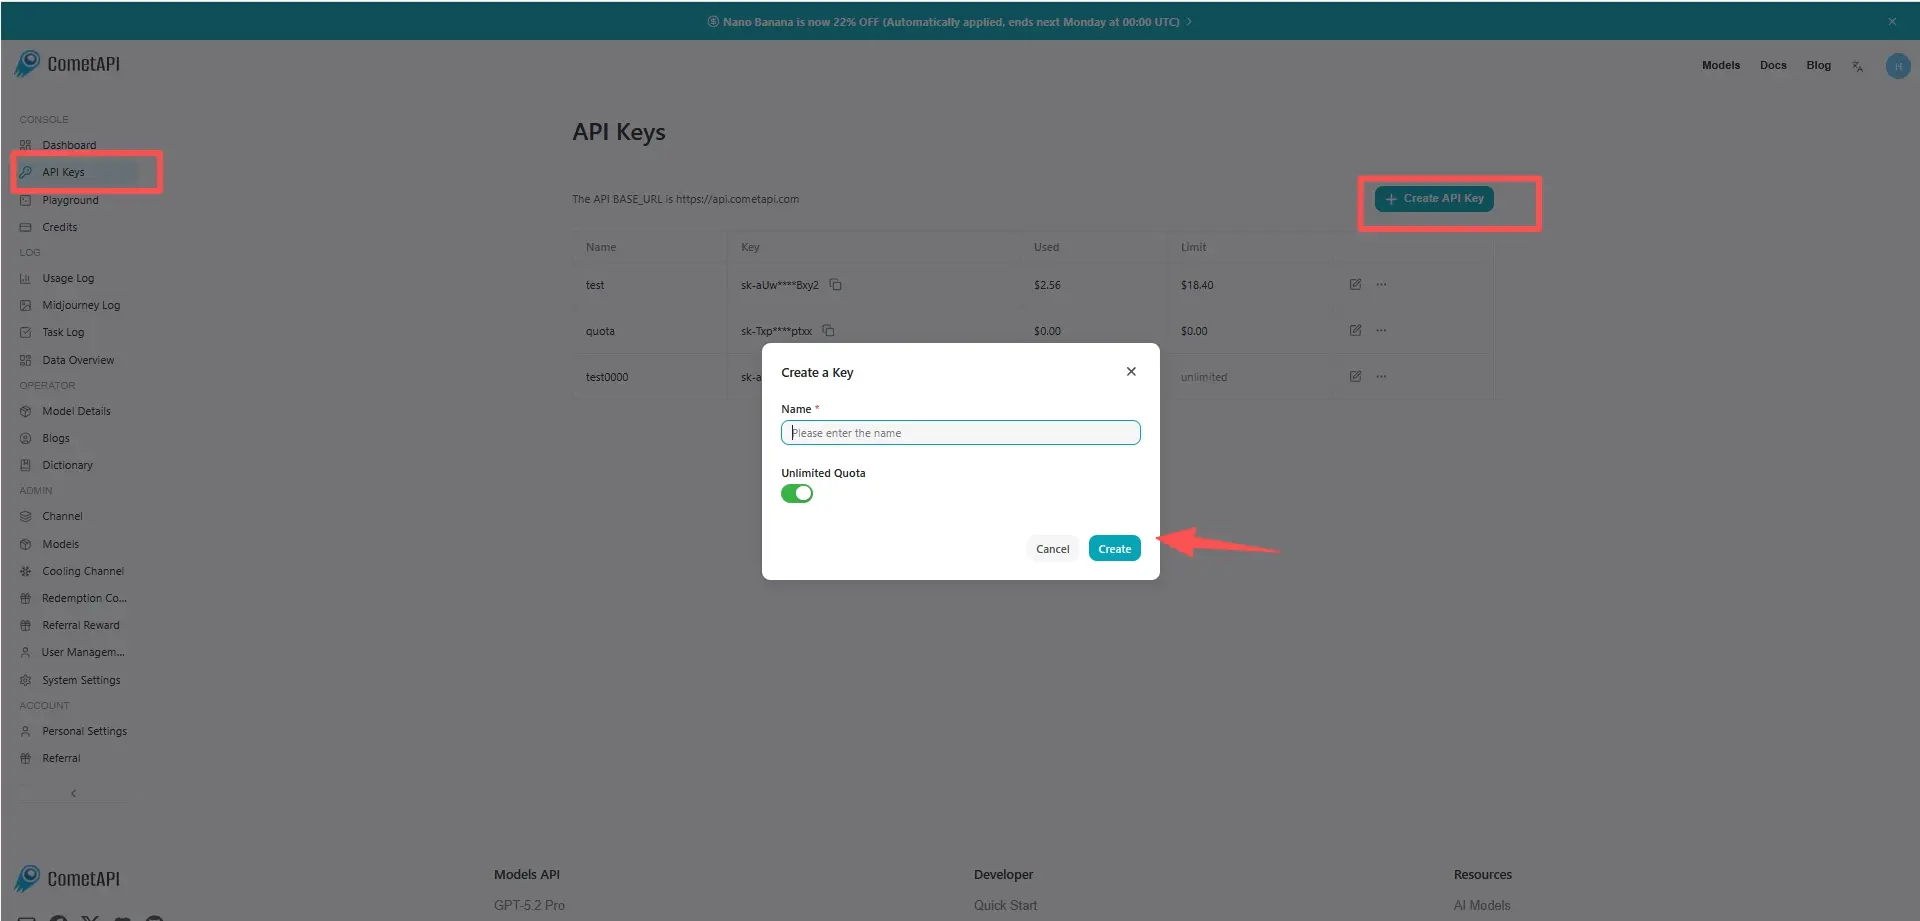
Langkah 2: Hantar Permintaan ke API qwen3.8-flash
Pilih titik akhir “qwen3.8-flash” untuk menghantar permintaan API dan tetapkan badan permintaan. Kaedah permintaan dan badan permintaan diperoleh daripada dokumen API di laman web kami. Laman web kami juga menyediakan ujian Apifox untuk kemudahan anda. Gantikan <YOUR_API_KEY> dengan kunci CometAPI sebenar daripada akaun anda.
Masukkan soalan atau permintaan anda ke medan content—ini yang akan dijawab oleh model. Proses respons API untuk mendapatkan jawapan yang dijana. Ia menyokong AI SDK, OpenAI Chat Completions, OpenAI Responses dan antara muka serasi Anthropic Messages.
Langkah 3: Proses Respons
API memulangkan respons calon berstruktur termasuk teks yang dijana, rujukan, metadata keselamatan dan output alat pilihan. Untuk permintaan multimodal, kandungan mesej boleh distruktur dengan input teks dan imej apabila titik akhir CometAPI yang dipilih mendedahkan keupayaan visi model.