Choose your path
Blog Qwen3
Cara Menggunakan API Qwen3.8-Flash: Panduan Lengkap untuk Pembangun
Ketahui cara menggunakan API Qwen3.8-Flash dengan CometAPI, termasuk Python, JavaScript, cURL, penstriman, mod pemikiran, input multimodal, output berstruktur.
Cara Menghoskan Qwen 3.8 Max Secara Tempatan: Perkakasan, vLLM, SGLang dan Panduan Kuantisasi
Di bawah ialah panduan menyeluruh untuk menyediakan dan melancarkan model Qwen berskala besar secara setempat menggunakan pemberat terbuka (contoh: “Qwen3.8-2.4T-A95B”), dengan fokus kepada keperluan GPU, mod FP8/FP4 (atau 4-bit), integrasi vLLM dan SGLang, tetingkap konteks 1M, serta pengoptimuman produksi. Gantikan nama model/rujukan laluan dengan model sebenar yang anda miliki. Ringkasan pantas - Saiz model: ~A95B (±95B parameter) adalah kategori “ultra-besar”; perlu multi-GPU. - Mod ketepatan: - FP16/BF16: + ketepatan, – memori - FP8: kompromi baik (perlu GPU Hopper/Ada dan TE) - 4-bit (AWQ/GPTQ): penjimatan memori besar, sedikit susut kualiti - Rangka kerja pelayan: vLLM atau SGLang, kedua-duanya menyokong batching berterusan dan pengurusan KV-cache lanjutan. - Konteks 1M: hanya praktikal jika model dilatih/diubah suai untuk long context dan anda menggunakan strategi pengurangan memori (KV-cache quantization/offload/sliding window). 1) Prasyarat sistem - OS: Linux x86_64 moden (Ubuntu 22.04 disyorkan) - Pemacu GPU & CUDA: - NVIDIA Driver terkini yang sepadan CUDA 12.x - CUDA Toolkit 12.x (atau gunakan imej Docker dengan CUDA 12.x) - cuDNN/Transformer Engine (TE) jika ingin FP8 sebenar - Python 3.10/3.11 dengan pip/venv - Storan: NVMe SSD pantas (≥2–4 TB) untuk pemberat/indeks/cache - Rangkaian: Jika memuat turun dari repositori, sediakan token/pintu masuk yang diperlukan 2) Keperluan GPU dan anggaran memori Anggaran kasar memori hanya untuk pemberat (tidak termasuk KV-cache dan overhead): - FP16/BF16: ~2 bait/parameter ⇒ ~190 GB untuk ±95B - FP8: ~1 bait/parameter ⇒ ~95 GB - 4-bit (AWQ/GPTQ): ~0.5 bait/parameter (+overhead) ⇒ ~50–60 GB Nota penting: - KV-cache untuk konteks panjang (contoh 1M token) boleh mengatasi memori pemberat dengan margin besar. Tanpa strategi seperti quantization KV-cache, offload, atau perhatian gelangsar, 1M jarang praktikal walaupun dengan banyak GPU. - Disarankan GPU kelas data center dengan memori besar dan interkoneksi pantas: - H100/H200 (80 GB) atau A100/A800 (80 GB) atau L40S (48 GB) - NVLink sangat membantu untuk beban ultra-besar - Contoh konfigurasi bijak: - FP8: 2–4× H100 80 GB (bergantung pada overhead dan KV-cache) - 4-bit: 2× L40S 48 GB atau 2× A100 80 GB boleh mencukupi untuk pemberat; perlu rancang KV-cache dengan teliti 3) Perolehan model - Pastikan anda benar-benar mempunyai “pemberat terbuka” untuk model sasaran. - Simpan di direktori setempat, contoh: - /models/Qwen3.8-2.4T-A95B - Untuk 4-bit: - Jika gunakan AWQ/GPTQ, pastikan model telah dipra-kuantis (atau sediakan pipeline pra-kuantisasi) - Untuk FP8: - Pastikan stack FP8 tersedia (GPU Hopper/Ada + NVIDIA Transformer Engine). Tidak semua pipeline menyokong FP8 penuh out-of-the-box. 4) Konfigurasi tetingkap konteks 1M - Gunakan model yang benar-benar menyokong tetingkap konteks panjang (latihan/penalaan dengan RoPE scaling atau teknik setara). - Semak fail konfigurasi HF (contoh rope_scaling, max_position_embeddings). Jika model tidak menyokong 1M secara natif, anda memerlukan teknik lanjutan (contoh NTK/YARN/linear scaling) yang mesti sepadan dengan latihan/penalaan—sekadar menetapkan max length tanpa sokongan model akan merosakkan kualiti. - Gunakan strategi memori: - KV-cache quantization (FP8/4-bit) jika disokong - KV-cache offload ke CPU/NVMe untuk prefill panjang - Sliding-window/sparse attention jika tersedia - Chunked prefill (pemecahan prefill kepada kepingan kecil) 5) Pelancaran dengan vLLM (serving API) Pemasangan - Buat persekitaran: - python -m venv .venv && source .venv/bin/activate - pip install --upgrade pip - pip install vllm - Untuk FP8: pasang juga transformer-engine (serasi GPU dan driver); rujuk dokumentasi TE dan vLLM versi yang menyokong FP8. Pelancaran asas (Python API) - Gunakan API Python untuk mengawal lebih baik parameter: - from vllm import LLM, SamplingParams - llm = LLM( model="/models/Qwen3.8-2.4T-A95B", tensor_parallel_size=4, # bilangan GPU max_model_len=1_000_000, # jika model menyokong 1M dtype="bfloat16", # atau "auto" quantization="awq" # pilihan: "awq", "gptq", None; set FP8 ikut sokongan ) - params = SamplingParams(temperature=0.7, top_p=0.9, max_tokens=1024) - llm.generate(["Arahan anda di sini"], params) - Nota: - Jika menggunakan 4-bit, sediakan model AWQ/GPTQ dahulu; set quantization selaras dengan model. - Untuk FP8, gunakan dtype/konfigurasi yang disokong versi vLLM anda (sesetengah binaan nightlies/TE diperlukan). Pastikan keserasian sebelum produksi. - Pelayan HTTP (API server): - python -m vllm.entrypoints.api_server \ --model /models/Qwen3.8-2.4T-A95B \ --tensor-parallel-size 4 \ --max-model-len 1000000 \ --dtype bfloat16 \ --quantization awq \ --gpu-memory-utilization 0.90 \ --host 0.0.0.0 --port 8000 - Parameter praktikal: - --tensor-parallel-size: sepadankan dengan bilangan GPU - --gpu-memory-utilization: 0.85–0.95 untuk penggunaan memori agresif - --max-model-len: tetapkan hanya jika model benar-benar menyokongnya - --quantization: gunakan nilai yang sepadan dengan model/artefak (awq/gptq/None) - Gunakan continuous batching (lalai vLLM) untuk throughput Pengurusan KV-cache di vLLM - Aktifkan/konfigurasi paged KV (lalai di vLLM moden) - Jika tersedia dalam versi anda: - Gunakan KV-cache quantization (FP8) untuk jimat memori - Prefill chunking: pisahkan prompt panjang kepada blok untuk mengekalkan kestabilan dan penggunaan memori rendah 6) Pelancaran dengan SGLang Pemasangan - python -m venv .venv && source .venv/bin/activate - pip install sglang - Untuk FP8, pastikan transformer-engine/komponen CUDA yang berkaitan dipasang. Pelancaran asas - SGLang menyediakan server inference dengan continuous batching, speculative decoding, dan prefill chunking: - python -m sglang.launch_server \ --model /models/Qwen3.8-2.4T-A95B \ --tp 4 \ --max-context-len 1000000 \ --dtype bfloat16 \ --quantization awq \ --host 0.0.0.0 --port 8000 - Cadangan: - Hidupkan chunked prefill untuk prompt panjang - Gunakan speculative decoding (jika sesuai dan model draf tersedia) untuk mempercepat decode - Sesuaikan scheduler/batching mengikut SLA latency 7) FP8 dan FP4/4-bit: amalan terbaik - FP8: - Memerlukan GPU Hopper/Ada (H100/H200/L40S) dan TE - Set FP8 untuk lapisan linear utama; uji kestabilan output - Perlu semakan keserasian kernel (FMHA, GEMM) versi CUDA/driver - 4-bit (FP4 setara dari perspektif storan pemberat): - AWQ (W4A16) atau GPTQ: - AWQ: latensi baik, perlu model yang dipra-kuantis - GPTQ: juga popular, latensi sedikit berbeza bergantung kernel - Perhatikan: - Penurunan ketepatan kecil dijangka; uji dengan set penanda aras dalaman - Pastikan quant scales/metadata disertakan (awq_config/gptq config) 8) Konteks 1M: strategi praktikal - Pastikan model benar-benar dilatih/ditala untuk 1M; jika tidak, gunakan: - RoPE scaling yang betul (linear/NTK/YARN) mengikut latihan - Sliding Window Attention (SWA) atau teknik sparsity jika tersedia - Kurangkan kos KV: - Quantize KV-cache (FP8/4-bit) jika disokong - KV offload ke CPU/NVMe semasa prefill - Gunakan chunked prefill dan streaming output - Hadkan panjang decode: - Tetapkan max_new_tokens yang munasabah - Gunakan cache/prompt reuse (prefix caching) untuk kes penggunaan berulang 9) Pengoptimuman produksi - Throughput vs latency: - Sesuaikan saiz batch, max_num_batched_tokens, dan keutamaan permintaan - Gunakan continuous batching; kumpulkan permintaan prefill panjang untuk efisiensi - Prefill/decode: - Gunakan prefill chunking untuk beban panjang - Pertimbangkan speculative decoding (SGLang) atau draft model untuk decode laju - Pengurusan memori: - Naikkan gpu-memory-utilization dengan berhati-hati - Hidupkan KV-cache compression/quantization - Offload pemberat kurang kritikal/attention KV ke CPU/NVMe jika perlu - Kebolehskalaan: - Tensor parallel (TP) merentasi GPU dengan NVLink - Skala mendatar: jalankan berbilang replika di belakang load balancer - Kebolehpercayaan: - Warmup model (jalankan permintaan dummy pada permulaan) - Healthcheck dan autoscaling berdasarkan QPS/latency - Observability: metrik GPU (utilization/mem), latency per tahap (prefill/decode), rate error - Keselamatan dan tadbir urus: - Hadkan panjang prompt/output - Penapisan kandungan/pematuhan dasar - Audit log dan versi model yang jelas - Pengemasan: - Gunakan pinned dependencies untuk mengelakkan regresi kernel - Uji kombinasi driver/CUDA/TE sebelum naik taraf produksi 10) Ujian dan penentukuran - Ujian fungsian: - Periksa keserasian 1M dengan sampel prompt panjang - Pastikan kualiti tidak merosot ketara selepas FP8/4-bit - Penanda aras: - Ukur prefill throughput (tok/s) dan decode latency untuk pelbagai panjang - Uji di bawah beban serentak; sesuaikan batching/scheduler - Tuning: - Laraskan TP size, max_model_len, quantization, dan parameter batching - Pantau out-of-memory; kurangkan max_num_batched_tokens atau aktifkan offload 11) Ringkas konfigurasi cadangan mengikut sasaran - Latency rendah, kualiti tinggi: - BF16/FP16 di 4× H100 80 GB, continuous batching, prefill chunking - Seimbang kos/kelajuan: - FP8 di 2–4× H100/L40S; KV-cache FP8 jika sokong - Kos minimum: - 4-bit (AWQ/GPTQ) di 2× L40S/A100; KV-cache quant/offload; hadkan konteks efektif jika perlu Penutup - Pastikan ketersediaan sebenar “Qwen3.8-2.4T-A95B” (pemberat terbuka) dan keserasian rangka kerja dengan mod FP8/FP4 yang anda sasarkan. - Untuk 1M konteks, kejayaan banyak bergantung pada latihan model, strategi KV-cache, dan infrastruktur GPU/IO. - Mulakan dengan prototaip (quant 4-bit atau FP8), sahkan kualiti, kemudian naik taraf ke kluster GPU bersesuaian serta aktifkan optimisasi produksi (batching, prefill chunking, KV quant/offload, observability).
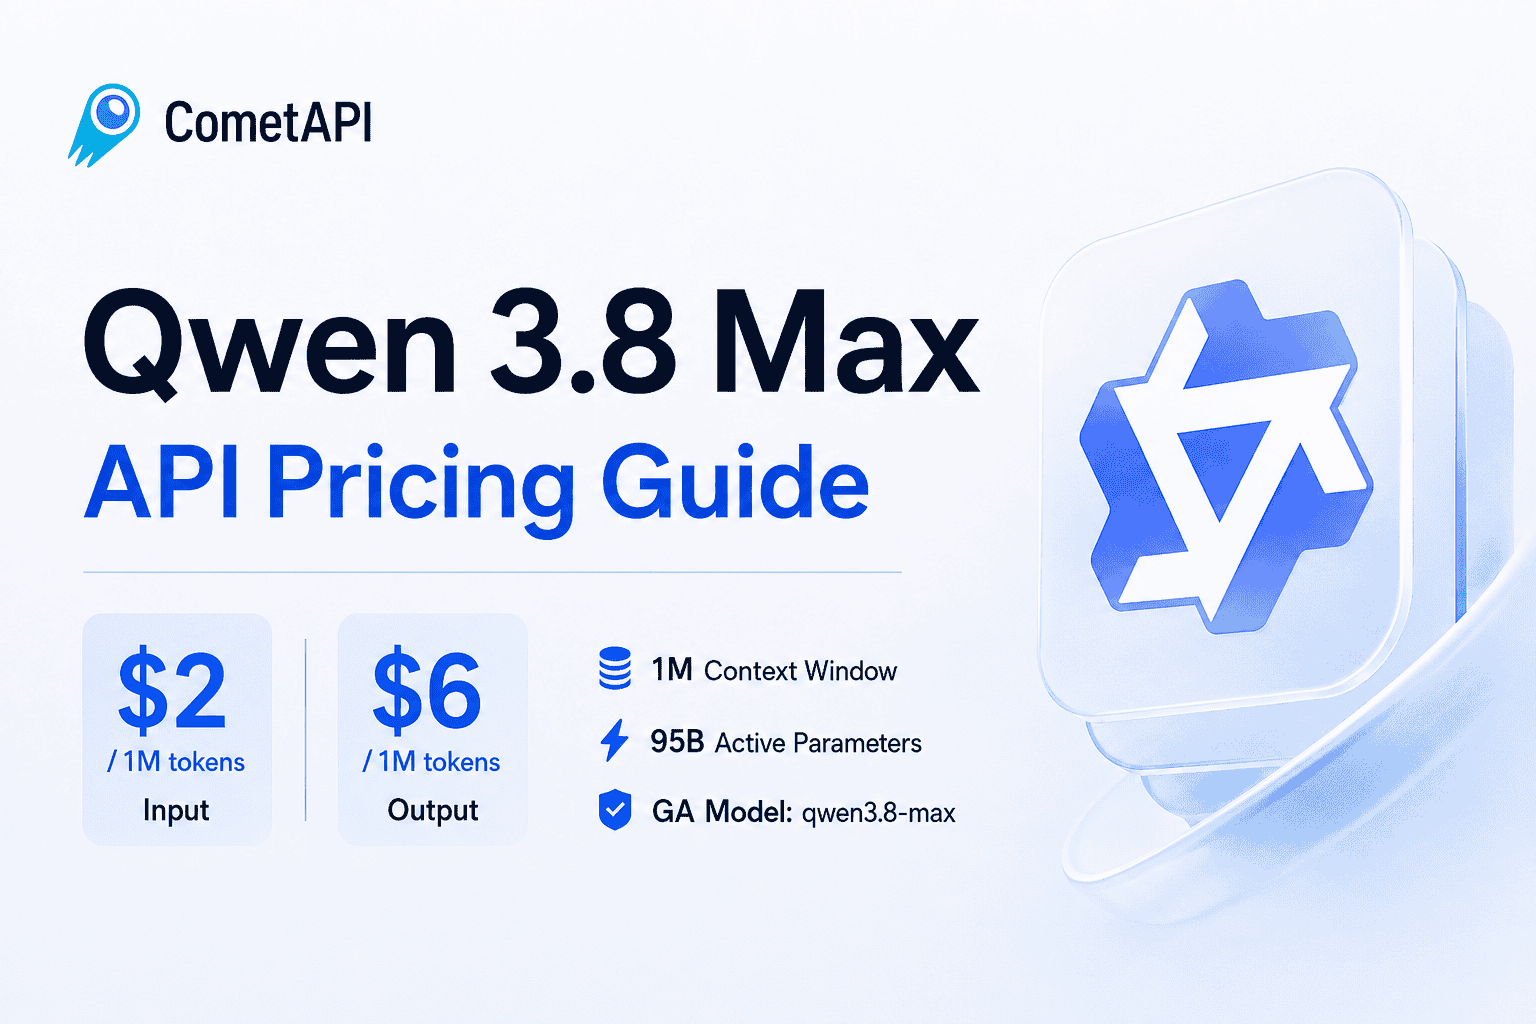
Harga API Qwen 3.8 Max: $2 Input, $6 Output, 1M Konteks
Qwen 3.8 Max mengenakan kos $2/M bagi input dan $6/M bagi output. Bandingkan fi cache, kos alat, contoh sebenar, had, dan nasihat migrasi Qwen 3.7.
Cara Menggunakan API Qwen 3.5
Pada malam Tahun Baharu Cina (16–17 Feb, 2026), Alibaba Group melancarkan model generasi seterusnya, Qwen 3.5 — sebuah model multimodal yang berkeupayaan ejen, diposisikan untuk apa yang syarikat panggil sebagai era “agentic AI”. Liputan industri menonjolkan dakwaan tentang peningkatan besar dalam kecekapan dan penjimatan kos, serta sokongan pantas daripada vendor perkakasan dan awan. CometAPI merupakan pilihan bagi pembangun yang mahukan akses API terhos atau integrasi yang serasi dengan OpenAI, manakala AMD mengumumkan sokongan GPU Day-0 untuk model tersebut pada barisan Instinct. ByteDance ialah salah satu pesaing domestik utama yang melancarkan naik taraf sekitar tempoh cuti yang sama. OpenAI kekal sebagai titik rujukan untuk perbandingan dalam penanda aras dan gaya integrasi.
Qwen-3.5 pada Tahun Baru Lunar — adakah ia mengungguli peringkat teratas sumber tertutup pada tahun 2026?
Qwen3.5 baharu daripada Alibaba merupakan satu langkah besar ke hadapan — ia merapatkan jurang dengan model tertutup di barisan hadapan tertentu pada sejumlah penanda aras awam dan ujian dalaman, dan dalam sesetengah beban kerja berasaskan agen / multimodal mendakwa mencapai kesetaraan atau kelebihan berbandingnya. Namun, "mengatasi" bergantung pada beban kerja: dalam penggunaan alat berasaskan agen, pemahaman dokumen/video multimodal, dan kos per inferens, Qwen3.5 dilaporkan amat kompetitif (dan dalam sesetengah carta vendor berada di hadapan). Rumusan praktikal: Qwen3.5 kelihatan sebagai pesaing sebenar di barisan hadapan pada awal 2026 — bagi banyak kes penggunaan perusahaan yang berasaskan agen dan multimodal, ia kini berdaya maju sebagai pilihan utama.
Cara menggunakan Qwen3-max thinking
Qwen3-Max-Thinking keluaran Alibaba — varian “pemikiran” bagi keluarga Qwen3 yang berskala besar — telah menjadi salah satu tajuk utama dalam AI tahun ini: model perdana dengan lebih daripada satu trilion parameter yang dioptimumkan untuk penaakulan mendalam, pemahaman konteks panjang dan aliran kerja berasaskan agen. Ringkasnya, ini ialah langkah pembekal untuk memberikan aplikasi mod pemikiran “System-2” yang lebih perlahan dan lebih mudah dijejak: model ini bukan sekadar menjawab; ia boleh menunjukkan (dan menggunakan) langkah-langkah, alat dan semakan perantaraan secara terkawal.

Alibaba AI Memperkenalkan Qwen3-Max: trilion-parameter model Qwen, sokongan CometAPI
Pasukan Qwen Alibaba telah mengeluarkan Qwen3-Max-Preview (Instruct) — model terbesar syarikat setakat ini, dengan lebih daripada 1 trilion parameter — dan menjadikannya
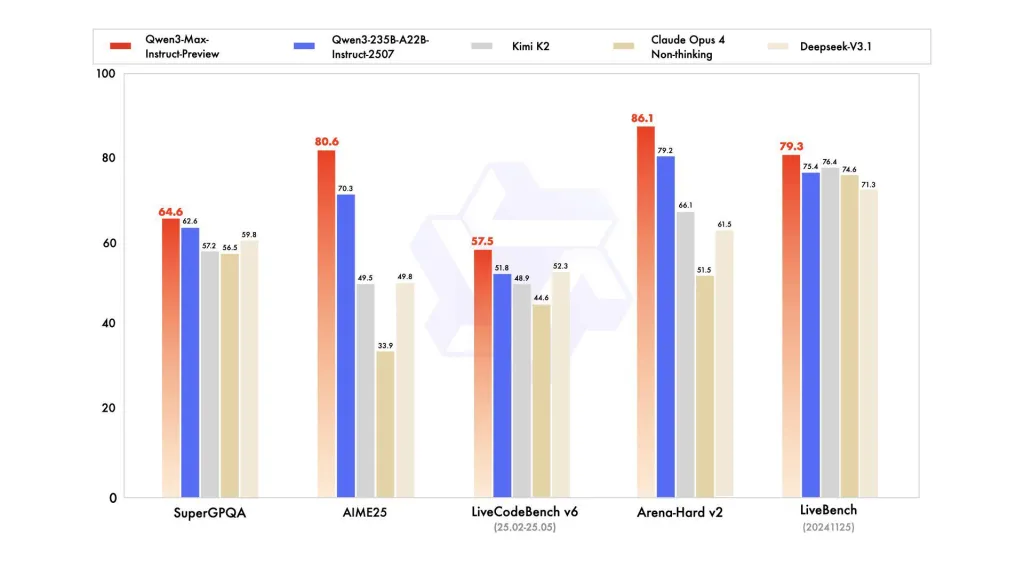
API Qwen3-Max-Preview
Qwen3-Max-Preview ialah model pratonton perdana terbaharu Alibaba dalam keluarga Qwen3 — satu trilion+-parameter, model gaya Campuran Pakar (MoE) dengan tetingkap konteks token 262k ultra panjang, dikeluarkan dalam pratonton untuk kegunaan perusahaan/awan. Ia menyasarkan *penaakulan mendalam, pemahaman dokumen panjang, pengekodan dan aliran kerja agen.