
Menjalankan Qwen3.8-Max secara setempat kini boleh dilakukan, tetapi frasa “Qwen 3.8 Max secara setempat” memerlukan satu penjelasan penting. Produk Max hos Alibaba dan checkpoint boleh muat turun berkait rapat, namun ia bukan produk yang serupa.
Qwen mula melancarkan perkhidmatan Max hos pada awal Ogos 2026 dan mengeluarkan Qwen3.8-2.4T-A95B sebagai berat terbuka pada 12 Ogos 2026. Checkpoint itulah model yang anda benar-benar gunakan pada infrastruktur sendiri.
Ini bukan tutorial Ollama-di-atas-PC-permainan yang biasa. Checkpoint tanpa kuantis ialah model Mixture-of-Experts 2.4 trilion parameter, dan resepi vLLM semasa menganggarkan berat BF16 bersaiz 4.45 TiB. Malah varian orientasi produksi berketepatan 4-bit terapung masih memakan kira-kira 1.3–1.5 TiB berat.
Jawapan ringkas: pengehosan sendiri kelas penuh Qwen 3.8 Max ialah penyebaran pusat data. Titik permulaan produksi yang praktikal ialah checkpoint FP4 pada 8× B300 atau 8× MI355X GPU; penyebaran H200 memerlukan lebih banyak GPU. Untuk stesen kerja biasa, gunakan Qwen3.8-27B.
Qwen 3.8 Max vs. Model Terbuka yang Anda Benar-benar Sebarkan
Checkpoint boleh muat turun Qwen3.8-2.4T-A95B secara rasmi digambarkan sebagai model bahasa kausal 2.4T-parameter dengan kira-kira 95B parameter diaktifkan setiap token. Perkhidmatan Max hos menambah keupayaan lapisan produk yang tidak hadir dalam checkpoint terbuka semasa.
| Spesifikasi | Perkhidmatan hos Qwen3.8-Max | Checkpoint terbuka Qwen3.8-2.4T-A95B |
|---|---|---|
| Jumlah parameter | 2.4T | 2.4T |
| Parameter aktif | ~95B | ~95B |
| Seni bina | Sparse MoE | Sparse MoE |
| Input | Teks, imej, video | Teks |
| Konteks | 1M konteks terurus | 262,144 asli; boleh diperluas ke ~1.01M |
| Tingkah laku fikir | Fikiran terurus / tanpa fikiran | Fikiran diperlukan; usaha penaakulan boleh dikonfigurasi |
| Alat terbina dalam | Tersedia pada perkhidmatan terurus | Aplikasi mesti menyediakan alat |
| Pengehosan sendiri | Tiada pengurusan berat diperlukan | Ya; checkpoint terbuka |
Produk hos mendedahkan input teks, imej, dan video dengan konteks 1,000,000 token. Sebaliknya, checkpoint terbuka ialah teks sahaja dan mempunyai konteks asli 262,144 token. Perbezaan ini penting jika aplikasi anda bergantung pada input multimodal atau alat terbina dalam terurus.
Seni Bina dan Spesifikasi Qwen 3.8
CometAPI telah meliputi latar belakang model dalam What is Qwen3.8 Max, jadi panduan penyebaran ini mengekalkan perbincangan seni bina tertumpu pada butiran yang mempengaruhi memori, paralelisme, dan penyajian.
| Spesifikasi berkaitan penyebaran | Qwen3.8-2.4T-A95B |
|---|---|
| Jumlah / parameter aktif | 2.4T / ~95B setiap token |
| Susun atur lapisan | 92 lapisan: 69 Gated DeltaNet + 23 perhatian penuh |
| Perutean MoE | 512 pakar dirutekan; 10 dirutek + 1 dikongsi aktif |
| Kepala perhatian penuh | 64 kepala query / 4 kepala key-value |
| Konteks asli | 262,144 token |
| Konteks diperluas | Sehingga kira-kira 1,010,000 token |
| Ramalan Berbilang Token | Disokong |
| Modality checkpoint terbuka | Teks sahaja |
Seni bina model hibrid Qwen rasmi yang digunakan dalam panduan penyebaran SGLang Qwen3.8.
Jangan tafsir “95B parameter aktif” sebagai jejak memori model 95B. Pengaktifan jarang mengurangkan komput per token, tetapi sistem penyajian masih perlu mengakses keseluruhan set berat pakar.
Snapshot Penanda Aras Qwen 3.8 Max
Memandangkan tinjauan Qwen3.8 Max sedia ada oleh CometAPI sudah membincangkan penanda aras secara terperinci, artikel ini hanya menggunakan subset berkaitan penyebaran daripada jadual penanda aras kad model rasmi Qwen.
| Penanda aras | Qwen3.8-Max | Qwen3.7-Max | GPT-5.6 Sol (max) |
|---|---|---|---|
| Terminal Bench 2.1 | 86.6 | 74.5 | 88.8 |
| SWE-bench Pro | 67.7 | 60.6 | 64.6 |
| PaperBench | 93.0 | 64.8 | 90.5 |
| FrontierSWE | 73.5 | 40.7 | — |
| CoWorkBench | 74.8 | 64.6 | 71.5 |
| GPQA Diamond | 92.6 | 92.4 | 94.1 |
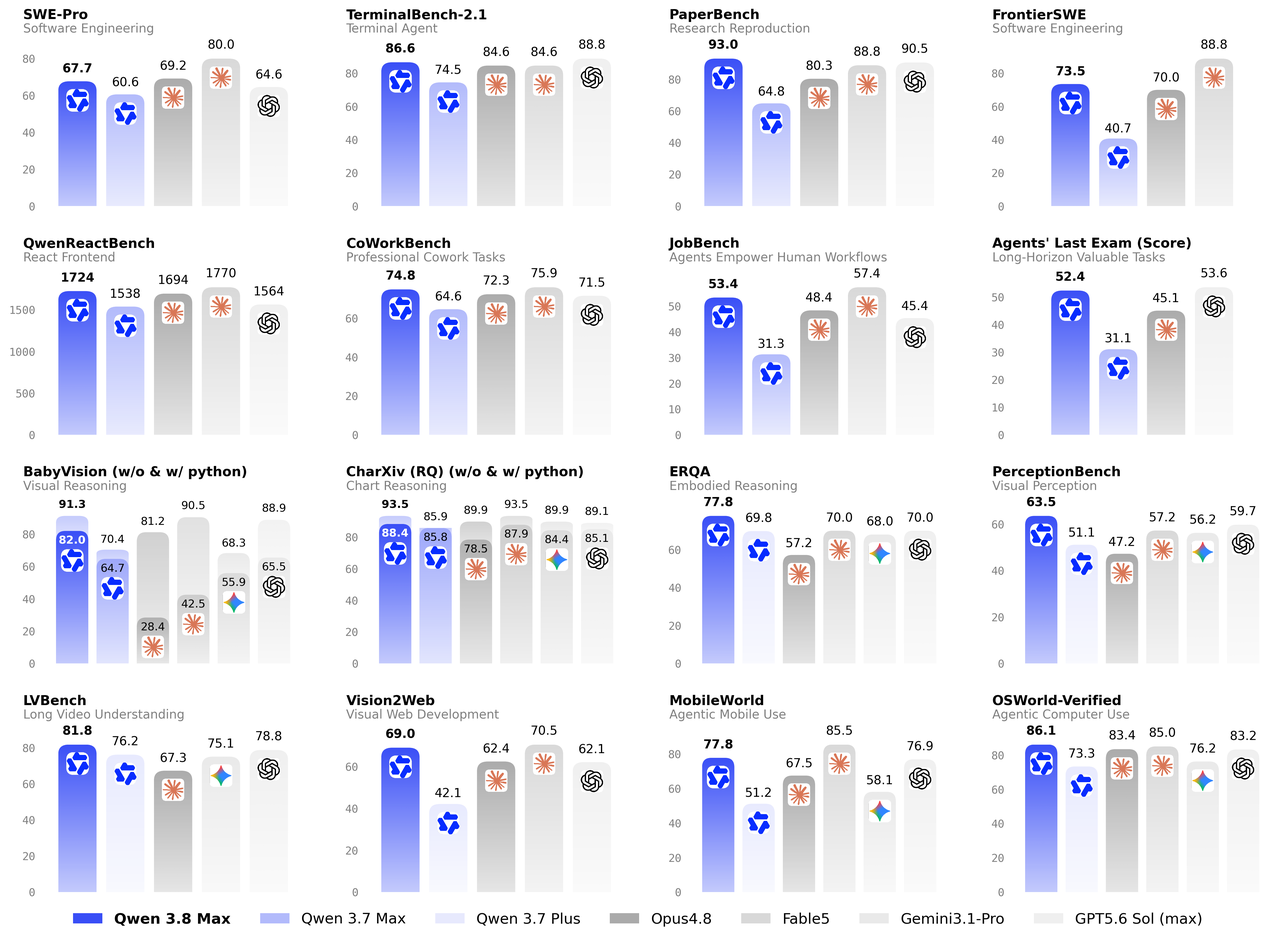
Grafik prestasi Qwen3.8 rasmi yang diterbitkan oleh pasukan Qwen.
Kenaikan terbesar yang dilaporkan berbanding Qwen3.7-Max dalam subset ini ialah PaperBench dan FrontierSWE. Qwen3.8-Max juga melebihi GPT-5.6 Sol pada SWE-bench Pro dan PaperBench, manakala GPT-5.6 Sol kekal di hadapan pada Terminal Bench 2.1. Untuk keputusan penyebaran, anggap ini sebagai konteks keupayaan; ukuran memori dan throughput penyajian di bawah lebih relevan dari segi operasi.
Jadual penanda aras bukan ranking sejagat. Harness, had masa, had konteks, akses alat, dan kuantisasi boleh mengubah keputusan. Jalankan penanda aras ke atas checkpoint, ketepatan, enjin penyajian, dan taburan prompt yang tepat anda rancang untuk digunakan.
Perkakasan Apakah yang Diperlukan Qwen3.8 untuk Penyebaran Setempat?
Keperluan GPU untuk Qwen3.8-2.4T-A95B
Ini ialah soalan penyebaran utama. Resepi vLLM Qwen3.8 semasa menerbitkan jejak checkpoint dan kiraan GPU realistik dengan ruang kepala runtime, yang lebih berguna daripada menganggar VRAM hanya daripada kiraan parameter.
| Ketepatan | Jejak berat | B300 (268 GB) | MI355X (288 GB) | H200 (141 GB) | Padanan terbaik |
|---|---|---|---|---|---|
| BF16 | 4.45 TiB | 24 GPU | 24 GPU | 48 GPU | Fideliti maksimum / penyelidikan |
| FP8 | 2.27 TiB | 16 GPU | 16 GPU | 32 GPU | Produksi fideliti tinggi |
| MXFP4 | 1.45 TiB | — | 8 GPU | 16 GPU | Penyebaran AMD praktikal |
| NVFP4 W4A4 | 1.32 TiB | 8 GPU | — | 16 GPU | Penyebaran NVIDIA praktikal |
Bagi kebanyakan organisasi yang benar-benar memerlukan Qwen3.8 dihos sendiri, FP4 ialah titik permulaan yang praktikal. Konfigurasi NVIDIA yang menonjol ialah NVFP4 W4A4 pada 8× B300; laluan AMD yang sepadan ialah MXFP4 pada 8× MI355X.
Pelayan 8× H200 tidak mencukupi untuk penyebaran model penuh yang disyorkan ini. Resepi rasmi menganggarkan H200 pada 16 GPU untuk FP4, 32 untuk FP8, dan 48 untuk BF16.
Keperluan VRAM untuk Qwen3.8-27B
Qwen3.8-27B ialah alternatif kelas stesen kerja yang praktikal. Memori berat mentah adalah kira-kira 54 GB dalam BF16, 27 GB dalam FP8, dan 13.5 GB pada ketepatan 4-bit. Overhed runtime dan KV cache meningkatkan keperluan sebenar, terutamanya pada panjang konteks yang panjang.
| Ketepatan | Anggaran memori berat | Panduan penyebaran praktikal |
|---|---|---|
| BF16 | ~54 GB | Gunakan GPU 64–80 GB, bergantung pada konteks dan overhed penyajian. |
| FP8 / INT8 | ~27 GB | GPU 40–48 GB menyediakan ruang kepala runtime yang lebih praktikal. |
| 4-bit | ~13.5 GB | GPU pengguna 20–24 GB boleh digunakan pada panjang konteks sederhana. |
Angka ini ialah anggaran perancangan yang diperoleh daripada kiraan parameter. Sahkan checkpoint tepat, format kuantisasi, enjin penyajian, panjang konteks, dan tetapan KV-cache sebelum menyukat perkakasan produksi.
Bolehkah Qwen3.8 Dijalankan pada GPU Pengguna?
Model penuh Qwen3.8-2.4T-A95B tidak praktikal pada GPU pengguna biasa, walaupun apabila dikuantis secara agresif. Projek komuniti telah menunjukkan binaan UD-Q1_0 mampatan agresif 397 GB merentasi empat sistem DGX Spark, tetapi laluan itu ialah kuantisasi ekstrem eksperimen dan bukan garis dasar untuk penyajian sensitif kualiti.
Untuk stesen kerja atau makmal rumah, model yang lebih sesuai ialah Qwen3.8-27B, yang berat terbukanya dikeluarkan pada 14 Ogos 2026. Model ini jauh lebih mudah untuk dihos dan merupakan pilihan yang tepat jika “setempat” bermaksud satu stesen kerja dan bukannya kluster GPU.
Sebelum Anda Memasang Qwen 3.8 Max
Rancang infrastruktur sebelum menjalankan arahan pemasangan. Anda memerlukan Linux, timbunan pemecut yang serasi, storan setempat atau kongsi yang mencukupi untuk checkpoint, interkoneksi GPU jalur lebar tinggi, dan—apabila merentasi nod—rangkaian yang direka untuk inferens teragih. Resepi vLLM kini mengesyorkan vLLM nightly dan Transformers 5.4.0 atau lebih baharu.
bash
uv venv
source .venv/bin/activate

uv pip install -U vllm \
  --extra-index-url https://wheels.vllm.ai/nightly

uv pip install -U "transformers>=5.4.0"
Cara Menyebarkan Qwen 3.8 FP8 dengan vLLM
FP8 ialah pilihan munasabah apabila anda mahukan checkpoint yang disediakan Qwen dan mampu infrastruktur berbilang nod. Checkpoint rasmi ialah Qwen/Qwen3.8-2.4T-A95B-FP8.
Untuk penyebaran dua nod, 16-GPU kelas B300, jalankan nod ketua dengan:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
Pada nod pekerja, gunakan topologi yang sama dengan pangkat nod berbeza dan tanpa pelayan API:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 1 \
  --master-addr "$HEAD_ADDR" \
  --headless \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
Jangan salin contoh 16-GPU ini ke pelayan H200 tanpa mengubah saiz topologi. Varian FP8 yang sama kini dianggarkan pada 32× H200 dalam resepi vLLM.
Cara Menjalankan Qwen 3.8 pada Satu Pelayan 8× B300
Untuk NVIDIA Blackwell, konfigurasi model penuh yang paling praktikal ialah NVFP4. vLLM kini mengesahkan NVFP4 W4A4 dengan paralelisme tensor merentasi lapan GPU B300.
bash
vllm serve Inferact/Qwen3.8-2.4T-A95B-NVFP4 \
  --tensor-parallel-size 8 \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
Binaan NVFP4 oleh Inferact ialah checkpoint dikuantis dan bukannya artifak BF16 Qwen asal. Sahkan kualiti model pada set penerimaan anda sendiri sebelum menganggapnya sebagai pengganti satu-ke-satu untuk BF16 atau FP8.
Cara Menyebarkan Qwen 3.8 dengan SGLang
SGLang menambah sokongan Hari-0 untuk Qwen3.8 pada 12 Ogos dan amat menarik untuk penyajian throughput tinggi, caching prefiks, paralelisme pakar, pengekodan spekulatif, serta pemisahan prefill/decode.
bash
SGLANG_ENABLE_MOE_DEFERRED_FINALIZE=1 \
SGLANG_FLASHINFER_MNNVL_CUTEDSL_AR_FUSION=1 \
sglang serve \
  --trust-remote-code \
  --model-path RadixArk/Qwen3.8-2.4T-A95B-NVFP4 \
  --tp-size 8 \
  --context-length 200000 \
  --preferred-sampling-params '{"top_k": 20}' \
  --attention-backend trtllm_mha \
  --linear-attn-prefill-backend flashinfer \
  --linear-attn-decode-backend flashinfer \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --host 0.0.0.0 \
  --port 30000
SGLang melaporkan 346 token output/s pada saiz kelompok 1 di TP8 B300 dengan MTP, dan throughput agregat yang jauh lebih tinggi dalam susun atur penyajian terpisah. Anggap angka tersebut sebagai ukuran timbunan penyajian, bukan penanda aras kualiti model.
Uji Endpoint Serasi OpenAI Setempat
Kedua-dua vLLM dan SGLang mendedahkan API serasi OpenAI, yang menjadikan integrasi aplikasi mudah.
python
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600,
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-2.4T-A95B-FP8",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant Redis architecture for three regions."
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=8192,
)

print(response.choices[0].message.content)
Kad model rasmi mengesyorkan temperature=1.0, top_p=0.95, dan top_k=20 sebagai parameter sampling garis dasar. Untuk kerja agen, tinggalkan belanjawan output yang mencukupi untuk penaakulan dan bukannya menetapkan max_tokens hanya untuk jawapan akhir yang kelihatan.
Dayakan Tetingkap Konteks 1M
Checkpoint terbuka Qwen3.8-2.4T-A95B mempunyai konteks asli 262,144 token dan boleh diperluas ke kira-kira 1.01M. Resepi vLLM mendokumenkan corak berikut:
bash
VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 \
vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --max-model-len 1010000 \
  --hf-overrides '{"max_position_embeddings": 1010000}' \
  --reasoning-parser qwen3 \
  ...
Jangan jadikan 1M sebagai lalai hanya kerana ia disokong. Konteks maksimum yang lebih besar menempah lebih banyak kapasiti cache dan boleh mengurangkan kebersamaan dengan ketara. Tetapkan --max-model-len kepada beban kerja sebenar.
Bagaimana Mempertingkat Prestasi Inferens Qwen3.8?
Guna MTP-3 untuk Mengurangkan Kependaman Pengguna Tunggal
Qwen3.8 menyertakan Multi-Token Prediction. Dalam ukuran terbitan vLLM, MTP-3 memindahkan output per pengguna daripada 130 ke 307 tok/s untuk FP8 TP16 dan daripada 133 ke 304 tok/s untuk NVFP4 TP8.
bash
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
Guna fastsafetensors untuk Permulaan Lebih Pantas
Untuk model berskala terabait, masa permulaan penting. Dalam satu ukuran vLLM, pemuatan berat jatuh daripada 545 s kepada 306 s dengan fastsafetensors dan pemuatan malas.
bash
--load-format fastsafetensors \
--safetensors-load-strategy lazy
Guna Paralelisme Pakar untuk Meningkatkan Throughput Serentak
Untuk kebersamaan tinggi, Qwen3.8 mendapat manfaat daripada susun atur paralel pakar kerana ia mempunyai 512 pakar dirutek. vLLM melaporkan sehingga 3,200 jumlah tok/s/GPU untuk FP8 EP dan sehingga 4,300 jumlah tok/s/GPU untuk konfigurasi NVFP4 DEP16 yang dioptimumkan.
Tetapkan --max-model-len untuk Mengimbangi VRAM dan Kebersamaan
Tetapkan --max-model-len kepada jujukan terpanjang yang benar-benar diperlukan oleh beban kerja. Nilai yang lebih besar menempah lebih banyak kapasiti KV-cache, meningkatkan tekanan memori, dan boleh mengurangkan bilangan permintaan serentak walaupun berat model sudah muat.
Mulakan dengan persentil produksi yang mewakili bukannya konteks maksimum yang diiklankan model. Uji beban had yang dipilih dengan ketepatan, corak kelompok, dan enjin penyajian yang sama digunakan dalam produksi, kemudian naikkan hanya apabila permintaan sebenar memerlukan lebih konteks.
Penyebaran Setempat Qwen 3.8 Max vs. API
Berat terbuka tidak secara automatik menjadikan inferens setempat ekonomik. Keputusan yang betul bergantung pada penggunaan, residensi data, kakitangan, sasaran ketersediaan, dan sama ada anda benar-benar memerlukan ciri multimodal model terurus.
| Dimensi | Qwen3.8-2.4T-A95B dihos sendiri | Qwen3.8-Max melalui CometAPI |
|---|---|---|
| Infrastruktur | Pelayan atau kluster berbilang GPU | Tiada infrastruktur GPU |
| Modality input | Teks | Teks, imej, video |
| Konteks | 262K asli; ~1.01M diperluas | 1M terurus |
| Kawalan data | Maksimum | API awan |
| Operasi | Anda memiliki pemantauan, naik taraf, dan HA | Diurus penyedia |
| Padanan terbaik | Residensi data, penggunaan berterusan, pasukan infra | Kebanyakan pasukan aplikasi dan beban berubah |
Jika anda sudah memiliki pemecut yang sesuai dan mempunyai penggunaan yang konsisten tinggi, pengehosan sendiri boleh dibenarkan. Jika anda akan membeli kluster hanya untuk model ini, Qwen3.8-Max di CometAPI biasanya laluan geseran lebih rendah. Panduan API sedia ada meliputi integrasi hos, manakala panduan harga meliputi pemodelan kos; oleh itu artikel ini kekal tertumpu pada penyebaran setempat.
Masalah Biasa Penyebaran Setempat Qwen 3.8
Pelayan Kehabisan Memori GPU Semasa Permulaan
Kurangkan dahulu --max-model-len jika cache ialah isu. Jika berat itu sendiri tidak muat, pengurangan konteks tidak akan menyelesaikan punca; beralih kepada checkpoint berketepatan lebih rendah yang disahkan atau tambah GPU.
Paralelisme Tensor Gagal dengan Saiz Tidak Sah
Qwen3.8 mempunyai 64 kepala perhatian dalam lapisan perhatian penuhnya, jadi vLLM memerlukan TP membahagi 64. Saiz TP yang mudah ialah 1, 2, 4, 8, 16, dan 32. Jumlah VRAM agregat semata-mata tidak mencukupi untuk memilih topologi.
Pelayan Mengambil Masa Lama untuk Mula
Memuatkan satu hingga beberapa terabait berat ditambah JIT kernel boleh mengambil masa beberapa minit. Tingkatkan VLLM_ENGINE_READY_TIMEOUT_S dan prob endpoint inferens sebenar dan bukan menganggap tetingkap permulaan yang singkat.
Model Setempat Tidak Dapat Memproses Imej
Itu dijangka. Checkpoint terbuka 2.4T ialah teks sahaja
Checkpoint terbuka Qwen3.8-2.4T-A95B ialah teks sahaja. Had ini khusus untuk Qwen3.8-2.4T-A95B. Qwen3.8-27B menyokong input visual apabila fail unjuran visi berasingan dimuatkan.
Konteks 1M Mengurangkan Throughput secara Dramatik
Kurangkan --max-model-len kepada jujukan terpanjang yang benar-benar diperlukan oleh beban kerja anda. Tetingkap konteks terbesar yang disokong bukan semestinya tetapan produksi terbaik; pilih had konteks yang mengimbangkan keperluan beban kerja, penggunaan KV-cache, dan kebersamaan.
Bolehkah Ollama atau LM Studio Menjalankan Qwen 3.8 Max?
Ekosistem boleh membungkus berat Qwen3.8 yang dikuantis secara berat untuk inferens gaya llama.cpp, tetapi itu tidak harus dikelirukan dengan aliran kerja Ollama desktop biasa. Binaan dikuantis yang memakan ratusan gigabait masih memerlukan ratusan gigabait memori boleh akses dan melibatkan kompromi ketara dalam kualiti dan prestasi.
Untuk pembangunan setempat biasa, Qwen3.8-27B ialah sasaran yang sesuai. Model penuh 2.4T harus dianggap sebagai model pelayan/kluster walaupun apabila kuantis komuniti ekstrem menjadikannya boleh but secara teknikal pada perkakasan luar biasa.
Kaedah Penyebaran Mana yang Harus Anda Pilih?
Untuk NVIDIA Blackwell, penyebaran 8× B300 NVFP4 kini merupakan titik permulaan model penuh paling bersih. Untuk AMD, 8× MI355X dengan MXFP4 ialah konfigurasi praktikal yang sepadan. Gunakan FP8 apabila anda mengutamakan provenance checkpoint dan kualiti berbanding saiz infrastruktur, dan BF16 hanya apabila fideliti maksimum membenarkan keperluan memori skala berbilang rak.
Untuk stesen kerja, gunakan Qwen3.8-27B. Untuk pasukan aplikasi yang memerlukan keupayaan Max tanpa operasi kluster GPU, gunakan model Qwen3.8-Max yang dihoskan di CometAPI.
Kesimpulan
Qwen3.8-Max telah menyeberangi sempadan penting sejak pelancaran API awalnya: keluarga Qwen kelas Max kini mempunyai checkpoint 2.4T terbuka yang boleh dikendalikan sepenuhnya oleh organisasi pada infrastruktur mereka sendiri.
Tetapi berat terbuka tidak bermaksud perkakasan pengguna. Jejak BF16 4.45 TiB, checkpoint FP8 2.27 TiB, dan varian FP4 1.3–1.5 TiB menjadikan Qwen3.8-2.4T-A95B antara model terbuka paling intensif infrastruktur yang tersedia. Kelebihan praktikalnya ialah vLLM dan SGLang sudah menyokong seni bina tersebut, dan FP4 menjadikan penyebaran satu nod 8× B300 atau 8× MI355X boleh dilaksanakan.
Hos sendiri apabila kawalan data, penggunaan berterusan, dan pemilikan infrastruktur membenarkan kluster. Jika tidak, gunakan API Max terurus—atau Qwen3.8-27B apabila apa yang anda benar-benar mahukan ialah model Qwen yang mantap pada satu stesen kerja.