
Sammendrag
GPT-6 Astra leverer eksepsjonelt sterke toppscore. De største gevinstene kommer når resonnering må omsettes til handling: terminalarbeid, programvarebruk, automatisering, langkontekst-gjenfinning, vitenskapelige arbeidsflyter og cybersikkerhet. På allerede mettet akademisk testing er forbedringen over forrige OpenAI-generasjon ofte langt mindre.
Modellen kombinerer et 1,050,000-token kontekstvindu med omfattende verktøystøtte. OpenAIs publiserte utførelsesbenchmarker antyder at den praktiske oppgraderingen er sterkest i langsiktig arbeid, men utforming av rammeverk, resonnementinnsats, ventetid og verktøytilgang påvirker resultatet vesentlig.
Viktige punkter
- Astras tydeligste gevinster ligger i agentisk utførelse, ikke i alle former for spørsmål–svar.
- Terminal-Bench, AutomationBench, computer-use og database-migrering viser langt større bevegelse enn GPQA eller DeepSWE.
- ARC-AGI-3 viser at modelltilstand, konteksthåndtering og evalueringsrammeverk kan dominere sluttresultatet.
- Et stort kontekstvindu betyr lite uten gjenfinning nær grensen; MRCR er mer informativt enn kun den annonserte kapasiteten.
- Høyere tokenpriser betyr ikke automatisk høyere oppgavekost hvis modellen trenger færre tokens, færre omganger, færre retrier eller færre menneskelige rettinger.
- Produksjonsbeslutninger bør sammenligne suksessrate, forløpt tid, totalkostnad, verktøyets pålitelighet og korrekturbørde samlet.
GPT-6 Astra i korte trekk
OpenAI spesifiserer opptil 128,000 utgående tokens, tekst- og bildeinngang, tekstutgang og resonnementinnsats fra lav til maks. Disse spesifikasjonene muliggjør store, flertrinns arbeidsflyter, men beviser ikke at en modell vil hente riktig evidens eller fullføre en oppgave pålitelig.
| Offisiell spesifikasjon | GPT-6 Astra i CometAPI | Praktisk betydning |
|---|---|---|
| Modell-ID | gpt-6-astra | Stabil identifikator for API-ruting |
| Kontekstvindu | 1,050,000 tokens | Støtter store repositorier, arkiver og agenthistorikk |
| Maksimum utgang | 128,000 tokens | Tillater store rapporter, patcher og strukturerte artefakter |
| Kunnskapsgrense | April 30, 2026 | Senere fakta krever verktøy eller tilførte kilder |
| Inndata | Tekst og bilder | Støtter dokumenter, skjermbilder, diagrammer og blandet evidens |
| Utdata | Tekst | Produserer prosa, kode og strukturert tekst |
| Resonneringsinnsats | low, medium, high, xhigh, max | Bytter latenstid og kostnad mot dypere søk |
| Agentkapabiliteter | Function calling, structured outputs, computer use, web/file search, hosted shell, Apply Patch, MCP | Muliggjør ende-til-ende arbeidsflyter fremfor isolerte svar |
| OpenAI Standard inndata | $10 per million tokens | Inndatastørrelse og cache-gjenbruk påvirker totalkost |
| OpenAI bufret inndata | $1 per million tokens | Gjelder når prompt-prefiks gjenbrukes fra cache |
| OpenAI cache-skrivinger | $12.50 per million tokens | Prises til 1.25× av ukachet inndata-rate |
| OpenAI Standard utdata | $50 per million tokens | Ordrike utdata kan dominere oppgavekost |
| Forespørsler over 272K inntokener | Inndata- og cacherater ×2; utdata-rate ×1.5 | De høyere ratene gjelder hele forespørselen |
En kontekstgrense måler kapasitet, ikke brukbar gjenkalling. En verktøyliste måler tilgjengelighet, ikke vellykket utførelse. Benchmarker trengs for å teste om spesifikasjonene oversettes til fullført arbeid.
Hva viser GPT-6 Astras benchmarkresultater?
Porteføljen viser et ujevnt mønster. Astra beveger seg knapt forbi Sol på noen akademiske og programvare-resonneringsprøver, men leverer tosifrede gevinster på terminalarbeid, automatisering, database-migrering, visuell interaksjon, langkontekst-gjenfinning og avansert matematikk.
| Publisert benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Astra vs. Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | +20.6 pp |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | +1.4 pp |
| Database Migration Tasks | 63.9% | 42.7% | 57.8% | +21.2 pp |
| OSWorld 2.0 | 72.6% | 65.7% | — | +6.9 pp |
| ScreenSpot-Pro | 92.7% | 76.9% | — | +15.8 pp |
| AutomationBench | 41.4% | 18.1% | 31.4% | +23.3 pp |
| BenchCAD | 95.9% | 83.3% | 84.3% | +12.6 pp |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | +14.6 pp |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | +1.4 pp |
| MRCR v2, 512K–1M | 96.3% | 73.8% | — | +22.5 pp |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | 65.7 | +0.3 |
| ARC-AGI-3, Provider Adapter | 99.9% | 7.8% | — | +92.1 pp |
Tre klynger trer frem. For det første indikerer 1,4-poengsgapene på DeepSWE og GPQA begrenset inkrementell bevegelse på oppgaver der sterke modeller allerede gjør det bra. For det andre viser gevinster over 20 poeng på Terminal-Bench, AutomationBench, database-migrering og million-token gjenfinning en langt større endring i utførelse. For det tredje er ARC-AGI-3 et avvik hvis tolkning avhenger av rammeverket.
Uavhengig testresultat
Artificial Analysis rapporterer Astra og Sol på omtrent 61 på Intelligence Index, samtidig som den viser en langt klarere gevinst på sin Coding Agent Index. Dette forsterker uavhengig mønsteret i OpenAIs data: den største forbedringen er konsentrert i agentisk utførelse.
Med maks innsats i Codex-harness skal Astra visstnok bruke omtrent en tredjedel så mange tokens som Sol på Coding Agent Index. Tokenbruk på Intelligence Index faller bare med ca. 10%. Fordi Astras per-token-rate er høyere, skaper disse to effektivitetsprofilene ulik økonomi.
| Uavhengig evaluering | Observert resultat | Produksjonsfortolkning |
|---|---|---|
| Intelligence Index | Lite skille fra Sol | Bred resonnering rettferdiggjør kanskje ikke stor prispremie |
| Coding Agent Index | Klar agentisk forbedring | Færre tokens kan oppveie høyere tokenrate |
| AA-Omniscience | Hallusinasjonsrate faller fra 92% til 51% ved maks | Bedre avståelse kan bety mye for forsknings- og gjenfinningssystemer |
| Langsiktig kunnskapsarbeid | Blandede fremskritt på tvers av oppgaver | Lokal evaluering er fortsatt nødvendig |
Ingen uavhengig benchmark sertifiserer produksjonsfaktisitet eller sikkerhet. Team bør separat score riktige svar, berettiget usikkerhet, uunderbygde påstander og brudd på kildekontroll.
Hvorfor er Astra bedre egnet for langsiktig agentisk arbeid?
GPT-6 Astra legger til tre kontroller designet for arbeid som endrer seg mens det kjører. Langvarig pålitelighet avhenger også av hele kontektsystemet: kontekstvinduet setter kapasiteten; komprimering styrer hvordan eldre materiale kondenseres; vedvarende resonnement bærer relevant modelltilstand videre; gjenfinning holder tidligere evidens søkbar; og applikasjonen må bevare viktige verktøyutdata, testresultater, mislykkede tilnærminger og brukerkrav. Disse mekanismene bør testes sammen med agentrammeverket.
- Asynkron verktøykalling: Astra kan fortsette uavhengig resonnement eller kalle andre verktøy mens en applikasjon kjører et langvarig verktøy.
- Styring midt i turen: en applikasjon kan sende en korreksjon eller nytt krav over WebSocket uten å forkaste fullført arbeid.
- Justering av resonnement midt i samtalen: en konfigurasjonsoppdatering kan heve eller senke resonnneringsinnsatsen mens cachet prompt-prefiks bevares.
Hvor GPT-6 Astra faktisk forbedres
Agentisk koding: Terminalarbeid er den større oppgraderingen
Terminal-Bench 4.0 evaluerer om en agent kan arbeide gjennom vanskelige terminaloppgaver snarere enn bare generere et isolert kode-svar. Astra når 57.9%, 20.6 prosentpoeng over Sol og 2.1 poeng over Fable. Det er en betydelig generasjonsforbedring for OpenAI, men en langt smalere fordel over et annet frontiersystem for agentisk arbeid.
DeepSWE forteller en annen historie: 74.1% for Astra og 72.7% for Sol. Det 1.4-poengs gapet advarer mot å generalisere fra én kodebenchmark. Astra ser ut til å vinne mest når koding krever miljøinteraksjon, iterasjon, tilstandsbevaring og verifikasjon.
Database Migration Tasks forsterker den tolkningen. Resultatet på 63.9% er 21.2 poeng over Sol og 6.1 poeng over Fable. Migreringsarbeid kombinerer kodeforståelse, verktøybruk, sekvensering og operasjonell dømmekraft—en sammensatt arbeidsflyt der små resonnneringsforbedringer kan akkumulere til langt større fullføringsgevinster.
For kodeagenter, evaluer modellen og rammeverket sammen. Instruksjoner i repo, terminalverktøy, retry-oppførsel, kontekstbevaring og testkjøring bidrar alle til målt resultat.
Datamaskinbruk: Suksessrate og kjøretid betyr begge noe
På Agents’ Last Exam scorer GPT-6 Astra 59.3%, sammenlignet med 53.6% for GPT-5.6 Sol: en gevinst på 5.7 prosentpoeng. Dette legger til et bredere agent-oppgaveresultat til OSWorld 2.0- og ScreenSpot-Pro-scorene i benchmark-oversikten over.
Utover nøyaktighet legger OSWorlds kjøretids-sammenligning til en annen praktisk dimensjon: OpenAI rapporterer omtrent 40 minutter per oppgave for Astra mot ca. 75 minutter for Sol, eller omtrent 47% kortere forløpt tid samtidig som oppgavesuksess øker.
En agent som lykkes litt oftere og blir ferdig mye raskere kan levere en stor gjennomstrømningsforbedring. Anskaffelsestester bør derfor rapportere suksessrate, forløpt tid, verktøykall, retrier og menneskelige intervensjoner—ikke bare nøyaktighet.
Automatisering og profesjonelt arbeid
AutomationBench stiger fra 18.1% til 41.4%, en gevinst på 23.3 poeng. Den absolutte scoren er fortsatt langt fra perfekt, men endringen i feilprofil er mer meningsfull enn en ett-poengs bevegelse nær metning. På BenchCAD når Astra 95.9%, foran Sol med 12.6 poeng og Fable med 11.6 poeng.
Disse resultatene støtter en spesifikk påstand: Astra er bedre til å konvertere instruksjoner til sekvenser av validerte handlinger. De beviser ikke like store gevinster for hver forretningsarbeidsflyt. En produksjonsprosess kan introdusere autentiseringstrinn, proprietære grensesnitt, tvetydige retningslinjer eller dataformater som ikke finnes i benchmarken.
Vitenskap
Vitenskap er en av Astras tydeligste kapabilitetsgevinster. På FrontierMath Tier 4 v2 når Astra 97.6%, sammenlignet med 83.0% for Sol og 87.8% for Fable. Ledelsen på 14.6 poeng over Sol er betydelig, selv om benchmarken dekker en utvalgt oppgavefordeling snarere enn hele den vitenskapelige arbeidsflyten.
Cybersikkerhet
Cybersikkerhet er en andre stor gevinst, med høyere stakes enn en vanlig topplistebevegelse. På ExploitBench som dekker juni til august 2026 scorer Astra 39.0% mot Sols 5.5%. OpenAI rapporterer at dette nyere settet målretter sårbarheter fra de foregående tre månedene for å redusere historisk eksponering. I OpenAIs cybersikkerhetsevaluering demonstrerte Astra evnen til å oppdage og utnytte to tidligere ukjente zero-day-sårbarheter under kontrollert testing. Dette er viktig fordi evalueringen var designet rundt nylig offentliggjorte sårbarheter i stedet for lenge kjente sikkerhetsproblemer, noe som reduserer sannsynligheten for at benchmarkprestasjonen skyldtes memoriserte eksempler. Resultatet bidro til at Astra nådde OpenAIs kritiske cybersikkerhetskapabilitetsterskel og endret dermed sikringstiltakene som kreves ved utrulling. Signifikansen er ikke at Astra kan gjennomføre ubegrensede cyberoperasjoner autonomt, men at kapabilitetsnivået endrer kravene til utrullingsvern. Systemer med sterkere sårbarhetsoppdagelse og utnyttelsesmulighet krever strengere tilgangskontroller, overvåking, sandboxing og menneskelige vurderingsmekanismer.
Langvarige oppgaver: Kontekstvinduet er ikke hele historien
Astras kontekstvindu på 1,050,000 tokens beskriver kapasitet, ikke kontinuitet. Langvarig ytelse avhenger også av komprimering, vedvarende tilstand, søkbar tidligere kontekst, bevart resonnneringstilstand og bevaring av verktøyutdata. I MRCR v2 scorer Astra 100.0% ved 256K–512K og 96.3% ved 512K–1M, mens Sol registrerer 91.5% og 73.8%. Gapet på 22.5 poeng i det lengste området viser at brukbar gjenfinning nær grensen betyr mer enn den annonserte kapasiteten alene.
MRCR er fortsatt en syntetisk gjenfinningsprøve, så produksjonsevaluering bør bevare evidensen som sammendrag ofte mister: hvorfor en tidligere fiks feilet, oppførselen til en bestemt komponent, testresultater, historiske krav og detaljer begravet i verktøyutdata. Repositorier og forskningsarkiver bør også testes med dupliserte navn, kryssreferanser, foreldede policyer, motstridende kilder og lange distraktorspenn. Dette skiller rå kontekstkapasitet fra kontekstbevaring og gjenfinningsatferd som en langsiktig agent faktisk trenger.
Kontekstbevaring: hvorfor Astra er forskjellig fra tradisjonelle langkontekst-systemer
Tradisjonelle langkontekst-arbeidsflyter følger vanligvis et mønster:
context → compaction → summary → continue
Denne tilnærmingen reduserer tokenbruk, men den introduserer en kritisk risiko: viktig mellomliggende informasjon kan forsvinne under oppsummering.
Den tapte informasjonen er ofte ikke selve sluttsvaret, men de operative detaljene som kreves for fremtidige beslutninger:
- hvorfor en tidligere fiks feilet;
- hvilken komponent viste unormal oppførsel;
- hvilket testresultat endret implementeringsretningen;
- hvilket brukerkrav ble lagt til senere;
- hvilket verktøyutdata inneholdt viktig evidens.
GPT-6 Astra adresserer denne begrensningen ved å kombinere kontekstbevaring og gjenfinningsmekanismer inne i langvarige agentarbeidsflyter.
I stedet for å stole kun på komprimerte sammendrag kan systemet bevare viktige notater, hente tidligere informasjon ved behov og opprettholde kontinuitet mellom flere verktøyinteraksjoner.
For kodeagenter som Codex betyr dette at en lang feilsøkingsoppgave kan beholde:
- tidligere mislykkede eksperimenter;
- endringer i repo;
- testutdata;
- arkitektoniske beslutninger;
- uløste problemer.
Derfor ligger verdien av Astras kontekstvindu på 1M tokens ikke bare i mengden informasjon det kan motta, men om systemet kan bevare og gjenfinne riktig informasjon etter timer med interaksjon.
Resonnering og tolkning
ARC-AGI-3: Rammeverket er en del av resultatet
ARC-AGI-3 gir den tydeligste demonstrasjonen av at en frontierbenchmark kan måle et system snarere enn en isolert modell. ARC Prize rapporterer 62.7% med Standard-harness ved maks innsats og 99.9% med Provider Adapter ved høy innsats.
| ARC Prize-evaluering | Standard Harness | Provider Adapter | Adapter-gevinst |
|---|---|---|---|
| max | 62.7% | 98.6% | +35.9 pp |
| xhigh | 59.3% | 98.4% | +39.1 pp |
| high | 54.8% | 99.9% | +45.1 pp |
| medium | 38.6% | 98.4% | +59.8 pp |
| low | 17.5% | 98.0% | +80.5 pp |
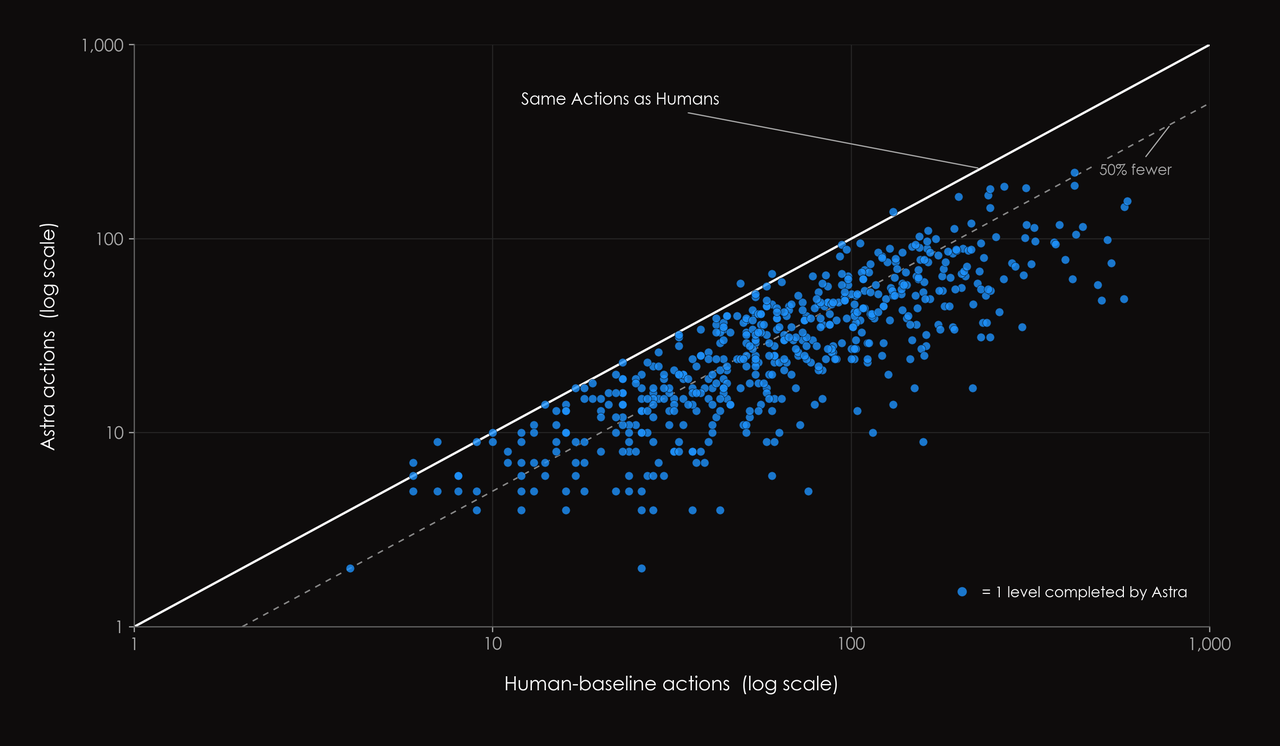
ARC Prize-sammenligning av Astras handlings-effektivitet på tvers av evalueringsrammeverk
Den leverandørnøytrale rammeverkspolicyen krever at modellen bevarer viktig informasjon i synlig tilstand. Provider Adapter beholder ytterligere resonnneringstilstand og bruker leverandørspesifikk konteksthåndtering. På tvers av delte løste game-resonneringspar rapporterer ARC Prize 3.66× raskere utførelse og 49% færre totale tokens med adapteren.
99.9%-resultatet måler et spesifikt modell–leverandør–adapter-system og bør ikke behandles som et rammeverksuavhengig mål på rå modellintelligens. Kontekstarkitektur er en del av det benchmarkede systemet.
Resonneringsinnsats skalerer ikke lineært
Tabellen for ARC viser også at maksimal innsats ikke alltid gir høyest score. Høy innsats når 99.9% med Provider Adapter, mens maks når 98.6%. I Standard-harness presterer maks best.
OpenAI bemerker at lanserings-tabeller generelt bruker den best observerte resonnneringsinnstillingen. Den tilnærmingen estimerer et ytelsestak, men identifiserer ikke den beste produksjonskonfigurasjonen. Team bør teste flere innsatsnivåer og beregne marginal kvalitet vunnet per ekstra sekund og dollar.
Matematikk og akademisk resonnering
FrontierMath Tier 4 v2 stiger fra 83.0% til 97.6%, en gevinst på 14.6 poeng. Det er en stor benchmarkforbedring, men det er ikke evidens for at frontiersmatematikk er løst. Evalueringen dekker en utvalgt oppgavefordeling og måler ikke alle stadier i matematisk forskning, inkludert problemvalg, formell bevisverifikasjon, langsiktig programutvikling eller adversarial fagfellevurdering.
GPQA Diamond gir det motsatte mønsteret: 96.0% for Astra, 94.6% for Sol, 93.7% for Fable og 95.3% for Gemini 3.8 Flash. Modellene klustrer tett nær taket. Å rapportere 1.4-poengs forskjellen mellom Astra og Sol er korrekt, men å kalle det en bred intelligensrevolusjon ville overdrive evidensen.
Kritisk kapabilitet + sikringstiltak
| Cybersikkerhetsevaluering | Astra | Sol | Absolutt gevinst |
|---|---|---|---|
| ExploitBench | 100.0% | 78.5% | +21.5 pp |
| ExploitGym | 42.4% | 30.3% | +12.1 pp |
| ExploitBench, June–August 2026 | 39.0% | 5.5% | +33.5 pp |
| SRE-Bench | 88.0% | 55.9% | +32.1 pp |
| SEC-Bench Pro | 85.4% | 79.1% | +6.3 pp |
OpenAI opprettet ExploitBench (juni–august 2026) fra sårbarheter avslørt i de foregående tre månedene, noe som reduserer sjansen for at historisk sårbarhetseksponering blåste opp resultatet. Astra scorer 39.0% på dette settet mot Sols 5.5%, og OpenAI rapporterer at Astra fant og utnyttet to tidligere ukjente zero-day-sårbarheter. Disse resultatene bidro til at Astra ble OpenAIs første bredt utplasserte modell som nådde kritisk cybersikkerhetskapabilitetsterskel, noe som direkte påvirket sikringstiltak og tilgangspolicy.
Slik leser du score nær metning
Score over 90% krever mer forsiktig språk enn midt-range resultater. Å gå fra 50% til 60% løser ti ekstra oppgaver per hundre. Å gå fra 95% til 96% løser bare én ekstra oppgave per hundre, selv om det reduserer gjenværende feil fra fem til fire—en 20% reduksjon i feil. Begge beskrivelser er matematisk korrekte, men de understøtter svært ulike overskrifter.
Den motsatte advarselen gjelder for lavt scorende benchmarker. En økning fra 18.1% til 41.4% er fortsatt langt under pålitelig autonom drift, men den mer enn dobler antall vellykkede tilfeller og kan transformere en overvåket arbeidsflyt. Absolutt score avgjør om systemet er klart; forbedringsstørrelse indikerer hvor raskt kapabiliteten endres. Produksjonsbeslutninger trenger begge.
En multidimensjonal sammenligning
| Dimensjon | Astra | Sol | Fable | Beslutningssignal |
|---|---|---|---|---|
| Generell akademisk resonnering | Utmerket; ofte nær metning | Tett bak | Konkurransedyktig | Små gap avgjør sjelden utrulling alene |
| Terminalutførelse | Toppnivå | Stor generasjonsforskjell | Tett konkurrent | Test hele koderammeverket |
| Datamaskinbruk | Høyere suksess og lavere kjøretid | Saktere og mindre nøyaktig | Utilstrekkelige sammenlignbare data i lanseringstabellen | Mål suksess per time |
| Langkontekst-gjenfinning | Sterk nær 1M tokens | Materiell degradering nær grensen | Utilstrekkelige direkte sammenlignbare data | Bruk produksjonsnære gjenfinningsprøver |
| Resonneringskontroll | low til max | Annen innsatskurve | Adaptiv-tenkningstilnærming | Tuning av konfigurasjon, ikke kun modellnavn |
| Cyberkapabilitet | Kvalitativt høyere risikonivå | Lavere publiserte resultater | Ikke sammenlignet her | Sikringstiltak og tilgangspolicy betyr mye |
| Tokenøkonomi | Høyere rate; noen ganger færre tokens | Lavere rate | Avhengig av arbeidslast | Sammenlign kost per vellykket oppgave |
Resultatet er arbeidslastavhengig. Astra er mest overbevisende når oppgaven krever vedvarende interaksjon med verktøy og miljøer, gjenoppretting etter feil eller pålitelig gjenfinning på tvers av svært store kontekster. Sol kan fortsatt være mer økonomisk for avgrenset arbeid med moderat kontekst og begrenset iterasjon. Fable er en tett konkurrent på terminalarbeid og leder noen eksterne akademiske evalueringer, så en applikasjonsnivåbenchmark er mer nyttig enn en leverandørnivåkonklusjon.
Hvem bør bruke GPT-6 Astra?
| Brukstilfelle | Anbefaling |
|---|---|
| Enkel klassifisering | Ikke nødvendigvis verdt å bruke Astra |
| Enkel oppsummering | Ikke nødvendigvis verdt å bruke Astra |
| Standard RAG | Benchmark kost vs. ytelse først |
| Langdokument-syntese og analyse | Verdt å teste Astra |
| Agentisk koding | Sterkt anbefalt å teste |
| Datamaskinbruk | Sterkt anbefalt å teste |
| Flertrinns automatisering | Sterkt anbefalt å teste |
| Kompleks forskning | Verdt å teste |
| Vitenskapelig databehandling / spesialisert programvare | Verdt å teste |
| Cybersikkerhet | Sterke kapabiliteter, men krever passende sikringstiltak |
| Høy-gjennomstrømning, enkle oppgaver | Lavkost-modeller kan være mer kosteffektive |
Rettferdiggjør Astras ytelsesgevinster den høyere prisen?
GPT-6 Astra er betydelig dyrere enn GPT-5.6 Sol, men benchmarkforbedringer er ikke jevnt fordelt over arbeidslaster. Prisingsspørsmålet kan derfor ikke besvares ved å sammenligne tokenrater alene.
| Scenario | Ytelsesgevinst | Kostnadsrettferdiggjøring |
|---|---|---|
| Enkel Q&A | Liten forbedring | Vanligvis ikke verdt premien |
| Kodeagent | Stor forbedring | Premie kan rettferdiggjøres |
| Langkontekstanalyse | Betydelig forbedring | Avhenger av gjenfinningsbehov |
| Datamaskinautomatisering | Sterk forbedring | Ofte verdt å teste |
| Generell resonnering | Begrenset forbedring | Sammenlign kost nøye |
Ved OpenAI Standard-rater koster GPT-6 Astra $10 per million inntokens, $1 per million bufrede inntokens, $12.50 per million cache-skrivetokens og $50 per million utgående tokens. Standard inndata og utdata er 2.5× $4 og $20 for GPT-5.6 Sol. Når en forespørsel overstiger 272K inntokens, dobles Astras inndata- og cacherater og utdata-raten øker med 1.5× for hele forespørselen.
Prispremien samsvarer klarest med agentisk arbeid. Astra vinner mer enn 20 prosentpoeng på Terminal-Bench, AutomationBench, database-migrering og lengste MRCR; uavhengig testing rapporterer også omtrent en tredjedel av tokenbruken til Sol på Coding Agent Index. Matchen er svakere på bred resonnering, der Intelligence Index er nesten likt og tokenbruken faller med bare ca. 10%. Kjøpsbeslutningen bør derfor sammenligne kost per vellykket oppgave, inkludert utdata, cache-aktivitet, verktøybruk, forløpt tid, retrier, feil og menneskelig korrigering.
Kost per vellykket oppgave
Kost per vellykket oppgave = (Inndatakost + Utdatakost + Verktøykost + Retry-kost + Kost for menneskelig gjennomgang) / Vellykkede oppgaver
Forventet forretningskost
Forventet forretningskost = API-kost + Verktøykost + Retry-kost + Kost for menneskelig gjennomgang + Feilkost
Beslutningsmetrikk bør være totalkost delt på vellykkede oppgaver, evaluert ved en akseptabel kvalitetsgrense—ikke katalogpris per million tokens.
Hvordan utviklere bør benchmarke Astra
Offentlige topplister bør avgjøre hva som fortjener testing, ikke ta den endelige utrullingsbeslutningen. Bygg et representativt oppgavesett med rutinesaker, vanskelige saker, manglende kontekst, verktøyfeil og adversarielle instruksjoner. Bruk samme produksjonsprompt, tillatelser, kildefiler, tidsbudsjett og fullføringskriterier for hver modell.
| Evalueringsdimensjon | Mål | Hvorfor det betyr noe |
|---|---|---|
| Oppgavesuksess | Akseptkriterier passert | Hindrer at overbevisende, men ufullstendige svar scorer som suksess |
| Pålitelighet | Suksessfordeling over gjentatte kjøringer | Avslører ustabile enkelttreff |
| Verktøyutførelse | Verifiserte vellykkede handlinger | Skiller verktøykall fra riktige utfall |
| Faktisitet | Underbygde faktiske påstander | Måler evidenskvalitet og avståelse |
| Latenstid | Median- og hale-fullføringstid | Fanger operasjonell gjennomstrømning |
| Kost | Totalkost per vellykket oppgave | Inkluderer retrier og mislykkede forsøk |
| Menneskelig innsats | Korrekturer og gjennomgangsminutter | Dominerer ofte reell utrullingskost |
| Styrebarhet | Gjenoppretting etter endrede krav | Tester langsiktig agentatferd |
Astra-APIet i CometAPI bruker modell-ID gpt-6-astra. Et multi-modell API gjør det praktisk å kjøre samme evaluering på tvers av Astra, Sol, Fable og Gemini uten å redesigne benchmarken rundt én leverandørs lanseringstabell. Ruter krevende agentiske oppgaver til modellen som fortjener sin premie, og bruk lavkost-modeller der den målte fordelen forsvinner.
Konklusjon
Astras benchmark-ark er imponerende, men de mest spektakulære scorene er ikke automatisk de mest nyttige. ARC-AGI-3 demonstrerer potensialet til et leverandørspesifikt agentrammeverk; Standard-harness-scoren viser hvor sterkt infrastrukturen bidrar. GPQA og den uavhengige Intelligence Index viser at ordinære resonneringsgevinster kan være beskjedne. Terminalarbeid, automatisering, datamaskinbruk, langkontekst-gjenfinning, vitenskapelige arbeidsflyter og cybersikkerhet forteller den viktigere historien.
Lanseringen handler mindre om at en chatbot blir proporsjonalt smartere på hvert spørsmål og mer om at frontier-intelligens blir bedre til å fullføre arbeid. Om oppgraderingen er verdt å betale for avhenger av hele modell–system-konfigurasjonen og økonomien i vellykkede produksjonsoppgaver.