
Kort fortalt
GPT-6 Astra API in CometAPI passer best til vanskelige, verktøyrike arbeidsflyter der kvalitet på ferdigstillelsen er viktigere enn laveste tokenpris. Modellen støtter et kontekstvindu på 1 050 000 token, 128 000 utgående token, bildeinput, strukturerte utdata, strømming, funksjonskalling og fem nivåer av resonnering. Start med Responses API, medium resonnering, et smalt sett med verktøy, og en evaluering som måler kostnad per akseptert oppgave. CometAPIs gjeldende grunnpriser per token er 20 % under tilsvarende OpenAI-priser.
Viktige punkter
- Astra er optimalisert for krevende ende-til-ende-arbeid, inkludert koding, datamaskinbruk, research og profesjonell automatisering.
- Bruk Responses API for nye, verktøydrevne integrasjoner.
- Velg lavest mulig resonneringsinnsats som består arbeidslast-evalueringen;
noneer ikke støttet. - Hold promptene under terskelen for lang kontekst på 272K når det er mulig, fordi den høyere satsen gjelder for hele forespørselen.
- Offentlige evalueringer viser høyere score og lavere estimert API-kost per oppgave i flere krevende arbeidslaster, men produksjonsruting bør baseres på din egen aksept-rate.
GPT-6 Astra API hurtigstart
- Opprett en CometAPI-nøkkel og lagre den i en miljøvariabel.
- Installer OpenAI-SDK-en.
- Send en forespørsel til Responses API med
model="gpt-6-astra". - Legg til en strikt output-kontrakt og valider resultatet.
- Koble bare til verktøyene som kreves av arbeidsflyten.
- Test integrasjonen på representative oppgaver før produksjon.
Hva er GPT-6 Astra API?
OpenAIs mest kapable modell for det vanskeligste ende-til-ende-arbeidet er designet for kompleks resonnering, koding, datamaskinbruk, research og dokumentopprettelse. I en API-applikasjon kommer Astras verdi av å bevare intensjon gjennom lange arbeidsflyter, kalle verktøy, tolke resultater og fortsette til applikasjonens fullføringskriterier er oppfylt.
GPT-6 Astra API-spesifikasjoner
| OpenAI-spesifikasjon | GPT-6 Astra |
|---|---|
| Modell-ID | gpt-6-astra |
| Kontekstvindu | 1,050,000 token |
| Maksimalt utdata | 128,000 token |
| Kunnskapsavgrensning | 30. april 2026 |
| Inndata og utdata | Tekst og bildeinn; tekstutdata |
| Resonneringsinnsats | low, medium, high, xhigh, max |
| Støttede funksjoner | Strømming, funksjonskalling, strukturerte utdata |
| Responses API-verktøy | Web search, file search, image generation, code interpreter, hosted shell, Apply Patch, computer use, MCP, and tool search |
| Finetuning | Ikke støttet |
Integrasjonsutfordringen er orkestrering: gi riktig kontekst, kjør forespurte verktøy, inspiser resultatene, og stopp når applikasjonens fullføringskriterier er oppfylt.
GPT-6 Astra API vs GPT-5.6 Sol: Hva er nytt?
OpenAIs gjeldende modellveiledning beskriver Astra som sterkere på vanskelige flertrinns arbeidsflyter og ofte med færre utgående token. Den legger også til kontroller som betyr mye for langvarige agenter: asynkrone verktøykall, styring midt i turen, endring av resonnering under en samtale og misalignment-overvåking.
| Dimensjon | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| Primærrolle | Det vanskeligste ende-til-ende-arbeidet | Komplekst profesjonelt arbeid til lavere tokenkost |
| Kontekst / maks utdata | 1,05M / 128K | 1,05M / 128K |
| Kunnskapsavgrensning | 30. april 2026 | 16. februar 2026 |
| Asynkrone verktøykall | Støttet | Bruk konvensjonell verktøy-resultat-koordinering |
| Styring midt i turen | Støttet via Responses WebSocket | Bruk en etterfølgende tur eller app-styrt omstart |
| Endre resonnering i samtale | configuration_update i kompatible flyter | Sett innsats på forespørselsnivå |
| none reasoning | Ikke støttet | Støttet |
| OpenAI Standard inn/ut | $10 / $50 per 1M | $4 / $20 per 1M |
| Beste rutingrolle | Eskalering for arbeid med høy kompleksitet | Standard for bredere kompleks trafikk |
Oppgraderingen er ikke en generell erstatning. Bruk Sol når den pålitelig består oppgaven; rut til Astra når verktøydybde, lang kontekst, retries eller menneskelig korreksjon gjør den billigere modellen dyrere i praksis.
Hvorfor bruke GPT-6 Astra via CometAPI?
GPT-6 Astra API i CometAPI bruker OpenAI-kompatibel /v1/responses-rute. Dets $8/M input og $40/M output kortkontekstrater er 20 % under tilsvarende OpenAI Standard-priser på $10/M og $50/M.
En eksisterende OpenAI SDK-integrasjon kan beholde klientbiblioteket mens nøkkel, base_url og modell-ID endres. Bruk samme gateway når du ruter passende arbeid til GPT-5.6 Sol.
Trinn 1: Få en CometAPI API-nøkkel
Opprett en nøkkel i CometAPI-dashboardet og lagre den utenfor kildekoden. Bruk en hemmelighetshåndterer i produksjon.
export COMETAPI_KEY="your_api_key"
$env:COMETAPI_KEY = "your_api_key"
Trinn 2: Installer OpenAI SDK
Installer gjeldende SDK for applikasjonsspråket ditt.
python -m pip install -U openai
npm install openai
Trinn 3: Gjør din første forespørsel
Bruk /v1/responses for nye integrasjoner, særlig når arbeidsflyten senere skal legge til verktøy eller strukturerte utdata.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=120.0,
    max_retries=2,
)

response = client.responses.create(
    model="gpt-6-astra",
    input="Give three practical ways to reduce API latency.",
    reasoning={"effort": "medium"},
)

if response.status != "completed":
    raise RuntimeError(f"Unexpected status: {response.status}")

print(response.output_text)
Trinn 4: Test før produksjon
Kjør representative oppgaver gjennom både kandidat- og fallback-rutene. Registrer aksept-rate, latens, retries, inn- og utgående token, verktøyfeil og tid for menneskelig korreksjon. Promoter Astra bare der resultatet forbedrer arbeidsflytens reelle fullføringsøkonomi.
Ikke behandl en vellykket demoprompt som produksjonsvalidering. Inkluder tvetydige input, verktøyfeil, manglende data og langvarige forespørsler i testsettet.
Slik velger du resonneringsinnsats
De støttede resonneringsnivåene er low, medium, high, xhigh og max. Bruk laveste nivå som konsekvent møter akseptkriteriene dine.
| Innsats | Praktisk startpunkt |
|---|---|
| low | Klassifisering, omskriving og rett-fram ekstraksjon |
| medium | Generell utvikling, analyse og de fleste første evalueringer |
| high | Kompleks feilsøking, arkitektur og multisource-syntese |
| xhigh | Vanskelig research og lang, flerstegs kodearbeid |
| max | Et lite antall av de aller vanskeligste oppgavene etter evaluering |
Slik bruker du bildeinput
Bruk en tilgjengelig bilde-URL eller en støttet opplastet fil. Kombiner bildet med en spesifikk inspeksjonsoppgave i stedet for å be om en generell beskrivelse.
vision = client.responses.create(
    model="gpt-6-astra",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "Identify one UI defect and propose a fix."},
            {"type": "input_image", "image_url": os.environ["SCREENSHOT_URL"]}
        ]
    }]
)

print(vision.output_text)
Slik bruker du strukturerte utdata og strømmer svar
Strukturerte utdata gir en maskinlesbar kontrakt; strømming forbedrer opplevd responsivitet. De løser ulike problemer og kan brukes sammen. Livssyklus-hendelser og tekstdeltaer bør håndteres separat.
stream = client.responses.create(
    model="gpt-6-astra",
    input="Create a deployment checklist.",
    stream=True,
)

completed = False
for event in stream:
    if event.type == "response.output_text.delta":
        print(event.delta, end="", flush=True)
    elif event.type == "response.completed":
        completed = True
    elif event.type in {"response.failed", "response.incomplete", "error"}:
        raise RuntimeError(event.type)

if not completed:
    raise RuntimeError("Stream closed before completion")
Slik opprettholder du tilstandsfulle samtaler
For portabel historikk, send på nytt brukerinput og modellutdataelementene som kreves for neste tur. Der leverandøren støtter det, kan previous_response_id referere til et lagret svar i stedet.
history = [{"role": "user", "content": "Give three latency improvements."}]
history.extend(
    item.model_dump(exclude={"id"}, exclude_none=True)
    for item in response.output
)
history.append({"role": "user", "content": "Turn them into a checklist."})

follow_up = client.responses.create(
    model="gpt-6-astra",
    input=history,
)
print(follow_up.output_text)
Slik bruker du funksjonskalling
En komplett funksjonssløyfe har fire deler: definer skjemaet, motta et verktøykall, utfør det i applikasjonen din, og returner et function_call_output-element med original call_id. Hold verktøytillatelser minimale og valider hvert argument før kjøring.
import json

history = [{"role": "user", "content": "Check order A-1042."}]
turn = client.responses.create(model="gpt-6-astra", input=history, tools=tools)
history.extend(item.model_dump(exclude={"id"}, exclude_none=True) for item in turn.output)

for item in turn.output:
    if item.type == "function_call" and item.name == "get_order_status":
        args = json.loads(item.arguments)
        tool_result = {"order_id": args["order_id"], "status": "shipped"}
        history.append({
            "type": "function_call_output",
            "call_id": item.call_id,
            "output": json.dumps(tool_result),
        })

final = client.responses.create(model="gpt-6-astra", input=history, tools=tools)
print(final.output_text)
Slik bruker du asynkrone verktøykall
Asynkrone verktøykall lar Astra fortsette uavhengig arbeid mens en langvarig funksjon eller et tilpasset verktøy venter. Sett async: true i verktøydefinisjonen, behold opprinnelig call_id, og returner resultatet når det eksterne arbeidet er ferdig. Applikasjonen din er fortsatt ansvarlig for jobbkø, tidsavbruddspolicy, idempotens og gjenoppretting.
Ikke send inn samme langvarige jobb igjen bare fordi et pollingsvindu utløp. Lagre jobb-ID-en og gjenoppta henting.
Slik prompt-er du GPT-6 Astra API
OpenAIs prompt-veiledning vektlegger initiativ, instruksjonsprioritet, stil, delegering og kalibrert verifikasjon. En nyttig produksjonsprompt bør angi oppgaven, tilgjengelige ressurser, fullføringstest, avgrensninger, forventet format og hvordan mangel på informasjon håndteres.
| Prompt-komponent | Hva som skal spesifiseres |
|---|---|
| Oppgave | Det konkrete utfallet som skal produseres |
| Ressurser | Filer, verktøy, data og kontekst som kan brukes |
| Fullføringstest | Betingelser som gjør arbeidet ferdig |
| Avgrensninger | Handlinger som er tillatt, forbudt eller krever godkjenning |
| Stil og format | Lengde, struktur, tone og output-skjema |
| Usikkerhet | Hva som kan utledes og hva som må avklares |
| Verifikasjon | Hvilke sjekker som kreves og når man skal slutte å teste |
Task: Review this API design and identify the three highest-impact migration risks.
Resources: Use the attached schema and deployment notes.
Completion test: Return three risks, evidence for each, and one acceptance test per risk.
Boundaries: Do not change production systems. Infer routine implementation details.
Clarification rule: Ask only if a missing requirement would materially change the result.
Style: Use concise prose and a final three-row table.
Verification: Check that every risk has an executable acceptance test.
GPT-6 Astra benchmarks: Høyere score, færre token
Offentlige evalueringer er mest nyttige når kvalitet og oppgaveøkonomi vurderes sammen. Benchmark-scorene nedenfor viser hvor Astras gevinster er store; de rapporterte besparelsene er konfigurasjonsspesifikke estimater, ikke garantier for enhver arbeidslast.
| Publisert evaluering | Astra | Sol | Forskjell |
|---|---|---|---|
| AutomationBench | 41,4% | 18,1% | +23,3 poeng |
| OSWorld 2.0 | 72,6% | 65,7% | +6,9 poeng |
| Terminal-Bench 4.0 | 57,9% | 37,3% | +20,6 poeng |
| MRCR v2, 512K-1M | 96,3% | 73,8% | +22,5 poeng |
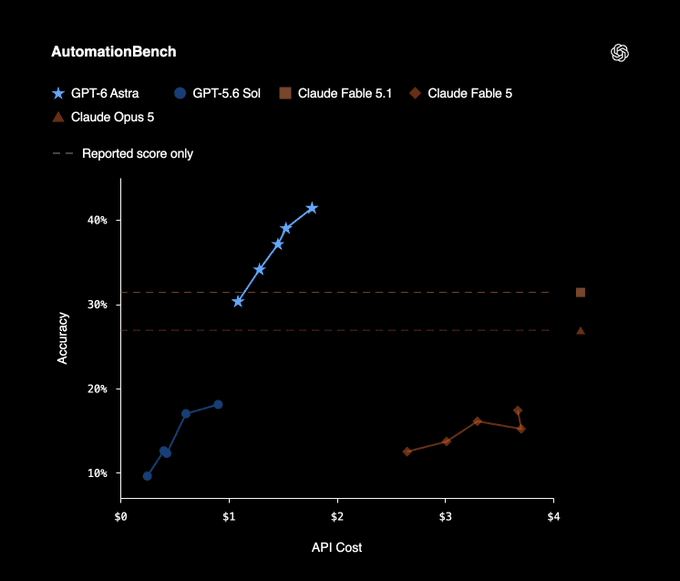
Offisiell OpenAI AutomationBench-graf: nøyaktighet plottet mot estimert API-kostnad.
| Sammenligning kostnad per oppgave | Kvalitetskonfigurasjon | Spart API-kostnad vs Sol |
|---|---|---|
| DeepSWE v1.1 | 74,1% vs 72,7%; høyest-scorede konfigurasjoner | Omtrent 32% |
| Database-migrering | 63,4% vs 42,7%; lavkost Astra-innstilling | Omtrent 38% |
| Terminal-Bench 4.0 | 57,9% vs 37,3%; rapporterte konfigurasjoner | Omtrent 9% |
Koblingen til prising er todelt. For det første kan færre utgående token og færre mislykkede forsøk senke estimert API-kost per fullført oppgave selv når Astra har høyere pris per token. For det andre er CometAPIs nåværende oppførte satser 20 % under tilsvarende leverandørsatser. Disse effektene er separate: ikke legg prosentene sammen, og ikke anta at en benchmark-besparelse vil gjentas i produksjon.
GPT-6 Astra API-priser
Prising måles per million token. Når input overstiger 272K token, gjelder langkontekst-planen for hele forespørselen.
| Gjeldende priser | CometAPI kort kontekst | CometAPI lang kontekst | OpenAI Standard |
|---|---|---|---|
| Input | $8 | $16 | $10 kort / $20 lang |
| Cache-lesing | $0.80 | $1.60 | $1 kort / $2 lang |
| Cache-skriving | $10 | $20 | $12.50 kort / $25 lang |
| Output | $40 | $60 | $50 kort / $75 lang |
Priser og gateway-policyer kan endres. Verifiser gjeldende priskonfigurasjon før budsjettering eller hardkoding av satser.
Slik reduserer du API-kostnader
- Hold stabile prefikser cache-vennlige. Plasser delte instruksjoner og verktøyskjemaer før forespørselsspesifikkt innhold.
- Unngå å passere 272K utilsiktet. Hent og dedupliser bare konteksten som kan endre svaret.
- Bruk laveste beståtte resonneringsnivå. Eskaler bare når aksept-raten forbedres.
- Ruter enkel trafikk annetsteds. Reserver Astra for arbeid som drar nytte av gjennomføringspålitelighet.
- Mål kostnad per akseptert oppgave. Inkluder retries, verktøykostnader og monetisert menneskelig gjennomgangsinnsats.
Slik migrerer du til GPT-6 Astra
Når du går fra GPT-5.6 Sol, gjør den minste kompatible endringen og kjør samme evalueringssett på nytt.
- Sett modellen til
gpt-6-astra. - Hvis den gamle ruten brukte
noneellerminimalresonnering, start pålow. - Bruk Responses for verktøy-kallende arbeidsflyter.
- Fjern ikke-støttede sampling-parametere:
temperature,top_pogtop_logprobs; fjern også Chat Completionslogprobs. - Test på nytt strukturerte utdata, caching, strømming, verktøysløyfer og leverandørspesifikk atferd.
- Sammenlign aksept-rate, latens, retries, token og menneskelig korreksjon før du endrer standardrute.
prompt = "Review this API design and identify migration risks."

baseline = client.responses.create(
    model="gpt-5.6-sol",
    input=prompt,
)

candidate = client.responses.create(
    model="gpt-6-astra",
    input=prompt,
    reasoning={"effort": "medium"},
)
Når bør du bruke GPT-6 Astra?
Bruk Astra når oppgavefeil er kostbare og arbeidsflyten kombinerer resonnering med verktøy, lang kontekst eller flerstegs utførelse.
- Feilsøking i repo-skala, migrering og test-og-retry-sløyfer.
- Nettleser- eller datamaskin-bruksagenter.
- Dyp research på tvers av flere kilder og verktøy.
- Svært lang dokument- eller kodebaseanalyse.
- Vitenskapelige og tekniske arbeidsflyter som bruker kode eller ekstern programvare.
- Profesjonell automatisering der en mislykket kjøring gir meningsfull gjenopprettingskostnad.
Bruk en billigere rute for enkel omskriving, korte sammendrag, klassifisering og rutinemessig ekstraksjon når det allerede møter kvalitetmål.
Vanlige API-feil
401 Authentication Error
Bekreft at forespørselen sender Authorization: Bearer <COMETAPI_KEY> og at prosessen leser korrekt miljøvariabel.
400 Bad Request
Sjekk for ikke-støttede sampling-parametere, et ugyldig skjema eller en ikke-støttet resonneringsverdi som none.
404 Model or Endpoint Error
Bekreft model="gpt-6-astra" og /v1/responses-ruten.
429 Rate Limit
Bruk eksponentiell backoff med jitter og en begrenset antall retries.
1 s -> 2 s -> 4 s -> 8 s -> capped retry window
5xx Server Error
Retry forbigående serverfeil, men ikke retry ugyldige 4xx-forespørsler uendret. Logg forespørselsidentifikatorer uten å lagre sensitiv prompt-tekst unødvendig.
FAQ
Hvilken modell-ID skal jeg bruke?
Bruk gpt-6-astra.
Bør jeg bruke Responses API eller Chat Completions?
Bruk Responses for nye integrasjoner, spesielt for verktøy, strukturerte utdata, strømming, tilstand og agent-arbeidsflyter. Behold Chat Completions bare der kompatibilitetskrav rettferdiggjør det.
Hvilken resonneringsinnsats bør jeg starte med?
Start med medium, evaluer deretter low for rutinetrafikk og high eller høyere for oppgaver som målbart drar nytte av dypere resonnering.
Kan Astra ta imot bilder?
Ja. Den aksepterer tekst og bildeinput og returnerer tekstutdata.
Er CometAPI-ruten alltid 20 % billigere per fullført oppgave?
Nei. De oppførte token-satsene er 20 % under tilsvarende leverandørpriser, men total oppgavekostnad avhenger også av kontekststørrelse, utdata-lengde, verktøykall, retries og gjennomgangsinnsats.
Bør Astra erstatte Sol overalt?
Nei. Sol er fortsatt det rimeligere valget for mange avgrensede arbeidslaster. Bruk Astra der sterkere gjennomføring, langkontekst-pålitelighet eller færre mislykkede forsøk endrer totaløkonomien.
Konklusjon
Astra er mest verdifull når et API-kall er ett trinn i en vanskelig arbeidsflyt snarere enn slutten på en. Dets lange kontekst, fem resonneringsnivåer, strukturerte utdata, strømming, funksjonskalling og nye agentkontroller gir utviklere flere måter å føre komplekst arbeid til fullføring.
Begynn med Responses, medium resonnering, klare fullføringskriterier og minimal nødvendig verktøytilgang. Mål aksept-rate og kostnad per akseptert oppgave, og øk deretter resonneringen eller ruter mer trafikk til Astra bare når bevisene støtter det.