Bygg med CometAPITrenger du ett API for flere modeller?Test arbeidsflyten i Playground, og opprett deretter en API-nøkkel når modellen og kostnaden passer bruksområdet ditt.
Slik bruker du DeepSeek V4.1 Flash API sammen med CometAPI ved hjelp av cURL, Python og JavaScript. Utforsk tenkemodus, inndata, strømming og produksjonspraksis.
For utviklere som bruker DeepSeek V4.1 Flash API i CometAPI, er den praktiske integrasjonen OpenAI-kompatibel: bruk https://api.cometapi.com/v1 som base-URL, sett modellen til deepseek-v4.1-flash, og kall standard Chat Completions-grensesnittet.
Én navneforskjell er viktig: DeepSeeks førsteparts-API bruker deepseek-flash, mens CometAPI bruker deepseek-v4.1-flash. Behandle modellidentifikatorer som leverandørspesifikk konfigurasjon.
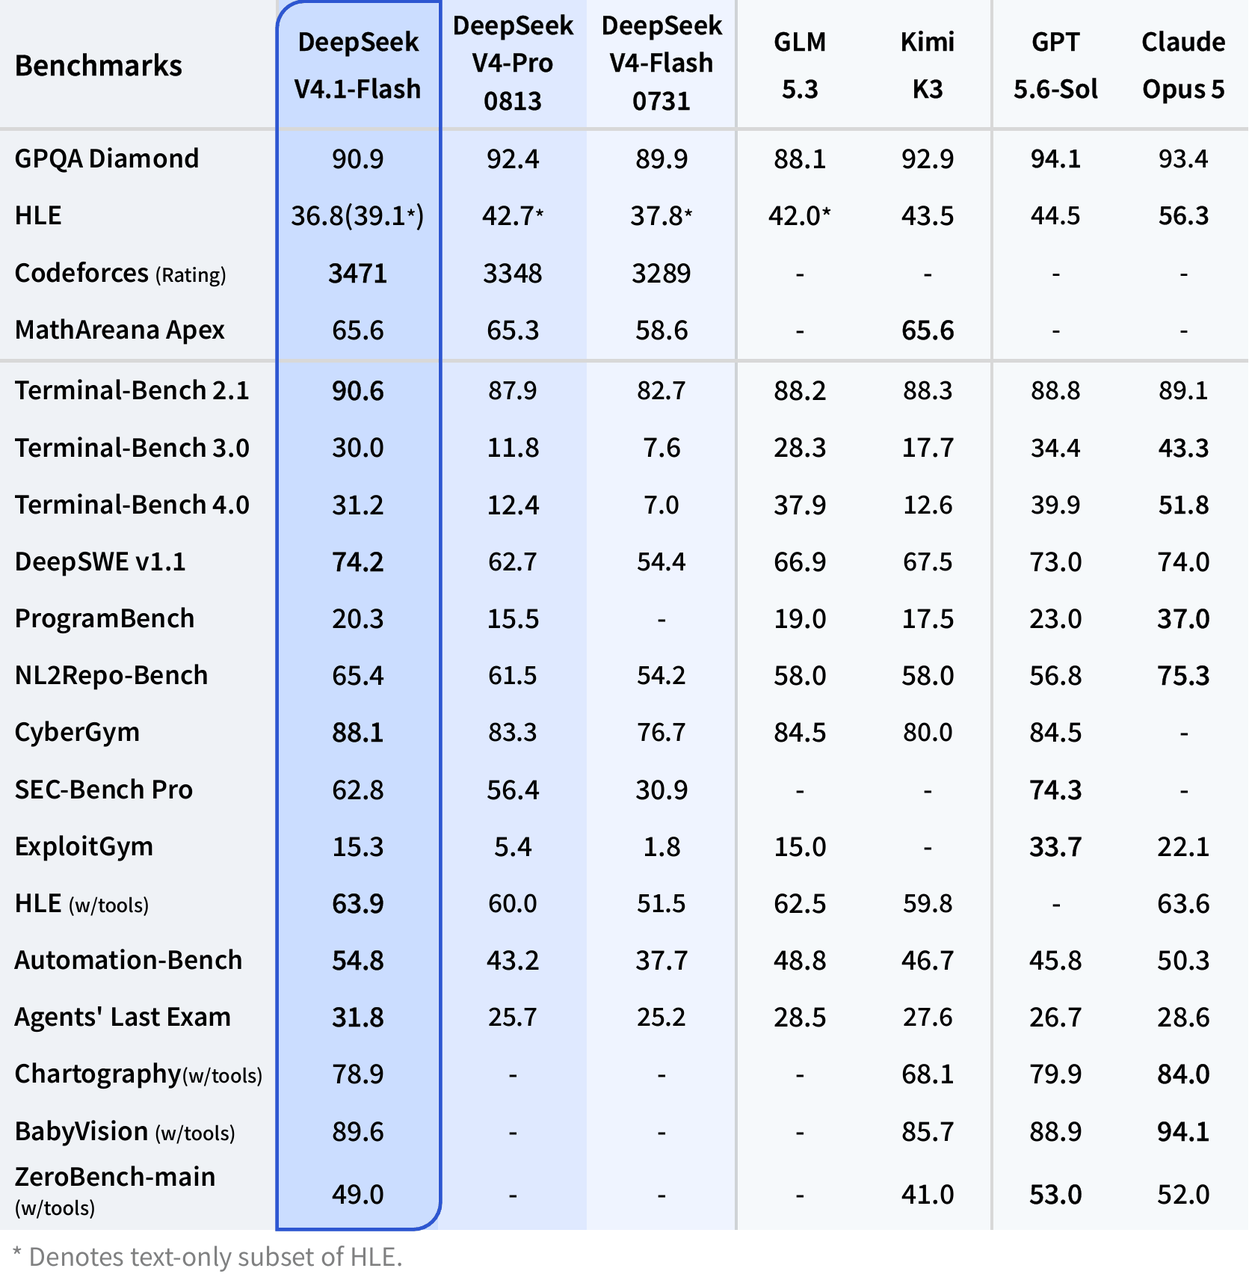
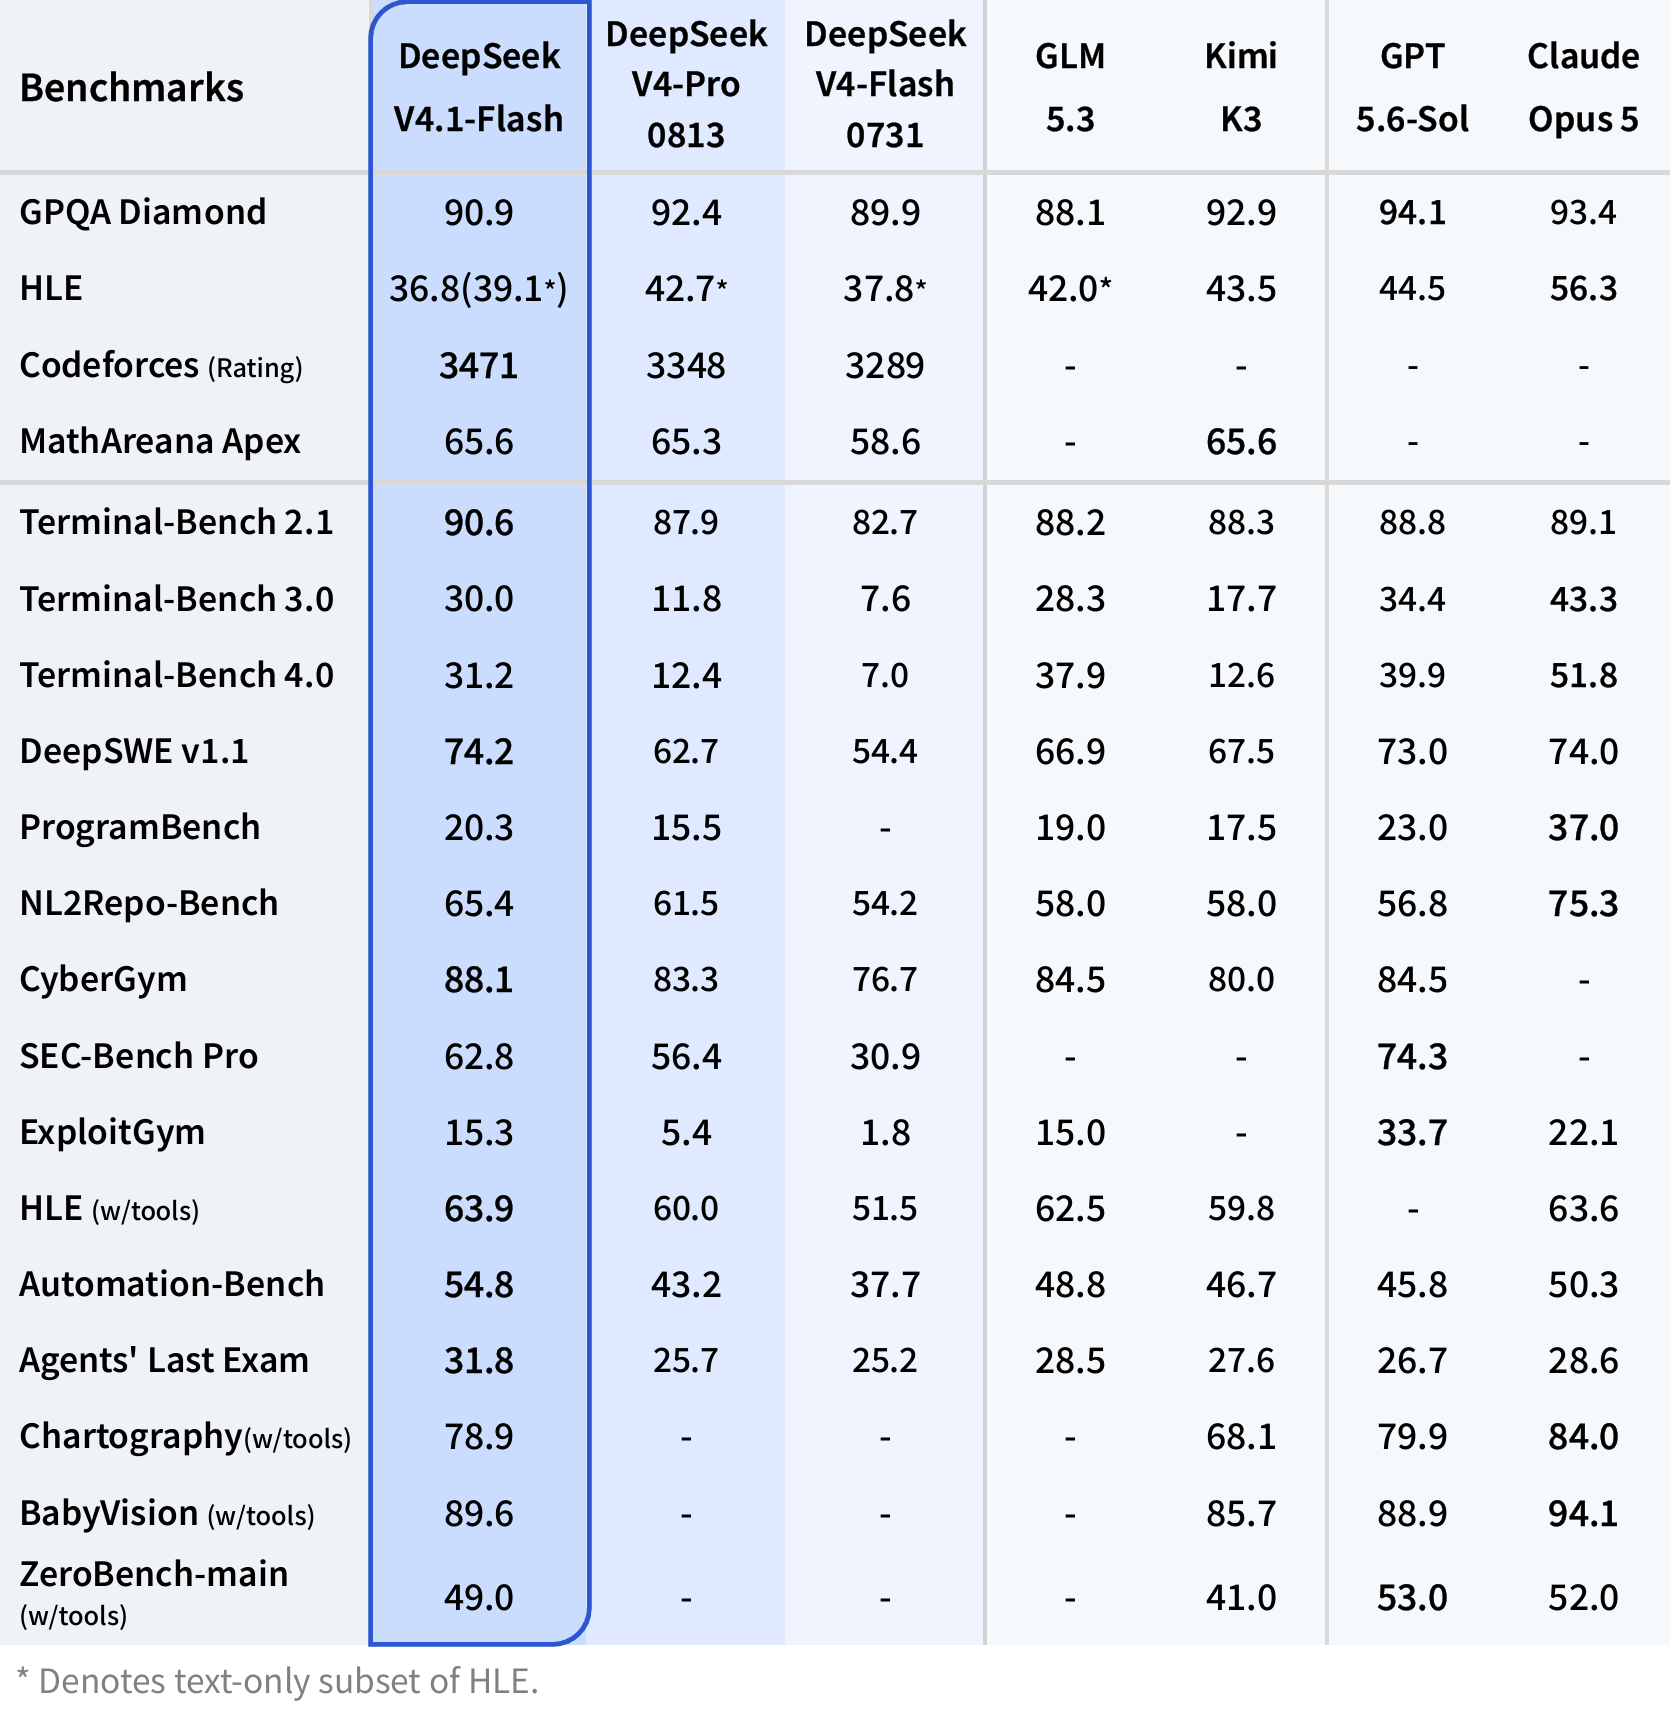
De største målte forskjellene er konsentrert innen koding, terminal, repository, automatisering og verktøyassisterte agent-benchmarker.
Før produksjonsutrulling, valider avanserte felt som thinking-kontroller, visjonsdata, streaming, verktøykall og strukturert output på nøyaktig den leverandørruten du vil ta i bruk.
Hva er DeepSeek V4.1 Flash API?
DeepSeek V4.1 Flash er den nyeste Flash-modellen bygget på en 552B-parameter Mixture-of-Experts-arkitektur. Dens kausale encoder-decoder-design aktiverer 8B parametere for input-prosessering og 16B for output-generering.
For integrasjonsplanlegging eksponerer det offisielle DeepSeek-API-et et kontekstvindu på 1M token og et maksimalt output på 384K token. Tjenesten oppstrøms støtter OpenAI-kompatible Chat Completions- og Responses-API-er, et Anthropic-kompatibelt API, streaming, JSON-output, verktøykall og innebygd bildeforståelse. Denne veiledningen bruker CometAPI Chat Completions-ruten, så verifiser funksjonspassthrough på den ruten før produksjonsutrulling.
Spesifikasjon
DeepSeek V4.1 Flash offisielle API-detaljer
Arkitektur
552B MoE, Causal Encoder-Decoder
Aktive parametere
8B for input; 16B for output
Kontekstlengde
1M token
Maksimalt output
384K token
Grensesnitt
Chat Completions, Responses API, Anthropic-kompatibelt API
Streaming
Støttet
Strukturert utdata
JSON-output og JSON Schema via støttede endepunkter
Verktøykall
Støttet, inkludert verktøybruk i thinking-modus
Bildeinput
JPEG, PNG, GIF og WebP
Bildegrenser
32 MiB inline; 64 MiB per fil; opptil 600 bilder per forespørsel
Førsteparts modell-ID
deepseek-flash
CometAPI modell-ID
deepseek-v4.1-flash
Leverandørmerknad: modell-ID-er og avanserte forespørselsfelt er rutespesifikke. Bruk deepseek-v4.1-flash for CometAPI-eksemplene i denne veiledningen, og test visjon, verktøykall, strukturert output og thinking-kontroller på endepunktet du faktisk distribuerer.
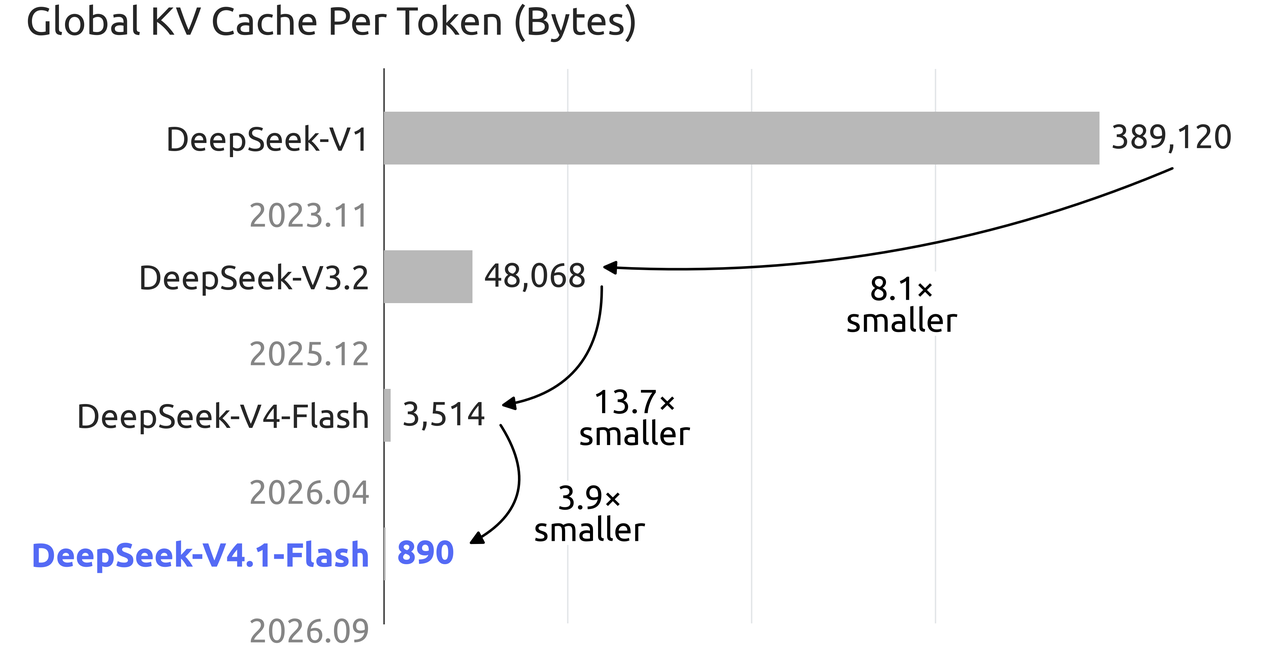
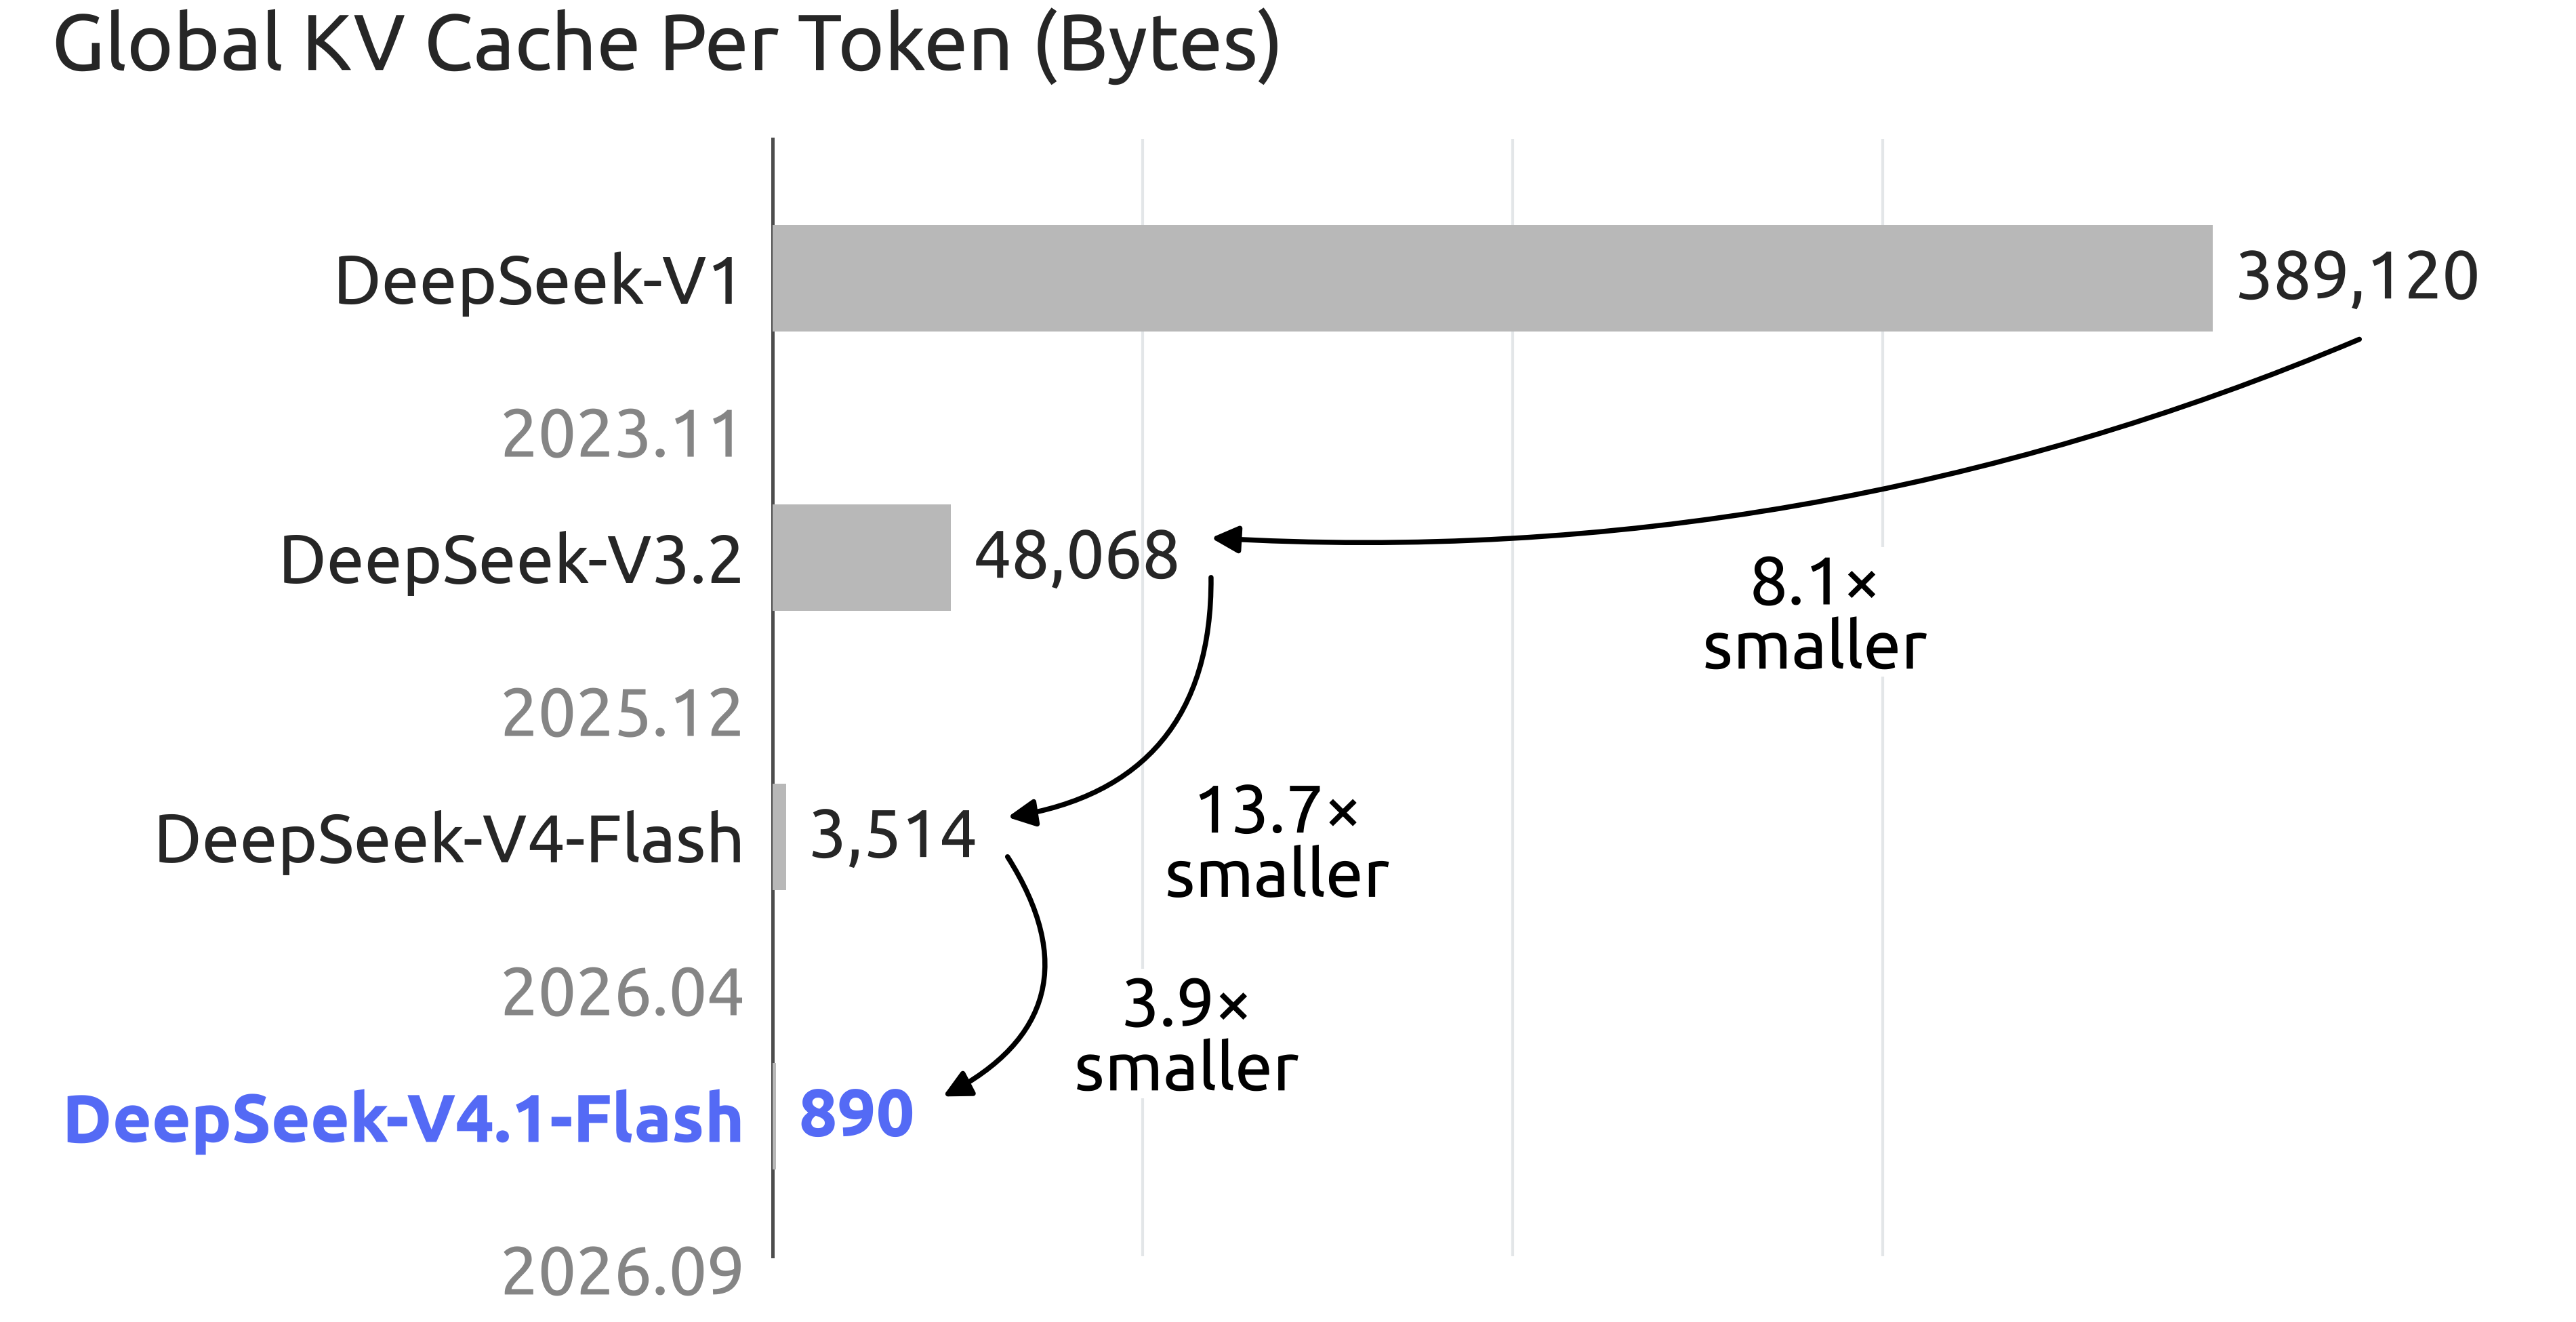
DeepSeek rapporterer også at den globale KV-cachen er rundt 890 byte per token, mot 3 514 byte per token for forrige V4 Flash-generasjon. Denne reduksjonen betyr mest for langtidskjørende agenter som gjentatte ganger gjenbruker store prompt, verktøyskjemaer og samtalehistorikk.
Hvor sterk er DeepSeek V4.1 Flash for koding og KI-agenter?
Denne veiledningen fokuserer på benchmark-bevis som direkte informerer API-valg. DeepSeek karakteriserer V4.1 Flash som bedre enn flaggskipmodeller, inkludert V4 Pro, på tvers av deres publiserte evalueringspakke. De mest handlingsrettede gevinstene vises innen terminalarbeid, programvareutvikling, repository-oppgaver, automatisering og verktøyassisterte agenter; produksjonsteam bør likevel validere modellen på egne prompt og fullføringskriterier.
Benchmark
DeepSeek V4.1 Flash
DeepSeek V4 Pro
DeepSeek V4 Flash
GPQA Diamond
90.9
92.4
89.9
Terminal-Bench 2.1
90.6
87.9
82.7
DeepSWE v1.1
74.2
62.7
54.4
NL2Repo-Bench
65.4
61.5
54.2
HLE with tools
63.9
60.0
51.5
Automation-Bench
54.8
43.2
37.7
Agents' Last Exam
31.8
25.7
25.2
Den praktiske konklusjonen er mer nyansert enn «V4.1 er smartere». DeepSeek V4.1 Flash er spesielt attraktiv for gjentatt verktøybruk, terminalhandlinger, koding i repository-skala, automatisering og lange agentforløp. Rene kunnskaps- eller resonneringsoppgaver kan gi en annen rangering.
Hvorfor bruke DeepSeek V4.1 Flash API via CometAPI?
Den viktigste integrasjonsfordelen er at DeepSeek V4.1 Flash API i CometAPI kan kalles via samme OpenAI-kompatible klientmønster som brukes for andre modeller, noe som reduserer SDK-endringer i multi-modell-applikasjoner.
Innstilling
Verdi
Base-URL
https://api.cometapi.com/v1
Chat-endepunkt
/chat/completions
Modell-ID
deepseek-v4.1-flash
Autentisering
Bearer API-nøkkel
Python-SDK
OpenAI-SDK kompatibel
JavaScript-SDK
OpenAI-SDK kompatibel
Dette unngår også en vanlig integrasjonsfeil: å kopiere DeepSeeks førstepartsidentifikator inn i en CometAPI-forespørsel. Leverandørrutene refererer til samme modellslekt, men de dokumenterte modell-ID-ene er forskjellige.
Opprett en CometAPI API-nøkkel, lagre den i en miljøvariabel, og konfigurer den OpenAI-kompatible base-URL-en som https://api.cometapi.com/v1. Ikke legg inn produksjonslegitimasjon i kildekoden.
Bruk CometAPI-modellidentifikatoren deepseek-v4.1-flash med standard Chat Completions-endepunktet.
curl "https://api.cometapi.com/v1/chat/completions"
  -H "Content-Type: application/json"
  -H "Authorization: Bearer ${COMETAPI_KEY}"
  -d '{
    "model": "deepseek-v4.1-flash",
    "messages": [
      {
        "role": "user",
        "content": "Explain three ways to reduce latency in a high-throughput API service."
      }
    ]
  }'
En vellykket respons bruker den velkjente OpenAI-stil fullføringsstrukturen, så applikasjoner som allerede leser choices[0].message.content krever minimal migrasjonsinnsats.
Python SDK-eksempel
pip install openai
``````python
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Write a Python retry helper with exponential backoff."
        }
    ],
)

print(response.choices[0].message.content)
I produksjon bør du legge til eksplisitte tidsavbrudd, begrensede retries, forespørselslogging og bruksmonitorering.
JavaScript SDK-eksempel
npm install openai
``````js
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
});

const response = await client.chat.completions.create({
  model: "deepseek-v4.1-flash",
  messages: [
    {
      role: "user",
      content: "Create a typed rate limiter interface for an Express API."
    }
  ],
});

console.log(response.choices[0].message.content);
Klientabstraksjonen forblir uendret, mens base-URL og modell-ID blir leverandørkonfigurasjon.
DeepSeek V4.1 Flash API-funksjoner
Konfigurer resonnering og tenkemodus
DeepSeek dokumenterer både thinking- og ikke-thinking-drift. Når du ruter via CometAPI, verifiser at leverandørspesifikke felt videresendes nøyaktig som forventet før du stoler på dem som en produksjonskontrakt.
Test hvert støttet innsatsnivå mot egne mål for latens, tokenbruk og oppgavefullføring, siden leverandørmappinger kan variere.
Analyser bilder med bildeinput
DeepSeek V4.1 Flash aksepterer JPEG, PNG, GIF og WebP. Offisielle grenser inkluderer 32 MiB per inline-bilde, 64 MiB per filbasert bilde, opptil 600 bilder per forespørsel, og en grense på 8 192 tegn for eksterne bilde-URL-er. Bilder hører hjemme i user- eller developer-meldinger, ikke system- eller assistant-meldinger.
response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "Identify the three most important anomalies."},
                {
                    "type": "image_url",
                    "image_url": {"url": "https://example.com/dashboard.png"}
                }
            ]
        }
    ],
)
Valider bildestørrelse, URL-tilgjengelighet, forhåndsprosessering, tokenbruk og latens på akkurat den CometAPI-ruten som brukes i produksjon.
Strøm svar med SSE
Streaming reduserer opplevd latens ved å levere inkrementell output til interaktive kode-, chat- og agentgrensesnitt.
stream = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Explain distributed-cache invalidation."
        }
    ],
    stream=True,
)

for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
Produksjonsklienter bør håndtere avbrutte strømmer, tomme deltaer, gjenoppretting etter tidsavbrudd, retry-grenser og endelig bruksregnskap.
Hvor mye koster DeepSeek V4.1 Flash API?
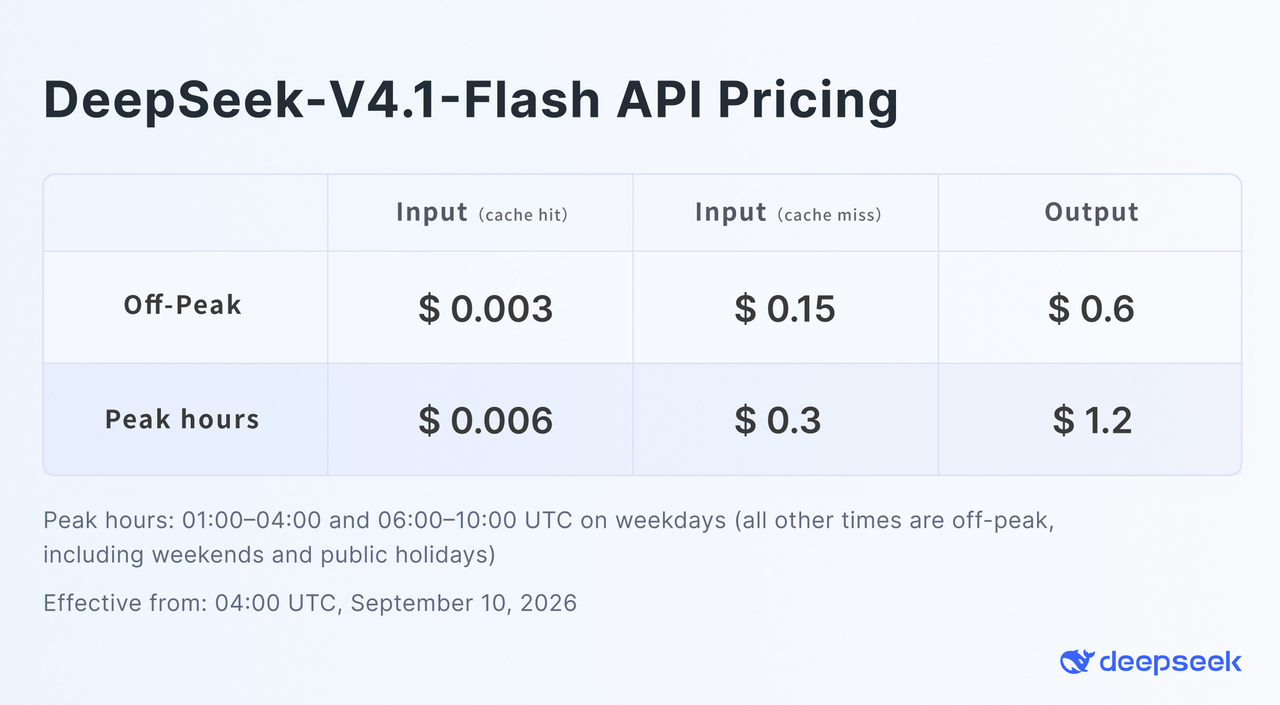
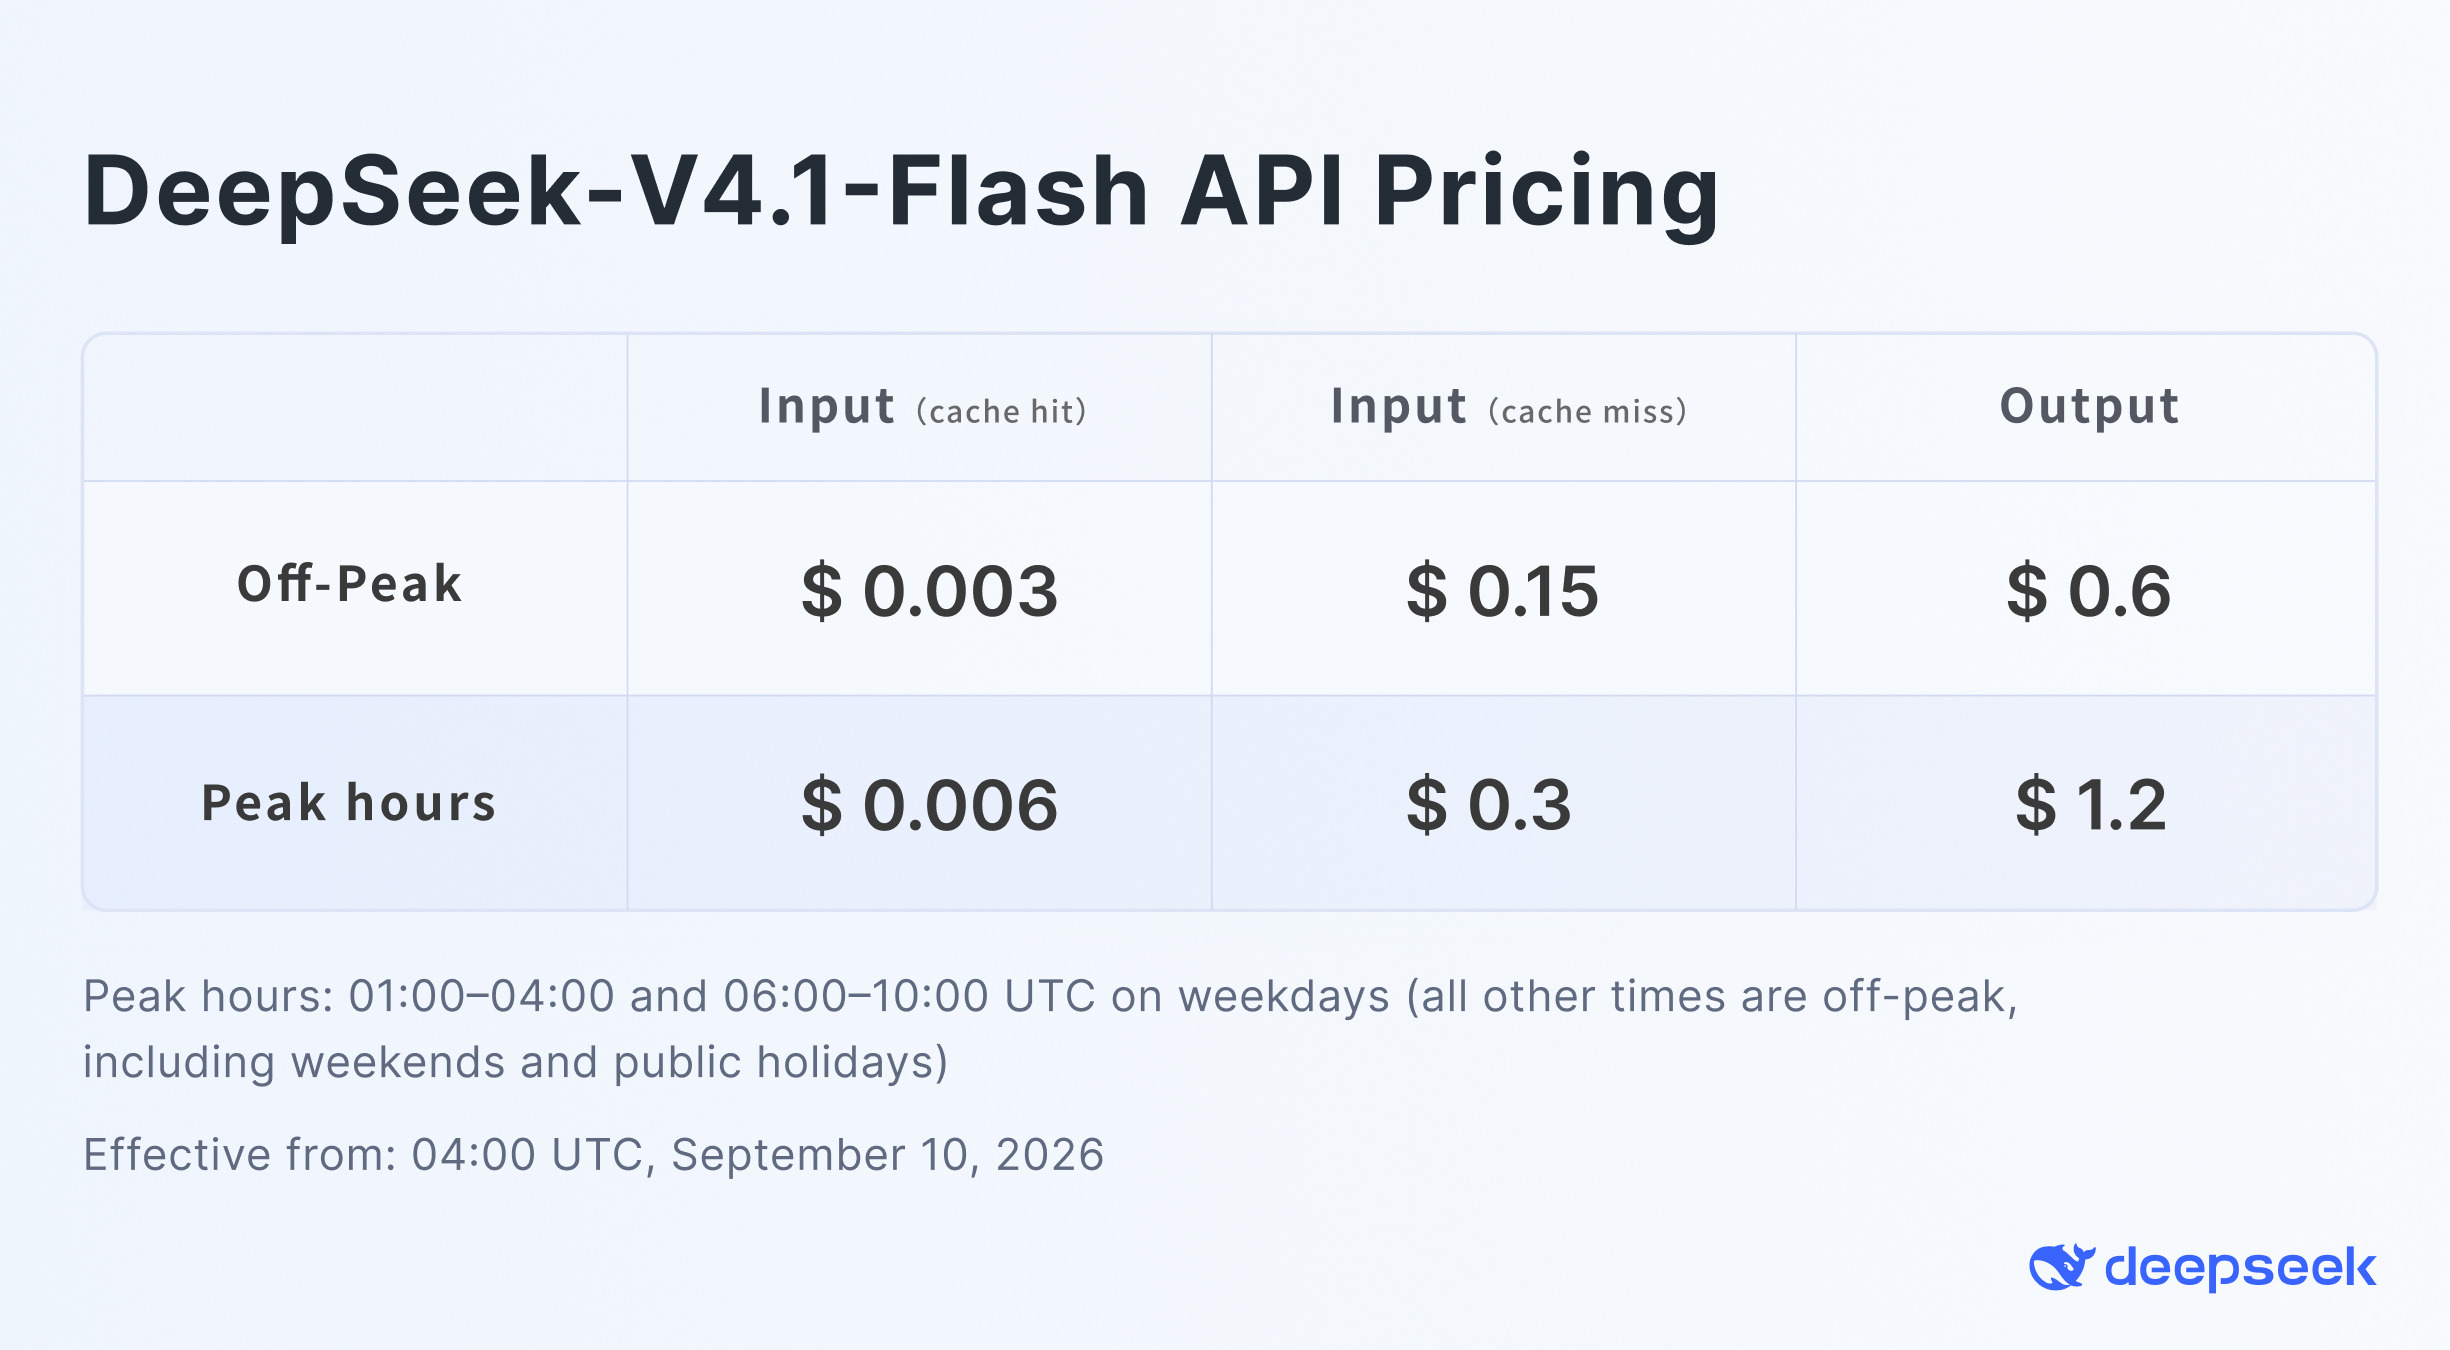
DeepSeeks dokumenterte API-priser bruker peak- og off-peak-vinduer. Det offisielle prisbildet viser off-peak-satser på $0.003/M cache-hit input, $0.15/M cache-miss input, og $0.60/M output; peak-satser er det dobbelte.
Et enkelt basisrate-eksempel for 100M cache-miss input-tokens og 20M output-tokens er:
Input:
100 x $0.12 = $12.00

Output:
20 x $0.48 = $9.60

Total base cost:
$21.60
Faktisk produksjonskostnad avhenger av cachet-token-miks, peak-multiplikatorer, forespørselbetingelser og gjeldende leverandørsats. Den store forskjellen mellom cache-hit og cache-miss-prising gjør stabile gjenbrukbare prefikser – systeminstruksjoner, verktøyskjemaer og felles kontekst – til en viktig kostnadsdriver.
DeepSeek V4.1 Flash API vs V4 Pro vs V4 Flash
Dimensjon
DeepSeek V4.1 Flash
DeepSeek V4 Pro
DeepSeek V4 Flash
Primær posisjonering
Effektiv resonnering, agenter, visjon
High-end V4-resonnering
Forrige raske V4-nivå
Innebygd visjon
Ja
Modellsavhengig / rutespesifikk
Eget visjons-endepunkt i forrige generasjon
Thinking
Ja
Ja
Ja
Agentytelse
Sterkest av de tre på mange publiserte agenttester
oppgir at DeepSeek V4 Pro forblir tilgjengelig etter 14. september 2026, med uendret fakturering. Verifiser live-dokumentasjonen før du stoler på ruting- eller migrasjonsatferd.
Hva bør du teste før du setter DeepSeek V4.1 Flash API i produksjon?
Modellruting: bekreft deepseek-v4.1-flash i CometAPI og hold leverandørspesifikke ID-er i konfigurasjon fremfor applikasjonslogikk.
Prompt-regresjon: kjør representative produksjonsprompt og sammenlign oppgavefullføring, ikke bare benchmark-poeng.
Strukturert output: valider hver JSON-respons mot applikasjonsskjemaet og definer en reparasjons- eller retry-sti.
Verktøykall: test argumenttyper, feilformede kall, parallelle kall og betingelser for løpps-terminering.
Thinking-kontroller: verifiser hvilke felt CometAPI videresender, og mål latens- og tokenpåvirkning for hver innstilling.
Visjon: test reelle skjermbilder og dokumenter, inkludert størrelsesgrenser, utilgjengelige URL-er og ikke-støttede meldingsroller.
Streaming: håndter tomme deltaer, avbrutte forbindelser, retry-grenser og endelig bruksregnskap.
Lang kontekst og caching: mål svarkvalitet, cache-treffrate og kostnad etter hvert som prompt-lengden øker.
Pålitelighet: registrer p50, p95 og p99-latens; øv på 429, 5xx, tidsavbrudd og fallback-baner.
Kostnadskontroll: spor input, cachet input, resonnering og output-tokens per fullført oppgave.
For agentarbeidslaster, sammenlign kostnad per fullført oppgave – ikke bare dollar per million token. En modell kan være dyrere per output-token og likevel billigere ende-til-ende hvis den reduserer retries og verktøykall; det motsatte gjelder når høyere resonneringsinnsats øker tokenforbruket uten å forbedre oppgavefullføring.
Er DeepSeek V4.1 Flash API verdt å bruke?
For nye DeepSeek-integrasjoner er DeepSeek V4.1 Flash en sterk standardkandidat for Flash-familien fordi den kombinerer bedre publisert agentisk ytelse med innebygd visjon og aggressiv prising.
De sterkeste brukstilfellene er ikke bare generisk chat. En bedre match er kodeagenter, automatisert programvareutvikling, langtidskontekstanalyse, multimodale assistenter, høyvolums arbeidsflytautomatisering og verktøybrukende agenter der gjentatt kontekst kan dominere totalkostnaden.
For utviklere som vil beholde en OpenAI-stil SDK-arkitektur, tilbyr DeepSeek V4.1 Flash API i CometAPI integrasjonsmønsteret brukt gjennom hele denne veiledningen: behold standard klientgrensesnitt, pek det mot https://api.cometapi.com/v1, og bruk deepseek-v4.1-flash.
DeepSeek V4.1 Flash API FAQ
Hvordan bør jeg organisere leverandørspesifikke modell-ID-er?
Lagre leverandør, base-URL og modell-ID sammen i miljøspesifikk konfigurasjon. Dette forhindrer at en førsteparts-ID som deepseek-flash ved et uhell sendes til en CometAPI-rute som forventer deepseek-v4.1-flash.
Hvordan kan jeg forbedre cache-gjenbruk i langtidskjørende agenter?
Hold stabile systeminstruksjoner, verktøyskjemaer og delt referansekontekst i starten av prompten. Legg til flyktig brukerinput og verktøyresultater senere, slik at det gjenbrukbare prefikset endres sjeldnere.
Hva er den tryggeste måten å sammenligne V4.1 Flash med V4 Pro?
Spill av samme produksjonsoppgavesett, sett tak på retry-budsjett, og sammenlign fullføringsrate, latens, antall verktøykall og totalt antall tokens. En lavere pris per token garanterer ikke lavere kostnad per vellykket oppgave.
Hvilken fallback-policy bør en agent bruke?
Definer hvilke feil som kan prøves på nytt, sett et strengt retry-tak, og velg en fallback-modell først etter at du har bevart verktøytilstanden som trengs for å fortsette trygt. Logg hver fallback slik at stille kvalitetsdrift er synlig.
Hvordan bør bildeforsendelser valideres før de sendes?
Sjekk faktisk filsignatur, støttet format, filstørrelse, URL-tilgjengelighet og meldingsrolle. Fjern unødvendige metadata og unngå å sende sensitive bilder med mindre retningslinjene for lagring og tilgang eksplisitt tillater det.
Når bør jeg vurdere Responses API i stedet for Chat Completions?
Bruk Chat Completions når du opprettholder et eksisterende OpenAI-kompatibelt meldingsarbeidsflyt. Vurder Responses API når applikasjonen drar nytte av typer for inputelementer, verktøy-output-bilder eller JSON Schema-output, og bekreft deretter at valgt leverandørrute støtter de nødvendige feltene.
Hvordan bør jeg håndtere skjemavalideringsfeil?
Avvis ugyldig output før den når nedstrøms systemer, registrer valideringsfeilen og prøv igjen med en begrenset reparasjonsprompt. Hvis gjentatt reparasjon mislykkes, ruter du oppgaven til en trygg fallback i stedet for å akseptere plausible, men ugyldige JSON.