📊 Tekniske spesifikasjoner
| Spesifikasjon | Detaljer |
|---|---|
| Modellfamilie | Gemini 3 (Flash-Lite) |
| Kontekstvindu | Opptil 1 million tokens (multimodal tekst, bilder, lyd, video) |
| Grense for utgangstokens | Opptil 64 K tokens |
| Inndatatyper | Tekst, bilder, lyd, video |
| Kjernearkitektur | Basert på Gemini 3 Pro |
| Distribusjonskanaler | Gemini API (Google AI Studio), Vertex AI |
| Prising (forhåndsvisning) | ~$0.25 per 1M inndatatokens, ~$1.50 per 1M utgangstokens |
| Kontroller for resonnering | Justerbare «tenkenivåer» (f.eks. minimalt til høyt) |
🔍 Hva er Gemini 3.1 Flash-Lite?
Gemini 3.1 Flash-Lite er den kostnadseffektive footprint-varianten i Googles Gemini 3-serie, optimalisert for massive AI-arbeidsbelastninger i skala—spesielt der redusert latens, lavere kostnad per token og høy gjennomstrømning er prioritert. Den bevarer den kjerne-multimodale resonneringsryggraden til Gemini 3 Pro, samtidig som den retter seg mot bulkprosesseringsbruk som oversettelse, klassifisering, innholdsmoderering, UI-generering og syntese av strukturert data.
✨ Hovedfunksjoner
- Ekstra stort kontekstvindu: Håndterer opptil 1 M tokens med multimodal input, muliggjør resonnering over lange dokumenter og video-/lydkontekster.
- Kostnadseffektiv kjøring: Betydelig lavere kostnad per token sammenlignet med tidligere Flash-Lite-modeller og konkurrenter, muliggjør høyvolumsbruk.
- Høy gjennomstrømning og lav latens: ~2.5× raskere tid-til-første-token og ~45 % raskere utdata-gjennomstrømning enn Gemini 2.5 Flash.
- Dynamiske resonneringskontroller: «Tenkenivåer» lar utviklere justere ytelse vs. dypere resonnering per forespørsel.
- Multimodal støtte: Naturlig prosessering av bilder, lyd, video og tekst i et samlet kontekstrom.
- Fleksibel API-tilgang: Tilgjengelig via Gemini API i Google AI Studio og enterprise Vertex AI-arbeidsflyter.
📈 Benchmark-ytelse
Følgende metrikker viser effektiviteten og kapasiteten til Gemini 3.1 Flash-Lite sammenlignet med tidligere Flash/Lite-varianter og andre modeller (rapportert mars 2026):
| Benchmark | Gemini 3.1 Flash-Lite | Gemini 2.5 Flash Dynamic | GPT-5 Mini |
|---|---|---|---|
| GPQA Diamond (vitenskapelig kunnskap) | 86.9 % | 66.7 % | 82.3 % |
| MMMU-Pro (multimodal resonnering) | 76.8 % | 51.0 % | 74.1 % |
| CharXiv (kompleks diagramresonnering) | 73.2 % | 55.5 % | 75.5 % (+python) |
| Video-MMMU | 84.8 % | 60.7 % | 82.5 % |
| LiveCodeBench (koderesonnering) | 72.0 % | 34.3 % | 80.4 % |
| 1M lang-kontekst | 12.3 % | 5.4 % | Not supported |
Disse resultatene indikerer at Flash-Lite opprettholder konkurransedyktig resonnering og multimodal forståelse selv med sin effektivitetsorienterte design, og overgår ofte eldre Flash-varianter på nøkkelbenchmarks.
⚖️ Sammenligning med relaterte modeller
| Funksjon | Gemini 3.1 Flash-Lite | Gemini 3.1 Pro |
|---|---|---|
| Kostnad per token | Lavere (inngangsnivå) | Høyere (premium) |
| Latens / gjennomstrømning | Optimalisert for hastighet | Balansert med dybde |
| Resonneringsdybde | Justerbar, men grunnere | Sterkere dyp resonnering |
| Bruksområdefokus | Bulk-pipelines, moderering, oversettelse | Oppgaver med kritisk resonnering |
| Kontekstvindu | 1 M tokens | 1 M tokens (samme) |
Flash-Lite er tilpasset skala og kostnad; Pro er for høy-presisjon, dyp resonnering.
🧠 Enterprise-bruksområder
- Høyvolums oversettelse og moderering: Sanntids språk- og innholdspipelines med lav latens.
- Bulk datauttrekk og klassifisering: Behandling av store korpora med effektiv token-økonomi.
- UI/UX-generering: Strukturert JSON, dashbordmaler og front-end-stillas.
- Simuleringsprompting: Logisk tilstands-sporing over utvidede interaksjoner.
- Multimodale applikasjoner: Video-, lyd- og bildeinformert resonnering i forente kontekster.
🧪 Begrensninger
- Resonneringsdybde og analytisk presisjon kan ligge etter Gemini 3.1 Pro i komplekse, oppgaver med kritisk betydning. :
- Benchmark-resultater som lang-kontekst-fusjon viser forbedringspotensial relativt til flaggskipsmodeller.
- Dynamiske resonneringskontroller avveier hastighet mot grundighet; ikke alle nivåer garanterer samme utgangskvalitet.
GPT-5.3 Chat (Alias: gpt-5.3-chat-latest) — Oversikt
GPT-5.3 Chat er den nyeste produksjons-chatmodellen fra OpenAI, tilgjengelig som endepunktet gpt-5.3-chat-latest i den offisielle API-en og driver ChatGPTs daglige samtaleopplevelse. Den fokuserer på å forbedre hverdagslig interaksjonskvalitet—gjøre svar mer smidige, mer nøyaktige og bedre kontekstualisert—samtidig som den opprettholder sterke tekniske kapasiteter arvet fra den bredere GPT-5-familien. :contentReference[oaicite:1]{index=1}
📊 Tekniske spesifikasjoner
| Spesifikasjon | Detaljer |
|---|---|
| Modellnavn/alias | GPT-5.3 Chat / gpt-5.3-chat-latest |
| Leverandør | OpenAI |
| Kontekstvindu | 128,000 tokens |
| Maks antall utgangstokens per forespørsel | 16,384 tokens |
| Kunnskapsavgrensning | August 31, 2025 |
| Inndatamodaliteter | Tekst og bildeinput (kun visjon) |
| Utdatamodaliteter | Tekst |
| Funksjonskalling | Støttet |
| Strukturerte utdata | Støttet |
| Strømming av svar | Støttet |
| Finjustering | Ikke støttet |
| Destillasjon / embeddings | Destillasjon ikke støttet; embeddings støttet |
| Typiske bruksendepunkter | Chat completions, Responses, Assistants, Batch, Realtime |
| Funksjonskalling og verktøy | Funksjonskalling aktivert; støtter web- og filsøk via Responses API |
🧠 Hva gjør GPT-5.3 Chat unik
GPT-5.3 Chat representerer en trinnvis forbedring av chat-orienterte kapabiliteter i GPT-5-linjen. Hovedmålet med denne varianten er å levere mer naturlige, kontekstuelt sammenhengende og brukervennlige samtalesvar enn tidligere modeller som GPT-5.2 Instant. Forbedringer er rettet mot:
- Dynamisk, naturlig tone med færre unyttige forbehold og mer direkte svar.
- Bedre kontekstforståelse og relevans i vanlige chat-scenarier.
- Smidigere integrasjon med rike chat-brukstilfeller inkludert flersamtale-dialog, oppsummering og samtaleassistanse.
GPT-5.3 Chat anbefales for utviklere og interaktive applikasjoner som trenger de nyeste samtaleforbedringene uten den spesialiserte resonneringsdybden til fremtidige «Thinking»- eller «Pro»-varianter av GPT-5.3 (som kommer).
🚀 Nøkkelfunksjoner
- Stort chat-kontekstvindu: 128K tokens muliggjør rik samtalehistorikk og lang-kontekstsporing. :contentReference[oaicite:17]{index=17}
- Forbedret svarkvalitet: Raffinert samtaleflyt med færre unødvendige forbehold eller overdrevne avslag. :contentReference[oaicite:18]{index=18}
- Offisiell API-støtte: Fullt støttede endepunkter for chat, batch-prosessering, strukturerte utdata og sanntids arbeidsflyter.
- Allsidig inndata-støtte: Godtar og kontekstualiserer tekst- og bildeinput, egnet for multimodale chat-brukstilfeller.
- Funksjonskalling og strukturerte utdata: Muliggjør strukturerte og interaktive applikasjonsmønstre via API-en. :contentReference[oaicite:21]{index=21}
- Bred økosystemkompatibilitet: Fungerer med v1/chat/completions, v1/responses, Assistants og andre moderne OpenAI API-grensesnitt.
📈 Typiske benchmarks og atferd
📈 Benchmark-ytelse
OpenAI og uavhengige rapporter viser forbedret ytelse i virkeligheten:
| Måleparameter | GPT-5.3 Instant vs GPT-5.2 Instant |
|---|---|
| Hallusinasjonsrate med nettsøk | −26.8% |
| Hallusinasjonsrate uten søk | −19.7% |
| Bruker-flaggede faktiske feil (web) | ~−22.5% |
| Bruker-flaggede faktiske feil (internt) | ~−9.6% |
Merk at GPT-5.3s fokus på samtalekvalitet i virkeligheten betyr at forbedringer i benchmark-score (som standardiserte NLP-metrikker) er mindre fremtredende ved lansering — forbedringene kommer tydeligst frem i brukeropplevelsesmetrikker snarere enn rå testscore.
I industrisammenligninger er chat-varianter i GPT-5-familien kjent for å overgå tidligere GPT-4-moduler på hverdagsrelevans og kontekstsporing, selv om spesialiserte resonneringsoppgaver fortsatt kan favorisere dedikerte «Pro»-varianter eller resonneringsoptimaliserte endepunkter.
🤖 Bruksområder
GPT-5.3 Chat egner seg godt for:
- Kundesupport-boter og samtaleassistenter
- Interaktive veilednings- eller læringsagenter
- Oppsummering og samtalesøk
- Interne kunnskapsagenter og team-chat-hjelpere
- Multimodal Q&A (tekst + bilder)
Balansen mellom samtalekvalitet og API-allsidighet gjør den ideell for interaktive applikasjoner som kombinerer naturlig dialog med strukturerte datautdata.
🔍 Begrensninger
- Ikke den dypeste resonneringsvarianten: For oppgaver med høy risiko og kritisk analytisk dybde kan kommende GPT-5.3 Thinking- eller Pro-modeller være mer passende.
- Multimodale utdata er begrenset: Selv om bildeinput støttes, er full bilde-/videogenerering eller rike multimodale utdata-arbeidsflyter ikke hovedfokuset for denne varianten.
- Finjustering støttes ikke: Du kan ikke finjustere denne modellen, men du kan styre atferd via systemprompter.
How to access Gemini 3.1 flash lite API
Trinn 1: Registrer API-nøkkel
Logg inn på cometapi.com. Hvis du ikke er vår bruker enda, vennligst registrer deg først. Logg inn på din CometAPI-konsoll. Hent tilgangslegitimasjonen API-nøkkel for grensesnittet. Klikk «Add Token» ved API-token i personlige senter, hent token-nøkkel: sk-xxxxx og send inn.
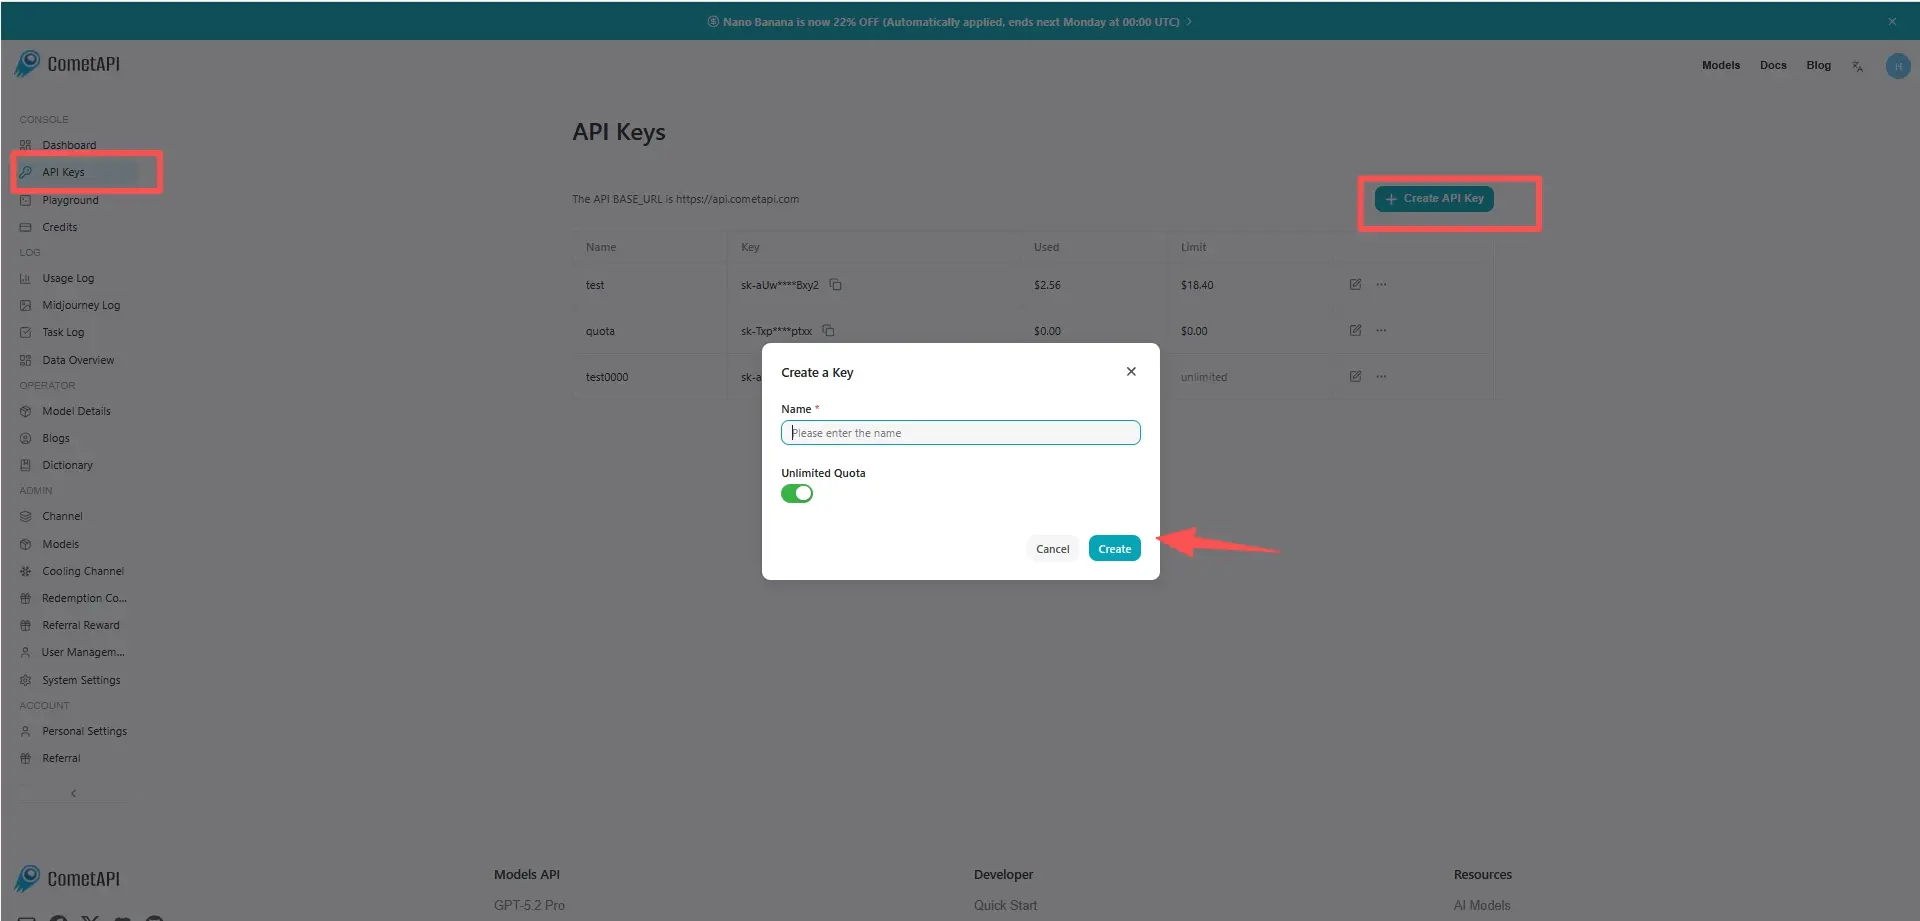
Trinn 2: Send forespørsler til Gemini 3.1 flash lite API
Velg endepunktet “` gemini-3.1-flash-lite” for å sende API-forespørselen og sett forespørselens body. Forespørselsmetode og body hentes fra vår nettsides API-dokumentasjon. Vår nettside tilbyr også Apifox-test for din bekvemmelighet. Erstatt <YOUR_API_KEY> med din faktiske CometAPI-nøkkel fra kontoen din. base url is Gemini Generating Content
Sett inn spørsmålet eller forespørselen din i content-feltet—det er dette modellen vil svare på . Behandle API-responsen for å hente det genererte svaret.
Trinn 3: Hent og verifiser resultater
Behandle API-responsen for å hente det genererte svaret. Etter behandling svarer API-et med oppgavestatus og utdata.