Hva er GPT-5.2 API
GPT-5.2 API er det samme som GPT-5.2 Thinking i ChatGPT. GPT-5.2 Thinking er mellomnivåvarianten i OpenAIs GPT-5.2-familie designet for dypere arbeid: flerstegsresonnering, oppsummering av lange dokumenter, kvalitetskodegenerering og profesjonelt kunnskapsarbeid der nøyaktighet og brukbar struktur betyr mer enn ren gjennomstrømning. I API-et eksponeres den som modellen gpt-5.2 (Responses API / Chat Completions), og den ligger mellom den lavlatente Instant-varianten og den høyere kvaliteten men dyrere Pro-varianten.
Hovedfunksjoner
- Svært lang kontekst & komprimering: 400K effektivt vindu og verktøy for komprimering som håndterer relevans på tvers av lange samtaler og dokumenter.
- Konfigurerbar resonneringsinnsats:
none | medium | high | xhigh(xhigh aktiverer maksimal intern beregning for krevende resonnering).xhigher tilgjengelig for Thinking/Pro-variantene. - Sterkere verktøy- og funksjonsstøtte: førsteklasses støtte for verktøykall, grammatikk (CFG/Lark) for å begrense strukturerte utdata, og forbedret agentatferd som forenkler kompleks flerstegsautomatisering.
- Multimodal forståelse: rikere bilde + tekst-forståelse og integrasjon i flerstegsoppgaver.
- Forbedret sikkerhet / håndtering av sensitivt innhold: målrettede tiltak for å redusere uønskede svar i områder som selvskading og andre sensitive kontekster.
Tekniske kapabiliteter & spesifikasjoner (utviklerperspektiv)
- API-endepunkter & modell-ID-er:
gpt-5.2for Thinking (Responses API),gpt-5.2-chat-latestfor chat/Instant-arbeidsflyter, oggpt-5.2-profor Pro-nivået; tilgjengelig via Responses API og Chat Completions der det er angitt. - Resonneringstokens & innsatsstyring: API-et støtter eksplisitte parametere for å tildele beregningsressurser (resonneringsinnsats) per forespørsel; høyere innsats øker latens og kostnad, men forbedrer outputkvaliteten for komplekse oppgaver.
- Strukturerte utdata-verktøy: støtte for grammatikk (Lark / CFG) for å begrense modellutdata til en DSL eller eksakt syntaks (nyttig for SQL, JSON, DSL-generering).
- Parallell verktøykalling & agentkoordinering: bedre parallellisme og renere verktøyorkestrering reduserer behovet for omfattende systemprompter og multi-agent-stillas.
Benchmark-ytelse & støttedata
OpenAI publiserte en rekke interne og eksterne benchmarkresultater for GPT-5.2. Utvalgte høydepunkter (OpenAIs rapporterte tall):
- GDPval (44 yrker, kunnskapsarbeid) — GPT-5.2 Thinking “slår eller matcher topp bransjeprofesjonelle i 70.9% av sammenligningene”; OpenAI rapporterer at utdata ble produsert med >11× hastigheten og <1% av kostnaden til ekspertprofesjonelle på deres GDPval-oppgaver (anslag for hastighet og kostnad er historikkbaserte). Disse oppgavene inkluderer regnearkmodeller, presentasjoner og korte videoer.
- SWE-Bench Pro (koding) — GPT-5.2 Thinking oppnår ≈55.6% på SWE-Bench Pro og ~80% på SWE-Bench Verified (kun Python) ifølge OpenAI, og etablerer en ny state of the art for kodegenerering / ingeniørevaluering i deres tester. Dette gir mer pålitelig feilsøking og end-to-end-rettinger i praksis, ifølge OpenAIs eksempler.
- GPQA Diamond (master-nivå vitenskaps-Q&A) — GPT-5.2 Pro: 93.2%, GPT-5.2 Thinking: 92.4% på GPQA Diamond (ingen verktøy, maks resonnering).
- ARC-AGI-serien — På ARC-AGI-2 (en vanskeligere test av flytende resonnering) scoret GPT-5.2 Thinking 52.9% og GPT-5.2 Pro 54.2% (OpenAI sier dette er nye state-of-the-art-nivåer for modeller i chain-of-thought-stil).
- Lang kontekst (OpenAI MRCRv2) — GPT-5.2 Thinking viser nær-100% nøyaktighet på 4-needle MRCR-varianten opp til 256k tokens og betydelig forbedrede resultater vs GPT-5.1 på tvers av langkontekst-innstillinger. (OpenAI publiserte MRCRv2-diagrammer og -tabeller.)
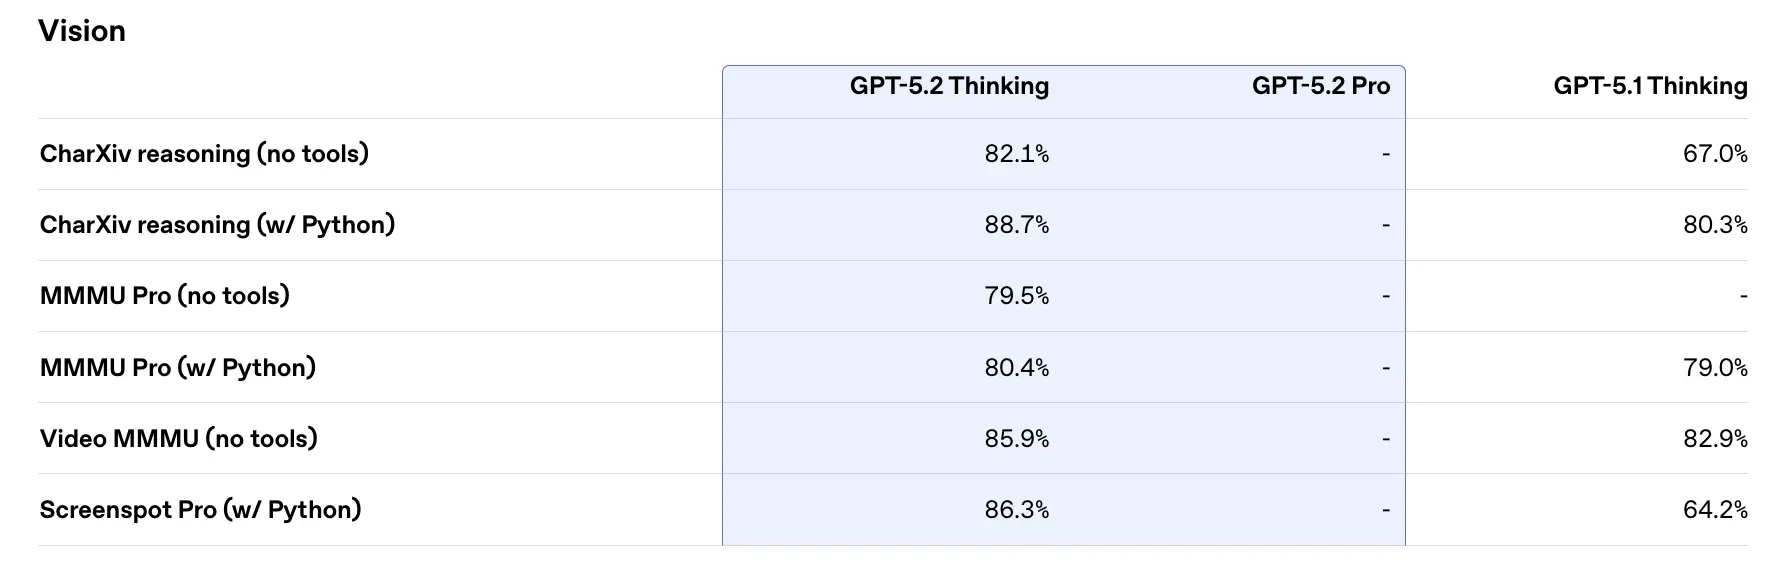
Sammenligning med samtidige
- vs Google Gemini 3 (Gemini 3 Pro / Deep Think): Gemini 3 Pro er profilert med et ~1,048,576 (≈1M) token kontekstvindu og brede multimodale inndata (tekst, bilde, lyd, video, PDF-er) samt sterk agentintegrasjon via Vertex AI / AI Studio. På papiret er Gemini 3s større kontekstvindu en differensiator for svært store enkeltøkt-arbeidsmengder; avveininger inkluderer verktøyflate og økosystemtilpasning.
- vs Anthropic Claude Opus 4.5: Anthropics Opus 4.5 vektlegger bedriftsrettede kode-/agent-arbeidsflyter og rapporterer sterke SWE-bench-resultater og robusthet for lange agentøkter; Anthropic posisjonerer Opus for automatisering og kodegenerering med et 200k kontekstvindu og spesialiserte agent-/Excel-integrasjoner. Opus 4.5 er en sterk konkurrent innen bedriftsautomatisering og kodeoppgaver.
Praktisk konklusjon: GPT-5.2 retter seg mot et balansert sett med forbedringer (400k kontekst, høye token-utdata, forbedret resonnering/koding). Gemini 3 sikter på de absolutt største kontekstene i én økt (≈1M), mens Claude Opus fokuserer på bedriftsrettet ingeniørarbeid og agentisk robusthet. Velg basert på samsvar mellom kontekststørrelse, modalitetsbehov, funksjon-/verktøytilpasning og avveininger i kostnad/latens.
Hvordan få tilgang til og bruke GPT-5.2 API
Trinn 1: Registrer deg for API-nøkkel
Logg inn på cometapi.com. Hvis du ikke er brukeren vår ennå, registrer deg først. Logg inn i din CometAPI console. Hent tilgangslegitimasjonens API-nøkkel til grensesnittet. Klikk “Add Token” ved API-tokenet i det personlige senteret, hent tokennøkkelen: sk-xxxxx og send inn.
Trinn 2: Send forespørsler til GPT-5.2 API
Velg “gpt-5.2”-endepunktet for å sende API-forespørselen og angi forespørselskroppen. Forespørselsmetoden og forespørselskroppen hentes fra vår nettsides API-dok. Nettstedet vårt tilbyr også Apifox-test for din bekvemmelighet. Erstatt <YOUR_API_KEY> med din faktiske CometAPI-nøkkel fra kontoen din. Utviklere kaller disse via Responses API / Chat endepunktene.
Sett inn spørsmålet eller forespørselen din i content-feltet—det er dette modellen vil svare på . Behandle API-svaret for å få det genererte svaret.
Trinn 3: Hent og verifiser resultater
Behandle API-svaret for å få det genererte svaret. Etter behandlingen svarer API-et med oppgavestatus og utdata.
Se også Gemini 3 Pro Preview API