
Svar først
GPT-6 Astra er OpenAIs nye flaggskipsmodell for vanskelige ende-til-ende-oppgaver. OpenAI lanserte GPT-6 Astra 3. september 2026 og posisjonerte den for kompleks resonnering, datamaskinbruk, koding, forskning, vitenskapelig arbeid og profesjonell leveranseproduksjon. API-modellen har et 1.05M-tokens kontekstvindu og 128K maks utdata, aksepterer tekst- og bildeinput, og støtter reasoning effort fra low til max. Standard API-priser starter på $10 input / $50 output per million tokens. Den viktigste praktiske endringen er ikke et jevnt hopp på alle generell-intelligens-benchmarker: Astras største gevinster kommer i agentbasert utførelse, datamaskinbruk, langkontekst-henting, kodingsarbeidsflyter, vitenskap og cybersikkerhet.
Dette er viktig fordi den eldre CometAPI-artikkelen GPT-6 Is Coming Soon — What Will It Look Like? nødvendigvis var spekulativ. Nå som Astra er offentlig, fokuserer denne veiledningen på bekreftet modellatferd, benchmark-avveiinger, API-økonomi og hvor modellen faktisk er et bedre valg enn billigere alternativer på frontlinjen.
Hva er GPT-6 Astra?
GPT-6 Astra er etterfølgeren til OpenAIs flaggskip GPT-5.6 Sol. OpenAI beskriver Astra som sin mest kapable modell for de vanskeligste ende-til-ende-oppgavene, med vekt på arbeidsflyter som krever at modellen resonerer, bruker verktøy, interagerer med programvare, reviderer mellomresultater og bærer en oppgave fra første forespørsel til ferdig resultat. Denne posisjoneringen er viktig: Astra er ikke bare en større chat-modell. Den er designet til å fungere som resonneringsmotoren inne i agenter som arbeider på tvers av nettlesere, terminaler, dokumenter, regneark, utviklingsmiljøer og bedriftsprogramvare.
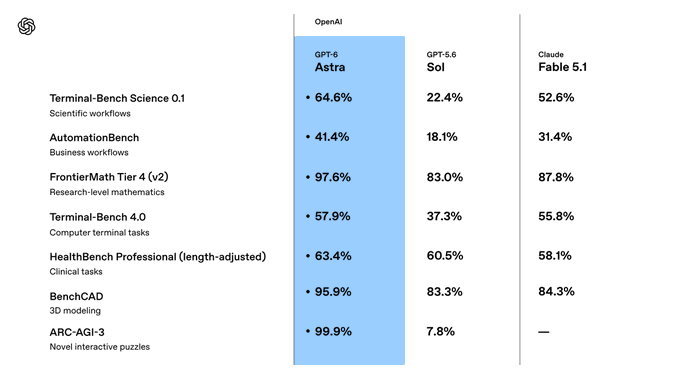
Lanseringsinnlegget fremhever banebrytende resultater innen datamaskinbruk, surfing, programvareutvikling, cybersikkerhet, vitenskap og profesjonelt arbeid. Det rapporteres 97.6% / 99.9% / 100% på henholdsvis FrontierMath Tier 4, ARC-AGI-3 og ExploitBench. Disse toppscoreene er slående, men de bør ikke tolkes som «Astra vinner alle benchmarker.» På Artificial Analysis Intelligence Index, brukt i OpenAIs egen sammenligningstabell, scorer Astra 61,2 mens Claude Fable 5.1 scorer 65,7. Lanseringen bør derfor forstås som et stegskifte i utførelse og agentbasert arbeid snarere enn en ren seier på alle mål for intelligens.
Hva er nytt fra GPT-5.6 Sol?
Datamaskinbruk ble en førsteklasses kjernekapabilitet
Astras tydeligste generasjonsgevinst er bruk av datamaskin. På OSWorld 2.0 rapporterer OpenAI 72.6% for Astra mot 65.7% for GPT-5.6 Sol. I samme latenssimulering fullførte Astra oppgaver på omtrent 40 minutter sammenlignet med cirka 75 minutter for Sol, en reduksjon på rundt 47%. Kombinert med et oppdatert Codex-harness, rapporterer OpenAI 1,9× raskere fullføring på Mind2Web. Poenget i praksis er ikke bare at Astra kan se en skjerm; den kan holde en flertrinns programvareoppgave konsistent lenger og ta færre kostbare omveier.
Profesjonelle leveranser blir mer målrettede
OpenAI trente eksplisitt Astra for profesjonelle arbeidsflyter som ender i brukbare leveranser fremfor rå prosa. Lanseringsmaterialet beskriver sterkere ytelse på dokumenter, regneark, presentasjoner, dataanalyse, designarbeid og maloverholdelse. Astra er også bedre til å holde kursen når krav endres midt i oppgaven, slik at en styringsmelding i mindre grad overstyrer det opprinnelige målet. Dette er spesielt nyttig i langvarige bedriftsagenter, der nye instruksjoner ofte kommer etter at arbeidsflyten allerede har startet.
Lange økter beholder mer nyttig arbeidssammenheng
For lange kodeøkter introduserer Astra en ny måte for Codex å bevare og hente notater etter at den aktive konteksten er fylt opp. Tidligere tilnærminger stolte tungt på komprimering, som kan utelate hvorfor et forsøk på fiks feilet eller hvilke begrensninger som allerede var testet. OpenAI sier at Astra kan beholde notater på tvers av kontekstvinduer, noe som forbedrer kontinuiteten under store refaktoreringer og feilsøkingsøkter.
Reasoning effort går nå opp til max
Utviklere kan velge low, medium, high, xhigh eller max reasoning effort. Dette skaper en bredere kvalitet–kost-kurve enn å behandle Astra som et enkelt fast driftspunkt. Den offisielle modellveiledningen anbefaler å velge laveste nivå som møter evalueringsmålet ditt, fordi modellens beste økonomi ofte kommer fra tokeneffektivitet snarere enn alltid å kjøre på maks reasoning.
GPT-6 Astra benchmark-ytelse
OpenAI publiserte en bred sammenligning som spenner over datamaskinbruk, profesjonelt arbeid, koding, akademisk resonnering, helse, cybersikkerhet, lang kontekst og tilpasning. Den mest nyttige måten å lese tabellen på er å skille «generell intelligens» fra «evnen til å fullføre arbeid med verktøy». Astra ligger bare marginalt over Sol på Artificial Analysis Intelligence Index i OpenAIs tabell, men er dramatisk foran på flere agent- og operasjonelle benchmarker.
Mønsteret er uvanlig klart. Astras fordel er størst når en benchmark krever vedvarende interaksjon med et verktøy eller miljø. AutomationBench stiger fra 18.1% til 41.4%; Terminal-Bench Science øker fra 22.4% til 64.6%; og langkontekst MRCR forbedres fra 73.8% til 96.3% i 512K–1M-båndet. Til sammenligning beveger Artificial Analysis Intelligence Index seg fra 60.9 til 61.2. Derfor bommer beskrivelsen «2,5× dyrere men litt smartere» på modellens faktiske verdiforslag.
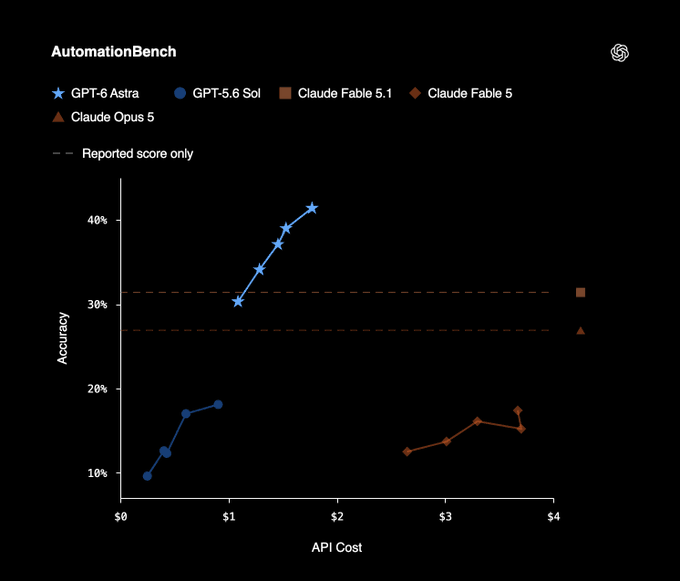
Kilde: OpenAI AutomationBench-diagram (originalbilde, ikke gjengitt på nytt)
Uavhengige benchmarker: Er GPT-6 Astra et generasjonshopp?
Uavhengig testing gir en viktig realitetssjekk. Artificial Analysis rapporterer en Intelligence Index-score på 61, lik GPT-5.6 Sol på max effort. Samtidig forbedrer Astra seg kraftig på Coding Agent Index og bruker vesentlig færre tokens i agentbasert koding. Artificial Analysis målte omtrent tre ganger lavere tokenbruk enn GPT-5.6 Sol på max effort i sitt Codex-harness, slik at Astra kan score høyere til omtrent samme kostnad per kodingsagent-oppgave.
Økonomien ser mindre gunstig ut på generell intelligens. Astra bruker omtrent 10% færre utdata-tokens enn Sol i Intelligence Index på max effort, men den 2,5× høyere per-token-prisen dominerer denne effektiviseringsgevinsten; Artificial Analysis anslår at Astra er omtrent 75% dyrere per oppgave på max effort. Det rapporterer også en reduksjon i hallusinasjonsrate fra 92% til 51% på AA-Omniscience samtidig som nøyaktigheten økte med fire poeng.
Den nyttige konklusjonen er arbeidslastspesifikk: GPT-6 Astra fremstår mest generasjonell der en agent må handle, iterere, bruke verktøy og fullføre en komplisert jobb. For ordinær resonnering eller høyvolums tekstgenerering kan pris-premien være langt vanskeligere å hente inn.
GPT-6 Astra vs GPT-5.6 Sol vs Claude Fable 5.1 vs Gemini 3.8 Flash
En praktisk modellvalg-sammenligning bør inkludere kapasitet, multimodalitet, kontekst, agentbasert utførelse og pris. Modellene nedenfor er ikke utskiftbare: Astra optimaliserer for hard ende-til-ende-utførelse, Claude Fable 5.1 leder noen generell-intelligens-mål, og Gemini 3.8 Flash tilbyr langt lavere token-priser med bredere native inputmodaliteter.
Når GPT-6 Astra er det bedre valget
Velg Astra når oppgaven er kostbar fordi mennesker må redde mislykkede agentkjøringer: lange kodeendringer, nettleser/skrivebordsautomatisering, dyp forskning som spenner over verktøy, teknisk leveranseproduksjon, eller komplekse vitenskapelige og operasjonelle arbeidsflyter. Premien er lettest å rettferdiggjøre når færre retries, færre manuelle korrigeringer og lavere utdata-tokenbruk betyr mer enn rå per-token-pris.
Når Claude Fable 5.1 er det bedre valget
Claude Fable 5.1 er fortsatt en seriøs konkurrent på frontlinjen. I OpenAIs egen lanseringstabell scorer den 65,7 på Artificial Analysis Intelligence Index mot Astras 61,2, og 65,0 på Humanity’s Last Exam med verktøy mot Astras 57,2. Det betyr at Astra ikke bør markedsføres som en universell intelligensvinner. Hvis evalueringssettet ditt ligner mer på langforma resonnering enn datamaskinbruk-utførelse, kan Claude Fable 5.1 fortsatt være et bedre valg.
Når Gemini 3.8 Flash er det bedre valget
Gemini 3.8 Flash sikter mot et annet punkt på frontlinjen. Den støtter tekst, bilde, lyd, video og PDF-input med et kontekstvindu på omtrent 1M tokens, mens offisiell introduksjonsprising er langt under Astra. For høyvolums multimodal ekstraksjon, video/lydforståelse, rutineagenter eller arbeidslaster der $10/$50-tokenøkonomi er vanskelig å forsvare, er Gemini 3.8 Flash ofte det mer økonomiske produksjonsvalget.
Hvorfor GPT-6 Astras cybersikkerhetsrating betyr noe
Astra er den første bredt distribuerte OpenAI-modellen som når kritisk terskel for cybersikkerhetskapabilitet under selskapets Preparedness Framework. OpenAI sier at modellen kan identifisere tidligere ukjente sikkerhetsfeil og utvikle utnyttelsesstrategier på tvers av herdede systemer når den får riktige verktøy og tilgang. I lanseringsevalueringer scoret Astra 100% på ExploitBench, 42.4% på ExploitGym og 88.0% på SRE-Bench i ett forsøk.
Denne kapabiliteten kommer med strengere distribusjonskontroller. OpenAI sier at produksjonsvernet kan senke, pause eller stoppe legitimt arbeid, spesielt i høyere-risiko cyberkontekster. ChatGPT eller Codex kan be en bruker om å gjennomgå en handling før fortsettelse, mens en API-oppgave kan stoppe. Standarddistribusjonen av Astra avviser også mer avanserte forespørsler om exploit-laging; OpenAIs Daybreak program gir separat, vurdert tilgang for noen defensive arbeidsflyter.
Systemkortet dokumenterer en avveining i monitorerbarhet: Astra er bedre tilpasset totalt sett enn Sol, men dens skriftlige resonnering kan være vanskeligere å overvåke under adversarielle evalueringsforhold. OpenAI distribuerer derfor bredere misjusteringsovervåking rundt verktøybrukende Astra-inferens. Bedriftsteam bør behandle agenttillatelser, godkjenningsgrenser, revisjonslogger og minst-privilegert verktøytilgang som en del av modellarkitekturen, ikke valgfrie tillegg.
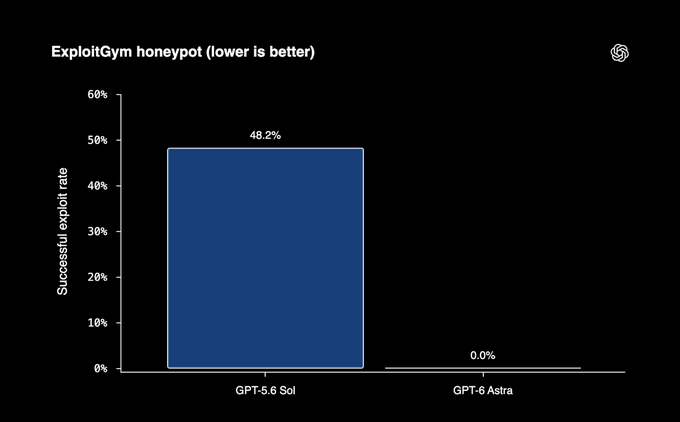
Kilde: OpenAIs offisielle ExploitGym-honeypot sikkerhetsdiagram (originalbilde, ikke gjengitt på nytt)
GPT-6 Astra-priser
OpenAIs gjeldende API-prisside skiller mellom kort- og langkontekst-forespørsler. For Standard-behandling er kortkontekst-satsene $10 input, $1 cached input, $12.50 cache writes og $50 output per million tokens. Forespørsler over 272K input-tokens bruker langkontekst-tabellen: $20 input, $2 cached input, $25 cache writes og $75 output per million tokens.
Sammenlignet med GPT-5.6 Sol, er Astras Standard per-token-priser for kort kontekst 2,5× høyere ($10/$50 versus $4/$20). Den premien betyr ikke automatisk 2,5× høyere kostnad per fullført oppgave. På agentbasert koding rapporterer både OpenAI og Artificial Analysis lavere utdata-tokenbruk for Astra i noen konfigurasjoner. Riktig enhet for evaluering er derfor kost per vellykket oppgave, ikke bare kost per token.
Slik får du tilgang til GPT-6 Astra
OpenAI startet en trinnvis utrulling 3. september 2026. Astra er planlagt å nå ChatGPT Plus, Pro, Business og Enterprise-brukere, OpenAI API og AWS i løpet av de følgende dagene. Bedriftsadministratorer kan aktivere Astra per arbeidsområde, og tilgang er av som standard ved lansering.
Kall GPT-6 Astra med OpenAI Responses API
from openai import OpenAI
client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "high"},
    input=(
        "Gå gjennom denne arkitekturen for repositoryet. Identifiser det mest risikable "
        "designproblemet, forklar bevisene, og foreslå en migrasjonsplan."
    ),
)

print(response.output_text)
Modell-ID-en er gpt-6-astra. For verktøytunge arbeidsflyter er Responses API det naturlige utgangspunktet fordi Astra støtter function calling, structured outputs, web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP og tool search. Finjustering støttes foreløpig ikke.
Virkelige bruksområder for GPT-6 Astra
Spillutvikling og visuelle programvarearbeidsflyter
Playco testet Astra i Playbot, en KI-drevet IDE som arbeider direkte i Unity og Godot. OpenAI rapporterer 50% færre manuelle fiks enn med forrige modell, og tre tematiske prototyper bygget fra et enkelt gråboks-grunnlag. Dette eksemplet er viktig fordi oppgaven krever mer enn kildekodegenerering: modellen må resonnere om romlig oppsett, spille spillet, teste endringer, identifisere feil og iterere i et visuelt miljø.
Juridisk og finansiell dokumentgjennomgang
OpenAI posisjonerer Astra for flertrinns profesjonelle arbeidsflyter som produserer polerte dokumenter, regneark og analyser. I juridisk og finansiell gjennomgang ligger den praktiske verdien i å opprettholde oppgavestatus på tvers av mange filer, kryss-sjekke bevis og levere en ferdig leveranse snarere enn å besvare ett isolert spørsmål. Ekspertvalidering, godkjenningskontroller og minst-privilegert datatilgang er fortsatt nødvendig.
Ingeniøragenter med lang horisont
Kombinasjonen av Terminal-Bench, DeepSWE, databasemigrering, datamaskinbruk og langkontekstresultater gjør Astra spesielt relevant for ingeniørarbeid i repositorie-skala. Et nyttig distribusjonsmønster er å gi Astra et begrenset utviklingsmiljø, et issue- eller migrasjonsmål, tester og verktøytilgang; evaluer deretter suksess på kvaliteten på sammenslåtte oppgaver, antall mislykkede iterasjoner, tid til menneskelig gjennomgang og totalkostnad. Dette er en bedre produksjonsmetrikk enn en enkelt kodingsbenchmark-score.
GPT-6 Astras begrensninger
- Premium per-token-pris. Astra koster 2,5× GPT-5.6 Sol per token ved Standard kortkontekst-prising, så rutinechat, klassifisering, ekstraksjon og enkel utkastskriving er ofte lite økonomisk.
- Lang kontekst har et påslag. Forespørsler med mer enn 272K input-tokens flyttes til høyere satser for hele forespørselen, så «1.05M kontekst» bør ikke tolkes som flatpris-minne.
- Ingen native lyd- eller videoinput i modellen. Astra aksepterer tekst og bilder og leverer tekst; Gemini 3.8 Flash er mer fleksibel når native lyd/video-forståelse er sentral for arbeidslasten.
- Ingen finjustering. Den offisielle modellsiden lister for øyeblikket finjustering som ikke støttet, så tilpasning er avhengig av prompting, verktøy, innhenting og arbeidsflytdesign.
- Cybersikkerhetsvern kan avbryte arbeidsflyter. OpenAI advarer eksplisitt om at ekstra sikkerhetssjekker kan pause eller stoppe legitimt arbeid i høyere-risiko-kontekster.
- Ikke en universell benchmark-vinner. Claude Fable 5.1 leder Astra på Artificial Analysis Intelligence Index og HLE-with-tools-tallene som er inkludert i OpenAIs egen lanseringssammenligning.
FAQs
Er GPT-6 Astra offisielt lansert?
Ja. OpenAI begynte utrullingen 3. september 2026. Tilgjengeligheten rulles ut trinnvis på tvers av organisasjoner, ChatGPT-betalplaner, API-tilgang og AWS, i stedet for å dukke opp for alle kontoer samtidig.
Hva er GPT-6 Astras kontekstvindu?
Den offisielle modellsiden lister et 1.05M-tokens kontekstvindu og 128K-tokens maks utdata. Forespørsler over 272K input-tokens bruker langkontekst-prisingen.
Hvor mye koster GPT-6 Astra?
Standard kortkontekst-prising er $10 input / $50 output per million tokens, med $1 cached input og $12.50 cache writes. Langkontekst, Batch/Flex og Fast mode har andre satser, så produksjonsestimater bør bruke nivået som samsvarer med den faktiske forespørselen.
Er GPT-6 Astra bedre enn Claude Fable 5.1?
Det avhenger av arbeidslasten. Astra leder på flere datamaskinbruk-, kodingsagent-, vitenskap-, cyber- og profesjonelt-arbeids-evalueringer, mens Claude Fable 5.1 leder Astra på Artificial Analysis Intelligence Index og HLE with tools i OpenAIs publiserte sammenligning. Bruk dine egne agent-/oppgaveevalueringer i stedet for å anta at én modell dominerer alle kategorier.
Er GPT-6 Astra AGI?
OpenAIs offisielle produktsider beskriver Astra som en ny generasjon intelligens og deres mest kapable bredt distribuerte modell, men de definerer ikke produktet i seg selv som «AGI». Mettede benchmarker på noen oppgaver er ikke ekvivalent med en etablert, universell AGI-definisjon.
Konklusjon
GPT-6 Astra bør forstås som en utførelsesfokusert frontlinjemodell. Dens sterkeste bevis på fremgang er ikke den lille bevegelsen fra 60,9 til 61,2 kontra GPT-5.6 Sol på Artificial Analysis Intelligence Index; det er den langt større forbedringen i datamaskinbruk, agentbasert koding, vitenskapelige arbeidsflyter, langkontekst-henting, profesjonell oppgavefullføring og cybersikkerhet. 1.05M-kontekstvinduet og den dype verktøystakken gir utviklere mer rom til å bygge agenter som forblir nyttige utover ett enkelt svar.
Avveiingen er pris. $10/$50 Standard-prising er premium, langkontekst-forespørsler koster mer, og uavhengig testing viser at Astra kan være betydelig dyrere enn Sol på generell-intelligens-arbeidslaster. Modellen fortjener den premien når bedre fullføringsrater og lavere manuell korrigering oppveier tokenkostnad. For enklere eller høyvolums arbeidslaster forblir GPT-5.6, Claude Fable 5.1 og spesielt Gemini 3.8 Flash relevante alternativer snarere enn utdaterte forgjengere.