

TL;DR
Claude Opus 5.5 to mocny kandydat startowy, ponieważ oferuje znacząco niższe ceny tokenów przy zachowaniu lub przekroczeniu wyników Claude Fable 5.1 w kilku opublikowanych ewaluacjach, kosztując $4 za milion tokenów wejściowych i $20 za milion tokenów wyjściowych, podczas gdy Fable 5.1 kosztuje odpowiednio $10 i $50.
Fable 5.1 nadal ma zastosowanie, gdy zadanie jest wyjątkowo trudne, długotrwałe, kosztowne w ponownych próbach lub ma działać bez ścisłego nadzoru. Zasada praktyczna jest prosta: zacznij od Opus 5.5, a następnie eskaluj tylko wtedy, gdy reprezentatywne testy produkcyjne pokażą, że Fable 5.1 zmniejsza koszty błędów, poprawek lub ponowień na tyle, by uzasadnić swoją wyższą cenę.
Claude Opus 5.5 vs Claude Fable 5.1 w skrócie
| Wymiar | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Data wydania | Sep. 22, 2026 | Sep. 1, 2026 |
| Identyfikator modelu API | claude-opus-5-5 | claude-fable-5-1 |
| Kontekst / maks. wynik | 1M / 128K | 1M / 128K |
| Wejście/wyjście na MTok | $4 / $20 | $10 / $50 |
| Odczyt cache na MTok | $0.20 | $0.25 |
| Terminal-Bench 4.0 | 66.4% | 55.8% |
| FrontierCode v1.1 | 54.4% | 50.3% |
| CursorBench 4.0 | 57.8% | 51.8% |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo |
| Migracja HAProxy z C do Rust | 9.5 hours; 51% lower task cost | 12 hours; baseline task cost |
| Opcja szybkości | Fast mode, up to 2.5× normal speed | Brak równoważnego trybu startowego |
| Początkowy poziom wysiłku | Średni | Wysoki |
| Najlepsze domyślne użycie | Codzienne frontier coding, agenci, nadzorowana produkcja i duży wolumen ruchu API | Największa wartość, trudne, długotrwałe lub nienadzorowane prace |
| Dostęp przez API | Anthropic API i zgodni dostawcy, w tym CometAPI | Anthropic API i zgodni dostawcy, w tym CometAPI |
Uwaga do lektury: Wyniki benchmarków pochodzą z publikacji Anthropic i zależą od poziomu wysiłku, harnessa, zabezpieczeń, wydania zadań, liczby prób oraz błędu standardowego. Należy je porównywać wyłącznie przy dopasowanych warunkach ewaluacji.
Najważniejsze wnioski
- Standardowe stawki wejścia/wyjścia Opus 5.5 są o 60% niższe niż w Fable 5.1.
- Oba modele obsługują okno kontekstu 1M tokenów i do 128K wyjścia, dlatego większe znaczenie mają koszty, ustawienia wysiłku i dopasowanie do obciążenia niż nominalny rozmiar kontekstu.
- Opublikowane wyniki Anthropic faworyzują Opus 5.5 w wielu ewaluacjach kodowania i agentów, ale ustawienia benchmarków istotnie wpływają na rezultat.
- Niezależne ewaluacje potwierdzają pozycję Opus 5.5 w czołówce, raportując inne wartości bezwzględne, co wzmacnia potrzebę dopasowanych testów.
- Dla większości nadzorowanych zastosowań produkcyjnych Opus 5.5 jest lepszym punktem startowym. Fable 5.1 to poziom eskalacji, a nie automatyczny domyślny wybór.
Czym jest Claude Opus 5.5?
Claude Opus 5.5 to pierwszy model Claude 5.5 firmy Anthropic. Pozycjonowany jest do agentowego kodowania, długo działających agentów, profesjonalnej pracy wiedzochłonnej, przepływów w przedsiębiorstwie, analizy finansowej, wizji i obsługi komputera.
Jego identyfikator modelu w API to claude-opus-5-5. Adaptive thinking jest zawsze włączone, a programiści kontrolują intensywność rozumowania poprzez ustawienia wysiłku: low, medium, high, xhigh i max. Anthropic oferuje też Fast mode, który może działać do 2,5 razy szybciej niż normalnie za $8/M wejścia i $40/M wyjścia.
Czym jest Claude Fable 5.1?
Claude Fable 5.1 jest pozycjonowany do wymagających, długotrwałych projektów, takich jak wielogodzinne kodowanie, złożone badania, interakcja z przeglądarką, autonomiczni agenci i przepływy obejmujące wiele aplikacji.
Jego identyfikator modelu w API to claude-fable-5-1. Wykorzystuje adaptive thinking, startuje od wyższego ustawienia wysiłku w API i najlepiej traktować go jako opcję premium, gdy oczekiwany koszt błędu lub powtórzeń przewyższa dodatkowy koszt inferencji.
Uproszczone odczytanie byłoby takie, że Opus 5.5 oferuje niemal ten sam zakres za 40% standardowej ceny tokenów Fable. I właśnie tutaj prosta tabela specyfikacji bywa myląca.
Porównanie kodu i benchmarków
Anthropic podaje, że Opus 5.5 wyprzedza Fable 5.1 w Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam z narzędziami, Terminal-Bench-Science, OSWorld 2.0 i Chartography.
Jak czytać wyniki benchmarków
Anthropic podaje, że Opus 5.5 wyprzedza Fable 5.1 w Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity's Last Exam z narzędziami, Terminal-Bench-Science, OSWorld 2.0 i Chartography. Są to wyniki ewaluacji, a nie stałe modelu niezależne od konfiguracji.
Większość wyników Opus 5.5 w nagłówkach korzystała z max effort, a Terminal-Bench 4.0 używał xhigh effort. Projekt harnessa, konfiguracja narzędzi, zabezpieczenia, liczba prób, błąd standardowy, zachowania awaryjne i limity kosztów mogą zmieniać rezultat. Sam Anthropic zastrzega, że marginesy benchmarków mogą zawyżać praktyczną różnicę między modelami czołowymi.
Wydajność w kodowaniu
| Benchmark | Claude Opus 5.5 | Claude Fable 5.1 | Interpretacja |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | Zgłaszana przewaga 10,6 pkt w zadaniach agentowych w terminalu |
| FrontierCode v1.1 | 54.4% max; 54.6% medium | 50.3% | Medium w Opus 5.5 pozostaje konkurencyjne dla ekonomiki produkcji |
| CursorBench 4.0 | 57.8% max; 52.5% medium | 51.8% | Medium nieznacznie przewyższa zgłoszony wynik Fable |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo | Zgłaszana przewaga w profesjonalnej pracy agentowej |
To są wyniki benchmarków zgłaszane przez Anthropic. Tabelę należy czytać łącznie z zastrzeżeniami dotyczącymi ustawień ewaluacji w kolejnych sekcjach oraz z oficjalną stroną modelu Claude Opus.
Pierwsze trzy wyniki wyróżniają się, ponieważ dotyczą obciążenia, w którym znaczenie komercyjne Claude rośnie: agenci do inżynierii oprogramowania. Terminal-Bench 4.0 pokazuje bezwzględną różnicę 10,6 punktu procentowego; FrontierCode — 4,1 punktu; CursorBench 4.0 — 6 punktów.
GDPval-AA, który mierzy profesjonalną pracę agentową, raportuje również 1846 Elo dla Opus 5.5 wobec 1735 dla Fable 5.1. Gdyby te liczby były całym obrazem, hierarchia produktów wyglądałaby na odwróconą. To nie jest takie proste.
Niezależna ewaluacja
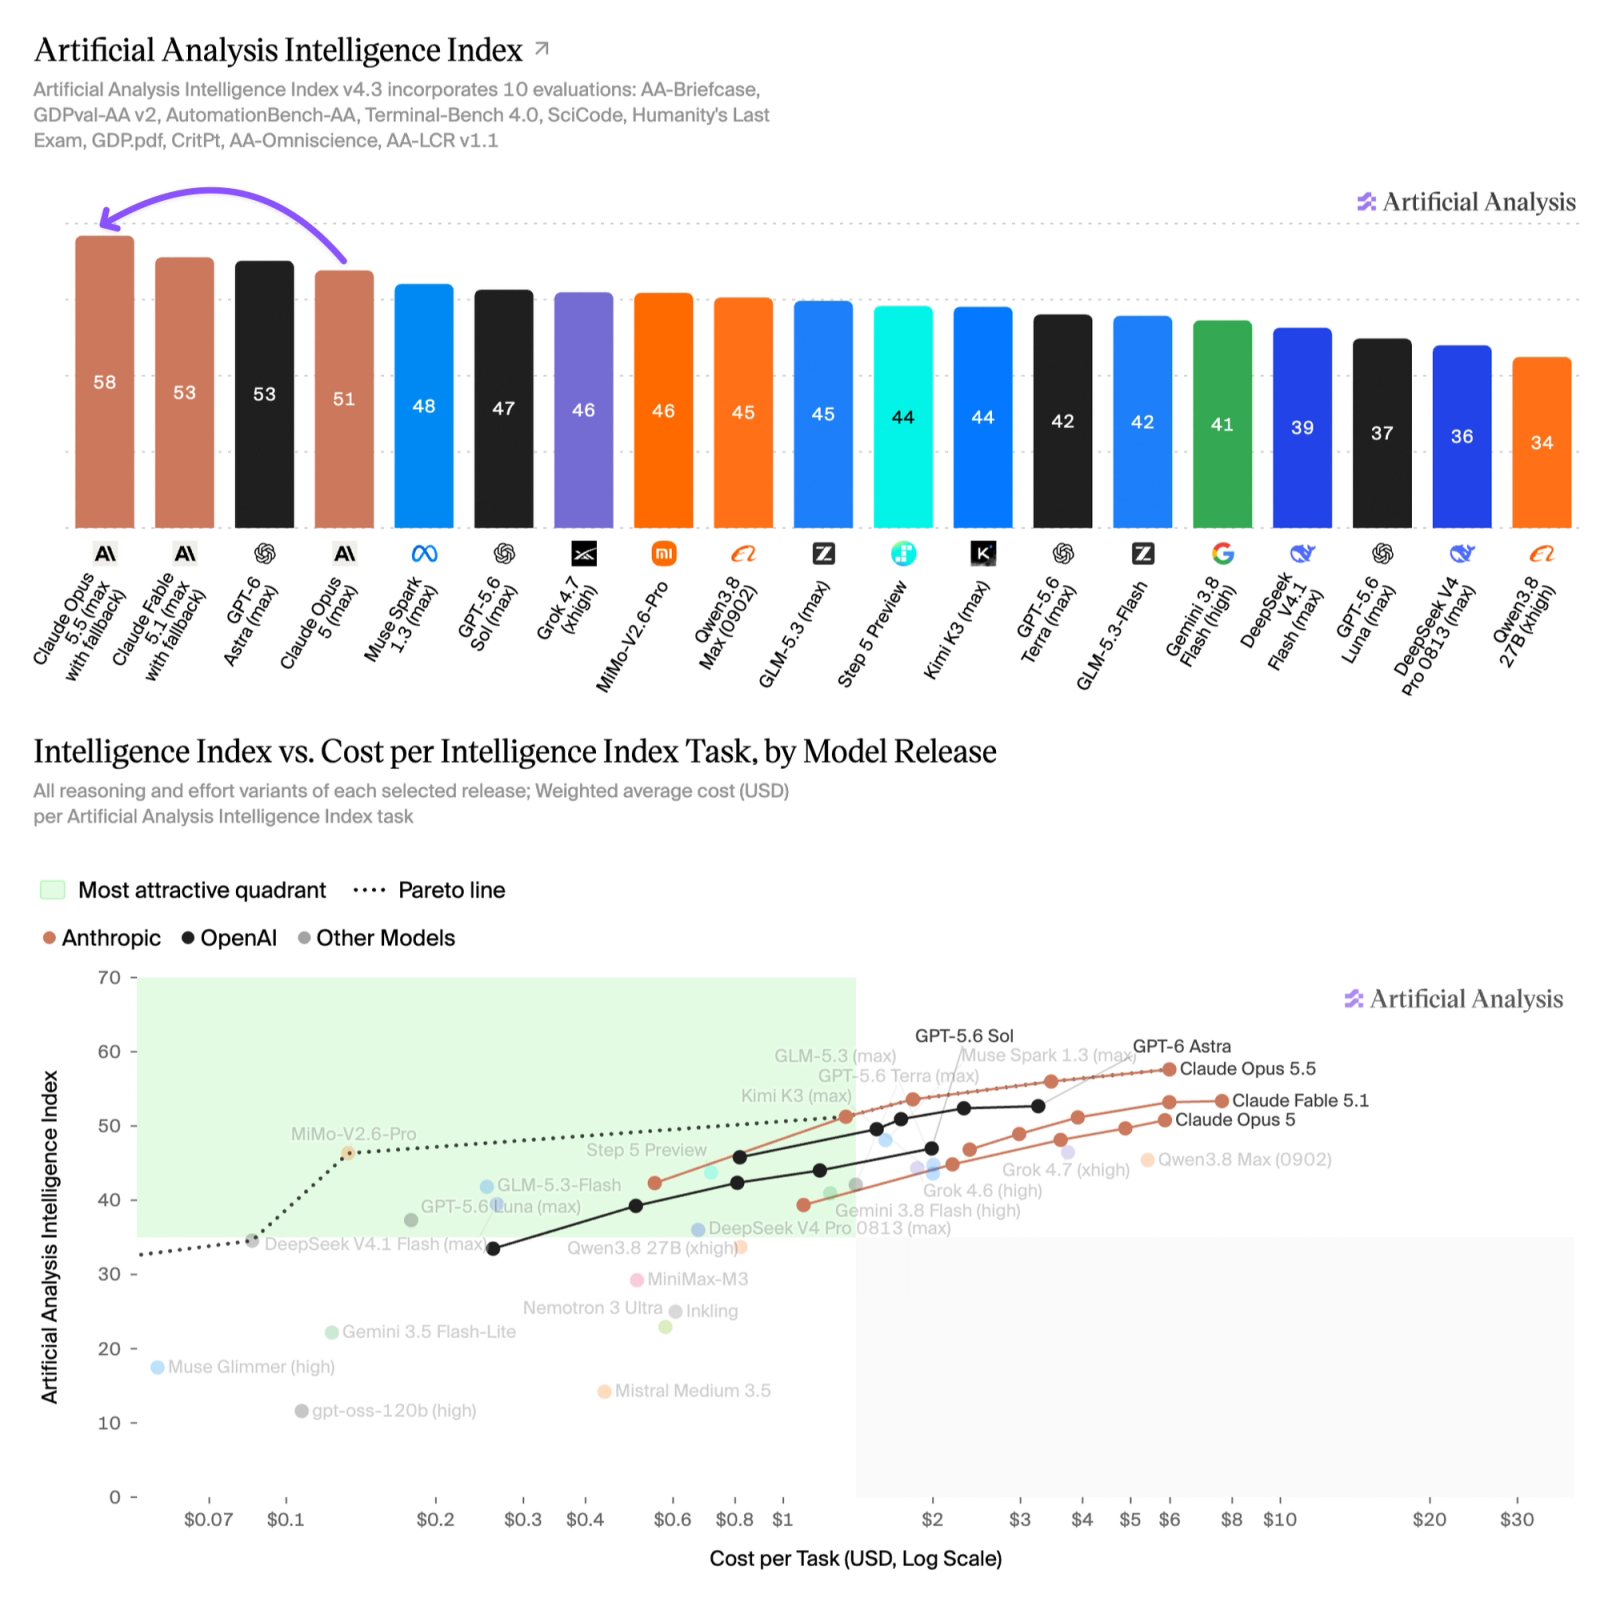
Artificial Analysis umieścił Opus 5.5 Max na poziomie 58 w swoim Intelligence Index i zgłosił mocne wyniki w AA-Briefcase, GDPval-AA, AutomationBench-AA, Terminal-Bench 4.0, SciCode i Humanity's Last Exam. Jego wynik w Terminal-Bench 4.0 wyniósł 59.6%, poniżej 66.4% Anthropic, co pokazuje, dlaczego zespoły powinny dokumentować wersję modelu, poziom wysiłku, harness, narzędzia, liczbę prób i limit kosztów, gdy wyniki się różnią.
Porównanie cen i kosztu ukończenia zadania
CometAPI oferuje ceny tokenów niższe niż stawki oficjalne, pozwalając programistom osiągnąć taką samą wydajność jak w oficjalnym API, używając standardowego formatu zapytań wiadomości.
Cennik tokenów
| Cennik | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Wejście | $4 | $10 |
| Wyjście | $20 | $50 |
| Zapis cache 5-min | $5 | $12.50 |
| Zapis cache 1 godz. | $8 | $20 |
| Odczyt cache | $0.20 | $0.25 |
| Batch wej./wyj. | 50% zniżki | 50% zniżki |
Załóżmy, że obciążenie zużywa 10 milionów świeżych tokenów wejściowych i 2 miliony tokenów wyjściowych. Bez efektów cache:
10 × $4 + 2 × $20 = $80
10 × $10 + 2 × $50 = $200
W tych założeniach Opus 5.5 kosztuje o 60% mniej. Jednak nie należy mylić tej liczby z oświadczeniem Anthropic, że Opus 5.5 kosztuje około 40% mniej w uruchomieniu niż Opus 5.
To dwie zupełnie różne porównania. Wartość 40% obejmuje niższe ceny poziomu Opus 5.5 oraz mniejsze zużycie tokenów na zadanie względem Opus 5. Wartość 60% wynika bezpośrednio z porównania standardowych cen katalogowych Opus 5.5 i Fable 5.1.
Koszt na ukończone zadanie
API modelu w rzeczywistości nie sprzedaje tokenów. Programiści kupują ukończoną pracę.
Zespół programistyczny nie dba o to, że model zużył 6.2 miliona tokenów. Obchodzi go, czy model naprawił błąd, ukończył migrację, przeszedł zestaw testów lub zakończył zadanie badawcze.
Anthropic podkreśla to w analizie What a task costs on Opus 5.5: dwa modele o podobnych cenach mogą mieć bardzo różny koszt zadania, jeśli jeden potrzebuje więcej tur, częściej odczytuje kontekst, częściej ponawia próby lub generuje więcej tokenów myślenia.
Task Cost = Fresh Input Cost
          + Cache Read Cost
          + Cache Write Cost
          + Output / Thinking Cost
          + Retry Cost
Ten ostatni element jest często pomijany. Tańszy model, który dwukrotnie zawiedzie, może okazać się droższy niż droższy model, który ukończy zadanie za pierwszym razem. Podobnie, ustawienie wysokiego wysiłku, które uniknie dziesięciu tur powtórzeń, może faktycznie obniżyć całkowity koszt.
Ekonomia buforowania promptów
Agenci z intensywnym cache wielokrotnie wykorzystują definicje narzędzi, kontekst repozytorium, instrukcje systemowe, historię rozmowy i wyniki testów. Ponieważ cena odczytu cache wynosi $0.20/M dla Opus 5.5 i $0.25/M dla Fable 5.1, różnica jest znacznie mniejsza niż $6/M w cenach świeżego wejścia. Zespoły powinny zatem osobno śledzić świeże wejście, odczyty cache, zapisy cache, wyjście, tury narzędzi i ponowienia.
Ekonomia poziomu wysiłku
Potencjalnie tak. Artificial Analysis przetestował pięć ustawień wysiłku Opus 5.5 i znalazł wyraźną krzywą możliwości względem kosztu.
| Wysiłek w Opus 5.5 | Artificial Analysis Intelligence Index | Koszt na zadanie w Index |
|---|---|---|
| Low | 42 | $0.55 |
| Medium | 51 | $1.34 |
| High | 54 | $1.82 |
| Xhigh | 56 | $3.46 |
| Max | 58 | $5.98 |
Poziom medium to rozsądny punkt startowy dla rutynowych zmian w kodzie, znanych refaktoryzacji i nadzorowanego debugowania. High lub xhigh mogą być uzasadnione przy niejednoznacznych awariach systemu, nocnych migracjach lub zadaniach, w których zły plan generuje duże prace naprawcze.
Porównanie bezpieczeństwa i niezawodności
Żadnego modelu nie należy nazywać bezpieczniejszym wyłącznie na podstawie benchmarków możliwości. Obronne porównanie wymaga dopasowanych promptów, narzędzi, uprawnień, ustawień wysiłku, limitów ponowień i kryteriów akceptacji. Wyższe możliwości mogą zmniejszać przypadkowe błędy, ale większa autonomia i dłuższe wykonanie zwiększają wpływ złego planu, prompt injection, niebezpiecznego wywołania narzędzia lub niezauważonego dryfu.
| Wymiar bezpieczeństwa | Porównanie praktyczne | Kontrola produkcyjna |
|---|---|---|
| Rozumowanie i wysiłek | Opus 5.5 udostępnia wiele poziomów wysiłku, podczas gdy Fable 5.1 zaczyna z wyższego pułapu wysiłku. Więcej rozumowania nie zastępuje egzekwowania polityk. | Ustal politykę wysiłku per obciążenie i ponownie testuj zachowania bezpieczeństwa przy każdej zmianie. |
| Długo działająca autonomia | Fable 5.1 jest pozycjonowany do trudnych, nienadzorowanych zadań; Opus 5.5 również wspiera agentowe przepływy pracy. Ryzyko rośnie wraz z czasem, uprawnieniami i nieodwracalnymi akcjami. | Stosuj checkpointy, bramki zatwierdzania, limity czasu i kosztów oraz automatyczne warunki wycofania lub zatrzymania. |
| Narzędzia i użycie komputera | Oba modele mogą obsługiwać narzędzia, więc sam wybór modelu nie kontroluje ekspozycji danych ani destrukcyjnych działań. | Stosuj zasadę najmniejszych uprawnień, listy dozwolonych, sandboxing, izolację sekretów i potwierdzenia przed zewnętrznymi lub nieodwracalnymi akcjami. |
| Ewaluacja i audytowalność | Publiczne wyniki benchmarków nie dowodzą jakości odmów, odporności na prompt-injection ani wskaźników incydentów produkcyjnych. | Loguj wywołania narzędzi i decyzje polityczne; mierz wskaźniki unsafe-compliance, fałszywych odmów, skuteczności iniekcji, wycieku sekretów, prób szkód i jakości odzysku. |
Praktyczna zasada bezpieczeństwa: zacznij od konfiguracji Opus 5.5 z najmniejszym niezbędnym przywilejem, która spełnia zadanie, a eskaluj do Fable 5.1 dopiero po przejściu tego samego zestawu testów bezpieczeństwa. W przepływach o wysokim wpływie wymagaj aprobaty człowieka niezależnie od tego, który model wypada lepiej w testach możliwości.
- Przeprowadź adwersarialne testy prompt-injection i exfiltracji danych z użyciem realnego zestawu narzędzi produkcyjnych.
- Rozdziel uprawnienia do odczytu, zapisu, publikacji, usuwania i finansów, zamiast nadawać jedną szeroką rolę narzędziową.
- Zdefiniuj wyzwalacze wycofania dla naruszeń polityk, powtarzających się awarii narzędzi, nieoczekiwanego rozszerzenia zakresu i przekroczeń kosztów.
- Rewaliduj po zmianie modelu, promptu systemowego, wysiłku, narzędzi, uprawnień lub trasowania.
Jak wybierać między Opus 5.5 a Fable 5.1
| Obciążenie | Rekomendowany punkt startowy | Warunek eskalacji |
|---|---|---|
| Codzienne kodowanie i code review | Opus 5.5, medium | Eskaluj tylko w wyjątkowo trudnych lub wysokiego ryzyka przypadkach |
| Prace nad funkcją w wielu plikach | Opus 5.5, medium lub high | Użyj Fable, gdy koszty dominują powtarzające się porażki planowania |
| Migracja w całym repozytorium | Najpierw testuj Opus 5.5 high lub xhigh | Eskaluj dla najtrudniejszych projektów bez nadzoru |
| Nocne autonomiczne przebiegi | Opus 5.5 z rygorystycznymi checkpointami | Preferuj Fable, gdy koszt błędnego kierunku jest skrajnie wysoki |
| Duży wolumen ruchu API | Opus 5.5 | Eskaluj tylko tę mniejszość zadań, które często zawodzą |
| Istniejące wdrożenie Fable | Utrzymaj obecne wdrożenie podczas testów | Przełącz dopiero po spełnieniu tych samych progów akceptacji |
Praktyczny test produkcyjny
Uruchom te same reprezentatywne zadania, prompty, narzędzia, politykę wysiłku, kryteria akceptacji i limity ponowień na obu modelach. Zapisz odsetek zaakceptowanych zadań, opóźnienie, świeże i buforowane wejście, tokeny wyjściowe i myślenia, wywołania narzędzi, ponowienia, korekty człowieka i całkowity koszt na zaakceptowany wynik. Uwzględnij zadania rutynowe oraz trudne przypadki błędów.
Wytyczne migracji dla obecnych użytkowników Claude Opus 5
Obecni użytkownicy Opus 5 powinni traktować Opus 5.5 jako następcę, a nie zakładać, że podmiana identyfikatora modelu jest wolna od ryzyka. Porównaj głębokość planowania, wzorce wywołań narzędzi, długość odpowiedzi, zgodność z formatem, opóźnienie, zachowanie cache promptów, odzysk po nieudanych wywołaniach narzędzi, trasowanie bezpieczeństwa oraz koszt ukończenia zadania. Utrzymuj kryteria wycofania i dotychczasowy model dostępny, dopóki Opus 5.5 nie przejdzie testów zbliżonych do produkcyjnych.
Obecni użytkownicy Fable 5.1 nie potrzebują ogólnej sekcji migracji. Powinni traktować Opus 5.5 jako kandydat do optymalizacji i oceniać go według tych samych kryteriów akceptacji produkcyjnej przed zmianą zweryfikowanego wdrożenia.
Dostęp przez CometAPI
Programiści oceniający oba modele mogą zapoznać się z przewodnikami CometAPI dotyczącymi Claude Opus 5.5 i Claude Fable 5.1. Integrując przez dowolnego zgodnego dostawcę API, potwierdź dokładny identyfikator modelu, wspierane parametry wysiłku, zachowanie cache, limity przepustowości, dostępność regionalną i aktualne ceny przed wdrożeniem produkcyjnym.
Używaj claude-opus-5-5 dla Opus 5.5 i claude-fable-5-1 dla Fable 5.1 tam, gdzie identyfikatory są wspierane. Unikaj cichego kierowania obu klas obciążeń przez jeden stały poziom wysiłku; wybór modelu i polityka wysiłku powinny być konfigurowane niezależnie.
Python — Anthropic Messages API przez CometAPI
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",)

message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user","content": ("Analyze this codebase and propose a safe migration plan."),}],)print(message.content[0].text)
Wnioski
Claude Opus 5.5 przesuwa praktyczną granicę między codziennym modelem czołowym Anthropic a jego premiowym poziomem eskalacji. Jest znacząco tańszy przy standardowych stawkach tokenów, prowadzi w wielu opublikowanych benchmarkach kodowania i agentów oraz oferuje na tyle elastyczne poziomy wysiłku, by pokryć szeroki zakres produkcyjny.
Claude Fable 5.1 pozostaje istotny, gdy zadanie jest trudne, wysokowartościowe, długotrwałe lub nienadzorowane, a koszt błędu przewyższa wyższy rachunek za inferencję. Dla większości zespołów najlepszą polityką jest start z Opus 5.5, pomiar wyników ukończonych zadań i selektywna eskalacja.
FAQ
Jak zaprojektować produkcyjny test A/B dla Opus 5.5 i Fable 5.1?
Używaj tych samych reprezentatywnych zadań, promptów, narzędzi, polityki wysiłku, kryteriów akceptacji i limitów ponowień dla obu modeli. Zapisuj odsetek zaakceptowanych zadań, opóźnienie, świeże i buforowane wejście, tokeny wyjściowe i myślenia, wywołania narzędzi, ponowienia, korekty człowieka i całkowity koszt na zaakceptowany wynik. Uruchom wystarczającą liczbę zadań, aby uchwycić pracę rutynową oraz trudne przypadki błędów.
Kiedy niższe ceny tokenów mogą nie obniżyć całkowitego kosztu zadania?
Tańszy model może nadal kosztować więcej, jeśli wymaga dodatkowych tur, częściej odczytuje kontekst, generuje więcej tokenów myślenia lub wymaga powtarzanych prób. Znaczenie ma też zachowanie cache: różnica w cenie wejścia maleje w długich sesjach zdominowanych przez odczyty cache. Porównuj koszt ukończenia zadania, a nie tylko ceny katalogowe.
Co należy dokumentować, gdy wyniki benchmarków się nie zgadzają?
Zapisuj wersję modelu, poziom wysiłku, harness, ustawienia awaryjne i bezpieczeństwa, liczbę prób, wydanie zestawu zadań, błąd standardowy i limit kosztów. Oznacz każdy wynik jako oficjalny lub niezależny i unikaj łączenia wyników z niedopasowanych konfiguracji w jednym rankingu.
Jakie ryzyka migracji powinni monitorować obecni użytkownicy Fable 5.1?
Obserwuj zmiany w głębokości planowania, wzorcach wywołań narzędzi, długości odpowiedzi, zgodności formatu, opóźnieniu, zachowaniu cache promptów, odzyskiwaniu po awariach narzędzi i trasowaniu bezpieczeństwa. Utrzymuj obecne wdrożenie dostępne podczas oceny, ustal kryteria wycofania i migruj dopiero po tym, jak Opus 5.5 spełni te same progi akceptacji w zadaniach zbliżonych do produkcyjnych.
SEO Metadata
Meta title: Claude Opus 5.5 vs Fable 5.1: Kod, koszty i benchmarki
Meta description: Compare Claude Opus 5.5 and Claude Fable 5.1 across coding benchmarks, API pricing, speed, caching, effort settings, complete-task cost, and workload fit.
Keywords: Claude Opus 5.5 vs Claude Fable 5.1, Claude Opus 5.5, Claude Fable 5.1, benchmarki kodowania Claude, ceny Claude API, CometAPI, modele AI do kodowania
URL slug: claude-opus-5-5-vs-claude-fable-5-1