
TL;DR
Claude Opus 5.5 i Claude Sonnet 5.5 oferują kontekst 1M i standardowe maksymalne wyjście 128K, obsługują wejście tekst+obraz oraz mają ograniczenie wiedzy do czerwca 2026. Opus jest przeznaczony do złożonej, otwartej pracy; Sonnet celuje w szybszą realizację dobrze zdefiniowanych codziennych zadań.
Przy standardowych stawkach API Anthropic, Sonnet 5.5 kosztuje $2/M za wejście i $10/M za wyjście, dokładnie połowę stawek Opus 5.5: $4/M za wejście i $20/M za wyjście. Kilka opublikowanych wyników jest zbliżonych, ale ranking różni się w zależności od benchmarku. Opus uzyskuje wyższe wyniki w CursorBench, podczas gdy Sonnet wypada lepiej w Terminal-Bench. Wyniki te używają różnych ustawień wysiłku i nie powinny być traktowane jako kontrolowany test bezpośredni.
Wybierz model, który spełnia Twoje wymagania jakości i opóźnienia przy najniższym całkowitym koszcie zadania. Zespoły powinny porównać koszt na zaakceptowane zadanie, latencję, zachowanie wywołań narzędzi, ponowienia oraz ilość wymaganej oceny, zanim zdecydują, gdzie Opus uzasadnia swoją premię.
Najważniejsze wnioski
- Cena: Sonnet 5.5 kosztuje połowę standardowej ceny za wejście/wyjście w porównaniu z Opus 5.5.
- Specyfikacja: Oba wspierają okno kontekstowe 1M tokenów i do 128K standardowego wyjścia.
- Kodowanie: Opus prowadzi w FrontierCode i CursorBench, podczas gdy Sonnet ma wyższy opublikowany wynik w Terminal-Bench 4.0.
- Praca wiedzochłonna: Opus zachowuje niewielką przewagę w GDPval-AA i AA-Briefcase.
- Wdrożenie: Testuj szybszego Sonnet do zawężonej realizacji i Opus do złożonej eskalacji; waliduj oba względem celów jakości, latencji i kosztów.
Claude Opus 5.5 vs Sonnet 5.5 w skrócie
| Czynnik decyzyjny | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Kontekst / maks. standardowe wyjście | 1M / 128K | 1M / 128K |
| Modalności wejścia/wyjścia | Tekst + obraz -> tekst | Tekst + obraz -> tekst |
| Rozumowanie | Myślenie adaptacyjne, zawsze włączone | Myślenie adaptacyjne |
| Domyślny poziom wysiłku na platformie Claude | Średni | Wysoki |
| Oficjalna cena za wejście/wyjście | $4 / $20 per 1M | $2 / $10 per 1M |
| Odczyt z pamięci podręcznej | $0.20 / 1M | $0.10 / 1M |
| Porównawcza latencja | Umiarkowana | Szybka |
| Wyróżnik w kodowaniu | FrontierCode 54.4%; CursorBench 57.8% | Terminal-Bench 70.6%; CursorBench 55.5% |
| Wyróżnik w pracy wiedzochłonnej | GDPval-AA 1846 | GDPval-AA 1844 |
| Główny obszar zastosowania | Złożona, niejednoznaczna, długotrwała praca | Szybka, zawężona, powtarzalna praca produkcyjna |
Claude Opus 5.5
Claude Opus 5.5 został wydany 22 września 2026 jako pierwszy model z rodziny Claude 5.5 Anthropic. Anthropic pozycjonuje go do zaawansowanego kodowania, złożonych agentów, profesjonalnej pracy wiedzochłonnej i długotrwałych przepływów, gdzie zachowanie intencji przez wiele kroków jest ważniejsze niż minimalna latencja.
Jego najbardziej wyróżniającym zachowaniem operacyjnym jest zawsze aktywne myślenie adaptacyjne. Programiści mogą kontrolować wysiłek rozumowania, ale samego myślenia adaptacyjnego nie można wyłączyć. To sprawia, że testy migracyjne są ważne dla starszych agentów, które wcześniej polegały na ścieżce z wyłączonym myśleniem lub innych domyślnych ustawieniach wysiłku.
API Claude Opus 5.5 w CometAPI zapewnia ujednoliconą trasę dla tego samego ID modelu, claude-opus-5-5, wraz z innymi modelami do trasowania obciążeń.
Claude Sonnet 5.5
Claude Sonnet 5.5 został wydany 28 września 2026 jako drugi model z rodziny Claude 5.5. Anthropic opisuje go jako szybszy, tańszy komplement dla Opus 5.5 do dobrze zdefiniowanej codziennej pracy, w tym naprawy błędów, tworzenia dokumentów, kodowania, agentów i zadań zorientowanych na projektowanie.
Anthropic raportuje, że Sonnet 5.5 generuje wyjście ponad 30% szybciej niż Sonnet 5 i może kosztować do 30% mniej na zadanie niż jego poprzednik. To porównania zgłaszane przez dostawcę względem Sonnet 5, a nie zmierzone stosunki szybkości czy kosztu zadania względem Opus 5.5.
API Claude Sonnet 5.5 w CometAPI używa ID modelu claude-sonnet-5-5 i nadaje się do testowania Sonnet jako tańszej warstwy wykonawczej w aplikacjach mieszających modele.
Claude Opus 5.5 vs Sonnet 5.5: Wydajność
Opublikowane wyniki Anthropic pokazują niewielkie różnice w wynikach na kilku ewaluacjach pracy wiedzochłonnej i obsługi komputera. Opus raportuje wyższe wyniki w FrontierCode, CursorBench i Humanity’s Last Exam, podczas gdy Sonnet raportuje wyższy wynik w Terminal-Bench. Porównania zależą od ustawień wysiłku i warunków ewaluacji.
| Benchmark | Claude Opus 5.5 | Claude Sonnet 5.5 | Co mierzy |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 70.6% | Zadania agenta w wierszu poleceń |
| FrontierCode 1.1 Main | 54.4% | 46.2% (Max) | Inżynieria oprogramowania w realnych warunkach |
| CursorBench 4.0 | 57.8% | 55.5% | Niejasne zadania kodowania obejmujące wiele plików |
| GDPval-AA v2.1 | 1846 | 1844 | Profesjonalna praca wiedzochłonna |
| AA-Briefcase v1.1 | 1822 | 1811 | Długoterminowa praca wiedzochłonna |
| Humanity's Last Exam, tools | 67.7% | 64.5% | Wielodyscyplinarne rozumowanie |
| OSWorld 2.1 | 81.8% | 80.1% | Obsługa komputera |
| Chartography | 64.4% | 61.6% | Rozpoznawanie wizualnych wykresów |
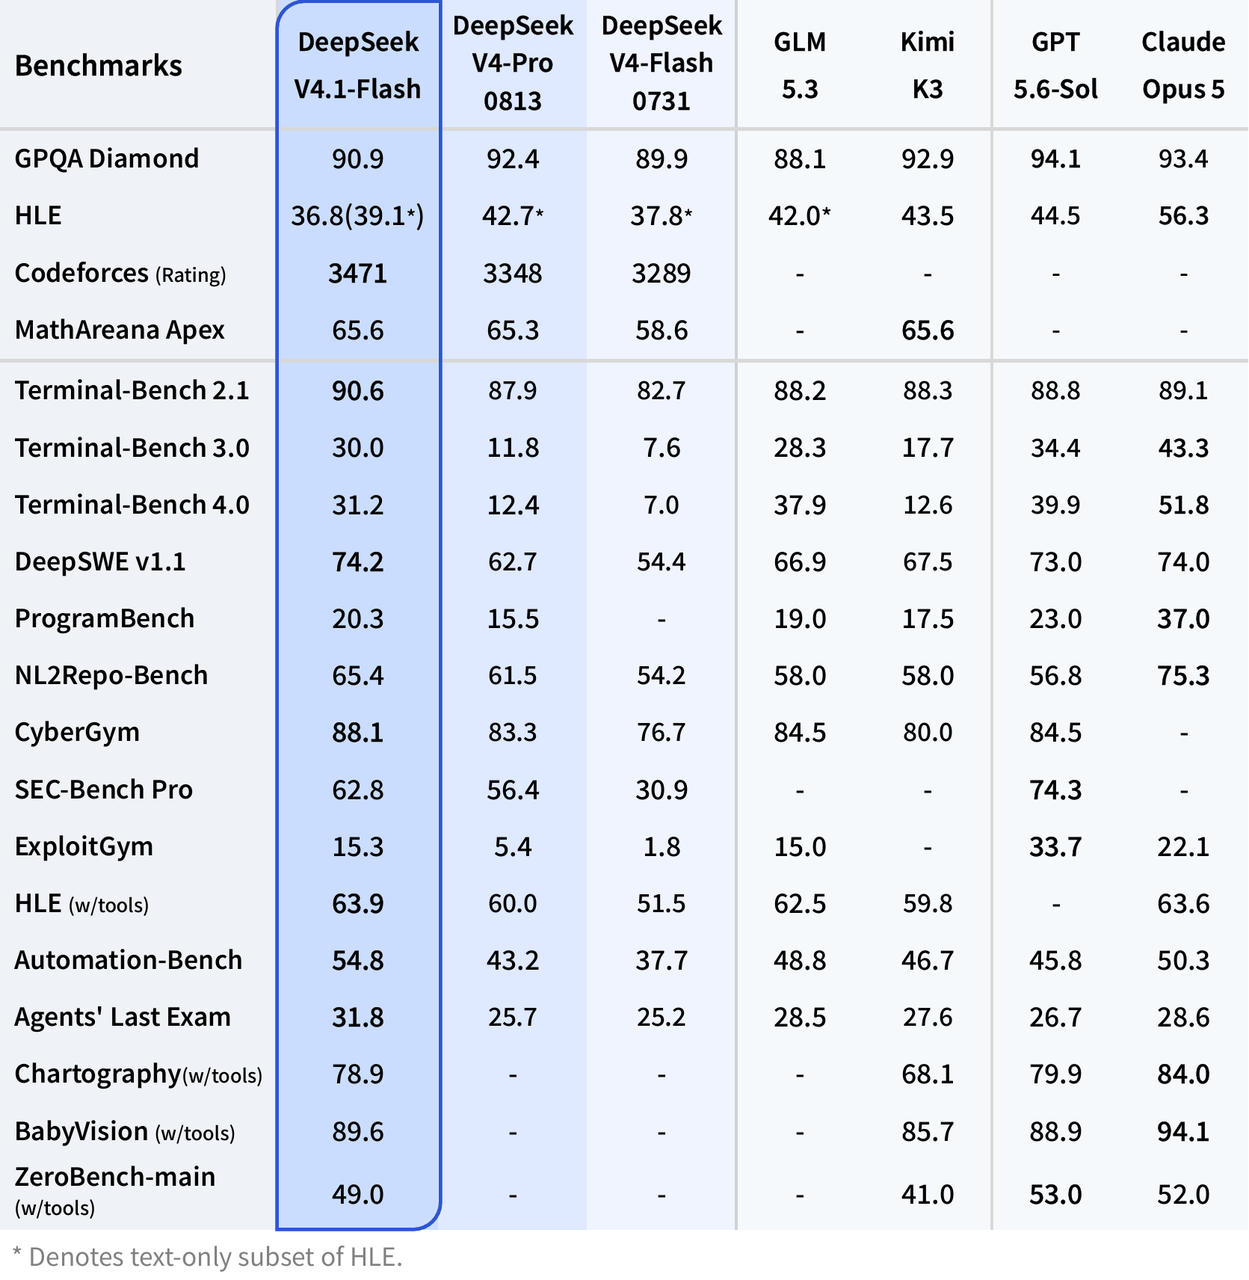
To są opublikowane wyniki, a nie kontrolowane porównanie przeprowadzone na potrzeby tego artykułu.
- Wysiłek: Wynik Opus w Terminal-Bench używa Xhigh. Wynik Sonnet w FrontierCode jest wyższy przy Xhigh niż przy Max.
- Punktacja i narzędzia: OSWorld używa częściowego zaliczania; wyniki Chartography tutaj są bez narzędzi.
- Wdrożenie: Wyniki Sonnet w GDPval-AA i AA-Briefcase mierzono na wdrożeniu przedpremierowym z błędem w strukturze wyjścia, który został później naprawiony.
Kodowanie agentowe
Wynik Sonnet 5.5 na poziomie 70.6% w Terminal-Bench 4.0 jest wyższy niż zgłoszony wynik Opus 5.5 66.4%, ale oficjalna adnotacja mówi, że wynik Opus jest przy wysiłku Xhigh. W FrontierCode 1.1 Main Opus prowadzi 54.4% do 46.2% wyniku Sonnet na Max; w CursorBench 4.0 Opus prowadzi 57.8% do 55.5%.
Ten podział ma znaczenie, ponieważ benchmarki agentów kodujących nagradzają różne zachowania. Terminal-Bench kładzie nacisk na skuteczną wieloetapową realizację w środowisku wiersza poleceń, podczas gdy CursorBench używa niejednoznacznych zadań wieloplikowych z rzeczywistych sesji kodowania. W ograniczonym kodowaniu i iteracyjnej realizacji Sonnet może być bardzo konkurencyjny; dla szerszej pracy w skali repozytorium Opus zachowuje silniejsze potwierdzenie w opublikowanych ewaluacjach Anthropic.
Praca wiedzochłonna i rozumowanie
W GDPval-AA v2.1 Sonnet 5.5 uzyskuje 1844, podczas gdy Opus 5.5 1846. W AA-Briefcase v1.1 różnica to 1811 vs 1822. Wyniki są godne uwagi, ponieważ różnica cenowa jest znacznie większa niż różnica w benchmarkach.
Anthropic wskazuje, że Opus 5.5 jest silniejszy w złożonej, otwartej pracy wymagającej trwałego osądu. Dla badań, architektury i audytów sprawdź, czy to zachowanie redukuje błędne decyzje lub korekty ludzkie w Twoich własnych zadaniach, zamiast wnioskować o przewadze ekonomicznej na podstawie niewielkich marginesów w benchmarkach.
Obsługa komputera i zadania wizualne
W OSWorld 2.1, przy częściowym zaliczaniu, Opus uzyskuje 81.8%, a Sonnet 80.1%. W Chartography bez narzędzi wyniki to odpowiednio 64.4% i 61.6%. Dla agentów przeglądarkowych lub GUI sugeruje to, że latencja, wydajność wywołań narzędzi i koszt na poziomie zadania mogą być równie istotne jak różnica w nagłówkowych benchmarkach.
Interpretacja benchmarków
Narracja o benchmarkach nie jest taka, że Sonnet zastąpił Opus. Jest taka, że Anthropic na tyle zawęził lukę w możliwościach, iż kształt obciążenia ma teraz większe znaczenie niż sama klasa modelu. Dobrze zdefiniowane i wrażliwe na opóźnienia zadania coraz częściej faworyzują ekonomię Sonnet, podczas gdy niejednoznaczność, długie horyzonty i kosztowne tryby porażki pozostają najsilniejszymi powodami, by testować Opus.
Claude Opus 5.5 vs Sonnet 5.5: Cennik
Oficjalne ceny API Claude
Specyfikacja cen Opus i specyfikacja cen Sonnet rozróżniają standardowe stawki tokenów, okna retencji cache oraz zniżki Batch. Poniższe ceny są w USD za milion tokenów; osobno potwierdź opcjonalne modyfikatory usług.
| Metryka cenowa | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Wejście / 1M tokenów | $4.00 | $2.00 |
| Wyjście / 1M tokenów | $20.00 | $10.00 |
| Odczyt z pamięci podręcznej / 1M tokenów | $0.10 | $0.20 |
| Zapis do pamięci podręcznej (5 min) / 1M tokenów | $5.00 | $2.50 |
| Zapis do pamięci podręcznej (1 godz.) / 1M tokenów | $8.00 | $4.00 |
| Batch wejście / 1M tokenów | $2.00 | $1.00 |
| Batch wyjście / 1M tokenów | $10.00 | $5.00 |
Sonnet ma o połowę niższe standardowe stawki za wejście, wyjście i zapis do pamięci podręcznej.
Odczyty z pamięci podręcznej podążają za tym samym stosunkiem cen 2:1: Sonnet 5.5 kosztuje $0.10/M za zbuforowane wejście, podczas gdy Opus 5.5 kosztuje $0.20/M. Ponowne użycie zbuforowanych prefiksów redukuje koszty wejścia dla obu modeli, zachowując niższą stawkę Sonnet za token. Całkowite oszczędności zadania zależą nadal od długości wyjścia, zapisów cache, ponowień i współczynnika akceptacji.
Koszt na zaakceptowane zadanie
Dla prostego zobrazowania, żądanie ze 100K niebuforowanych tokenów wejścia i 10K tokenów wyjścia kosztuje około $0.60 na Opus 5.5 i $0.30 na Sonnet 5.5 przy standardowych stawkach. Jednak 2x różnica stawki za token nie gwarantuje 2x różnicy kosztu na sukces. Ponowienia, wywołania narzędzi, długość wyjścia, trafienia w cache, nieudane próby i korekty ludzkie mogą zmienić wynik.
Oceny produkcyjne powinny zatem rejestrować koszt na zaakceptowane zadanie obok współczynnika ukończenia, latencji p50/p95, ponowień, wywołań narzędzi i interwencji człowieka.
Cennik CometAPI
Katalog modeli CometAPI reklamuje 20% zniżki na wiele obsługiwanych tras Anthropic. Dla Claude Opus 5.5 API w CometAPI wspomniane ceny katalogowe to $3.20/M za wejście i $16/M za wyjście. Dla Claude Sonnet 5.5 API w CometAPI, zlokalizowane dane katalogowe pokazują $1.60/M za wejście i $8/M za wyjście. Ponieważ ceny bramy mogą się zmieniać, potwierdź działającą trasę modelu przed budżetowaniem ruchu produkcyjnego.
| Stawka CometAPI | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Wejście / 1M | $3.20 | $1.60 |
| Wyjście / 1M | $16.00 | $8.00 |
| Relatywny rabat vs oficjalny | 20% | 20% |
Claude Opus 5.5 vs Sonnet 5.5: Specyfikacje techniczne
Oba modele dzielą podstawowe limity kontekstu i wyjścia pokazane w tabeli „w skrócie”. Dodatkowy limit wyjścia 300K to możliwość wersji beta Batch API, a nie standardowy limit wyjścia interaktywnego.
Długość kontekstu nie jest czynnikiem różnicującym między tymi dwoma modelami. Oba wspierają to samo okno 1M tokenów i 128K standardowego wyjścia. Bardziej znaczące różnice dotyczą zachowania rozumowania, szybkości i ilości trudnego osądu wymaganego przez zadanie.
Raportowane przez Sonnet przyspieszenie generowania wyjścia odnosi się do Sonnet 5. Opus ma również Fast mode z przepustowością tokenów wyjściowych do 2.5x, wyceniony na $8/M za wejście i $40/M za wyjście. To zapowiedź badawcza w API Claude; nie jest to gwarancja 2.5x szybszych zadań end-to-end ani czasu do pierwszego tokena.
Ujawnienie architektury i zachowanie integracji
Przytoczone materiały nie ujawniają liczby parametrów ani wystarczających szczegółów wewnętrznej architektury, aby obronić porównanie modelu gęstego vs MoE. Zamiast tego porównuj udokumentowane interfejsy i zachowanie. Obie migracje wymagają testów ograniczeń wyboru narzędzi i zachowanego myślenia; myślenia adaptacyjnego w Opus nie można wyłączyć. Waliduj stan rozmowy podczas trasowania między modelami, zamiast przekazywać niejawne bloki myślenia bez sprawdzenia kompatybilności.
Claude Opus 5.5 vs Sonnet 5.5: Zastosowania
Praktyczna strategia wdrożeniowa to traktowanie Sonnet 5.5 jako domyślnego modelu wykonawczego, a Opus 5.5 jako modelu do eskalacji. Może to ograniczyć wydatki na dobrze określone, powtarzalne zadania, rezerwując Opus do pracy, która korzysta z trwałego osądu. Oszczędności zależą od współczynnika akceptacji Sonnet i tego, jak często zadania wymagają eskalacji.
Dobór na podstawie charakteru obciążenia
| Obciążenie/rodzaj pracy | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|
| Rutynowe kodowanie | Zdolny, wyższy koszt | Bardzo dobrze dopasowany |
| Naprawa błędów | Przydatny w trudnych przypadkach | Bardzo dobrze dopasowany |
| Ruch API o dużym wolumenie | Wyższy koszt jednostkowy | Bardzo dobrze dopasowany |
| Generowanie dokumentów / slajdów | Silny | Bardziej ekonomiczny |
| Sub-agenci do kodowania | Używać wybiórczo | Bardzo dobrze dopasowany |
| Migracja w skali repozytorium | Bardzo dobrze dopasowany | Testować dla ograniczonych zadań |
| Niejasna architektura | Bardzo dobrze dopasowany | Zależne od złożoności |
| Długotrwale autonomiczne agenty | Bardzo dobrze dopasowany | Dobra warstwa wykonawcza |
| Trudne badania / analiza | Bardzo dobrze dopasowany | Dobry dla ograniczonych zadań |
| UX wrażliwy na latencję | Umiarkowana | Bardzo dobrze dopasowany |
| Mieszane obciążenie produkcyjne | Model eskalacyjny | Domyślny model wykonawczy |
Praktyczny router może zaczynać od Sonnet i eskalować, gdy zadanie przekroczy próg niejednoznaczności, długości pętli narzędzi, powtarzających się niepowodzeń lub wpływu biznesowego. Zasada trasowania powinna być zwalidowana na zadaniach zbliżonych do produkcyjnych, a nie zakładana na podstawie wyników benchmarków.
Jak wywoływać Opus 5.5 i Sonnet 5.5 przez CometAPI
Utwórz klucz API CometAPI i skonfiguruj klienta kompatybilnego z Anthropic, aby używał punktu końcowego CometAPI. Wybierz ID modelu dla zadania, wyślij prompt przez Messages API i odczytaj odpowiedź tekstową. Porównując modele, zachowaj spójność promptu, limitu wyjścia, narzędzi i kryteriów akceptacji oraz zapisuj efektywny wysiłek rozumowania.
Przykład: Opus 5.5
Do przeglądu planu migracji wybierz claude-opus-5-5 i poproś model o zidentyfikowanie najbardziej ryzykownych kroków, wyjaśnienie ich wpływu i zasugerowanie zabezpieczeń. Wyślij żądanie przez Messages API CometAPI i przejrzyj zwrócony tekst.
Przykład: Sonnet 5.5
Dla tego samego przeglądu planu migracji wybierz claude-sonnet-5-5 i prześlij ten sam prompt oraz limit wyjścia przez CometAPI. Porównaj odpowiedź względem tych samych kryteriów akceptacji, a następnie zarejestruj latencję, ponowienia i rzeczywisty koszt, zanim zdecydujesz, który model pasuje do obciążenia.
Do trasowania produkcyjnego trzymaj oba ID modeli za tym samym interfejsem aplikacji i rejestruj jakość ukończenia, latencję, ponowienia oraz rzeczywisty naliczony koszt. Unikaj eskalacji wyłącznie dlatego, że prompt jest długi; niejednoznaczność i koszt porażki zwykle są lepszymi sygnałami.
Wnioski
Claude Opus 5.5 i Sonnet 5.5 mają teraz niemal ten sam zakres techniczny, więc wybór modelu coraz częściej dotyczy ekonomii i zachowania obciążenia, a nie rozmiaru kontekstu. Sonnet łączy szybsze wykonanie i o połowę tańsze standardowe tokeny z wydajnością w benchmarkach często zbliżoną do Opus.
Opus zyskuje na wartości wraz ze wzrostem niejednoznaczności, czasu trwania zadania i kosztu błędnej decyzji. Jego wartość wynika mniej z większego okna kontekstu, a bardziej z utrzymania osądu w trudnych, otwartych przepływach pracy.
Dla wielu zespołów produkcyjnych najbardziej efektywna architektura użyje obu: Sonnet do powtarzalnej większości pracy oraz Opus do podzbioru zadań, gdzie silniejsze rozumowanie mierzalnie redukuje porażki, ponowienia lub interwencję człowieka.
FAQ
Jak router dla Claude 5.5 powinien zapobiegać kosztownym pętlom eskalacji?
Ustaw maksymalną liczbę prób i budżet przed wykonaniem. Eskaluj po powtarzalnej porażce, brakujących dowodach lub bramce jakości specyficznej dla zadania, a nie po każdej niepewnej odpowiedzi. Rejestruj, która porażka wywołała Opus i czy poprawiła wynik akceptacji. Jeśli żaden model nie przechodzi, zwróć nierozwiązane zagadnienie do przeglądu zamiast próbować w nieskończoność.
Jak uczciwie porównać Opus i Sonnet na jednym typie pracy?
Użyj tego samego korpusu zadań, dostępnych narzędzi, materiału dowodowego wejścia, limitu wyjścia i rubryki oceny. Rejestruj efektywny wysiłek i testuj oddzielnie przebiegi na zimnym i ciepłym cache. Przeglądaj wyniki bez ujawniania modelu, gdy to praktyczne. Raportuj współczynnik akceptacji i całkowity koszt, w tym nieudane próby; równe ceny za tokeny lub jeden benchmark nie ustanawiają równej wartości.
Co należy zachować podczas przełączania modeli Claude 5.5 w trakcie zadania?
Zachowaj instrukcje użytkownika, istotne dowody, wyniki narzędzi i jawne podsumowanie postępu. Traktuj niejawny stan myślenia jako specyficzny dla modelu i rozmowy; nie zakładaj, że można go odtworzyć na różnych trasach. Przetestuj wspierane przez dostawcę przekazywanie przed produkcją, zwłaszcza jeśli przepływ miesza konta, bramy lub SDK.
Kiedy należy ponownie ocenić wybór modelu Claude 5.5?
Uruchom ponownie odpowiednie testy akceptacyjne po poprawce wdrożeniowej, zmianie trasowania, zmianie ceny, zmianie narzędzia lub istotnej aktualizacji promptu. Zachowaj wcześniejszy przebieg jako punkt odniesienia i zarejestruj datę, ID modelu, punkt końcowy, konfigurację i wersję harnessu. To odróżnia zmianę modelu od zmian w otaczającej aplikacji.