
TLDR: DeepSeek-V4.1-Flash-1017 to niewielka, lecz bardzo znacząca aktualizacja z 17 października 2026 dla modelu V4.1-Flash. Zapewnia lepsze wyniki w testach rozumowania, kodowania, zadań agentowych i wizualnych, jednocześnie generując krótsze odpowiedzi i szybciej kończąc zadania—przesuwając granicę Pareto wydajności względem kosztu.
Najważniejsze informacje
- DeepSeek-V4.1-Flash-1017 Wydany 17 października 2026 jako bezpłatna aktualizacja istniejącego punktu końcowego API
deepseek-flash—dla dotychczasowych użytkowników nie są wymagane żadne zmiany w kodzie. - Wzrosty raportowane przez dostawcę we wszystkich 11 wymienionych benchmarkach wobec wrześniowej V4.1-Flash, z największymi skokami w zadaniach agentowych i kodowaniu.
- Architektura: Mixture‑of‑Experts o 552B parametrów z projektem Causal Encoder‑Decoder (≈8B aktywnych parametrów podczas wejścia/prefill, 16B podczas dekodowania/generowania); kontekst 1M tokenów; do 384K tokenów wyjściowych; natywne wsparcie wizji.
- Cennik bez zmian: poza godzinami szczytu $0.15 / $0.60 za 1M tokenów wejściowych (brak trafienia w cache) / wyjściowych (w szczycie stawki podwajane); trafienia w cache od $0.003. CometAPI wycenione o 20% taniej niż oficjalna stawka.
- Nowe API Search & Fetch udostępnione wszystkim deweloperom ($0.75 za 1 000 wywołań; bezpłatne przez niektóre narzędzia po stronie serwera do 31 października 2026).
- Silne możliwości „wish‑driven programming” dla generowania projektów end‑to‑end (gry, sceny 3D, pełne repozytoria). Konkurencyjny względem większych zamkniętych modeli w benchmarkach agentowych i kodowania, pozostając znacznie tańszy i szybszy dla wielu produkcyjnych obciążeń.
- Open‑source, wagi na licencji MIT na Hugging Face i ModelScope umożliwiają self‑hosting i fine‑tuning.
- Do zastosowań produkcyjnych platformy takie jak CometAPI zapewniają wygodny, kompatybilny z OpenAI dostęp do modeli DeepSeek wraz z 500+ innymi, często z konkurencyjną ceną i uproszczonym przełączaniem.
DeepSeek nadal przesuwa granice wydajnych, wysokosprawnych otwartych modeli AI. 17 października 2026 firma wydała DeepSeek-V4.1-Flash-1017, ukierunkowaną aktualizację swojego modelu V4.1-Flash (pierwotnie uruchomionego 10 września 2026). Promowany jako przynoszący istotne ulepszenia w rozumowaniu, kodowaniu, zdolnościach agentowych i rozumieniu wizualnym—przy jednoczesnym skróceniu czasu wykonania zadań i długości odpowiedzi—ten checkpoint jest pozycjonowany jako najpotężniejszy wydajny model DeepSeek do rzeczywistych obciążeń agentowych i kodowania.
Model jest dostępny na stronie DeepSeek, w aplikacji mobilnej oraz przez API (wciąż pod nazwą deepseek-flash). Wagi są otwarcie udostępnione na licencji MIT, co czyni go jednym z najsilniejszych otwarto‑wagowych wyborów dla deweloperów potrzebujących wydajności agentów na poziomie frontier bez kosztów na poziomie frontier.
Czym dokładnie jest DeepSeek V4.1-Flash-1017?
DeepSeek-V4.1-Flash-1017 to checkpoint oznaczony datą („1017” odnosi się do wydania z 17 października) z rodziny V4.1-Flash. DeepSeek opisuje go jako „drobna aktualizacja”, jednak ulepszenia są szerokie i istotne: wyższe wyniki we wszystkich raportowanych kategoriach benchmarków, szybsze ukończenie zadań i krótsze odpowiedzi. Firma określa to jako prawdziwe ulepszenie Pareto—lepsza wydajność i jednocześnie lepsza efektywność kosztowa.
Dziedziczy innowacyjną architekturę wprowadzoną wraz z V4.1-Flash:
- Projekt Mixture‑of‑Experts (MoE) z około 552B łącznej liczby parametrów backbone (plus dodatkowe parametry Engram w niektórych raportach). Nowa architektura Causal Encoder‑Decoder, która aktywuje tylko ~8B parametrów na token podczas prefill/przetwarzania wejścia oraz ~16B podczas dekodowania/generowania wyjścia.
- Silnie skompresowany KV cache (deklarowane redukcje do 1/4 zużycia HBM i 1/8 SSD względem poprzednich generacji), co znacząco obniża koszt długiego kontekstu i wieloetapowych interakcji agentowych.
- Natywne wsparcie multimodalne (tekst + obraz wejście → tekst wyjście). Okno kontekstu 1 miliona tokenów i maksymalna długość wyjścia 384K tokenów (zalecane próbkowanie często używa ≥256K maks. tokenów).
- Obsługa trybów thinking / non‑thinking, wywoływania narzędzi, JSON output oraz regulowanego nakładu rozumowania.
Model trenowano z wykorzystaniem wzmocnionych technik RL, w tym pętli samosprzężenia zwrotnego ukierunkowanych na poprawę rozwoju projektów end‑to‑end. Umożliwia to bardziej niezawodne „wish‑driven programming”—zamianę celów w języku naturalnym na kompletne, działające projekty, takie jak gry webowe, sceny 3D lub całe repozytoria kodu.
Dla dewelopera aplikacji zmienia to pytanie ewaluacyjne. Zamiast sprawdzać, czy model potrafi stworzyć wiarygodną funkcję, testuj, czy potrafi zrozumieć istniejącą bazę kodu, wprowadzić skoordynowane zmiany, uruchomić testy i naprawić błędy. Przekonująca demonstracja potwierdza zdolność wartą testów; nie potwierdza niezawodności w dowolnych repozytoriach.
Aktualizacja sprawia też, że warto oddzielnie mierzyć efektywność wyjścia od jakości odpowiedzi. Krótsza odpowiedź może obniżyć koszt generacji, ale tylko jeśli zachowuje implementację, wyjaśnienia lub dowody wymagane przez zadanie. Usunięcie użytecznej walidacji byłoby regresją nawet przy niższym rachunku tokenowym.
Specyfikacja API DeepSeek V4.1-Flash-1017
| Specyfikacja | DeepSeek V4.1-Flash-1017 |
|---|---|
| Natywny identyfikator API | deepseek-flash |
| Okno kontekstu | 1M tokenów |
| Maksymalne wyjście | 384K tokenów |
| Obsługa wejścia | Tekst i obrazy |
| Tryby rozumowania | Thinking i non-thinking |
| Funkcje dla deweloperów | Tool calls, JSON output, Responses API |
| Architektura | Causal Encoder–Decoder MoE |
| Ogłoszona liczba parametrów rodziny | 552B |
| Aktywne parametry | 8B dla wejścia; 16B dla wyjścia |
Jak DeepSeek V4.1-Flash-1017 wypada w benchmarkach?
Niezależne wczesne testy (np. zestawienia side‑by‑side z DeepSeek V4 Pro) pokazały, że 1017 dorównuje jakości na praktycznych zadaniach, będąc znacząco szybszym i tańszym, a także dodając wsparcie wizji, którego Pro brakowało w niektórych konfiguracjach.
Wybrane wyniki raportowane przez dostawcę porównują wydanie wrześniowe z aktualizacją z 17 października.
| Oficjalne wyniki benchmarków | Wydanie wrześniowe | Aktualizacja 17 października | Bezwzględna zmiana wyniku (punkty) |
|---|---|---|---|
| HLE bez narzędzi | 36.8 | 42.6 | +5.8 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
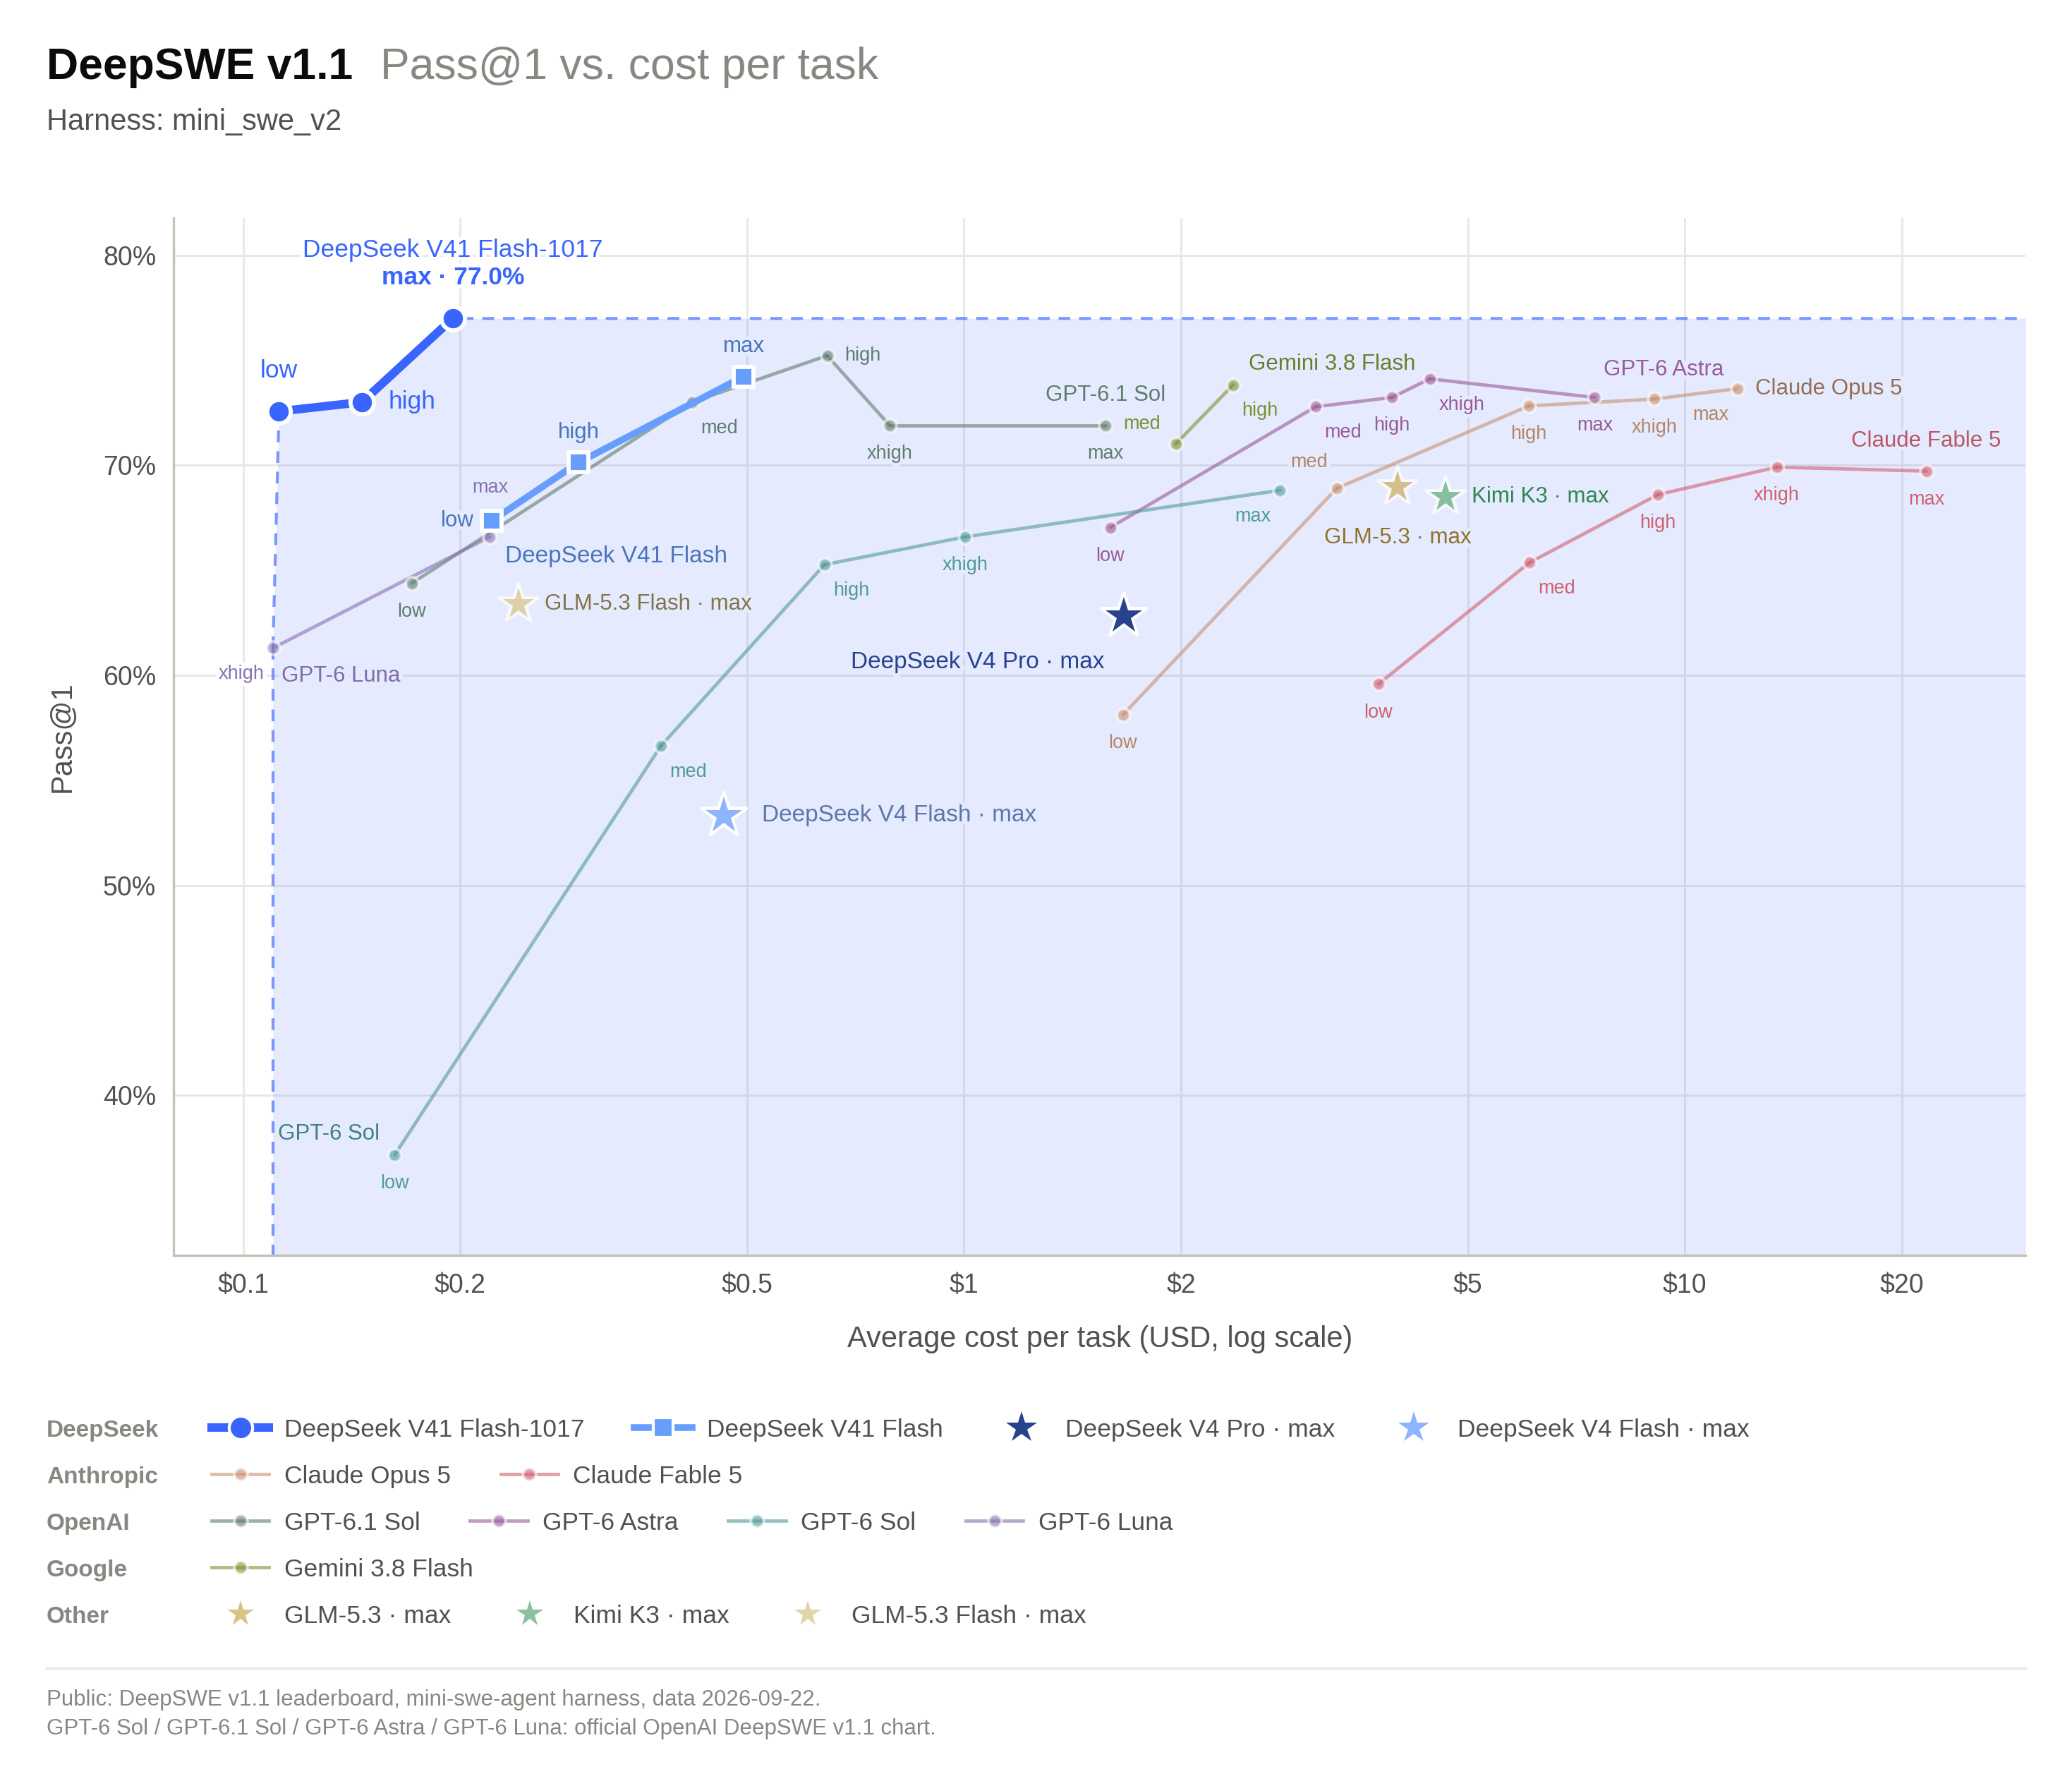
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 |
| Agents’ Last Exam | 31.8 | 35.4 | +3.6 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 |
| Chartography z narzędziami | 78.9 | 83.0 | +4.1 |
Są to wyniki raportowane przez dostawcę, nie niezależne replikacje. DeepSeek użył Claude Code dla Terminal-Bench 4.0 i Mini-SWE-V2 dla DeepSWE v1.1. HLE jest raportowane bez narzędzi i używa głównych wyników, a nie osobno oznaczonego podzbioru tekstowego; Chartography używa narzędzi. Cytowana tabela wydania nie podaje pełnej konfiguracji dla każdego wiersza, więc nie można zakładać równych budżetów rozumowania, sprzętu ani warunków zatrzymania. Powyższe zmiany to proste różnice punktowe, nie względne procenty.
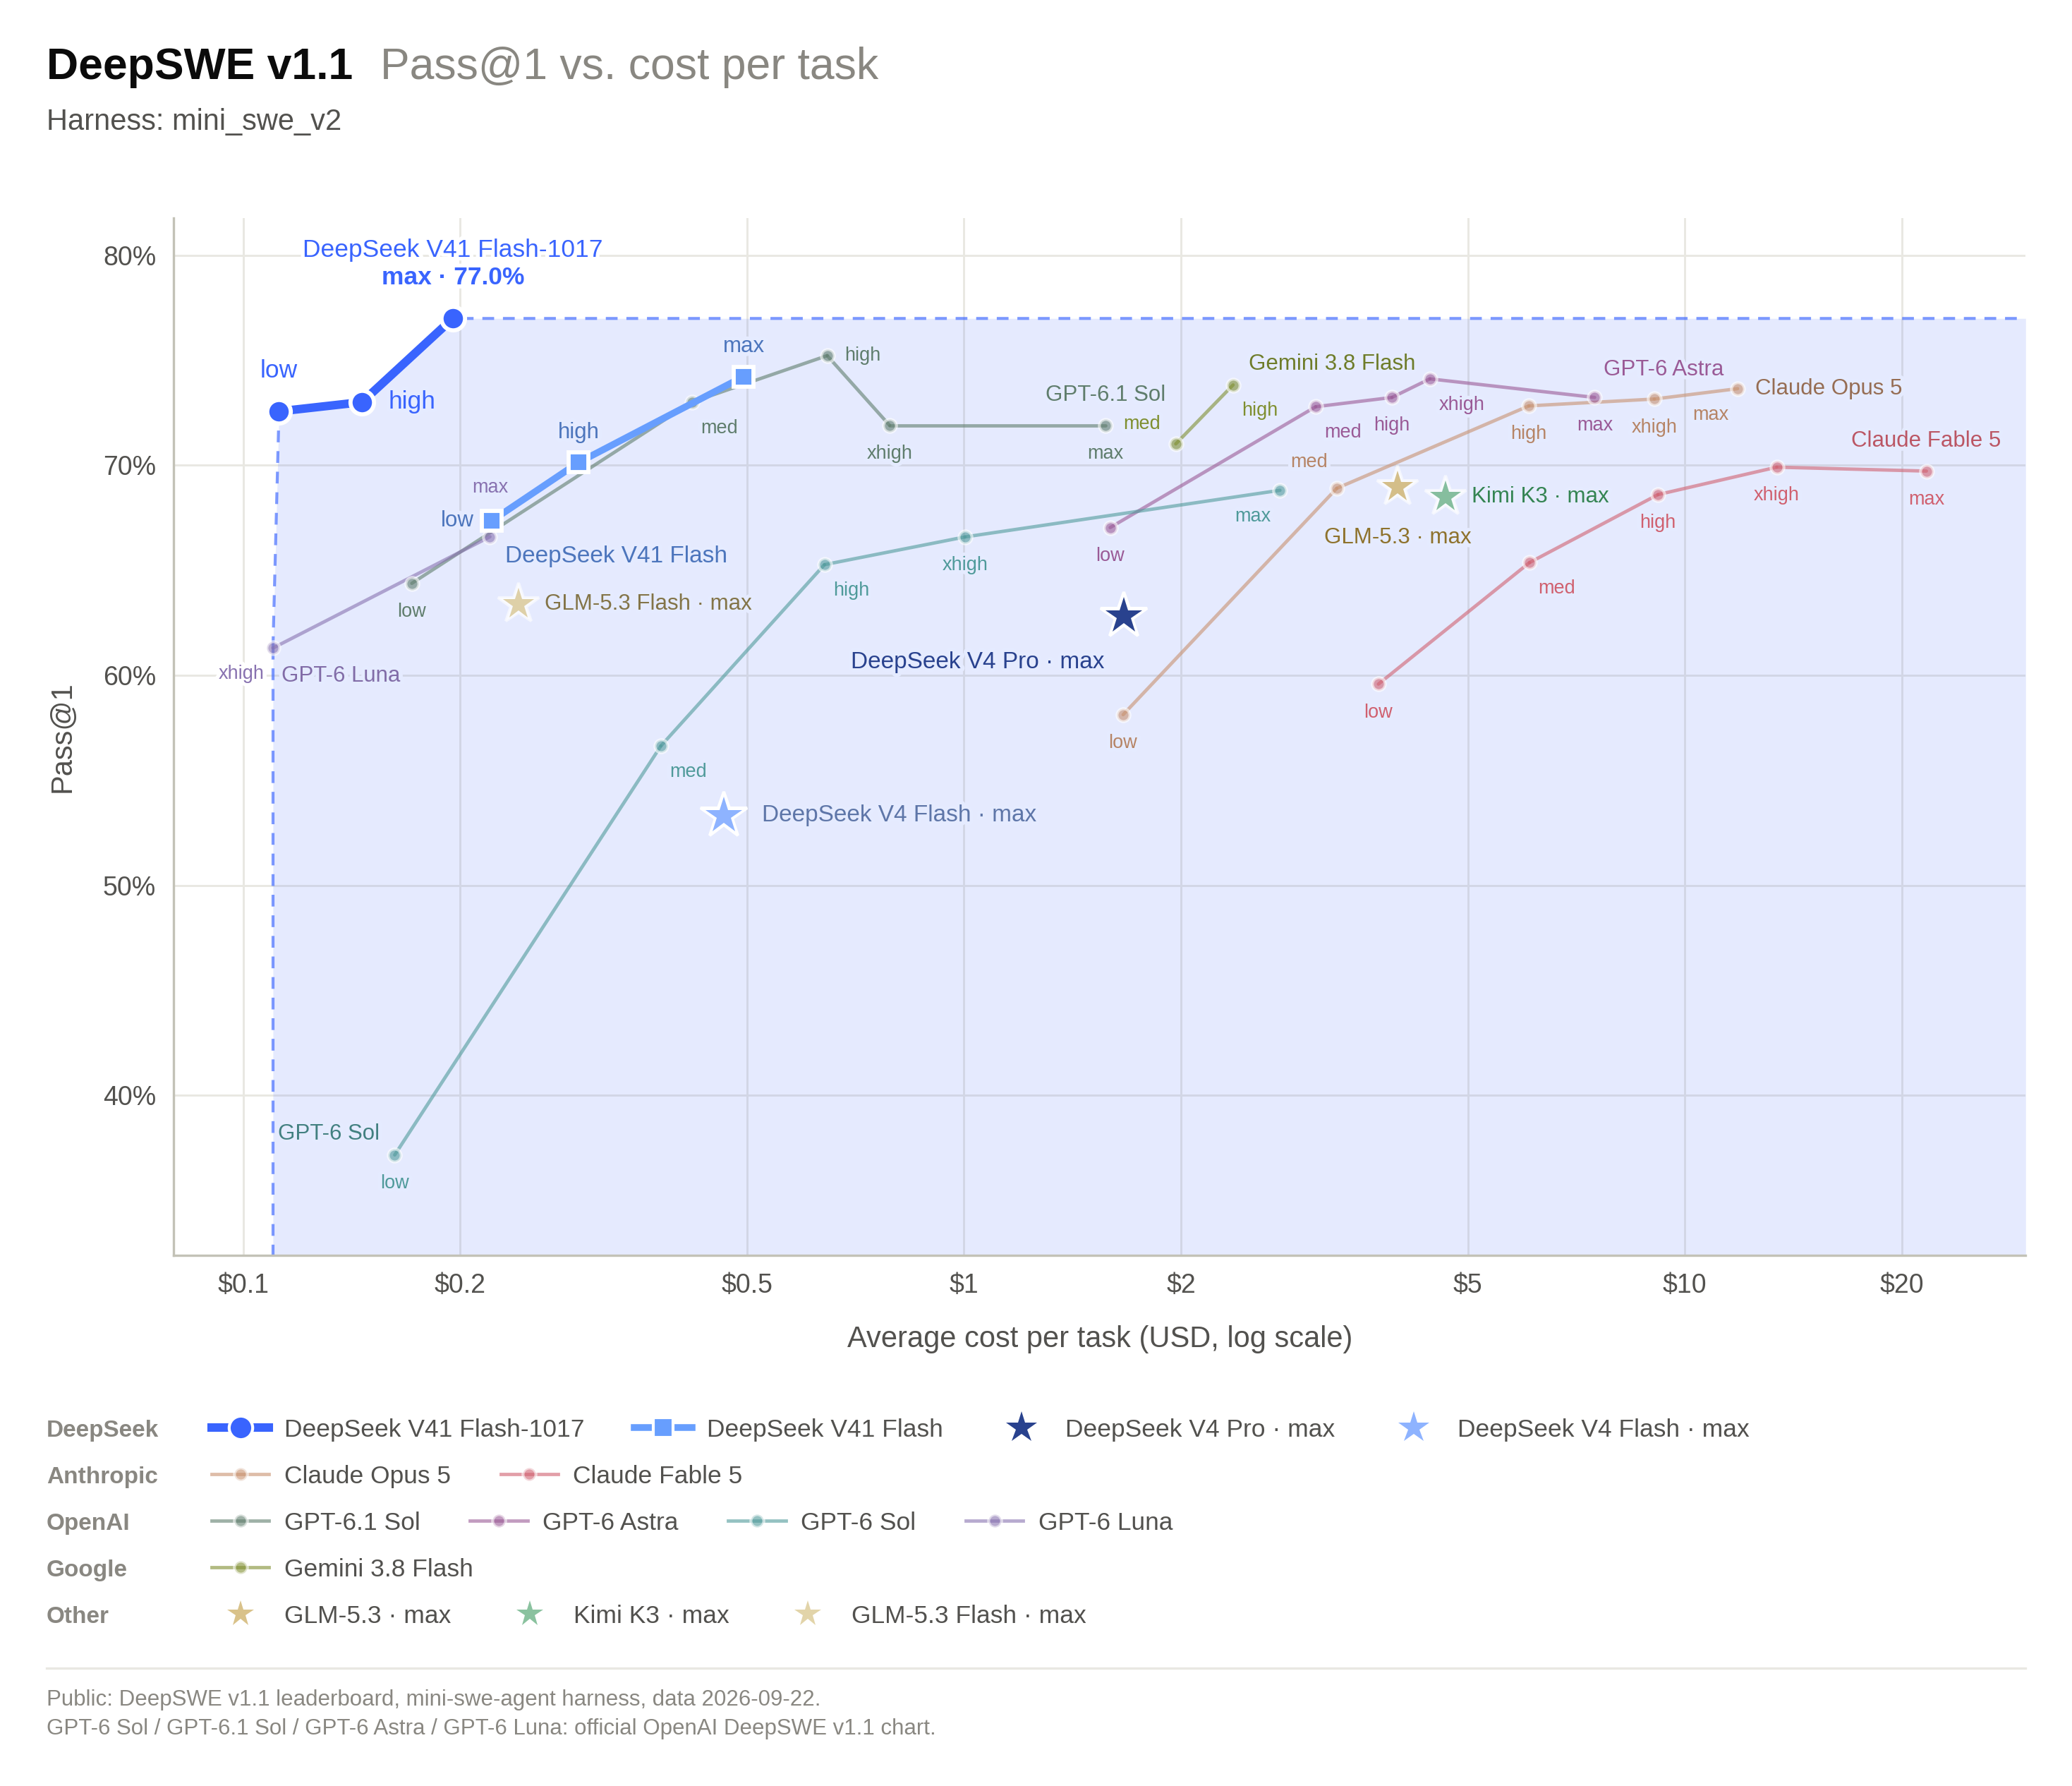
Na wykresie wydajność‑vs‑koszt DeepSWE v1.1 DeepSeek naniesiono Pass@1 względem średniego kosztu zadania (USD) na osi logarytmicznej, używając harnessu Mini‑SWE‑V2. Różne ustawienia rozumowania pojawiają się jako oddzielne punkty; porównuj właściwy współczynnik sukcesu i konfigurację przed wyciąganiem wniosków o kosztach.
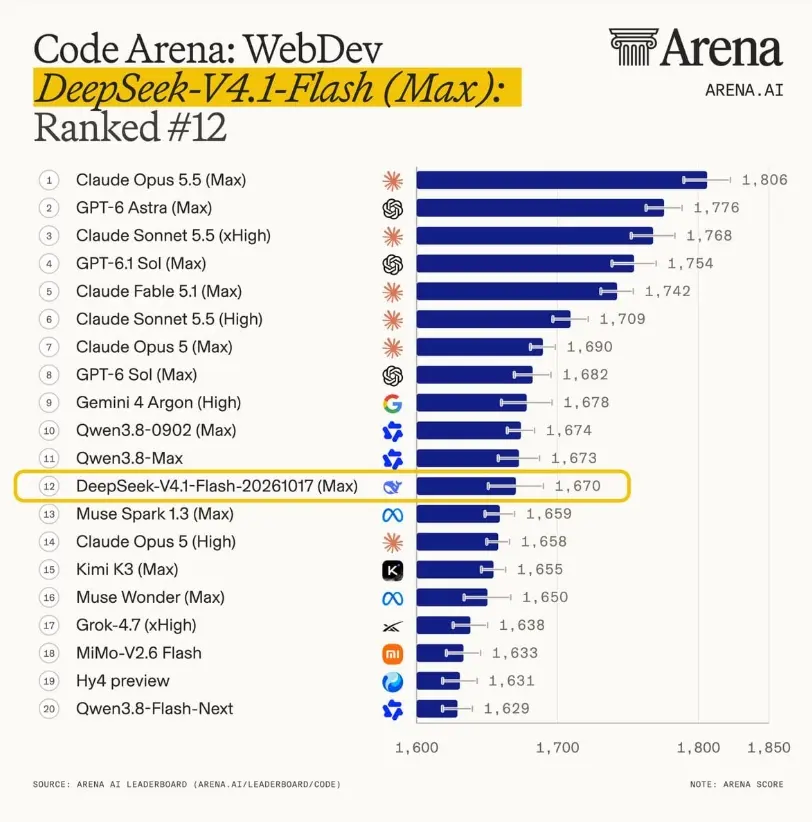
Code Arena: WebDev Leaderboard – najlepszy model open‑source
W najnowszej ewaluacji benchmarku frontier dla kodowania i rozwoju webowego, DeepSeek-V4.1-Flash-1017 nie tylko przewyższył wysoko oceniany Kimi K3 (Max), ale także osiągnął poprawę rzędu wielkości w efektywności kosztowej inferencji—z kosztem operacyjnym około jednej dziesiątej konkurenta. DeepSeek-V4.1-Flash-20261017 (Max) oficjalnie zajął pierwsze miejsce na Code Arena: WebDev leaderboard, zdobywając tytuł „numer jeden wśród modeli open‑source”.
W ogólnej klasyfikacji model zajął 12. miejsce z wynikiem 1670. Na tym wysokim poziomie przewyższa wiodący model zamknięty Claude Opus5 (High) i zmniejsza dystans do topowego GPT-6Sol (Max) do mniej niż 10 punktów.
Jak aktualizacja październikowa wypada względem wydania wrześniowego?
W porównaniu z wydaniem wrześniowym, aktualizacja z 17 października najsilniej zyskuje w wybranych benchmarkach kodowania: Terminal-Bench 4.0 wzrasta z 31.2 do 42.3 (+11.1 punktu), a ProgramBench z 20.3 do 29.1 (+8.8 punktu). DeepSWE v1.1 poprawia się z 74.2 do 77.0 (+2.8 punktu). Te wyniki raportowane przez dostawcę uzasadniają ocenę aktualizacji pod kątem workflow terminalowych i szerszych zadań programistycznych; nie implikują równoważnych zysków produktywności w każdej bazie kodu.
Wydanie kładzie też większy nacisk na pełny rozwój projektów poprzez wzmocnienie uczenia z samosprzężeniem zwrotnym. Szybkość i oszczędność tokenów pozostają zależne od zadania, co pokazują dwa przykłady w kolejnej sekcji. Dla istniejących natywnych integracji API identyfikator modelu pozostaje deepseek-flash. Decyzja o praktycznym uaktualnieniu powinna więc opierać się na przyjętych ukończeniach zadań, całkowitym koszcie i czasie end‑to‑end mierzonym na reprezentatywnych pracach.
Ile kosztuje DeepSeek V4.1-Flash-1017?
Przewaga kosztowa jest ogromna: Flash jest zwykle 10–40× tańszy per token niż czołowe modele zamknięte, a krótsze odpowiedzi dodatkowo wzmacniają oszczędności w wieloetapowych agentach. Względem poprzednika, 1017 jest ściśle lepszy w raportowanych metrykach przy niezmienionej cenie—co czyni go czystym uaktualnieniem.
USD za milion tokenów, zgodnie z artykułem źródłowym z 19 października 2026. Stawki CometAPI w oknie szczytu stosują opublikowany mnożnik 2×.
| Kategoria tokenów | DeepSeek natywnie: poza szczytem | DeepSeek natywnie: szczyt | DeepSeek V4.1 Flash API w CometAPI: baza | CometAPI: okno 2× |
|---|---|---|---|---|
| Wejście, trafienie w cache | $0.003 | $0.006 | $0.0024 | $0.0048 |
| Wejście, brak trafienia | $0.15 | $0.30 | $0.12 | $0.24 |
| Wyjście | $0.60 | $1.20 | $0.48 | $0.96 |
Obaj dostawcy podają okna szczytu w dni powszednie 01:00–04:00 i 06:00–10:00 UTC. DeepSeek wyłącza chińskie święta państwowe; wyświetlane warunki CometAPI nie precyzują tego wyłączenia. Pozostałe godziny używają stawek poza szczytem/bazowych. Kolumna 2× w CometAPI jest obliczona z opublikowanych cen bazowych.
Dla natywnego API DeepSeek, 10 milionów niecache’owanych tokenów wejściowych plus 2 miliony tokenów wyjściowych kosztuje:
- Poza szczytem: (10 × $0.15) + (2 × $0.60) = $2.70.
- Szczyt: (10 × $0.30) + (2 × $1.20) = $5.40.
Dla budżetu pilota dziel tokeny i opłaty narzędziowe przez wszystkie podejścia z podziałem na zadania przyjęte. Uwzględnij ponowne użycie cache i okna szczytu; koszty infrastruktury i przeglądu ludzkiego raportuj osobno. Powyższe przykłady obejmują jedynie tokeny modelu.
Opłaty Search i Fetch
Search i Fetch API DeepSeek kosztują $0.75 za 1 000 udanych żądań. Rozliczanie jest oddzielne od użycia tokenów modelu; nieudane żądania, puste wyniki wyszukiwania i timeouty nie są rozliczane zgodnie z dokumentacją.
Dla użytkowników API DeepSeek wywołania Search i Fetch po stronie serwera przez DeepSeek Harness, Claude Code i Codex są tymczasowo bezpłatne w ramach oficjalnej polityki rozliczeń. Rozliczanie tych wywołań rozpoczyna się 31 października 2026 o 16:00 UTC, czyli 1 listopada o północy w Pekinie. To ograniczone zwolnienie nie oznacza, że wszystkie samodzielne żądania Search i Fetch są bezpłatne.
Czy DeepSeek V4.1-Flash-1017 zawsze jest szybszy i tańszy?
Nie. Dwuzadaniowy test EmpirioLabs wykazał niższy czas i użycie tokenów wyjściowych dla animacji akwarium, ale wyższe wartości dla animacji panoramy miasta:
| Testy kodowania z pierwszej ręki EmpirioLabs | Wydanie wrześniowe | Aktualizacja 17 października | Zaobserwowany wynik |
|---|---|---|---|
| Czas ukończenia akwarium | 162 sekundy | 124 sekundy | Aktualizacja październikowa szybsza |
| Tokeny wyjściowe akwarium | 41,833 | 33,149 | Aktualizacja październikowa użyła mniej |
| Czas ukończenia panoramy | 163 sekundy | 177 sekund | Aktualizacja październikowa wolniejsza |
| Tokeny wyjściowe panoramy | 37,928 | 42,907 | Aktualizacja październikowa użyła więcej |
Obie wersje wygenerowały działające animacje w tych testach na platformie API EmpirioLabs 18 października 2026. Każde zadanie użyło tego samego promptu i żądało jednego samodzielnego pliku HTML z osadzonym CSS i JavaScript, bez zewnętrznych bibliotek i zasobów. Oba modele działały z ustawieniami domyślnymi, thinking włączony z domyślnym budżetem i limitem wyjścia 65,536 tokenów. Uruchomiono równolegle dla każdego zadania, po jednej próbie na model. Czasy obejmują całe żądanie; liczby tokenów wyjściowych, w tym tokeny rozumowania, pochodzą z raportów użycia API. Zrzuty ekranu renderowano w przeglądarce headless po sześciu sekundach. Te dwa przykłady ilustrują zmienność obciążeń, a nie ustanawiają ogólnej klasyfikacji.
Jak uzyskać dostęp do DeepSeek V4.1-Flash-1017?
- Oficjalne API DeepSeek — użyj nazwy modelu
deepseek-flashna https://api.deepseek.com. - Otwarte wagi — pobierz z Hugging Face lub ModelScope do self‑hostingu.
- CometAPI — CometAPI dodaje DeepSeek-V4.1-Flash-1017 Zobacz szczegóły modelu ID modelu: deepseek-v4.1-flash-1017
Użyj natywnego API DeepSeek
Szybki start API DeepSeek’s API quick start i CometAPI potwierdzają, że deepseek-flash teraz serwuje wersję z 17 października, bez zmian sposobu wywołania.
Wyślij żądanie planowania projektu przez API w Pythonie. Zainstaluj pakiet OpenAI dla Pythona i ustaw API_KEY w środowisku przed uruchomieniem przykładu.
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.deepseek.com",# https://api.cometapi.com/v1
)
response = client.chat.completions.create(
    model="deepseek-v4.1-flash-1017",
    messages=[
        {
            "role": "user",
            "content": (
                "Design a small issue-tracking application. "
                "Give the data model, implementation plan, "
                "and acceptance tests."
            ),
        }
    ],
)
print(response.choices[0].message.content)
To zwraca odpowiedź modelu. Aby automatycznie zbudować i zweryfikować projekt, środowisko agenta musi dodatkowo zapewnić dostęp do plików, wykonywanie poleceń, informację zwrotną z testów i odpowiednie uprawnienia.
CometAPI Rekomendacja: CometAPI już udostępnia różne modele DeepSeek i jest doskonałym sposobem, by wypróbować V4.1-Flash-1017 obok Claude, GPT, Gemini, Grok oraz wyspecjalizowanych modeli kodowania/wizji bez uzależnienia od dostawcy. Zarejestruj się i uzyskaj klucz API, a następnie wskaż istniejący SDK OpenAI na bazowy URL CometAPI. Podejście to jest szczególnie silne dla frameworków agentowych, które korzystają na kierowaniu różnych podzadań do najbardziej opłacalnego lub najwyżej wydajnego dostępnego modelu.
Podsumowanie
DeepSeek-V4.1-Flash-1017 reprezentuje sprytny, efektywny skok naprzód w możliwościach otwartej AI. Poprzez poprawę wydajności w kluczowych benchmarkach agentowych i kodowania przy jednoczesnym skróceniu długości wyjścia i czasu zadań—bez zmiany niskich cen—umacnia pozycję DeepSeek jako lidera w wyścigu wydajność‑per‑dolar. Niezależnie od tego, czy budujesz autonomiczne agentowe oprogramowanie, aplikacje multimodalne, czy systemy produkcyjne zoptymalizowane kosztowo, ten model zasługuje na poważną ewaluację.
W połączeniu z wygodnymi warstwami dostępu takimi jak CometAPI deweloperzy mogą integrować najnowocześniejsze modele jak V4.1-Flash-1017 w solidne, wielodostawcze workflow z minimalnym tarciem. W miarę pojawiania się niezależnych ewaluacji i dojrzewania ekosystemu narzędzi (Harness, CodeBuddy, itp.), oczekuj, że ten checkpoint stanie się domyślnym wyborem dla wielu wysokowolumenowych, wysoko‑inteligentnych obciążeń pod koniec 2026 roku i później.