
TL;DR
DeepSeek V4.1 Pro to zapowiedziany przyszły następca V4 Pro, bez ustalonej daty wydania w oficjalnych źródłach przejrzanych 14 października 2026 r. Ogłoszenie z 10 września dotyczące Flash dostarcza najczytelniejszej wskazówki co do terminu. Dostępne specyfikacje i oceny Flash pomagają deweloperom się przygotować, ale nie ustanawiają możliwości wariantu Pro. DeepSeek wyjaśnił, że V4 Pro pozostaje dostępny w odpowiedzi na zapotrzebowanie użytkowników. Poniższe liczby benchmarków opisują pierwotne wydanie Flash, a nie aktualizację Flash-1017 z 17 października; przed wdrożeniem integracje powinny zweryfikować wersje modeli specyficzne dla dostawców.
Najważniejsze wnioski
- Status wydania: V4.1 Pro został oficjalnie wspomniany, ale nie potwierdzono konkretnej daty premiery.
- Najważniejsza wskazówka: Ogłoszenie V4.1 Flash połączyło przyszły V4.1 Pro z planem przejścia API.
- Status API: DeepSeek potwierdził kontynuację usługi V4 Pro z niezmienionym rozliczaniem w odpowiedzi na zapotrzebowanie użytkowników; wcześniejszy plan przekierowywania żądań Pro do Flash został zastąpiony.
- Podstawa techniczna: V4.1 Flash ujawnia backbone o 552B parametrach, asymetryczne przetwarzanie oraz okno kontekstu 1M tokenów.
- Przygotowanie: Porównuj benchmarki istniejących modeli i utrzymuj konfigurowalność identyfikatorów modeli w API.
When Will DeepSeek V4.1 Pro Be Released?
Na dzień 14 października 2026 r. oficjalne źródła przejrzane na potrzeby tego artykułu nie podają daty wydania DeepSeek V4.1 Pro. Nazwa pojawia się w komunikacji produktowej DeepSeek, ale wzmianka o przyszłym produkcie nie stanowi harmonogramu premiery.
10 września 2026 r. DeepSeek przedstawił V4.1 Flash jako najmniejszego członka nowej rodziny architektury. Oficjalne ogłoszenie premiery opisywało wstępny plan przekierowania starszego API V4 Pro do V4.1 Flash do czasu wydania przyszłego V4.1 Pro. Oświadczenie wiąże następcę z konkretną polityką migracji, ale nie ustanawia daty premiery, statusu treningu ani ostatecznych specyfikacji.
DeepSeek V4.1 Pro Release Timeline
| Date | Development | Implication |
|---|---|---|
| April 24, 2026 | V4 preview family released | Previous generation baseline |
| August 13, 2026 | V4 Pro general-availability update | Known flagship baseline |
| September 10, 2026 | V4.1 Flash announced; V4.1 Pro referenced | New architecture family introduced, with a future Pro successor referenced but no release date confirmed |
| September 14, 2026 | Original V4 Pro migration target | Subsequently revised |
| V4.1 Pro release | No announced date | Timing remains unconfirmed |
Oficjalne archiwum newsów datuje wydanie V4 preview na 24 kwietnia oraz V4 Pro na 13 sierpnia jako wydanie ogólnodostępne. Wrześniowa data migracji była celem przejścia usług, a nie datą wydania V4.1 Pro.
Wrześniowe ogłoszenie proponowało przekierowanie żądań V4 Pro do Flash od 14 września do czasu przyszłego wydania Pro. Jednak obecna dokumentacja API wymienia V4 Pro jako oddzielny model z własnymi stawkami. DeepSeek następnie doprecyzował w oficjalnym wpisie changeloga z 10 września, że będzie kontynuował świadczenie usługi API V4 Pro po 14 września w odpowiedzi na zapotrzebowanie użytkowników, z niezmienionym rozliczaniem. Wcześniejszą propozycję przekierowania należy zatem traktować jako zastąpiony plan, a nie aktualną politykę routingu V4 Pro. Bieżąca tabela modeli wymienia deepseek-v4-pro jako V4-Pro-0813 oraz deepseek-flash jako V4.1-Flash-1017; przed wdrożeniem zweryfikuj mapowanie modeli specyficzne dla każdego dostawcy.
Przyszłe potwierdzenie powinno pochodzić z dedykowanego ogłoszenia DeepSeek, wspieranego identyfikatora API i opublikowanych ocen oraz cennika wariantu Pro.
What Has DeepSeek Officially Confirmed About V4.1 Pro?
Confirmed Information
Rozróżnienie między oficjalnymi oświadczeniami a spekulacjami technicznymi jest kluczowe przed premierą. Ujawnienia dotyczące V4.1 Flash dostarczają istotnych dowodów na temat rodziny architektury, ale nie stają się automatycznie specyfikacją V4.1 Pro.
DeepSeek wspomniał V4.1 Pro jako przyszłego członka rodziny V4.1, ale przeglądane źródła nie ustanawiają daty wydania, publicznego identyfikatora modelu, liczby parametrów, okna kontekstu, wsparcia wizji, sterowania rozumowaniem, wyników benchmarków ani cen w API. Dostępne specyfikacje V4.1 Flash dostarczają kontekstu dla rodziny architektury, nie zaś potwierdzonych parametrów V4.1 Pro.
DeepSeek opisuje V4.1 Flash jako najmniejszego członka nowej rodziny zaprojektowanej do skalowania. To wspiera hipotezę większej przyszłej architektury, ale nie dowodzi, że V4.1 Pro będzie po prostu większą kopią. Trening, budżety aktywnych parametrów, schematy atencji i metody post-treningowe pozostają niepotwierdzone.
Community Reports / Leaks
W poście na X z 27 września 2026 r. @NFT_Chen twierdził, że DeepSeek V4.1 Pro pojawił się w wewnętrznych testach z wstępnym dostępem ograniczonym do wybranych kont.
Post @NFT_Chen to niesprawdzona relacja społeczności, a nie oficjalne ogłoszenie DeepSeek. Zrzut ekranu widocznie pokazuje nazwę V4.1 Pro, etykietę wczesnego dostępu i kilka pól konfiguracyjnych, ale nie ustala źródła zrzutu, środowiska wdrożeniowego, powiązania z działającym modelem, publicznej dostępności API ani ostatecznych specyfikacji produktu. Traktuj to jako przesłankę do dalszej weryfikacji, a nie dowód potwierdzonej premiery.
Załączony zrzut konfiguracji pokazuje nazwę DeepSeek V4.1 Pro, tagline Early access, wysokie nakłady na rozumowanie oraz flagi dotyczące wykorzystania danych szkoleniowych, dostępu non-premium i braku wsparcia multimodalnego. Zawiera również identyfikator FREEBUFF_AI_TRAINING_NOTICE.
Jeśli autentyczny i powiązany z aktywną integracją, wpis mógłby być przesłanką wczesnego dostępu. Flaga dostępności nie jest gwarancją usługi, a prognoza rychłego wydania przez autora nie stanowi potwierdzonego okna premiery. Traktuj zrzut jako przesłankę do dalszej weryfikacji, a nie jako specyfikację wariantu Pro.
What Is Known About DeepSeek V4.1 Pro?
V4.1 Flash oferuje najjaśniejszą podstawę techniczną dla nadchodzącej rodziny. V4.1 Flash używa architektury Causal Encoder-Decoder z różnymi ścieżkami obliczeń dla prefill i dekodowania.
Zgodnie z kartą modelu technicznego wydany model zawiera 40 warstw Transformera: 20-warstwowy encoder i 20-warstwowy decoder.
| Specification | DeepSeek V4 Pro | V4.1 Flash | V4.1 Pro |
|---|---|---|---|
| Backbone parameters | 1.6T | 552B | Unannounced |
| Activated parameters | 49B | 8B input / 16B output | Unannounced |
| Architecture | MoE | Causal Encoder-Decoder MoE | Unannounced |
| Context window | 1M | 1M | Unannounced |
| Max output | 384K | 384K | Unannounced |
| Native image input | Not in listed configuration | Supported | Unannounced |
| KV cache footprint | Not directly comparable | ~890 bytes/token | Unannounced |
| Reasoning control | Low / high / max | Continuous 1–100 | Unannounced |
| Availability | API | API and open weights | Not announced |
Chociaż V4.1 Flash zawiera 552B parametrów backbone, podczas przetwarzania aktywowane jest tylko około 8B parametrów na token wejściowy i 16B podczas generowania wyjścia.
Causal Encoder-Decoder Scaling Potential
Separation między prefill a dekodowaniem może umożliwić przyszłym członkom rodziny zwiększanie pojemności reprezentacji przy jednoczesnym kontrolowaniu kosztów inferencji. V4.1 Flash zawiera także Compressed Sparse Attention 2 i FP4 KV caching. Nie wiadomo, czy i w jaki sposób V4.1 Pro odziedziczy te cechy.
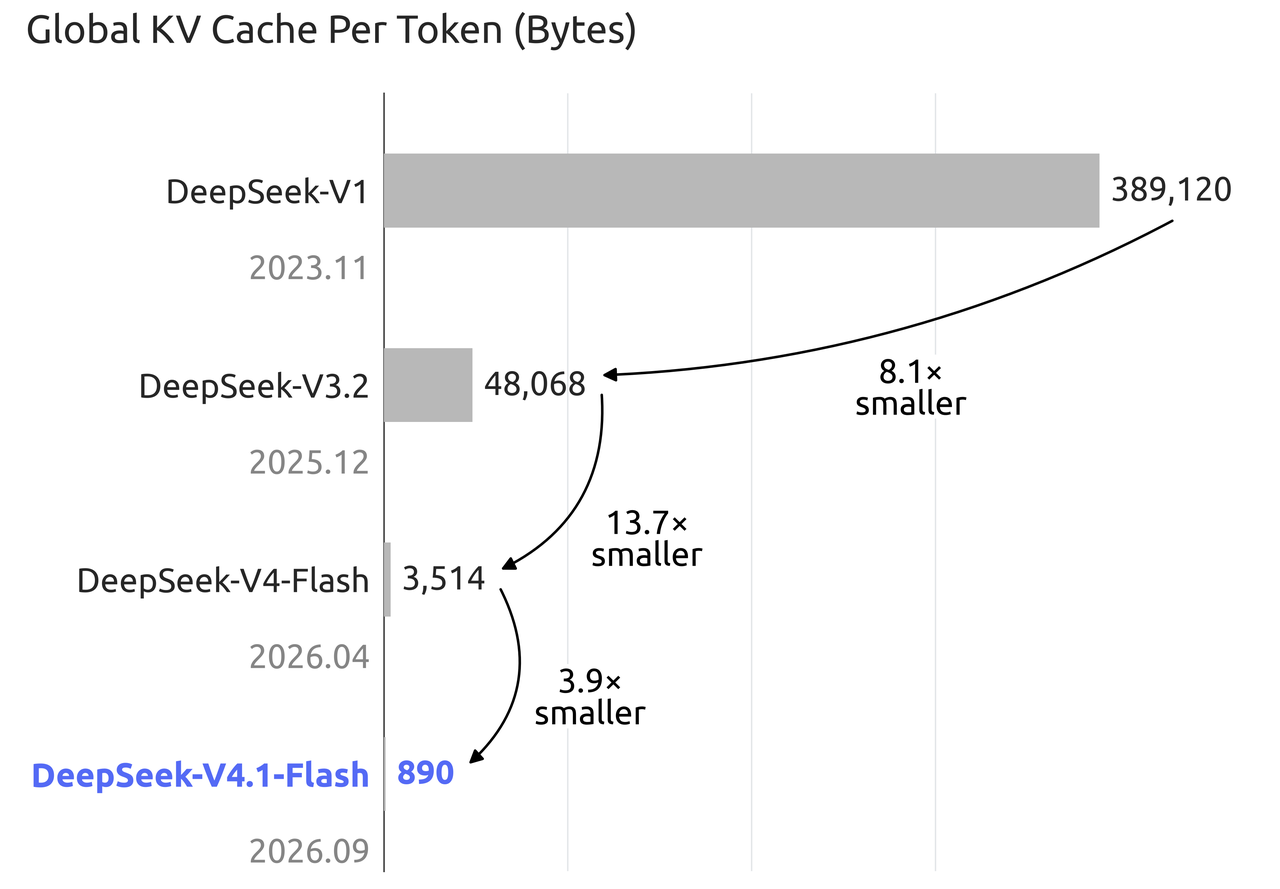
DeepSeek raportuje globalny ślad pamięci podręcznej KV na poziomie około 890 bajtów na token dla V4.1 Flash, w porównaniu do 3 514 bajtów dla V4 Flash. To globalne porównanie pamięci KV, a nie miara całkowitej pamięci serwowania.
Dwie oryginalne grafiki odtworzone w tym artykule są opublikowane w oficjalnej karcie modelu DeepSeek; żadna z nich nie jest wynikiem V4.1 Pro.
DeepSeek V4.1 Pro vs V4 Pro vs V4.1 Flash
Przydatnym punktem wyjścia jest obserwowana różnica między istniejącymi modelami, a nie wymyślony benchmark wariantu Pro. Poniższa tabela porównuje wydany model V4 Pro 0813 z pierwotnym wrześniowym wydaniem V4.1 Flash.
DeepSeek benchmark comparison
| Benchmark (metric) | V4 Pro 0813 | V4.1 Flash | Flash − Pro (percentage points) |
|---|---|---|---|
| GPQA Diamond (Pass@1) | 92.4 | 90.9 | −1.5 |
| HLE, text-only (Pass@1) | 42.7 | 39.1 | −3.6 |
| Terminal-Bench 2.1 (Pass@1) | 87.9 | 90.6 | +2.7 |
| Terminal-Bench 3.0 (Pass@1) | 11.8 | 30.0 | +18.2 |
| DeepSWE v1.1 (Resolved) | 62.7 | 74.2 | +11.5 |
| CyberGym (Pass@1) | 83.3 | 88.1 | +4.8 |
| HLE with tools (Pass@1) | 60.0 | 63.9 | +3.9 |
| Agents’ Last Exam (Pass@1) | 25.7 | 31.8 | +6.1 |
Uwaga dot. wersji (19 października 2026):
Nie są to wyniki V4.1-Flash-1017.
potwierdza, że strona, aplikacja i API przełączyły się na Flash-1017. Tabela pozostaje jako historyczne porównanie z V4 Pro 0813. Nie interpretuj różnic punktowych jako porównania z najnowszą wersją Flash; przed podjęciem aktualnej decyzji o wyborze modelu uruchom dopasowane ewaluacje.
Oficjalna tabela ocen modelu instruktażowego jest źródłem wyników benchmarków zgłoszonych przez dostawcę powyżej. Dla spójnego porównania, wyniki HLE oparte są na podzbiorze tylko tekstowym dla obu modeli. Wszystkie różnice wyników wyrażono w punktach procentowych, a nie jako względne przyrosty procentowe.
Benchmark Conditions and Limits
Ewaluacje instruct modelu Flash używają reasoning_effort=100, temperature=1.0 i top_p=0.95. Terminal-Bench używa DeepSeek Harness Minimal z kontekstem 1M tokenów; DeepSWE v1.1 używa mini-SWE. Te ustawienia opisują raportowane uruchomienia Flash i nie powinny być traktowane jako odtworzenie konfiguracji każdego modelu porównawczego.
Towarzyszące badanie cross-scaffold określa kontenery Linux, max_steps=500, osiem próbek na zadanie dla DeepSWE i trzy dla Terminal-Bench 2.1, bez dostępu do sieci dla tego ostatniego. Te szczegóły dotyczą tego badania, a nie automatycznie każdego wiersza w tabeli nagłówkowej. Karta modelu nie podaje jednej wspólnej konfiguracji sprzętowej dla wszystkich wymienionych wyników; nie jest tu składane żadne roszczenie dotyczące przepustowości znormalizowanej sprzętowo.
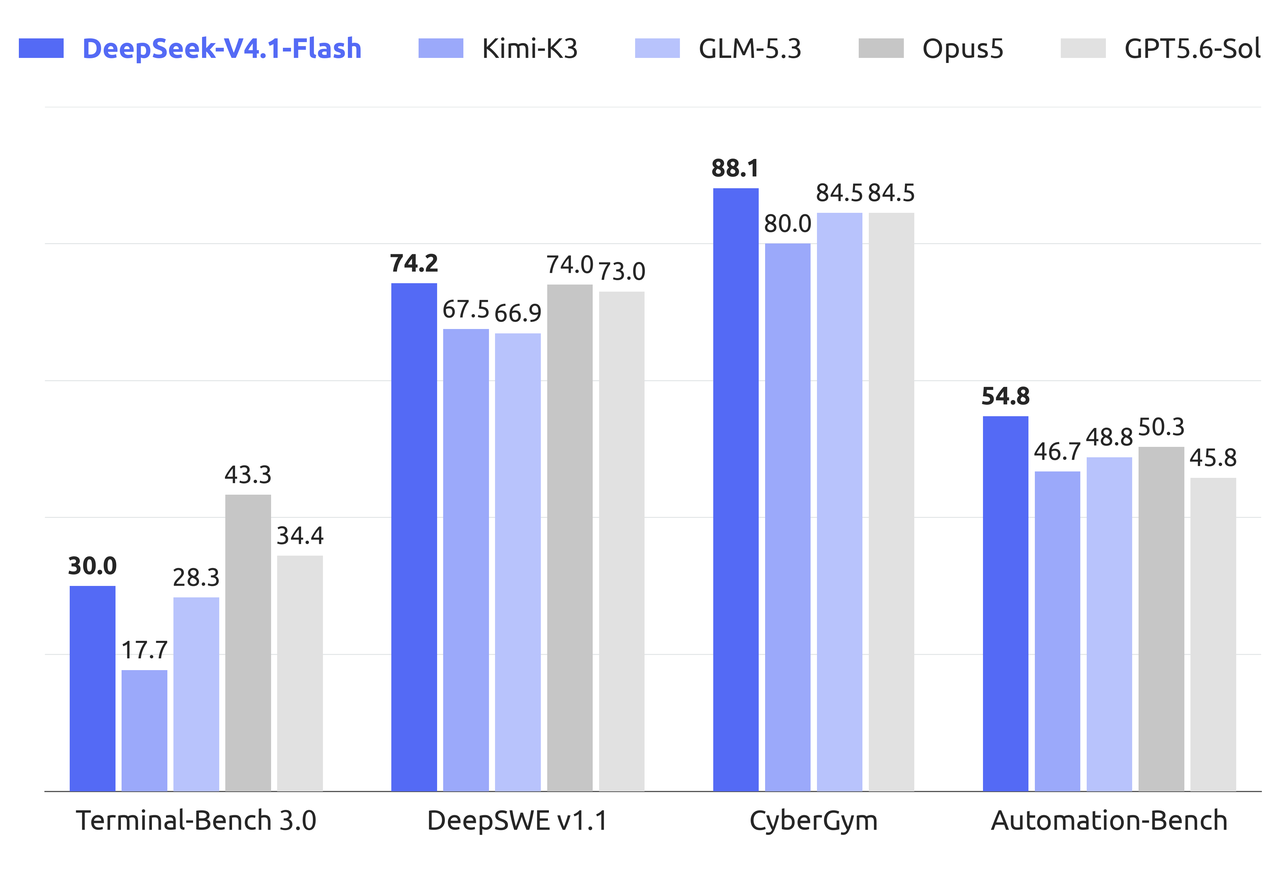
Oryginalny wykres wydajności agentowej DeepSeek porównuje Flash z wybranymi modelami czołowymi. Jego wartość 17.7 dla Terminal-Bench 3.0 należy do Kimi K3, nie do V4 Pro. Powyższa tabela dostarcza osobnego porównania z V4 Pro.
To historyczne porównanie pokazuje, dlaczego mniejszy model nie musi być gorszy w każdym zadaniu. Wobec pierwotnego wrześniowego wydania Flash, V4 Pro prowadził w wybranych testach rozumowania, podczas gdy Flash był lepszy w kilku ewaluacjach terminalowych, programistycznych i z użyciem narzędzi. Tych rankingów nie należy przenosić na Flash-1017 bez zaktualizowanych, porównywalnych testów.
How Much Could DeepSeek V4.1 Pro Cost?
DeepSeek nie ogłosił cen V4.1 Pro. Obecne ceny pierwszej strony stanowią punkt odniesienia, a nie prognozę. Stawki rozróżniają okresy szczytowe i poza szczytem, wejście cache-hit i cache-miss oraz generowane wyjście.
Poniższe liczby pochodzą z dokumentacji cen DeepSeek; stawki mogą się zmienić.
Ceny i limity sprawdzone 14 października 2026 r. Okresy szczytowe to 01:00–04:00 i 06:00–10:00 UTC od poniedziałku do piątku, z wyłączeniem chińskich świąt państwowych. Wszystkie pozostałe godziny to czas poza szczytem. To stawki pierwszej strony DeepSeek, a nie wycena CometAPI; rozliczanie specyficzne dla dostawcy należy sprawdzić oddzielnie.
| Price per 1M tokens | Flash off-peak | Flash peak | V4 Pro off-peak | V4 Pro peak |
|---|---|---|---|---|
| Cache-hit input | $0.003 | $0.006 | $0.022 | $0.044 |
| Cache-miss input | $0.15 | $0.30 | $0.66 | $1.32 |
| Output | $0.60 | $1.20 | $1.98 | $3.96 |
W migawce cen i limitów z 14 października, zarówno V4.1 Flash, jak i V4 Pro wspierają okno kontekstu 1M tokenów. Wymieniona współbieżność wynosi 2 500 dla Flash i 500 dla V4 Pro, z tymi samymi limitami pokazanymi dla okresów szczytowych i poza szczytem. To limity pierwszej strony; przed wdrożeniem potwierdź limity wybranego dostawcy.
Przy opublikowanych stawkach poza szczytem, niebuforowane wejście Flash jest około 77% tańsze niż V4 Pro, a generowane wyjście około 70% tańsze. Niższe ceny mogą być szczególnie istotne dla powtarzalnych działań agentów i przepływów pracy opartych na dokumentach.
Quality and Cost Trade-offs for V4.1 Pro
Dla ilustracji: model kosztujący $0.01 na próbę z 60% skutecznością ma oczekiwany koszt API $0.0167 na udane zadanie, podczas gdy model $0.03 z 95% skutecznością kosztuje około $0.0316. To nie są zmierzone wyniki DeepSeek; zakładają niezależne próby ze stałym prawdopodobieństwem sukcesu. Model o wyższej skuteczności może być mimo to preferowany, jeśli redukuje koszty przeglądu, poprawek lub inne koszty biznesowe.
How Should Developers Prepare for the DeepSeek V4.1 Pro API?
Deweloperzy mogą zweryfikować istniejące kompatybilne interfejsy, bieżące modele i wielokrotnego użytku protokoły testowe bez zakładania identyfikatora V4.1 Pro. Kluczem jest oddzielenie wyboru modelu od logiki aplikacji.
Start with an available DeepSeek model
Deweloperzy mogą uzyskać dostęp do DeepSeek V4 Pro API w CometAPI oraz DeepSeek V4.1 Flash API w CometAPI, aby zbudować obecny punkt odniesienia. Przykład używa identyfikatora CometAPI deepseek-v4.1-flash. Własne API DeepSeek używa deepseek-flash; identyfikatory i klucze są specyficzne dla dostawców i nie należy ich zamieniać.
Zainstaluj pakiet openai i ustaw COMETAPI_KEY przed uruchomieniem. To minimalny przykład integracji; zweryfikuj go na własnym koncie przed użyciem produkcyjnym.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

model = os.getenv("DEEPSEEK_MODEL", "deepseek-v4.1-flash")

response = client.chat.completions.create(
    model=model,
    messages=[
        {"role": "system", "content": "You are a careful coding assistant."},
        {"role": "user", "content": "Explain how to optimize Python API latency."}
    ]
)

print(response.choices[0].message.content)
Identyfikator modelu w tym przykładzie odnosi się do Flash, a nie do niezapowiedzianego wariantu Pro. Przyszły oficjalny identyfikator modelu można podmienić dopiero po jego potwierdzeniu i przetestowaniu.
Build a repeatable DeepSeek evaluation suite
| Test area | Suggested task | Primary metric |
|---|---|---|
| Reasoning | Verified scientific questions | Accuracy |
| Coding | Multi-file repository changes | Tests passed |
| Agents | Tool-assisted research | Completion rate |
| Structured output | Schema-constrained JSON | Validity |
| Long context | Document retrieval | Recall |
| Vision | Chart/document understanding | Extraction accuracy |
| Latency | Controlled repeated requests | P50 / P95 |
| Cost | Full workflow evaluation | Cost per success |
Użyj wyników istniejących modeli do wyboru punktu odniesienia, a nie do przewidywania wydajności V4.1 Pro. Dowody benchmarkowe powyżej poprzedzają Flash-1017. Dla przepływów terminalowych i narzędziowych testuj także długohoryzontowe ukończenie oraz redundantne wywołania narzędzi; mierz opóźnienia pod kontrolowanym obciążeniem. To cele ewaluacji, a nie oficjalne obietnice V4.1 Pro.
Używaj spójnych promptów, narzędzi, danych i budżetów rozumowania wszędzie tam, gdzie to możliwe. Różne ustawienia harnessu mogą generować pozorne zyski modelu niezwiązane z samym modelem.
Prepare a gradual deployment strategy
- Zgodność: przetestuj uwierzytelnianie, streaming, schematy, wywołania narzędzi i limity tokenów.
- Shadow evaluation: przetwarzaj próbki realnych zadań bez zmiany wyników produkcyjnych.
- Controlled rollout: kieruj niewielką część kwalifikujących się żądań do nowego modelu.
- Rollback: zachowaj poprzednią zweryfikowaną trasę, dopóki nie zostaną spełnione cele niezawodności i budżetu.
Should You Wait for DeepSeek V4.1 Pro or Use V4.1 Flash Now?
Jeśli dostępny model spełnia Twoje wymagania, zacznij od niego i utrzymuj konfigurowalną trasę modelu dla przyszłej ewaluacji wariantu Pro. Utrzymuj konfigurowalny identyfikator modelu i ponownie oceń, gdy zostaną opublikowane data wydania, wspierany identyfikator API oraz wyniki ewaluacji.
| Requirement | Practical option | Reason |
|---|---|---|
| Low token cost | Evaluate V4.1 Flash | Lower published rates |
| Large-scale agents | Test Flash first | Agent scores and concurrency |
| Difficult reasoning | Compare V4 Pro and Flash | Different task strengths |
| Existing V4 Pro system | Keep verified integration | Avoid regressions |
| Native visual input | Test Flash | Official vision support |
| Critical workflows | Task-specific evaluation | Real accuracy over leaderboard |
Utrzymuj konfigurowalny identyfikator modelu, jeśli zamierzasz później ocenić V4.1 Pro.
Conclusion
DeepSeek V4.1 Pro został oficjalnie wspomniany, ale jego data wydania, publiczny identyfikator API, ceny i wyniki benchmarków pozostają niepotwierdzone w przejrzanych źródłach. Deweloperzy mogą korzystać z dostępnych tras V4 Pro i V4.1 Flash już teraz, utrzymując konfigurowalny wybór modelu i ponownie uruchamiając dopasowane ewaluacje przed przyjęciem przyszłego wydania Pro.