Buduj z CometAPIPotrzebujesz jednego API dla wielu modeli?Przetestuj proces w Playground, a potem utwórz klucz API, gdy model i koszt pasują do Twojego zastosowania.
- Jakość głosu:
- Eleven v4: najwyższa naturalność, bogatsza barwa, lepsza intonacja i stabilność w długich ujęciach (audiobooki, lektor do wideo, podcasty).
- v4 Turbo: bardzo dobra jakość, minimalnie mniej szczegółowa ekspresja; wystarczająca w dialogu na żywo i zastosowaniach interaktywnych.
- Latencja:
- Eleven v4: wyższa; dłuższy czas do pierwszego dźwięku i wolniejsze strumieniowanie.
- v4 Turbo: najniższa; projektowany pod reakcje w czasie rzeczywistym (asystenci głosowi, połączenia, gry).
- Streaming:
- Eleven v4: streaming dostępny, lecz z większym opóźnieniem; lepszy do odsłuchu podglądowego i dłuższych odcinków niż do rozmów na żywo.
- v4 Turbo: pełne, niskolatencyjne strumieniowanie w czasie rzeczywistym; szybki start audio i płynne dosyłanie.
- CometAPI:
- Eleven v4: brak wsparcia (lub ograniczone).
- v4 Turbo: pełne wsparcie; CometAPI zapewnia ultra‑niską latencję do zastosowań interaktywnych.
- Cennik API:
- Eleven v4: model premium — wyższy koszt jednostkowy.
- v4 Turbo: niższy koszt jednostkowy, korzystniejszy przy dużym wolumenie i aplikacjach czasu rzeczywistego.
- Uwaga: dokładne stawki zależą od planu; obowiązują limity/rozliczanie per model.
Rekomendacja wyboru:
- Tworzenie treści (audiobooki, lektor do wideo, narracje, podcasty, dubbing): Eleven v4 dla maksymalnej jakości i spójności długiej formy. v4 Turbo można użyć do szybkich wersji roboczych lub dużych batchy, gdy liczy się koszt/czas.
- Agenci i interakcje w czasie rzeczywistym (voiceboty, asystenci, telefony/RTC, gry): v4 Turbo ze względu na bardzo niską latencję, streaming i dostęp do CometAPI. Opcjonalnie hybryda: odpowiedź na żywo w v4 Turbo, a po rozmowie dosyntetyzowanie finalnych komunikatów w v4 dla archiwum lub publikacji.
Wybierz Eleven v4 do audiobooków, narracji i ról postaci, gdy priorytetem jest jakość produkcyjna. Wybierz Eleven v4 Turbo do agentów głosowych i aplikacji interaktywnych, gdy liczy się czas reakcji. ElevenLabs podaje, że oba warianty mają ten sam zakres ekspresji; opublikowana stawka API za znak w Turbo jest o 50% niższa. Ostatecznego wyboru dokonaj na podstawie własnych skryptów, testów odsłuchowych i pomiarów opóźnienia end‑to‑end.
Najważniejsze wnioski
Dla produkowanego audio: Zacznij od wariantu standardowego i oceń sposób wykonania, spójność oraz nakład pracy przy montażu.
Dla interakcji na żywo: Zacznij od Turbo i mierz pełny czas od wejścia użytkownika do słyszalnej odpowiedzi.
Koszt: Opublikowana stawka za znak w Turbo jest o 50% niższa, zanim uwzględnisz ponowienia lub inne usługi.
Benchmarki: Opublikowane wyniki preferencji porównują model standardowy z konkurencyjnymi systemami; nie ustanawiają bezpośredniej przewagi jakości nad Turbo.
Sprawdzone pod kątem przejrzystości, atrybucji źródeł i aktualnej terminologii API.
Integracja: Natywne strumieniowanie i asynchroniczne generowanie podmiotów trzecich mają odmienne wymagania operacyjne.
Eleven v4 vs v4 Turbo w skrócie
Wymiar — specyfikacje natywne; ceny natywne
Eleven v4
Eleven v4 Turbo
Główne zastosowanie
Narracja produkcyjna, audiobooki i role postaci
Agenci czasu rzeczywistego i interaktywna mowa
Model ID
eleven_v4
eleven_v4_turbo
Języki
90+
90+
Cena natywna
$0.08 / 1,000 znaków
$0.04 / 1,000 znaków
Mediana opóźnienia inferencji
Brak bezpośrednio porównywalnej wartości
~100 ms
Mediana czasu do pierwszej mowy
Brak porównywalnej wartości
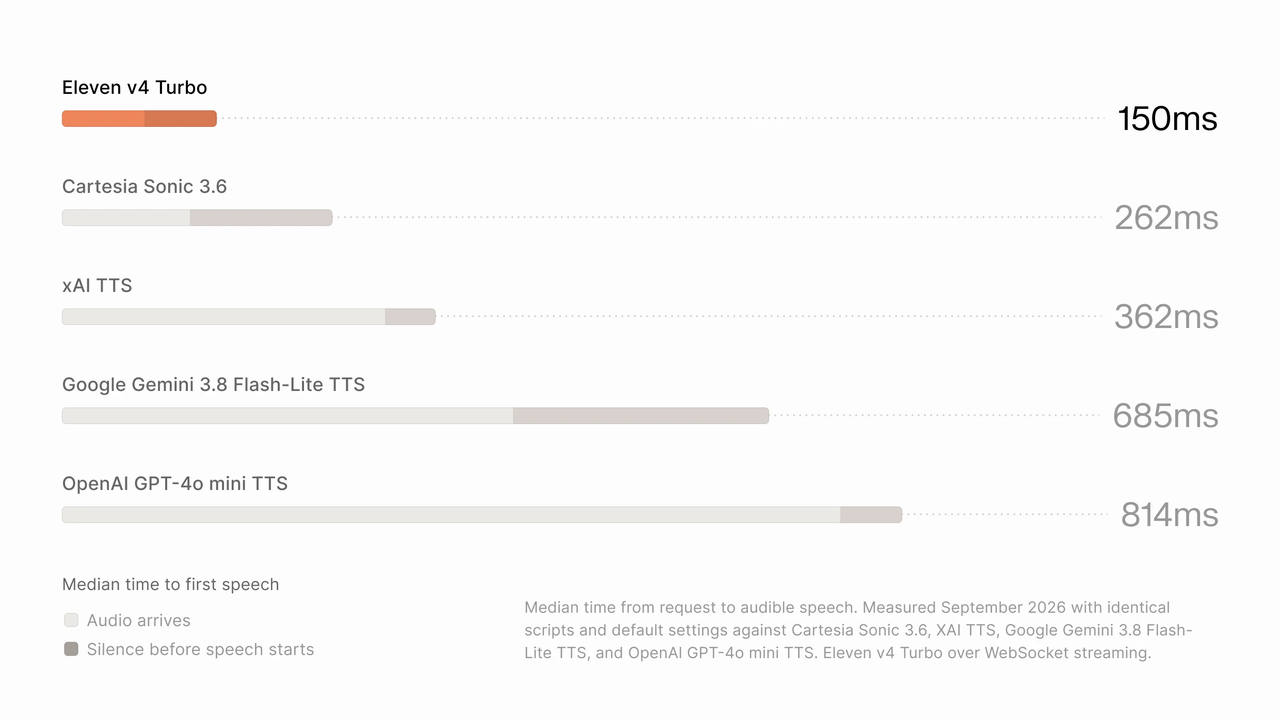
~150 ms medianowego czasu od żądania do słyszalnej mowy przez WebSocket; zmierzone opóźnienie sieciowe wyłączone
Zarejestrowane głosy na połączenie Text to Dialogue WebSocket
Do 10
Dokładnie 1
Wartość 150 ms pochodzi z porównania ElevenLabs z września 2026, wykorzystującego identyczne skrypty i ustawienia domyślne. Mierzy początek słyszalnej mowy, a nie pełne opóźnienie konwersacji z agentem głosowym. Ograniczenia rejestracji głosu dotyczą punktu końcowego Text to Dialogue WebSocket.
Eleven v4 vs v4 Tu
Eleven v4 vs v4 Turbo: Przegląd i specyfikacje
Eleven v4: Produkowane audio i występy wielogłosowe
Opublikowane pozycjonowanie modelu standardowego to najwyższej jakości produkcja mowy, w tym naturalne dialogi wielogłosowe i długie narracje. Czyni to z niego rozsądnego kandydata, gdy nagranie można przejrzeć i zmontować przed publikacją. Kluczowe pytanie brzmi, czy jego realizacja pozostaje przekonująca na przestrzeni całych fragmentów i regenerowanych kwestii.
Eleven v4 Turbo: Ekspresyjna mowa w czasie rzeczywistym
Eleven v4 Turbo jest przeznaczony do agentów czasu rzeczywistego, asystentów i interaktywnych postaci. ElevenLabs podaje, że zachowuje pełny zakres ekspresji Eleven v4 i obsługuje Professional Voice Clones, priorytetyzując jednocześnie niską latencję generowania.
Oceniaj go podczas strumieniowania i odtwarzania audio, ponieważ przekonujący odizolowany klip nie dowodzi, że cała rozmowa jest odpowiednio szybka. Niskie opóźnienie inferencji to punkt wyjścia specyfikacji, a nie gwarancja dla całej aplikacji.
Krótka ścieżka instruktażowa może brzmieć równie akceptowalnie w obu wariantach, natomiast dramatyczna scena może ujawnić różnice, które uzasadniają droższe generowanie.
Architektura i zakres oceny
Oficjalne ogłoszenie architektury opisuje Eleven v4 jako zbudowany na zupełnie nowej architekturze i wskazuje, że Turbo przenosi tę samą technologię do zastosowań niskolatencyjnych. Nie ujawniono jednak wystarczających szczegółów, by porównać liczbę parametrów, strukturę warstw, nakład treningowy ani konkretne zmiany odpowiedzialne za różnicę w szybkości. Traktuj te informacje jako nieujawnione i nie wnioskuj, że Turbo jest mniejszy lub destylowany.
Ograniczenia natywne i sterowanie głosem
Sprawdź limit wejścia dla modelu i punktu końcowego, którego planujesz użyć, zanim podzielisz długi skrypt. Limit opublikowany dla jednego interfejsu nie obowiązuje automatycznie w innym, a brak podanego limitu nie oznacza nieograniczonego wejścia.
Oba warianty oferują kontrolki Stability i Similarity. Gdy wybierzesz Professional Voice Clone w Eleven v4, dodatkowy Clone Strength slider reguluje, jak ściśle wynik podąża za nagraniami treningowymi klona. Niższe wartości pozwalają na bardziej elastyczną realizację z lekkim wygładzeniem głosu; wyższe zachowują więcej oryginalnej interpretacji i charakterystycznych cech głosu, w tym akcentów. ElevenLabs zaleca zaczynać od 0% dla większości głosów. Suwaki Style i Speed są niedostępne w natywnym doświadczeniu v4, a SSML nie jest obsługiwany.
Implikacja dla migracji jest praktyczna: zachowaj sens dotychczasowych instrukcji dla głosu, ale przejrzyj sposób ich wyrażenia. Stary, intensywnie oparty na SSML skrypt należy dostosować i przesłuchać, zamiast kopiować bez zmian.
Eleven v4 vs v4 Turbo: Wydajność
Opublikowane benchmarki i granice źródeł
Liczą się dwa oficjalne wyniki: preferencje słuchowe i opóźnienie odpowiedzi. Odpowiadają na różne pytania.
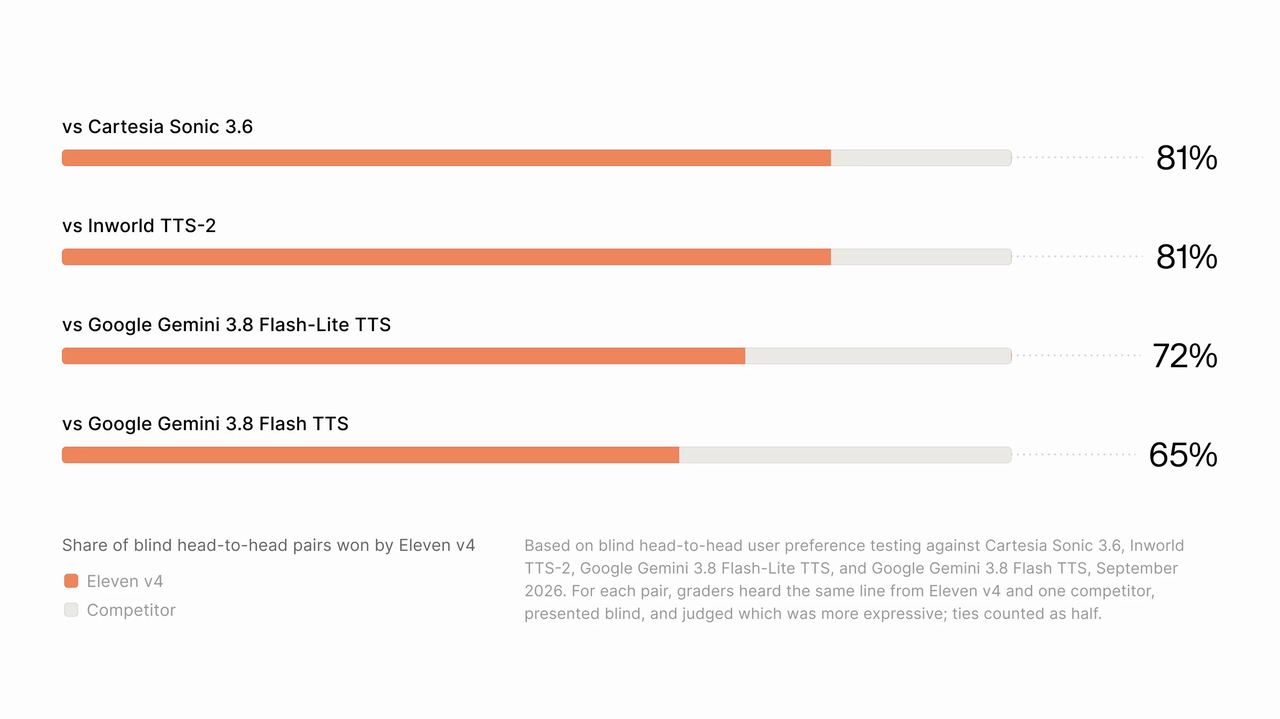
Preferencję słuchaczy względem testowanych modeli konkurencji
Mediana opóźnienia inferencji Turbo
Około 100 ms
Deklarację czasu inferencji modelu
Mediana czasu do pierwszej mowy Turbo
Około 150 ms
Czas od żądania do słyszalnej mowy w podanych warunkach testu
Opublikowane testy odsłuchowe porównują Eleven v4 z konkurencyjnymi modelami mowy. Nie ustalają, o ile — jeśli w ogóle — słuchacze wolą go od Eleven v4 Turbo. W tym wyborze porównaj oba warianty, używając tych samych skryptów i głosów, w swoim własnym ślepym teście odsłuchowym.
Oficjalny wykres latencji ElevenLabs. Zgłaszany czas wyklucza zmierzone opóźnienie sieciowe.
Warunki oceny
Oficjalne badanie odsłuchowe z września 2026 użyło ślepych porównań w parach tego samego wersu z Eleven v4 i modelu konkurencyjnego, oceniając ekspresję i naturalność; remisy liczono jako połowę. Porównywane systemy i stopy preferencji na system są pokazane na oficjalnym wykresie poniżej. Te wyniki pochodzą od dostawcy i porównują Eleven v4 z systemami konkurencji. Nie kwantyfikują różnicy jakości odsłuchowej między Eleven v4 a Eleven v4 Turbo.
Wrześniowe porównanie latencji w 2026 użyło identycznych skryptów i ustawień domyślnych, usunęło zmierzone opóźnienie sieciowe dla każdego systemu i uruchomiło Turbo przez strumieniowanie WebSocket. Zgłaszane 150 ms mierzy czas od żądania do słyszalnej mowy; to inna metryka niż około 100 ms dla inferencji. Cytowana metodologia nie podaje pełnego opisu sprzętu, regionu, obciążenia i wielkości próby, więc nie stanowi gwarancji latencji produkcyjnej.
Jakość głosu i spójność produkcyjna
ElevenLabs podkreśla wsparcie dla Professional Voice Clone, poprawioną spójność mówcy między regenerowanymi kwestiami oraz łączenie żądań dla długich nagrań. Oceń te deklaracje na pełnym fragmencie i kwestii zastępczej wstawionej do istniejącego nagrania.
W produkowanych nagraniach oddziel ekspresję od spójności produkcyjnej. Słuchaj akcentów, emocji, wymowy oraz tego, czy ten sam mówca pozostaje rozpoznawalny w kolejnych fragmentach. Model standardowy to opcja z pierwszeństwem jakości, ale prosty skrypt instruktażowy może nie ujawnić istotnej różnicy. Porównuj zaakceptowane ujęcia zamiast zakładać, że droższe generowanie zawsze wymaga mniej montażu.
Kierunek głosu i dostarczanie wielojęzyczne
Oba warianty wspierają ekspresyjną realizację, ale użyteczna ekspresja zależy od skryptu i wybranego głosu. Zacznij od niewielkiej liczby jasnych wskazówek, a następnie sprawdź, czy poprawiają zamierzony sens.
Uspokajająca odpowiedź wsparcia może łączyć ciepły ton z krótką pauzą:
[warm, reassuring] I found your reservation.
[short pause] Let me confirm the arrival time with you.
To ilustracyjny prompt, a nie zmierzony wynik. Przetestuj go równolegle z wersją bez tagów. Dodatkowe wskazówki są użyteczne tylko wtedy, gdy poprawiają rezultat.
Lokalizacja wymaga również osobnego odsłuchu. Zgodnie z przewodnikiem produktu, generowanie w tym samym języku zachowuje oryginalny akcent głosu referencyjnego, podczas gdy generowanie międzyjęzykowe przyjmuje naturalną wymowę języka docelowego zamiast przenosić akcent języka źródłowego.
Takie zachowanie może pasować do lokalizowanego samouczka produktu, ale fikcyjna postać z celowo rozpoznawalnym obcym akcentem może wymagać dodatkowego kierunku. Oddzielnie oceń wymowę, tożsamość i zamierzony akcent; głos może brzmieć płynnie, a mimo to mijać się z założeniem kreatywnym.
Latencja i niezawodność
Dla produkcyjnego agenta głosowego synteza mowy to tylko część opóźnienia. Rozpoznawanie mowy, detekcja tury, wynik modelu językowego, transmisja sieciowa i buforowanie audio — wszystko to wpływa na moment, gdy użytkownik słyszy odpowiedź.
Mierz zarówno medianę, jak i wolniejszy „ogon” czasów odpowiedzi w swojej aplikacji. Niska mediana może współistnieć z okazjonalnymi pauzami, które frustrują rozmowę.
Eleven v4 vs v4 Turbo: Koszt
Oficjalne ceny API za znaki
Poniższe porównanie natywnego API używa opublikowanych stawek sprawdzonych 19 października 2026. Sumy wolumenów to obliczenia z tych stawek, a nie oddzielne oferty pakietowe.
Użycie — oficjalne ceny API
Wariant standardowy
Wariant Turbo
Obliczona oszczędność z Turbo
1,000 znaków
$0.08
$0.04
$0.04
100,000 znaków
$8.00
$4.00
$4.00
1 milion znaków
$80.00
$40.00
$40.00
10 milionów znaków
$800.00
$400.00
$400.00
Liczby te opisują generowanie mowy na podstawie liczby znaków, a nie cały rachunek za agenta głosowego. Limity abonamentu, inne usługi i właściwe warunki handlowe należy rozważać osobno.
Cennik i warunki rozliczeń w CometAPI
CometAPI prezentuje ceny denominowane w tokenach, podczas gdy powyższe stawki natywne są za znaki. Porównuj koszty dopiero po potwierdzeniu, jak wybrany punkt końcowy mierzy i rozlicza zużycie. Jeśli potrzebujesz Turbo, potwierdź, że model jest dostępny na wybranej trasie CometAPI przed planowaniem integracji.
Koszt na zaakceptowane nagranie lub interakcję
Do budżetowania użyj:
Koszt generowania mowy = rozliczalne znaki ÷ 1,000 × właściwa stawka za znak
W produkcji treści bardziej użyteczną miarą operacyjną jest koszt na zaakceptowane nagranie. Uwzględnij regenerowane ujęcia i czas montażu. Jeśli tańszy wariant wielokrotnie nie radzi sobie z trudną interpretacją, jego przewaga w cenie jednostkowej może maleć.
Dla agentów na żywo porównaj koszt ukończonych interakcji przy wymaganej jakości i czasie reakcji. Niski rachunek za syntezę ma ograniczoną wartość, jeśli użytkownicy porzucają wolne lub mylące rozmowy.
Eleven v4 vs v4 Turbo: Porównanie i wybór
Zdolności i wybór według obciążenia
Poniższe rekomendacje łączą opublikowane pozycjonowanie z praktycznymi kryteriami oceny. To punkty wyjścia do testów, a nie dodatkowe wyniki benchmarków.
Projekt
Rekomendowany punkt startu
Decydująca ocena
Audiobook lub dokument
Wariant standardowy
Spójność w fragmentach i regenerowanych kwestiach
Dramatyczna scena postaci
Wariant standardowy
Emocjonalna realizacja i interakcja między mówcami
Agent wsparcia klienta
Turbo
Czas do słyszalnej odpowiedzi, wymowa i obsługa przerywania
Interaktywna postać w grze
Turbo
Responsywność i wydajność podczas krótkich tur
Proste klipy instruktażowe
Przetestuj oba
Czy słuchacze zauważają istotną różnicę jakości
Produkcja wielojęzyczna
Testuj oba per język
Wymowa, akcent i tożsamość głosu
Produkt z nagraniami i mową na żywo
Oddzielne trasowanie
Czy każda trasa spełnia swoje kryteria akceptacji
Dla audiobooków, reklam i scen dramatycznych przetestuj Eleven v4 na neutralnym fragmencie, emocjonalnym fragmencie i regenerowanej kwestii wstawionej do istniejącego nagrania. Słuchaj spójności tożsamości głosu, tempa i wymowy na łączeniach. Wybierz wariant standardowy, gdy zaakceptowana realizacja lub oszczędność czasu w montażu uzasadniają wyższy koszt generowania.
Dla agentów wsparcia i interaktywnych postaci testuj Turbo w całej rozmowie: mowa użytkownika, detekcja tury, generowanie odpowiedzi, synteza i odtwarzanie. Uwzględnij wolne łącza, awarie połączeń i przerwania. Potwierdź, że odtwarzanie szybko się zatrzymuje, gdy użytkownik przerywa, i że kolejna odpowiedź zaczyna się płynnie. Wybierz Turbo, gdy spełnia i próg jakości odsłuchu, i cel czasu reakcji.
Zbuduj reprezentatywny zestaw testowy: uwzględnij neutralne wyjaśnienie, uspokajającą odpowiedź, emocjonalny fragment, nazwy lub skróty oraz tekst wielojęzyczny używany przez Twoją publiczność.
Utrzymaj skrypt, głos i ustawienia wyjścia możliwie porównywalne w każdym interfejsie.
Przeglądaj nagrania bez etykiet modeli. Zapisuj błędy wymowy, niespójną tożsamość głosu i korekty potrzebne dla każdego ujęcia.
Oddzielnie mierz czas odpowiedzi na żywo od jakości odsłuchu, uwzględniając zarówno medianę, jak i wolniejszy ogon opóźnień.
Ustal progi akceptacji przed wyborem trasy: wymowa, spójność głosu, nakład montażu, medianowy czas reakcji i wolniejszy ogon czasów reakcji.
Przepuść reprezentatywny ruch przez punkt końcowy, który wdrożysz. Śledź odrzucone wyniki, ponowienia oraz awarie odtwarzania lub połączenia.
Porównaj koszt na zaakceptowane nagranie lub ukończoną interakcję, uwzględniając regenerowane ujęcia i wysiłek montażowy.
W produktach z nagraniami i mową na żywo przetestuj oddzielne trasowanie i potwierdź, że każda trasa spełnia własne progi akceptacji.
Gdzie uzyskać dostęp do Eleven v4 i v4 Turbo?
Dostęp u oficjalnego dostawcy
Użyj natywnej trasy dostawcy dopasowanej do obciążenia: generowana mowa i dialog do produkowanych nagrań oraz strumieniowanie Text to Dialogue WebSocket do interakcji Turbo. Oficjalny przykład poniżej dokumentuje połączenie strumieniowe i jego ograniczenia rejestracji głosu. Przed podłączeniem obciążenia produkcyjnego zweryfikuj bieżący schemat punktu końcowego, wymagania uwierzytelniania i limity konta.
Ta sama referencja określa dokładnie jeden zarejestrowany głos na połączenie Turbo, w porównaniu z maksymalnie dziesięcioma dla wariantu standardowego na tym punkcie. To reguły na poziomie połączenia, a nie uniwersalne stwierdzenie o każdym interfejsie.
Dostęp przez CometAPI
Eleven v4 API in CometAPI zapewnia trasę do generowania mowy przez interfejs zgodny z Runway. Ogłoszenie integracji z 10 października 2026 dokumentuje zachowania specyficzne dla dostawcy podsumowane poniżej.
Szczegół integracji — ogłoszenie CometAPI
Opublikowane zachowanie
Model ID
eleven_v4
Punkt końcowy zgłoszenia
POST /runwayml/v1/text_to_speech
Przetwarzanie
Asynchroniczne zgłaszanie zadań
Wyjście
Audio MP3
Limit wejściowy
Do 2,500 znaków na żądanie
Konfiguracja głosu
Głosy predefiniowane
Dodatkowa kontrola
Regulowana szybkość mowy
To detale specyficzne dla tej integracji. Natywny limit 10,000 znaków i natywne kontrolki interfejsu nie powinny zastępować udokumentowanego działania tego interfejsu. Podobnie, asynchroniczny przepływ pracy nie oznacza, że natywna wydajność WebSocket Turbo jest dostępna tą trasą.
Praktyczna sekwencja integracji to zgłoszenie krótkiego skryptu, podążenie udokumentowanym przepływem statusu zadania, pobranie wyniku i sprawdzenie wymowy oraz długości wyjścia przed zwiększeniem wolumenu.
Wnioski
Wybierz Eleven v4, gdy zaakceptowane nagrania zapewniają taką jakość wykonania lub oszczędności produkcyjne, które uzasadniają wyższą stawkę za znak. Wybierz Eleven v4 Turbo, gdy spełnia Twój próg jakości odsłuchu i wspiera responsywność wymaganą dla rozmowy na żywo. Ostateczną decyzję podejmij dla punktu końcowego, który wdrożysz, uwzględniając reprezentatywne skrypty, ponowienia i całkowity koszt operacyjny.
FAQ
Jak dzielić długie skrypty Eleven v4 do produkcji?
Dziel na granicach akapitów, zdań lub scen, a nie w środku wyrazu czy tury mówcy. Zostaw miejsce na tekst wskazówek w ramach dozwolonego wejścia punktu końcowego, prowadź rejestr skryptu i ustawień głosu dla każdego segmentu i przesłuchaj łączenia po złożeniu audio. Porównaj głośność, tempo, wymowę i tożsamość głosu na granicach; akceptacja każdego klipu osobno nie dowodzi, że połączone nagranie będzie płynne. Używaj limitu faktycznego punktu końcowego dostawcy, ponieważ limity żądań natywne i w CometAPI różnią się.
Jak ponowić przerwone żądanie Eleven v4?
Śledź oryginalny identyfikator żądania lub zadania i ustal jego stan, zanim wyślesz ten sam tekst ponownie. W asynchronicznym przepływie dostawcy sprawdź, czy oryginalne zadanie zostało ukończone i czy jego wynik nadal można pobrać. W strumieniu na żywo zanotuj, które audio już odtworzono, i zdecyduj, czy powtórzyć kwestię, czy odzyskać na czystej granicy. Potwierdź zasady dotyczące ponowień, idempotencji i rozliczeń dla punktu końcowego; nie zakładaj, że powtórzenie żądania jest bezpłatne lub da identyczne audio.
Jak zespoły mogą testować regresję wydania głosu Eleven v4?
Utrzymuj stały zestaw akceptacyjny zawierający nazwy marek, skróty, liczby, trudne wymowy, emocjonalne fragmenty i języki używane w produkcie. Archiwizuj skrypt, identyfikator modelu, identyfikator głosu, dostępne ustawienia, datę generowania i zaakceptowane nagrania referencyjne. Gdy zmienia się model, głos lub integracja, odsłuchaj nowe próbki względem referencji i udokumentuj wymagane korekty. Oddziel procedurę testową możliwą do odtworzenia od założenia identycznych przebiegów fal: zaliczenie jednego nagrania nie gwarantuje, że każde kolejne przejdzie.