
TL;DR
Gemini 4 Argon nie jest uwzględniony w bezpłatnym poziomie Gemini API, a sama subskrypcja Google AI Pro nie zapewnia dostępu do Argon przez API. Google AI Ultra może zapewnić dostęp poprzez wybrane produkty Gemini, natomiast płatne użycie API jest rozliczane osobno. CometAPI oferuje niezależną ścieżkę API bez wymagania, by każdy użytkownik końcowy posiadał subskrypcję Google AI Pro lub Ultra. Opublikowane stawki za niekeszowane wejście/wyjście to odpowiednio 1,60 USD i 8 USD za milion tokenów, w porównaniu z wprowadzającymi stawkami Standard Google na poziomie 2 USD i 10 USD.
Dostęp i stawki głównych dostawców sprawdzone 16 października 2026 r.
Najważniejsze informacje
- Cena wprowadzająca: 2 USD / 1 mln tokenów wejścia i 10 USD / 1 mln tokenów wyjścia; od 1 grudnia stawki się podwajają.
- Zkeszowane wejście: 95% zniżki dla kwalifikujących się trafień implicitnego cache; minimum cache to 4 096 tokenów promptu.
- Rozliczenie wyjścia obejmuje tokeny rozumowania; wejście, rozumowanie i widoczne wyjście współdzielą budżet 1 048 576 tokenów.
- Oddziel subskrypcje aplikacji Gemini od uprawnień Antigravity i płatnego dostępu API. Brak modelu w jednym produkcie nie dowodzi, że każdy kanał dostępu jest niedostępny.
- CometAPI zapewnia niezależną ścieżkę API z niższymi opublikowanymi stawkami dla niekeszowanego wejścia i wyjścia. Aplikacje mogą obsługiwać wielu użytkowników końcowych w ramach jednego konta CometAPI bez wymagania, by każdy utrzymywał subskrypcję Google AI Pro lub Ultra; wciąż obowiązują limity na poziomie konta: przydziału, salda, stawek i współbieżności.
Jakie są obecne ograniczenia dostępu do Gemini 4 Argon w Google?
Pierwszą decyzją jest, gdzie potrzebujesz Argon: w interaktywnej aplikacji, lokalnym środowisku programistycznym czy integracji API. Ogłoszenie dostępu dla deweloperów rozróżnia płatny dostęp przez Gemini API od dostępu dla abonentów Ultra w AI Studio i Antigravity. Nie interpretuj ograniczenia subskrypcji Antigravity jako wymogu zakupu Ultra dla każdego płatnego scenariusza API.
Dla aplikacji API CometAPI zapewnia alternatywne konto i rozliczanie. Jest to przydatne, gdy chcesz ocenić Argon obok innych modeli bez kupowania konsumenckiej subskrypcji Google w tym celu. Nie zmienia to praw dostępu w aplikacjach Google i nie należy opisywać tego jako nieograniczonego użycia.
Ile kosztuje Gemini 4 Argon przez API?
Standardowe stawki Gemini 4 Argon Google obowiązują do 30 listopada 2026 r., a wyższe stawki od 1 grudnia. Wszystkie kwoty poniżej to USD za milion tokenów, o ile nie zaznaczono inaczej. Batch, Flex i Priority mają odrębne stawki.
| Kategoria rozliczeń (USD / 1 mln tokenów) | Google Standard: do 30 lis 2026 | Google Standard: od 1 gru 2026 | Gemini 4 Argon API w CometAPI |
|---|---|---|---|
| Wejście | 2,00 USD | 4,00 USD | 1,60 USD |
| Zkeszowane wejście | 0,10 USD | 0,20 USD | 0,16 USD |
| Wyjście, w tym rozumowanie | 10,00 USD | 20,00 USD | 8,00 USD |
Stawki CometAPI sprawdzono 14 października 2026 r. Opublikowane ceny wejścia i wyjścia są o 20% niższe od wprowadzających stawek Standard Google. Wartość dla zkeszowanego wejścia pochodzi z kalkulatora kosztów CometAPI; przed przyjęciem jej do budżetu potwierdź aktywną stawkę konta i kwalifikowalność cache. Zmiana cen Google w grudniu nie determinuje przyszłych stawek CometAPI; przy budżetowaniu sprawdzaj stawki widoczne na swoim koncie CometAPI.
Przy tych stawkach 200 000 niekeszowanych tokenów wejścia plus 60 000 rozliczanych tokenów wyjścia kosztuje 0,80 USD przez CometAPI, w porównaniu z 1,00 USD przez Google w okresie wprowadzającym. Ten przykład nie obejmuje narzędzi i ponowień.
Ile kosztuje Gemini 4 Argon w realistycznych obciążeniach?
Poniższe scenariusze to przykłady kalkulacji, a nie zmierzone użycie modelu. Wejście jest niekeszowane; wyjście obejmuje zarówno rozumowanie, jak i widoczny tekst. Żądanie agenta kodującego z 200 000 tokenów wejścia i 60 000 rozliczanych tokenów wyjścia kosztuje 1,00 USD w okresie wprowadzającym i 2,00 USD później. Powtórzenie tego samego obciążenia 1 000 razy kosztuje 1 000 USD lub 2 000 USD przed ponowieniami, narzędziami i podatkami.
| Przykładowe żądanie | Niekeszowane tokeny wejścia | Rozliczane tokeny wyjścia | Cena w okresie wprowadzającym | Cena standardowa |
|---|---|---|---|---|
| Krótka odpowiedź asystenta | 5K | 1K | 0,02 USD | 0,04 USD |
| Analiza dokumentu | 100K | 10K | 0,30 USD | 0,60 USD |
| Złożony agent kodujący | 200K | 60K | 1,00 USD | 2,00 USD |
| Przepływ badawczy | 500K | 100K | 2,00 USD | 4,00 USD |
| Żądanie z długim dekodowaniem | 100K | 500K | 5,20 USD | 10,40 USD |
Wzór: Koszt = (niekeszowane tokeny wejścia × stawka wejścia + zkeszowane tokeny wejścia × stawka cache + rozliczane tokeny wyjścia × stawka wyjścia) / 1 000 000. Powyższe przykłady są poglądowe i zakładają brak cache.
Jak obniżyć koszty Gemini 4 Argon przez API?
Implicitne buforowanie i ponownie używane prefiksy promptu
Buforowanie zmniejsza wydatki na ponownie użyte wejście, a nie cały koszt żądania. Dla przykładu 200K wejścia / 60K wyjścia pełne kwalifikujące się trafienie cache obniża wprowadzający koszt wejścia z 0,40 USD do 0,02 USD. Łączny koszt tokenów staje się 0,62 USD zamiast 1,00 USD: spadek o 38%, mimo że zniżka na wejście wynosi 95%. Jeśli 50% tokenów wejścia jest obsłużone z cache, to samo żądanie kosztuje 0,81 USD: 100 000 zkeszowanych tokenów wejścia × 0,10 USD / 1 mln + 100 000 niekeszowanych tokenów wejścia × 2 USD / 1 mln + 60 000 rozliczanych tokenów wyjścia × 10 USD / 1 mln = 0,01 USD + 0,20 USD + 0,60 USD. Tutaj 50% odnosi się konkretnie do wolumenu tokenów wejścia. Traktuj to jako scenariusze i używaj zaobserwowanego użycia tokenów z cache do prognozowania.
Google włącza implicitne buforowanie dla promptów o długości co najmniej 4 096 tokenów i nie obsługuje jawnego tworzenia cache dla Argon. Zachowuj wielokrotnego użytku prefiksy promptu, ale budżetuj jak za niekeszowane wejście, dopóki zaobserwowane trafienia cache nie uzasadnią niższego oszacowania.
Poziomy rozumowania i koszt wyjścia
Krótka widoczna odpowiedź może nadal nieść istotny koszt wyjścia, ponieważ rozumowanie jest rozliczane. Zacznij od średniego poziomu rozumowania, a następnie przetestuj niższe i wyższe poziomy na reprezentatywnych zadaniach. Śledź zarówno jakość, jak i łączne użycie wyjścia; wybierz najniższy poziom rozumowania, który spełnia Twoje kryteria akceptacji.
Ponieważ rozumowanie i widoczne wyjście współdzielą limit odpowiedzi, niska wartość max_output_tokens może pozostawić zbyt mało miejsca na finalną odpowiedź. Porównaj skuteczne ukończenie zadania na każdym poziomie rozumowania przed obniżeniem limitu wyjścia.
Kontrole operacyjne kosztów Gemini 4 Argon
- Używaj realistycznych limitów wyjścia i unikaj zbędnie długich generacji.
- Ponownie wykorzystuj wspólne prefiksy promptu, gdy kwalifikują się do implicitnego cache.
- Kieruj proste zadania do tańszych modeli, zachowując Argon dla trudnych przypadków.
- Loguj łączne rozliczane tokeny, niepowodzenia, ponowienia i koszt na udane zadanie.
- Oceń ekonomikę przy stawkach po zakończeniu promocji, zanim zobowiążesz się do dużego wdrożenia.
Jak uzyskać dostęp do Gemini 4 Argon?
Wybierz dostęp przez aplikację Gemini do osobistej pracy interaktywnej i płatną ścieżkę API do aplikacji oraz zautomatyzowanych agentów. Argon jest wyłączony z bezpłatnego poziomu Gemini API; sama subskrypcja Google AI Pro nie zapewnia dostępu do Argon przez API. Uprawnienia w aplikacjach Pro i Ultra są oddzielone od rozliczania tokenów w API, a Ultra nie jest wymagana do płatnego Gemini API.
| Ścieżka dostępu | Dostęp do Argon | Rozliczanie / uprawnienia |
|---|---|---|
| Aplikacja Gemini | Uprawnieni abonenci Pro i Ultra | Subskrypcja i limity aplikacji |
| Google AI Studio | Uprawnieni abonenci Ultra lub płatni użytkownicy API | Zależne od ścieżki dostępu |
| Gemini API | Uprawnione płatne projekty | Rozliczanie wg użycia API |
| Google Antigravity | Uprawnieni abonenci Ultra | Uprawnienia specyficzne dla produktu |
| CometAPI | Obsługiwane konta CometAPI | Stawki i warunki CometAPI |
Bezpośrednia integracja z Gemini 4 Argon przez API
Deweloperzy mogą integrować Gemini 4 Argon bezpośrednio poprzez uprawniony, płatny projekt Gemini API. Identyfikator modelu to gemini-4-argon. Ta ścieżka jest przeznaczona dla aplikacji, zautomatyzowanych agentów i produkcyjnych przepływów pracy, które wymagają bezpośredniego dostępu do API Google, rozliczania wg użycia i oficjalnych funkcji API.
Bezpłatny poziom Gemini API nie obejmuje Argon. Dostęp w aplikacjach Google AI Pro również nie zapewnia automatycznie dostępu przez API ani kredytów API. Deweloperzy powinni skonfigurować rozliczanie i uprawnienia dla projektu powiązanego z ich poświadczeniami API.
Błędy uwierzytelnienia, rozliczeń lub uprawnień muszą zostać rozwiązane dla projektu, który jest właścicielem klucza, zanim spróbujesz ponownie; zmiana konsumenckiej subskrypcji sama w sobie nie konfiguruje rozliczania API.
Dostęp do Gemini 4 Argon przez CometAPI
Deweloperzy mogą uzyskać dostęp do Gemini 4 Argon API w CometAPI poprzez osobne konto i klucz API. Praktyczne zalety to niezależne rozliczanie API, dostęp do wielu modeli u jednego dostawcy i opublikowane stawki wejścia/wyjścia porównane powyżej. Ta ścieżka nie wymaga zakupu Google AI Pro ani Ultra jako subskrypcji konsumenckiej.
Dostęp oparty na koncie nie jest obietnicą nieograniczonej przepustowości. Potwierdź dostępność modelu, saldo, limity stawek i współbieżności, obsługiwane regiony, buforowanie, kontrolę poziomu rozumowania i raportowanie użycia dla swojego konta CometAPI. Dostęp przez API nie odblokowuje też Argon w aplikacji Gemini ani w Antigravity.
Zacznij od małego żądania przez wybranego dostawcę, zweryfikuj zwrócone pola model i usage, a następnie ustaw limit wydatków przed zwiększeniem ruchu.
Czy Gemini 4 Argon jest wart swojej ceny?
Gemini 4 Argon to kandydat do wymagającego rozumowania, kodowania, badań i pracy z długim kontekstem. Jego wartość zależy od tego, czy poprawia odsetek udanych zadań lub zmniejsza liczbę ponowień na tyle, by uzasadnić wydatki na tokeny. Użyj specyfikacji i opublikowanych benchmarków poniżej, aby zidentyfikować obciążenia do testów, a następnie oceń jakość i koszt własnymi promptami, narzędziami i wybraną ścieżką dostępu.
Specyfikacja Gemini 4 Argon
| Specyfikacja | Gemini 4 Argon |
|---|---|
| Identyfikator modelu | gemini-4-argon |
| Deweloper | Google DeepMind |
| Typ modelu | Model multimodalny ukierunkowany na rozumowanie |
| Ujednolicone okno wejście + rozumowanie + wyjście | Do 1 048 576 tokenów łącznie |
| Poziomy rozumowania | Niski / średni / wysoki |
| Domyślny poziom rozumowania | Średni |
| Obsługa długiego wyjścia | Wykonywanie w tle; maksimum zależne od wspólnego budżetu |
| Pamięć podręczna kontekstu | Implicitna; kwalifikujące się prompty ≥ 4 096 tokenów |
| Jawna pamięć podręczna | Nieobsługiwana |
Limit miliona tokenów jest współdzielony między wejście, rozumowanie i generowane wyjście. W Interactions API wygenerowanie ponad 65 536 tokenów wymaga zarówno background=True, jak i generation_config.max_output_tokens powyżej 65 536. Ustawienie samego background=True nie podnosi domyślnego limitu wyjścia. GenerateContent API obsługuje także kontynuację po stronie klienta dla długiego dekodowania
Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5: opublikowane benchmarki
Poniższe wartości odpowiadają opublikowanym przez Google wynikom ewaluacji. To wyniki publikowane przez dostawców, zebrane z wielu źródeł ewaluacyjnych, a nie nowa kontrolowana próba porównawcza przygotowana na potrzeby tego artykułu.
| Opublikowany benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Vals Index | 68,9% | 63,1% | 67,0% |
| AutomationBench | 51,3% | 41,4% | 42,5% |
| Vals Finance Agent v2 | 65,4% | 53,5% | 58,6% |
| DeepSWE v1.1 | 77,9% | 74,1% | 74,2% |
| FrontierSWE v2 | 55,0% | 65,5% | 62,3% |
| Terminal-bench 4.0 | 57,4% | 58,2% | 66,4% |
| GraphWalks 256K–1M, BFS F1 | 84,2% | 71,8% | 66,8% |
| LVBench | 91,7% | 87,5% | 83,7% |
Warunki ewaluacji i porównywalność
Eksperymenty ewaluacyjne Google korzystają z Gemini API na najwyższym ustawieniu rozumowania, chyba że wskazano inaczej, zazwyczaj z pass@1. DeepSWE używa mini-swe dla Argon; dane konkurentów pochodzą z rankingów lub kart systemowych. GraphWalks 256K–1M używa 200 zadań. LVBench działa bez narzędzi, z 1 FPS dla Gemini, 800 klatek dla GPT-6 Astra i 600 dla Opus 5.5. Wyniki Vals pochodzą z Vals AI; AutomationBench używa prywatnego rankingu Zapier. Te różnice ograniczają bezpośrednią porównywalność.
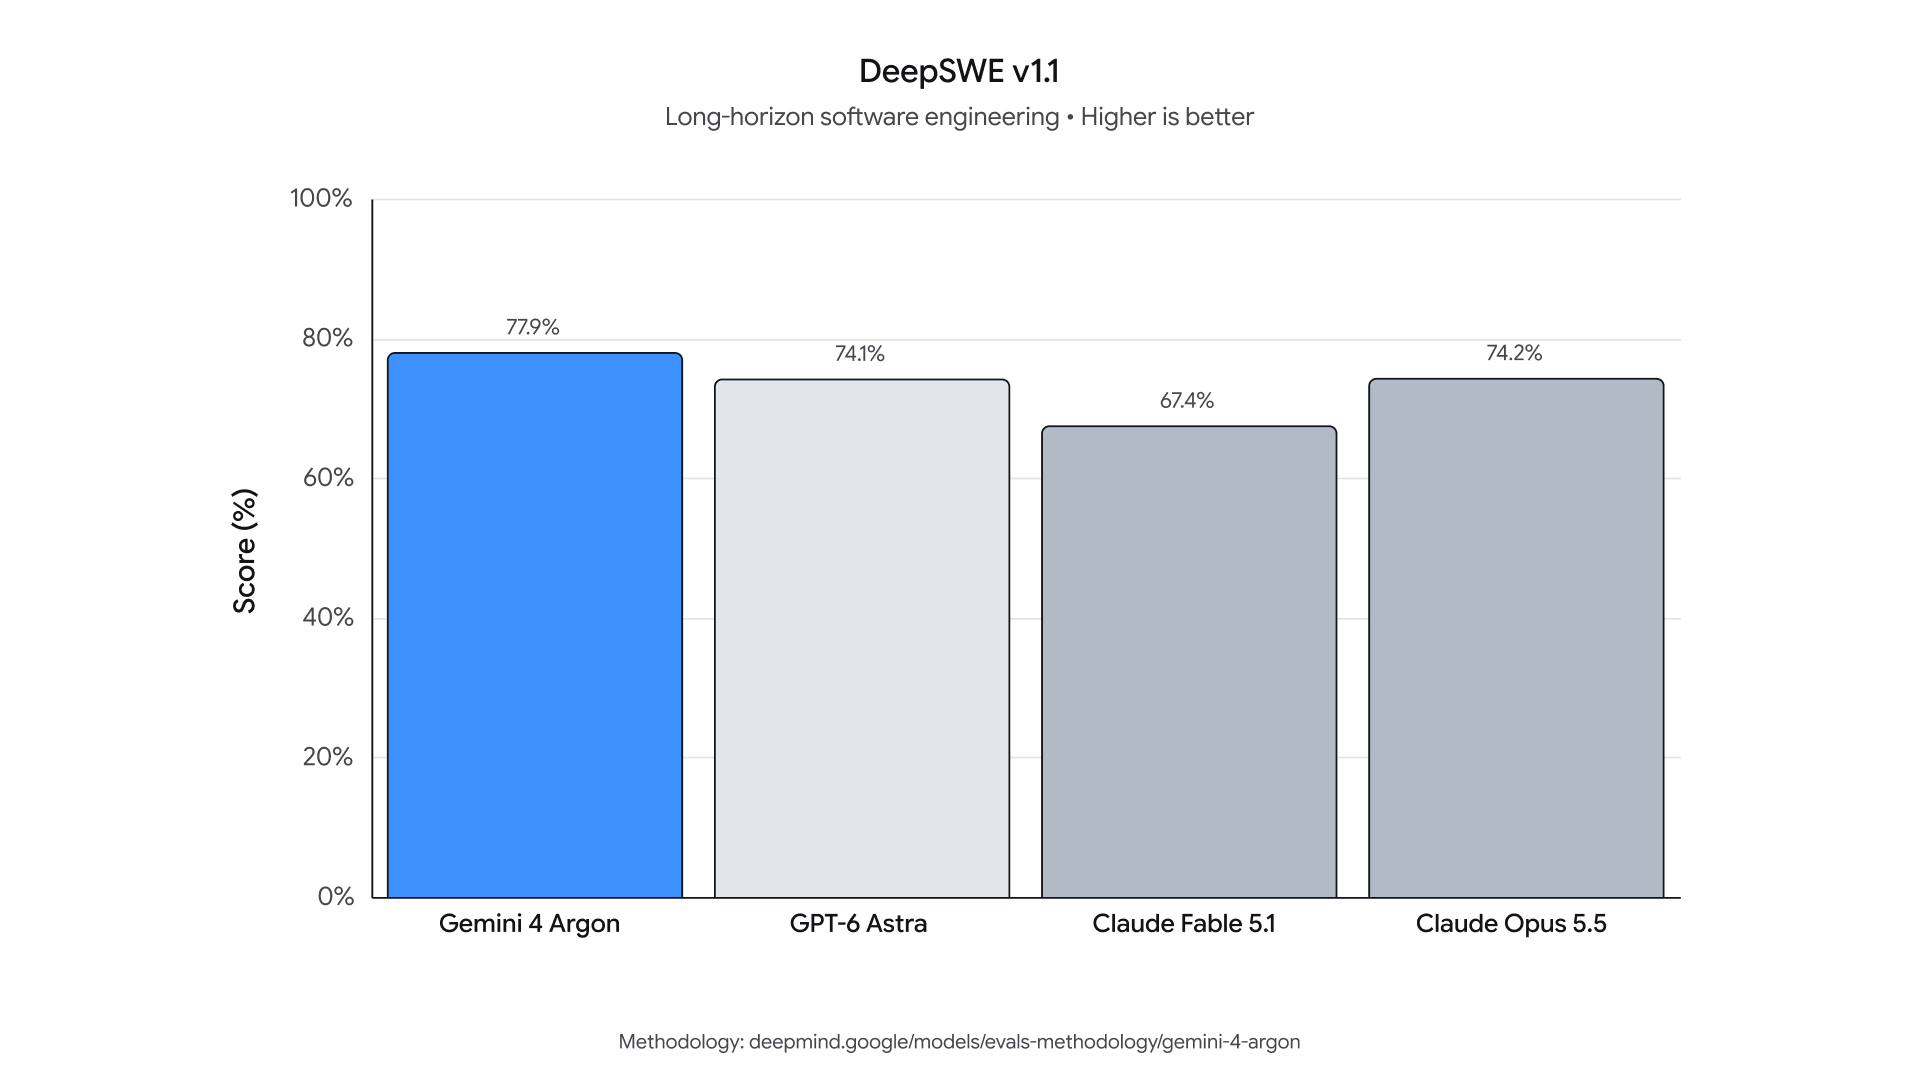
Oryginalny wykres DeepSWE v1.1 Google pokazuje, od lewej do prawej, Gemini 4 Argon (77,9%), GPT-6 Astra (74,1%), Claude Fable 5.1 (67,4%) i Claude Opus 5.5 (74,2%). Powyższa tabela wybiera trzy z tych modeli; oficjalna grafika obejmuje wszystkie cztery.
Implikacje wydajnościowe dla użytkowników Gemini 4 Argon
Interpretacja: Argon prowadzi w wybranych wierszach Vals Index, AutomationBench, finansowym agencie i długim kontekście; nie prowadzi w FrontierSWE ani Terminal-bench. Ponieważ harnessy ewaluacyjne i prompty mogą się różnić, traktuj te wyniki jako wskazówkę i uruchamiaj testy specyficzne dla Twoich obciążeń.
Na potrzeby zakupów mierz koszt udanego zadania obok dokładności, opóźnień, ponowień i użycia tokenów. Wyższy opublikowany wynik nie przesądza o niższym koszcie produkcyjnym pod Twoje prompty, narzędzia i ścieżkę dostępu.
Wybór: Gemini 4 Argon czy tańszy model
Testuj Argon w trudnych zadaniach dotyczących rozumowania, kodowania i długiego kontekstu, gdzie mniej ponowień lub wyższy odsetek ukończeń może uzasadnić większe wydatki na tokeny. Do rutynowej klasyfikacji, ekstrakcji i hurtowych streszczeń najpierw przetestuj tańsze modele.
Porównuj łączny koszt na udane zadanie, łącznie z tokenami rozumowania, użyciem cache, wywołaniami narzędzi i ponowieniami. Wybierz model i ścieżkę dostępu, które spełniają wymagania jakościowe przy akceptowalnym koszcie.
FAQ
Czy Gemini 4 Argon Batch i Flex są tańsze niż Standard?
Stawki tokenowe Argon Batch i Flex w Google to 1 USD za wejście i 5 USD za wyjście za milion tokenów do 30 listopada 2026 r., rosnące do 2 USD i 10 USD później. Zkeszowane wejście to 0,05 USD, rosnące do 0,10 USD. To odrębne opcje przetwarzania, więc zweryfikuj ich ograniczenia operacyjne względem Twojego obciążenia, zanim zastąpisz integrację Standard.
Szacuj użycie Standard, Batch i Flex osobno z zastosowaniem właściwych stawek dla każdej opcji, a następnie zsumuj subtotale dla budżetu mieszanego obciążenia.
Czy szacunki tokenów Gemini 4 Argon obejmują opłaty za wyszukiwanie?
Nie. Aritmetyka tokenów z wyłączeniem usług rozliczanych osobno. Opłata za Search grounding Google to 14 USD za 1 000 zapytań po wspólnej miesięcznej puli 5 000 żądań dla Gemini 3 i nowszych modeli. Jedno zgłoszone żądanie może wykonać więcej niż jedno zapytanie, więc śledź rzeczywiste użycie grounding osobno, zamiast zakładać, że jeden prompt użytkownika równa się jednemu rozliczanemu zapytaniu.
Jak budżetować Gemini 4 Argon przez zmianę cen?
Podziel prognozowane użycie tokenów na okres wprowadzający i standardowy, a następnie zastosuj stawki właściwe dla każdego okresu. Na przykład 10 mln niekeszowanych tokenów wejścia plus 1 mln tokenów wyjścia kosztuje 30 USD przy wprowadzających stawkach Standard lub 60 USD później. Jeśli połowa tego wolumenu przypada na każdy okres, szacunek tokenowy wynosi 45 USD. Dodaj osobno koszty narzędzi i ponowień i używaj stawek po promocji do budżetu stanu ustalonego.
Dlaczego odpowiedź Gemini 4 Argon może zatrzymać się przed ukończeniem?
Limit wyjścia obejmuje rozumowanie oraz widoczny tekst. Wymagający prompt może wyczerpać to ograniczenie zanim finalna odpowiedź zostanie ukończona. Dla długich odpowiedzi wykonywanie w tle kontynuuje generację skokami aż do ukończenia lub osiągnięcia ustawionego limitu; nadal potrzebna jest odpowiednia wartość max_output_tokens. Sprawdź status zakończenia i użycie, a następnie dostosuj głębokość rozumowania lub limit zamiast wielokrotnego wysyłania tego samego niedobudżetowanego żądania.
Wnioski końcowe
Dobierz dostęp do Gemini 4 Argon według przepływu pracy, a następnie porównuj koszt wykonania użytecznego zadania. Uprawnienia aplikacji Google i Antigravity różnią się od płatnego dostępu API. CometAPI oferuje odrębną ścieżkę API z opublikowanymi cenami wejścia/wyjścia o 20% niższymi niż wprowadzające stawki Standard Google, co czyni ją praktyczną opcją do małej, budżetowanej ewaluacji. Weryfikuj limity konta i wymagane funkcje, śledź tokeny rozumowania i ponowienia, a skaluj dopiero wtedy, gdy jakość i łączny koszt spełniają Twoje wymagania.