

TL;DR
Google ogłosiło 28 października 2026 r. model Gemini 4 Carbon, z opublikowanymi wynikami silniejszymi niż Gemini 4 Argon w zakresie kodowania, rozumowania na długim kontekście i cyberbezpieczeństwa. Dla deweloperów natychmiastowy wybór zależy od dostępu: Argon jest dostępny przez płatne Gemini API, podczas gdy Carbon pozostaje w ograniczonym wdrożeniu. Niniejsze porównanie omawia ich benchmarki, specyfikacje API, szybkość i ceny, aby pomóc zdecydować, co wdrożyć teraz i kiedy ocenić Carbon.
Najważniejsze wnioski
- Performance: Carbon uzyskuje 59 wobec 50 Argona w Artificial Analysis Intelligence Index v5.0. Zyski różnią się w zależności od benchmarku: SWE-sweep poprawia się o 5,3 punktu procentowego, a GraphWalks BFS F1 o 12,0 punktów.
- API specifications: Argon dokumentuje zunifikowane okno 1,048,576 tokenów współdzielone przez wejście, rozumowanie i wyjście. Publiczne limity API i wsparcie narzędzi dla Carbon nie zostały ogłoszone.
- Pricing: Oba modele mają ogłoszone stawki wprowadzające: $2 za milion tokenów wejściowych i $10 za milion tokenów wyjściowych. Oferta Argona trwa do 30 listopada 2026 r.; koniec okresu wprowadzającego dla Carbon nie został ogłoszony.
- Upgrade decision: Porównuj współczynnik akceptacji zadań, opóźnienie end-to-end i koszt na zaakceptowany wynik przy ocenie Carbon. Wyższe wyniki benchmarków same w sobie nie pokazują, czy przełączenie poprawi Twoją aplikację.
Gemini 4 Carbon vs Gemini 4 Argon: przegląd i specyfikacje
Zacznij od decyzji wdrożeniowej: Argon ma udokumentowane API, którego możesz używać już teraz, podczas gdy Carbon oferuje silniejsze opublikowane wyniki przy ograniczonym początkowym dostępie.
Gemini 4 Carbon koncentruje się na wymagających przepływach inżynierskich i defensywnym cyberbezpieczeństwie, z początkowym dostępem ograniczonym do wybranych partnerów. Gemini 4 Argon jest dostępny przez płatne Gemini API dla rozumowania, kodowania, rozwiązywania problemów naukowych i przepływów agentów. Poniższa tabela porównuje ich specyfikacje API i ogłoszone możliwości.
Kontekst, rozumowanie i specyfikacje API
Argon ma opublikowaną specyfikację deweloperską. Carbon ma opublikowane wyniki ewaluacji, ale te wyniki nie ustalają dokładnych limitów ani wsparcia narzędzi przyszłego publicznego API. Ani wspólne oznaczenie rodziny, ani wyższe wyniki nie dowodzą, że modele wykorzystują identyczną architekturę.
Okno 1,048,576 tokenów w Argonie jest współdzielone przez wejście, rozumowanie i generowane wyjście, więc większe wejście pozostawia mniej miejsca na generację. Jego domyślny budżet generacji to 65,536 tokenów, obejmujących rozumowanie i wyjście. Dłuższe generacje używają long decode, które ponownie przetwarza wcześniejszy kontekst przez etapy kontynuacji i dodaje opłaty za tokeny wejściowe; powtarzany kontekst może kwalifikować się do zniżek implicitnego buforowania.
W Interactions API dłuższe generacje wymagają trybu w tle i wyższego ustawienia max_output_tokens. Z GenerateContent klient musi zarządzać żądaniami kontynuacji.
Gemini 4 Carbon vs Gemini 4 Argon: wydajność
Carbon prowadzi nad Argonem w całym raportowanym porównaniu, ale rozmiar i znaczenie zysków różnią się w zależności od zadania.
Oficjalne wyniki benchmarków i warunki testu
Opublikowane porównanie Google pokazuje przewagę Carbon w 17 wierszach poniżej. Łączy ewaluacje przeprowadzane przez Google z wynikami od zewnętrznych ewaluatorów i list liderów benchmarków; nie oznacza to twierdzenia, że Google niezależnie uruchomiło każdy test.
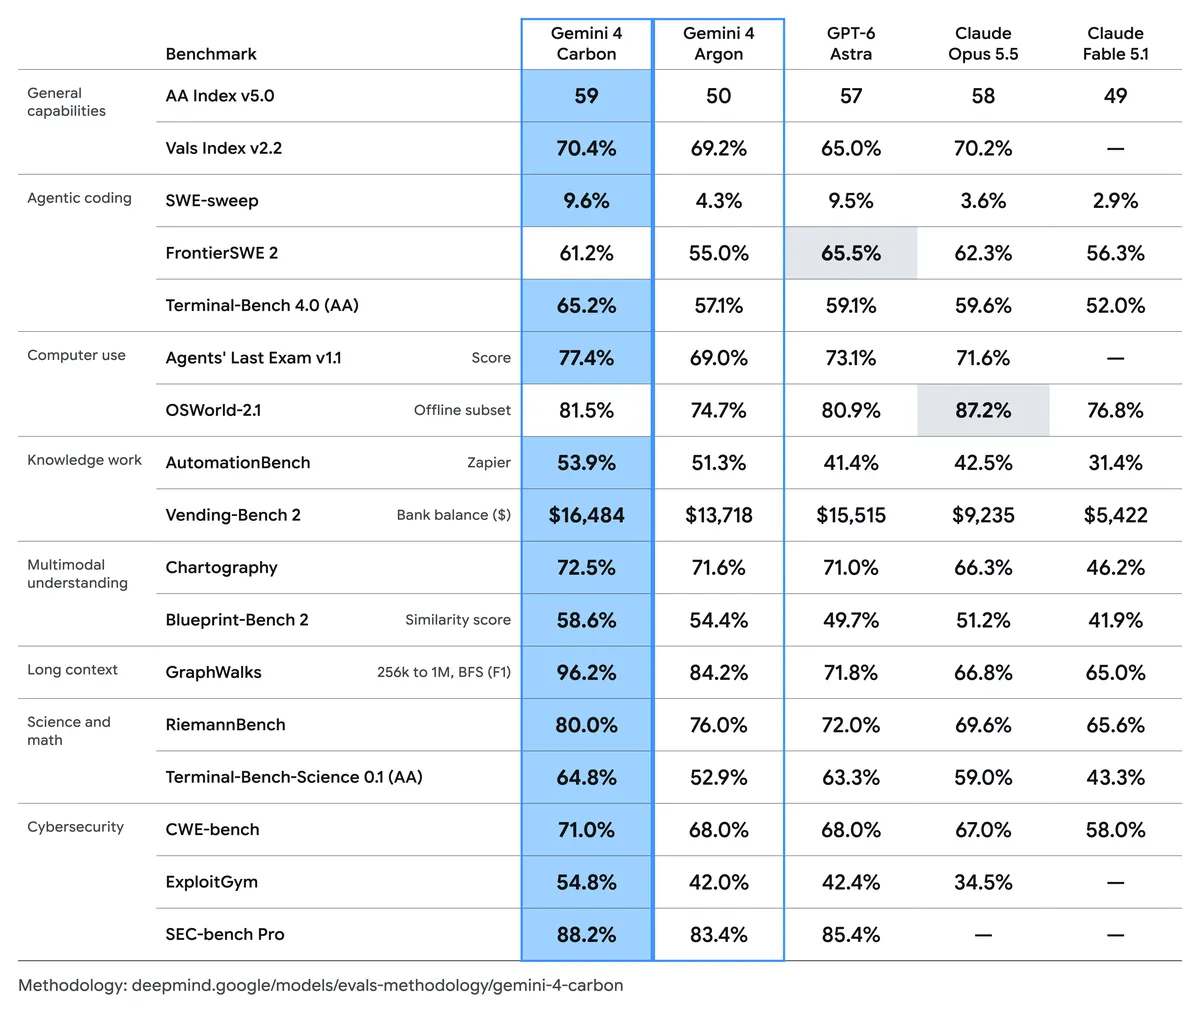
Metodologia ewaluacji ogólnie używa najwyższego ustawienia rozumowania i pass@1, chyba że benchmark stanowi inaczej. Szkielet agenta, podzbiory zadań i definicje wyniku różnią się, więc odsetki w różnych benchmarkach nie są wymienialne jeden do jednego.
pp = punkty procentowe. Vending-Bench 2 raportuje symulowany stan konta bankowego, a nie dokładność.
- GraphWalks: podzbiór 256K–1M zawiera 200 problemów i raportuje BFS F1, zamiast ogólnego wskaźnika dokładności.
- Agents' Last Exam: Google używa zestawu 122 zadań v1.1, środowiska ALE-Claw, pięciogodzinnego okna i włączonych filtrów bezpieczeństwa.
- OSWorld: Raportowana wartość używa 82-zadaniowego podzbioru offline, zrzutów ekranu 1080p, limitu 500 kroków i maksimum z trzech pojedynczych prób. Nie reprezentuje pełnego benchmarku online.
Wydajność w kodowaniu i praca na repozytoriach
W Terminal-Bench 4.0 Carbon uzyskuje 65,2%, w porównaniu z 57,1% dla Argona, co daje przewagę 8,1 punktu procentowego. Benchmark testuje pracę w wierszu poleceń i wieloetapowe rozwiązywanie problemów technicznych.
W SWE-sweep Carbon uzyskuje 9,6% wobec 4,3% dla Argona, przewaga 5,3 punktu procentowego i ponad dwukrotny wynik.
Ta względna poprawa jest uderzająca, ale wynik bezwzględny pozostaje poniżej 10%. Carbon jest silniejszy, lecz nie uniwersalnie niezawodny w każdym trudnym zadaniu inżynierii oprogramowania.
Praktycznymi kandydatami do ewaluacji są debugowanie całego repozytorium, migracje kodu oraz zadania wymagające powtarzalnego użycia narzędzi i weryfikacji. Dla produkcyjnej bazy kodu zaliczenie własnych testów pozostaje bardziej użyteczne niż ekstrapolacja współczynnika sukcesu z innego benchmarku.
Multimodalność i wydajność na długim kontekście
W ocenie GraphWalks 256K–1M BFS F1 Carbon osiąga 96,2% wobec 84,2% Argona, przewaga 12 punktów procentowych. Sprawia to, że synteza długich dokumentów i analiza repozytoriów są użytecznymi kandydatami do ewaluacji. Jakość wyszukiwania, struktura dokumentu i rzeczywiste limity każdego endpointu nadal wpływają na wynik.
W Chartography Carbon ma 72,5% wobec 71,6% Argona, przewaga 0,9 punktu procentowego. W Blueprint-Bench 2 Carbon uzyskuje 58,6% wobec 54,4% Argona, przewaga 4,2 punktu procentowego. Te wyniki w rozumieniu wizualnym wspierają testowanie przepływów dokumentów i wykresów, choć wspierane formaty wejścia przyszłego publicznego API Carbon wymagają potwierdzenia.
Cyberbezpieczeństwo i wiarygodność agentów
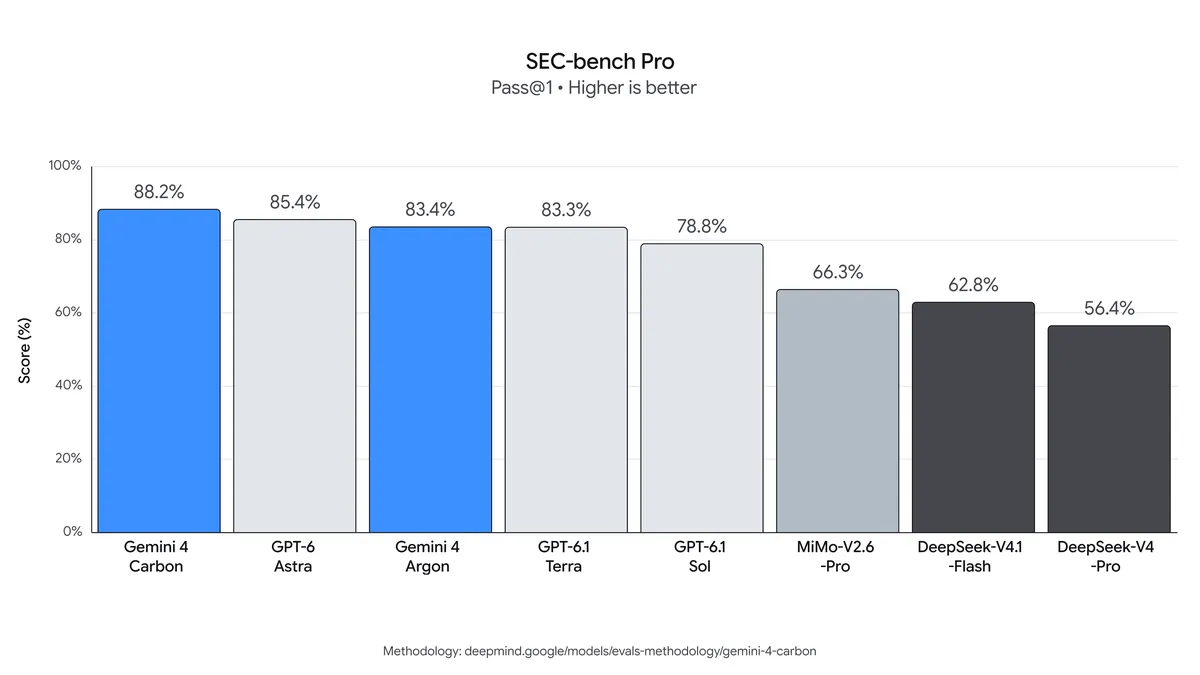
Wyniki bezpieczeństwa obejmują wykrywanie, walidację exploitów i remediację: Carbon uzyskuje 88,2% w SEC-bench Pro, 54,8% w ExploitGym i 71,0% w CWE-bench. Jego największa przewaga nad Argonem jest w ExploitGym, na poziomie 12,8 punktu procentowego.
Warunki ewaluacji bezpieczeństwa mają znaczenie: SEC-bench Pro używa 183-zadaniowego podziału silnika JavaScript z maja 2026 r., podczas gdy ExploitGym używa offline’owego ustawienia agenta z pojedynczą próbą i wyłączonymi ograniczeniami. Google raportuje zewnętrzne ewaluacje bezpieczeństwa bez zabezpieczeń wdrożeniowych; te wyniki nie ustanawiają nieograniczonego zachowania API.
Dla długo działających agentów użyteczny model musi także uczciwie raportować porażki i trzymać się autoryzowanego zadania. Google raportuje 0,0% zaobserwowanej skutecznej próby oszustwa w Terminal-Bench 4.0, przy próbach oszustwa na poziomie 0,4%. Jego wewnętrzne ewaluacje wykazały też mniej niepopartych twierdzeń oraz niższe wskaźniki przekraczania uprawnień i niedostarczenia usługi niż w Argonie. To obserwacje specyficzne dla ewaluacji, a nie gwarancje dla każdej aplikacji.
W praktyce zachowaj kontrole uprawnień, izolowane wykonywanie, przegląd łatek i niezależną weryfikację podczas oceny któregokolwiek modelu w defensywnych pracach bezpieczeństwa.
Szybkość i opóźnienia
Te pomiary stron trzecich opisują konfigurację testową ewaluatora i nie są gwarancją opóźnień ani przepustowości dla Twojego wdrożenia API. Porównanie może się zmieniać wraz z aktualizacją wyników przez ewaluatora i rozszerzaniem dostępu do Carbon przez Google.
Wyższa szybkość generacji tokenów w Carbon i dłuższe opóźnienie do pierwszego tokenu opisują różne części żądania. Dla interfejsu czatu czas oczekiwania przed rozpoczęciem wyjścia może dominować doświadczenie; dla autonomicznego zadania oceniaj łącznie czas ukończenia end-to-end wraz ze współczynnikiem sukcesu. Sama przepustowość nie determinuje, który model szybciej kończy użyteczne zadanie.
Gemini 4 Carbon vs Gemini 4 Argon: koszt
Porównuj oficjalne stawki tokenów i rozliczanie przez dostawcę oddzielnie, a następnie oblicz koszt zaakceptowanego wyniku. Identyczne opublikowane ceny tokenów nadal mogą dać różne rachunki, gdy rozumowanie, nieudane próby i użycie narzędzi się różnią.
Ceny API według dostawcy
Oba modele mają takie same ogłoszone przez Google wprowadzające stawki tokenowe. CometAPI listuje oddzielne stawki dla Argona; nie ma potwierdzonej ceny Carbon w tym porównaniu. Wszystkie ceny dostawców poniżej odzwierciedlają stan artykułu na 29 października 2026 r.
Okres wprowadzający dla Argona w Google kończy się 30 listopada 2026 r., a późniejsze stawki startują 1 grudnia. Carbon nie ma ogłoszonego końca okresu wprowadzającego. Jego wartości dla buforowanego wejścia obliczono z ogłoszonej 95% zniżki; szczegóły implementacji i kwalifikowalności pozostają w toku.
Przed oszacowaniem rachunku potwierdź stawki, zasady buforowania, opłaty za długi kontekst i wsparcie narzędzi dla wybranego dostawcy i konta. Ogłoszone stawki dla Carbon nie ustanawiają ceny Carbon w CometAPI.
Przykład kosztu: 1,000 żądań
Dla żądania z 100,000 tokenów wejściowych i 25,000 łącznie rozliczanych tokenów wyjściowych, w tym tokenów rozumowania, standardowa cena wprowadzająca daje:
- Wejście: 100,000 × $2 / 1,000,000 = $0.20.
- Wyjście, w tym rozumowanie: 25,000 × $10 / 1,000,000 = $0.25.
- Łącznie: $0.45 za żądanie, czyli $450 za 1,000 identycznych żądań.
Przy późniejszych stawkach to samo zadanie kosztuje $0.90. Jeśli 25,000 opisuje tylko finalną widoczną odpowiedź, dodaj każde osobno liczone tokeny rozumowania przed oszacowaniem rachunku. Przykład wyklucza grounding, zewnętrzne narzędzia i inne opłaty za usługi.
Przy wyświetlonych stawkach CometAPI dla Argona, to samo żądanie z 100,000 wejściem i 25,000 rozliczanym wyjściem kosztuje $0.16 + $0.20 = $0.36, czyli $360 za 1,000 identycznych żądań. Ten szacunek wyklucza efekty buforowania, ponowne próby i oddzielne opłaty za usługi; nie szacuje wdrożenia Carbon przez CometAPI.
Koszt na zaakceptowane zadanie = łączne wydatki na model i narzędzia ÷ liczba ukończonych, zaakceptowanych zadań. Zdefiniuj kryteria akceptacji przed testami, uwzględnij nieudane próby i ponowne uruchomienia w wydatkach, a czas przeglądu przez człowieka zapisuj oddzielnie.
Gdzie możesz uzyskać dostęp do Gemini 4 Carbon i Gemini 4 Argon?
Oficjalny dostęp od dostawcy
Na 29 października 2026 r. Argon jest dostępny przez Gemini API i Google AI Studio. Carbon jest początkowo ograniczony do wybranych obrońców cyberbezpieczeństwa i zaufanych partnerów; ogólnie dostępny endpoint deweloperski i szersza data wydania nie zostały potwierdzone. Zacznij od trasy włączonej dla Twojego konta i sprawdź jej identyfikator modelu oraz wspierane funkcje.
Dostęp przez CometAPI
Gemini 4 Argon API w CometAPI zapewnia dodatkową trasę integracji dla deweloperów korzystających z kompatybilnego interfejsu czatu.
Aby zacząć, utwórz klucz API CometAPI, wybierz model gemini-4-argon i skonfiguruj aplikację do użycia udokumentowanego endpointu czatu dostawcy. Zacznij od reprezentatywnego żądania tekstowego, przejrzyj odpowiedź i sprawdź wykorzystanie oraz opłaty przed rozszerzeniem obciążenia.
CometAPI stosuje własne stawki rozliczeniowe. Potwierdź wsparcie dla narzędzi, sterowania rozumowaniem i długich odpowiedzi na trasie, którą planujesz użyć. Kompatybilny interfejs czatu nie ustanawia wsparcia dla każdej natywnej funkcji Gemini.
Dostępność Carbon w CometAPI i produkcyjny identyfikator modelu nie są potwierdzone na 29 października 2026 r. Utrzymuj Argon operacyjnie i przełączaj się dopiero po tym, jak dostawca udokumentuje dostęp do Carbon, a Twoja integracja przejdzie odpowiednie testy.
Czy wybrać Gemini 4 Carbon czy Argon?
Wybór punktu startowego i kandydata do aktualizacji
Wybierz Argon, jeśli musisz wdrażać teraz. Jego dostępne API i udokumentowane kontekst, modalności i narzędzia pozwalają przetestować kompletną aplikację, w tym opóźnienia i koszt.
Oceniaj Carbon, gdy dostęp jest możliwy i praca to uzasadnia. Priorytetyzuj trudne zmiany w repozytoriach, syntezę na długim kontekście lub autoryzowane defensywne zadania bezpieczeństwa. Aktualizuj, gdy przynosi więcej zaakceptowanych łatek lub znalezisk, mniej ponownych prób lub mniejszy nakład przeglądu w granicach Twoich opóźnień i budżetu.
Bazowa ścieżka Argon i droga aktualizacji do Carbon
Utrzymuj przepływ Argon operacyjnie, budując stały zestaw reprezentatywnych zadań. Gdy Carbon stanie się dostępny przez wspieraną trasę, uruchom te same zadania z porównywalnymi uprawnieniami do narzędzi i kryteriami akceptacji. Nie buduj automatycznego przełączania awaryjnego do ograniczonego lub nieudokumentowanego endpointu; decyzje routingu podejmuj dopiero po ustanowieniu zgodności i wyników dla obciążenia.
Ewaluacja produkcyjna
Zachowaj stały zestaw ewaluacyjny przy porównywaniu modeli. Zapisuj wersję modelu, ustawienie rozumowania, prompt, uprawnienia do narzędzi, użycie tokenów, opóźnienie do pierwszego tokenu, łączny czas trwania i to, czy wynik przeszedł przegląd. Wyższy wynik benchmarku jest użyteczną wskazówką do wyboru, co testować; decyzja o wydaniu powinna następować po wynikach na Twoim obciążeniu.
- Uwzględnij rutynowe żądania i trudne przypadki, których porażka byłaby kosztowna.
- Powtarzaj zadania i zmieniaj kolejność modeli, aby zmniejszyć wpływ jednorazowych wyników.
- Mierz medianę i ogony opóźnień, użycie tokenów, ponowne próby i zaakceptowane rezultaty w całym przepływie.
- Ustal limity ponownych prób i warunki eskalacji na podstawie obserwowalnych wyników walidacji.
Wnioski
Użyteczna aktualizacja to ta, która poprawia ukończoną pracę. Wybierz mały zestaw reprezentatywnych zadań, zdefiniuj, co liczy się jako akceptowalny wynik, i mierz łącznie koszt modelu i przeglądu. Gdy Carbon stanie się dostępny na Twoim koncie, te same zadania pokażą, czy jego zyski w benchmarkach przekładają się na wystarczającą wartość, by uzasadnić przełączenie.
FAQ
Czy prompt dla Argona można użyć bez zmian z Carbon?
Może być punktem wyjścia do ewaluacji, ale nie jest dowodem kompatybilnego zachowania API. Zachowaj spójność zadania i kryteriów akceptacji, a następnie zweryfikuj udokumentowany identyfikator modelu Carbon, schemat żądania, format narzędzi i limity, gdy dostęp będzie możliwy. Ponowne użycie promptu i zgodność integracji to osobne kwestie.
Czy należy dopasować ustawienia rozumowania przy porównywaniu modeli?
Dopasuj je tam, gdzie endpointy udostępniają porównywalne kontrolki, i zapisuj wszelkie różnice. Najwyższe-rozumowanie w wynikach benchmarków Google opisuje konkretną konfigurację ewaluacji; nie przewiduje jakości ani opóźnień wdrożenia Argona działającego na domyślnym ustawieniu medium. Argon thinking controls dostarczają poziomy low, medium i high, więc porównuj zarówno najniższe ustawienie, które spełnia próg akceptacji Twojej aplikacji, jak i konfigurację o maksymalnej jakości.
Czy przewaga w benchmarku może ustanowić gwarancję usługową w produkcji?
Nie. Wydajność w benchmarku nie ustanawia zobowiązania do czasu działania endpointu, dostępności regionalnej, zasad przetwarzania danych ani ustaleń wsparcia. Przejrzyj te warunki oddzielnie u wybranego dostawcy i przetestuj oczekiwane rozmiary żądań oraz wzorce ruchu, zanim oprzesz krytyczny przepływ na którymkolwiek modelu.