Buduj z CometAPIPotrzebujesz jednego API dla wielu modeli?Przetestuj proces w Playground, a potem utwórz klucz API, gdy model i koszt pasują do Twojego zastosowania.
Gemini API bezpłatny poziom 2026: bezpłatne modele, limity & przewodnik po cenach
Sprawdź, które modele Gemini API są bezpłatne w 2026 r., poznaj limity RPM, TPM i RPD, uzyskaj wskazówki dotyczące konfiguracji Pythona i rozliczeń oraz porównaj ceny Google z CometAPI.
Darmowy poziom Gemini API jest dostępny w październiku 2026 r. dla wybranych modeli, w tym Gemini 3.8 Flash, Gemini 3.6 Flash, Gemini 3.5 Flash-Lite oraz Gemini 3.1 Flash-Lite. Możesz zacząć bez konfiguracji rozliczeń, ale to limit dostępny dla Twojego projektu określa, ile faktycznie uruchomisz.
Zacznij od Gemini 3.8 Flash do wymagających eksperymentów z kodowaniem i rozumowaniem lub od modelu Flash-Lite do rutynowej ekstrakcji i klasyfikacji. Zanim użyjesz prawdziwych danych klientów, sprawdź odpowiednie warunki dotyczące danych. Jeśli potrzebujesz płatnej pojemności, porównaj natywne stawki Google z oddzielnie rozliczanym dostępem CometAPI.
Key Takeaways
Gemini 3.8 Flash to najnowsza opcja Flash ujęta tutaj, z multimodalnym wejściem i regulowanym nakładem rozumowania.
Gemini 3.6 Flash pozostaje wspieraną opcją dla istniejących integracji; Gemini 3.5 Flash-Lite i Gemini 3.1 Flash-Lite są kierowane do lżejszych obciążeń.
Gemini 4 Argon wymaga płatnego dostępu do API. Darmowa dostępność w innym produkcie Google nie oznacza kwalifikacji do darmowego API.
Sprawdzone pod kątem przejrzystości, atrybucji źródeł i aktualnej terminologii API.
Sprawdzaj limity w AI Studio. Okno kontekstu modelu różni się od przydziału żądań i tokenów Twojego projektu.
Porównaj drogi dostępu. Darmowy limit Google i ceny, kredyty oraz limity konta CometAPI są niezależne.
Is the Gemini API Free in 2026?
Google oferuje darmowe tokeny wejścia i wyjścia dla wybranych modeli Gemini API, z zastrzeżeniem limitów na poziomie projektu. Możesz rozpocząć bez włączania rozliczeń. To jest darmowy poziom oparty na limitach, a nie jednorazowy kredyt promocyjny.
Istotne rozróżnienie: Google AI Studio, Gemini API i konsumenckie subskrypcje Gemini to oddzielne środowiska dostępu. Model dostępny w jednym interfejsie nie musi być dostępny za darmo w innym.
Which Gemini API Models Are Free in October 2026?
Poniższe cztery modele to przydatne punkty startowe dla aplikacji tekstowych i multimodalnych. Nie jest to wyczerpująca lista wszystkich punktów końcowych kwalifikujących się do darmowego dostępu. Śledź linki modeli, aby sprawdzić dostęp przez CometAPI; specyfikacje Google są podlinkowane poniżej tabeli.
Model
Model ID
Praktyczne zastosowanie na start
Gemini 3.8 Flash
gemini-3.8-flash
Złożone programowanie, rozumowanie i przepływy sterowane narzędziami
Gemini 3.6 Flash
gemini-3.6-flash
Istniejące aplikacje Flash i ogólna automatyzacja
Gemini 3.5 Flash-Lite
gemini-3.5-flash-lite
Parsowanie dokumentów i lekkie zadania agentowe
Gemini 3.1 Flash-Lite
gemini-3.1-flash-lite
Klasyfikacja, tłumaczenie i prosta ekstrakcja
Wszystkie cztery przyjmują wejście tekstowe, obraz, wideo, audio i PDF oraz generują tekst. Ich opublikowany limit wejścia to 1 048 576 tokenów, a wyjścia do 65 536 tokenów. Te limity modelu nie gwarantują, że darmowy projekt może wysłać żądanie o takim rozmiarze.
Audio, Embeddings and Image Generation: Access and Limits
Google wymienia też darmowy dostęp do wybranych modeli specjalistycznych, takich jak Gemini 3.8 Live, Gemini 3.8 Flash TTS i Gemini Embedding 2. Przed integracją sprawdź wpis cennika dla konkretnego modelu i endpointu: rozumienie obrazu lub klipu audio to inna możliwość niż generowanie obrazu lub odpowiedzi głosowej.
Metody API, formaty żądań i limity różnią się w zależności od możliwości. Sprawdź dokumentację dla konkretnego modelu i operacji, których planujesz użyć.
Darmowy dostęp nie obejmuje każdego modelu Gemini ani każdego endpointu generacyjnego. Gemini 4 Argon wymaga płatnego dostępu przez Gemini API, a premiumowe endpointy generowania obrazów i wideo mają własne zasady kwalifikacji. Zanim zintegrujesz funkcję, sprawdź dokładny model i operację zamiast zakładać, że współdzielą taki sam darmowy limit.
How Does Gemini 3.8 Flash Perform?
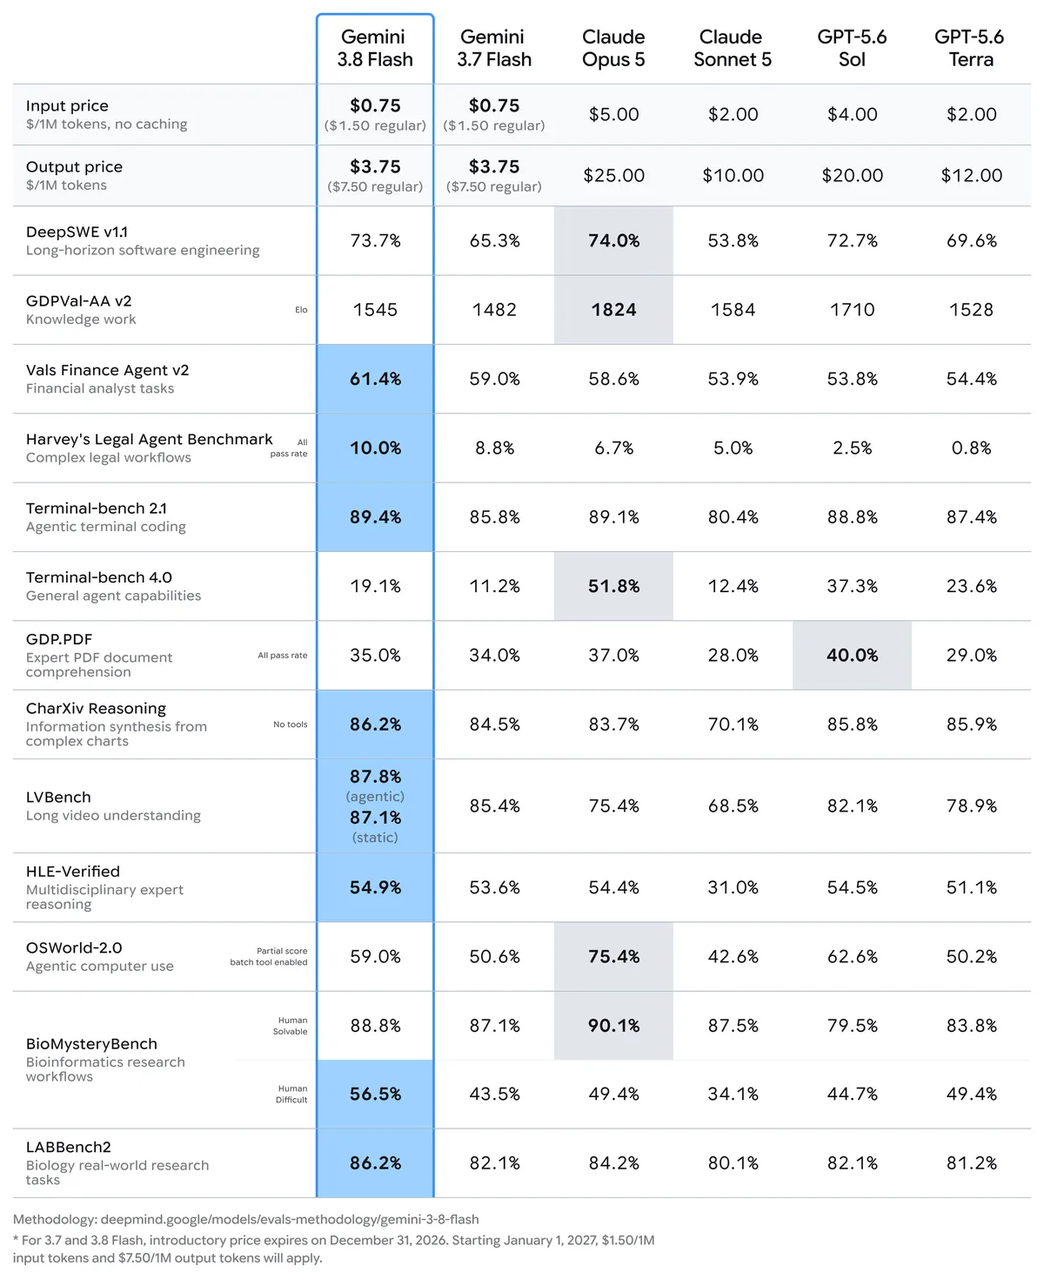
Opublikowana przez Google ewaluacja porównuje Gemini 3.8 Flash z Gemini 3.7 Flash i innymi modelami. Raportuje 73,7% na DeepSWE v1.1, wobec 65,3% dla 3.7 Flash — wzrost o 8,4 punktu procentowego. Na HLE-Verified zgłoszony wynik rośnie z 53,6% do 54,9%.
Wykorzystaj te wyniki do wyboru modelu do testów, a następnie oceń go na przykładach z własnej aplikacji. Dla ekstraktora dokumentów ważniejsze od benchmarku kodowania mogą być poprawność pól i stabilność formatu wyjścia. Dla asystenta kodowania zmierz, czy proponowana zmiana działa, ile trwa i ile tokenów zużywa.
What Are the Gemini API Free Tier Rate Limits in 2026?
Największe nieporozumienie dotyczące darmowego poziomu Gemini polega na przekonaniu, że każde konto otrzymuje tę samą, stałą liczbę żądań.
Otwórz Google AI Studio, wybierz projekt powiązany z Twoim kluczem API i przejrzyj aktywne limity dla wybranego modelu. Przewodnik po limitach szybkości Google wyjaśnia wymiary limitów; pulpit pokazuje przydział obowiązujący dla Twojego konta.
RPM (requests per minute): Ogranicza liczbę żądań wysyłanych w każdej minucie. Uważaj na krótkie zrywy i równoległe worker’y, które naraz wysyłają zbyt wiele żądań.
TPM (input tokens per minute): Ogranicza wolumen tokenów wejściowych wysyłanych w ciągu minuty. Duże prompty, historie rozmów i dokumenty mogą zużywać ten przydział, nawet gdy liczba żądań jest niska.
RPD (requests per day): Ogranicza łączną dzienną liczbę żądań. Planuj obciążenie wokół dziennego limitu i czasu jego resetu.
Limit wejścia na poziomie miliona tokenów opisuje maksymalny rozmiar wejścia obsługiwany przez model. Nie gwarantuje to, że projekt na darmowym poziomie ma wystarczającą pojemność TPM, by przesłać milion tokenów w jednym żądaniu. Pojemność kontekstu i pojemność limitów szybkości trzeba oceniać osobno.
Dzienne limity żądań resetują się o północy czasu pacyficznego. Wiele kluczy w jednym projekcie współdzieli jego limity użycia, więc utworzenie kolejnego klucza nie zwiększa pojemności. Inne limity mogą dotyczyć modeli specjalistycznych lub operacji.
Handle Gemini API 429 Errors
Przeczytaj treść błędu przed ponowieniem. W aktualnym Interactions API kod 429 może rozróżnić krótkoterminowy limit żądań lub tokenów od wyczerpanego dziennego limitu. Dla krótkoterminowego limitu spowolnij kolejkę i użyj wykładniczego backoffu z jitterem. Dla dziennego wyczerpania poczekaj na reset lub zmień plan pojemności aplikacji. Kod 503 oznacza tymczasową niedostępność usługi. Zobacz referencję błędów API Google.
How Do Google and CometAPI Prices Compare?
When Gemini API Billing Begins
Wyczerpanie darmowego limitu nie przełącza automatycznie projektu na płatne użycie. Bez aktywnego konta rozliczeniowego żądania przekraczające dostępny darmowy przydział napotkają ograniczenia dostępu lub pojemności zamiast standardowych opłat za tokeny.
Aby korzystać z płatnej pojemności, musisz podpiąć rozliczenia. Jeśli Twoje konto przypisano do planu prepaid, musisz także dodać kredyty, zaczynając od $5 lub lokalnego odpowiednika. Przed uaktualnieniem sprawdź przypisany plan i kontrolę wydatków w AI Studio. Salda i rozliczenia mogą aktualizować się z opóźnieniem, więc wyświetlane saldo prepaid nie jest natychmiastowym ogranicznikiem wydatków.
Powitalny kredyt $300 w Google Cloud jest oddzielny od darmowego poziomu Gemini API. Konta otwarte po 2 marca 2026 r. nie mogą używać tego kredytu do opłat za Gemini API lub AI Studio. Zapoznaj się z przewodnikiem rozliczeń, aby poznać zasady dotyczące Twojego konta.
Google and CometAPI Token Prices
Tabela porównuje standardowe ceny tokenów Google z opublikowanymi stawkami modeli CometAPI sprawdzonymi 26 października 2026 r. Wszystkie kwoty to USD za milion tokenów; wyjście obejmuje rozliczane rozumowanie, gdzie dotyczy. Darmowe wejście i wyjście Google mają zastosowanie tylko do kwalifikujących się żądań w granicach przydziału projektu.
Model
Darmowe wejście/wyjście w Google
Płatne wejście/wyjście w Google
Wejście/wyjście w CometAPI
Gemini 3.8 Flash
Free
$0.75 / $3.75
$0.60 / $3.00
Gemini 3.6 Flash
Free
$0.75 / $3.75
$0.60 / $3.00
Gemini 3.5 Flash-Lite
Free
$0.30 / $2.50
Sprawdź bieżącą wycenę w katalogu
Gemini 3.1 Flash-Lite
Free
$0.25 / $1.50
$0.20 / $1.20
Gemini 4 Argon
Not available
$2.00 / $10.00
$1.60 / $8.00
Wprowadzone ceny Flash powyżej kończą się 31 grudnia 2026 r.; 3.8 Flash i 3.6 Flash przechodzą wtedy na $1.50 za wejście i $7.50 za wyjście. Cena promocyjna Argon kończy się 30 listopada 2026 r., po czym wyniesie $4 za wejście i $20 za wyjście. Stawki CometAPI należy weryfikować niezależnie, gdy te promocje się zmieniają. Narzędzia, cache, storage, podatki i inne usługi mogą generować dodatkowe opłaty.
A Small Workload Example
Załóżmy, że wysyłasz 1 000 żądań tekstowych, każde z 2 000 tokenami wejściowymi i 500 tokenami wyjściowymi. To dwa miliony tokenów wejścia i pół miliona tokenów wyjścia. Przy stawkach powyżej Gemini 3.8 Flash kosztuje $3.375 przez Google (ok. $3.38) i $2.70 przez CometAPI. Kwalifikujące się obciążenie w darmowym poziomie Google kosztuje $0 tylko wtedy, gdy mieści się w dostępnych limitach. To są szacunki kosztów tokenów, a nie zmierzone rachunki.
How Can You Start Using the Gemini API Free Tier?
Potrzebujesz kwalifikującego się konta Google i regionu, klucza API oraz środowiska Python z pip. Poniższy przykład podąża za aktualnym przewodnikiem startowym Google i używa Interactions API.
Create a Key and Install the SDK
W Google AI Studio skopiuj lub utwórz klucz API dla projektu, który nie ma włączonego płatnego rozliczania. Zainstaluj SDK, a następnie ustaw klucz w środowisku terminala. Przechowuj klucz na serwerze, zamiast osadzać go w kodzie przeglądarkowym.
pip install -U google-genai
W systemie macOS lub Linux:
export GEMINI_API_KEY="your_api_key"
W Windows PowerShell:
$env:GEMINI_API_KEY="your_api_key"
Send a Request and Check the Result
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-3.8-flash",
    input="Explain vector databases in 100 words."
)
print(interaction.output_text)
Zapisz to jako plik Pythona i uruchom z tego samego środowiska. Udane żądanie wydrukuje krótkie wyjaśnienie. Następnie sprawdź pulpit użycia w AI Studio, aby potwierdzić projekt i model otrzymujące ruch. Jeśli wystąpi błąd, sprawdź kod błędu i zweryfikuj klucz, dostęp do modelu, limit i stan rozliczeń, zanim zmienisz kod.
How Can Developers Access Gemini API Models Through CometAPI?
CometAPI zapewnia oddzielną drogę dostępu do wspieranych modeli Gemini i innych dostawców AI.
Wybierz tę drogę, gdy wspólny interfejs między dostawcami upraszcza Twoją aplikację. Użyj klucza CometAPI z jego endpointem, następnie zweryfikuj obsługiwany identyfikator modelu i limity konta. Darmowy limit Google nie przenosi się na tę usługę. Poniższy przykład używa interfejsu kompatybilnego z OpenAI udokumentowanego przez CometAPI.
pip install -U openai
Ustaw COMETAPI_KEY w swoim środowisku, używając tej samej metody specyficznej dla powłoki jak powyżej, a następnie uruchom:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)
response = client.chat.completions.create(
    model="gemini-3.8-flash",
    messages=[{
        "role": "user",
        "content": "Summarize the benefits of RAG."
    }]
)
print(response.choices[0].message.content)
Przed wdrożeniem potwierdź, że zamierzony identyfikator modelu jest obsługiwany przez Twoje konto CometAPI. Natywne identyfikatory Google i aliasy specyficzne dla dostawców nie muszą się pokrywać dla każdego modelu.
What Privacy Restrictions Apply to the Gemini API Free Tier?
Zgodnie z Gemini API Additional Terms of Service Google, monity i odpowiedzi w niepłatnych usługach mogą być wykorzystywane do ulepszania produktów Google, a ludzie-recenzenci mogą je przeglądać. Nie przesyłaj wrażliwych, poufnych ani osobistych informacji do usług niepłatnych. Płatne usługi API mają inne zasady wykorzystania danych.
Reguły regionalne mają znaczenie: postanowienia dotyczące wykorzystania danych dla usług płatnych mają zastosowanie do niektórych niepłatnych użyć w EOG, Szwajcarii i Wielkiej Brytanii, ale udostępnienie klienta API użytkownikom w tych regionach wymaga Paid Services. To odrębne warunki. Sprawdź aktualne warunki dla swoich użytkowników i wdrożenia przed wydaniem.
How Can You Optimize Gemini API Free Tier Usage?
Buduj wokół zmierzonego przez siebie limitu. Utrzymuj mały zestaw reprezentatywnych zadań i rejestruj skuteczność zadań, opóźnienia, tokeny wejścia i wyjścia oraz ponowienia. Następnie zmieniaj jedną część obciążenia naraz:
Kieruj ruchem wg trudności. Przetestuj Flash-Lite przy rutynowej ekstrakcji i używaj większego modelu tylko tam, gdzie poprawia wynik.
Odetnij zbędne wejście. Wysyłaj odpowiedni fragment dokumentu i niezbędną historię rozmowy zamiast wielokrotnego przesyłania wszystkiego.
Kontroluj generację. Poproś o użyteczną długość wyjścia i dostosuj nakład rozumowania tylko tam, gdzie model i API to wspierają.
Wykorzystuj wyniki ponownie. Przechowuj powtarzalne wyniki aplikacji i sprawdź kwalifikację do cache’owania specyficzną dla modelu, zanim założysz, że cache API jest darmowy.
Budżetuj współbieżność. Trzymaj worker’y za wspólną kolejką, aby niezależne zadania nie powodowały zbędnych zrywów.
Na koniec monitoruj jakość, a nie tylko zużycie. Tańszy model, który często zawodzi lub wymaga kilku podejść, może tworzyć więcej pracy niż nieco droższy model, który kończy sukcesem za pierwszym razem.
Przydatna wewnętrzna metryka oceny to:
Efektywny koszt na udane zadanie = Całkowity koszt inferencji / Liczba udanych zadań
Dla eksperymentów na darmowym poziomie dodatkową metryką operacyjną jest liczba udanych zadań na dostępne okno limitu.
FAQ
Skąd wiem, czy problem z limitem wynika z nagłych skoków żądań, czy z dużych dokumentów?
Porównaj znaczniki czasu niepowodzeń z liczbą żądań i wolumenem tokenów wejściowych. Zryw krótkich promptów wskazuje na częstotliwość żądań; kilka długich dokumentów może wyczerpać pojemność tokenów nawet przy niskim RPM. W Interactions API sprawdź maszynowy kod błędu i odróżnij wyczerpanie dziennego limitu od krótkoterminowego ograniczenia. Loguj zużycie tokenów i współbieżność workerów razem, aby móc zmienić odpowiednią część kolejki.
Co zrobić, jeśli żądanie przekroczy limit czasu po wysłaniu?
Przekroczenie limitu czasu nie zawsze mówi, czy operacja zdalna się zakończyła. Dla interakcji, dla której masz ID, sprawdź jej stan, zanim rozpoczniesz kolejne kosztowne zadanie. Obejmij workflow identyfikatorem zadania na poziomie aplikacji i deduplikuj działania w dół strumienia, zwłaszcza e-maile, zapisy do bazy i wywołania narzędzi. Ponowienie generowania tekstu nie powinno po cichu powtórzyć akcji biznesowej. Dokumentacja Interactions opisuje pobieranie interakcji i stany wykonania.
Jak porównywać Flash i Flash-Lite w kontekście ekstrakcji dokumentów?
Używaj tych samych dokumentów, wymaganych pól i reguł akceptacji dla obu modeli. Uwzględnij zaszumione skany, brakujące pola i niejednoznaczne wartości. Oceniaj dokładność faktów w polach i poprawność wyjścia, a następnie zliczaj ponowienia i ręczne poprawki. Model generujący mniej tokenów może nadal powodować większy nakład pracy, jeśli jego błędy wymagają kolejnego żądania. Zachowaj wydzielony zestaw dokumentów, aby zmiany promptu nie były oceniane wyłącznie na przykładach już dostrojonych.
Co sprawdzić przed przeniesieniem aplikacji z Google do CometAPI?
Przetestuj dokładny endpoint, identyfikator modelu, format wiadomości i funkcje, których używa Twoja aplikacja. Zgodne żądanie chat-completions nie oznacza identycznego wsparcia dla plików, narzędzi, cache czy ustawień rozumowania. Porównaj zwracane pola zużycia i obsługę błędów, a także samą odpowiedź tekstową, i przejrzyj polityki danych pośrednika oraz dostawcy nadrzędnego. Zacznij od małego, nieczułego obciążenia przed przeniesieniem reszty ruchu.
Jak utrzymać stabilną integrację, gdy modele i ceny się zmieniają?
Trzymaj identyfikatory modeli, ustawienia endpointów i założenia cenowe w konfiguracji. Rejestruj model i datę z wynikami ewaluacji, monitoruj komunikaty o wycofywaniu i ponownie uruchamiaj reprezentatywne zadania przed zmianą modelu. Ustaw alerty budżetowe i przejrzyj stawki promocyjne przed datą ich zakończenia. Miej przetestowany fallback dla kluczowych obciążeń, zamiast zakładać, że darmowy limit lub konkretny alias modelu pozostaną dostępne bezterminowo.
Conclusion
Darmowy poziom Gemini API to użyteczny sposób na zwalidowanie aplikacji przed płaceniem za pojemność. Wybierz model do zadania, zmierz limit dostępny w Twoim projekcie i sprawdź warunki danych przed użyciem danych produkcyjnych.
Na pierwszy eksperyment wykonaj jedno małe żądanie i potwierdź je w AI Studio. Następnie zmierz reprezentatywne obciążenie. Jeśli ograniczeniem stanie się darmowa pojemność, porównaj płatne API Google z CometAPI, używając tych samych promptów, wymagań jakości i pełnych kosztów tokenów.