
TL;DR
GLM 5.4 to nazwa używana przez społeczność dla potencjalnego następcy w rodzinie GLM firmy Z.ai. Na dzień 14 października 2026 r. oficjalna dokumentacja modeli i przeglądnięte na potrzeby tego artykułu rejestry wydań nie potwierdzają premiery GLM-5.4, karty specyfikacji ani identyfikatora API. Union Alpha to trop pochodzący z plotek, a październikowa premiera jest ewentualnością wynikającą z rytmu wydań. Najbardziej użyteczne pytanie brzmi, czy przyszłe wydanie poprawi niezawodność w kodowaniu i koszt na ukończone zadanie; istniejące modele GLM stanowią punkt odniesienia dla tej oceny.
Najważniejsze wnioski
- Status wydania: Źródła oficjalne, zweryfikowane 14 października 2026 r., nie potwierdzają GLM-5.4; nie ustalono dokładnej daty premiery.
- Dowody z przecieków: Powiązanie Union Alpha z GLM-5.4 pozostaje niezweryfikowane, a cytowane zestawienie nie wskazuje pierwotnego źródła atrybucji.
- Punkt odniesienia wydajności: Wyniki GLM-5.3 są użytecznym kontekstem, ale nie stanowią pomiarów GLM-5.4.
- Architektura: GLM-5.3-Flash pokazuje inny kierunek efektywności i multimodalności; dziedziczenie tego przez GLM-5.4 pozostaje kwestią otwartą.
- Działania deweloperów: Oceń dostępne modele już teraz i wymagaj zweryfikowanych identyfikatorów modeli, kompatybilności oraz pomiarów na poziomie zadań przed aktualizacją.
Czy GLM 5.4 został wydany?
GLM 5.4 to nieoficjalna nazwa potencjalnego następcy GLM. Indeks oficjalnej dokumentacji i zapisy wydań przejrzane 14 października 2026 r. identyfikują istniejące modele GLM, ale nie potwierdzają wydania produktu GLM-5.4. To przegląd źródeł na określony dzień, a nie dowód, że nie istnieją żadne prace prywatne.
Dwie udokumentowane ścieżki rozwoju wyjaśniają, dlaczego potencjalny następca przyciąga uwagę.
Z.ai potwierdza, że GLM-5.3 ponownie wykorzystuje bazowy model GLM-5.2 i zyski osiąga poprzez post-training. GLM-5.3-Flash natomiast używa nowej multimodalnej bazy i hybrydowego mechanizmu uwagi. Te fakty opisują istniejące modele, a nie ujawniony projekt GLM-5.4.
W praktyce jedna ścieżka ulepsza istniejący model poprzez dodatkowe szkolenie, podczas gdy druga przeprojektowuje architekturę, aby zmniejszyć koszty obliczeń i wspierać nowe możliwości.
Przyszły GLM-5.4 mógłby oprzeć się na dowolnym z tych kierunków, ale nie ma jeszcze wystarczających dowodów, by określić, który podejście wybierze Z.ai.
Na ile wiarygodne są plotki i przecieki o GLM-5.4?
Informacje potwierdzone
Potwierdzona baza techniczna pochodzi z GLM-5.3 i GLM-5.3-Flash, nie z GLM-5.4. Nazwa GLM-5.4, finalne specyfikacje, data wydania i wyniki benchmarków pozostają niepotwierdzone w oficjalnych źródłach przejrzanych na potrzeby tego artykułu.
Relacje społeczności / przecieki
Post na X z 8 października 2026 r. autorstwa @NFT_Chen (https://x.com/NFT_Chen/status/2108131637502628341) przypisuje możliwy kierunek rozwoju GLM-5.4/5.5 komentarzom Tanga Jie. Post opisuje trzy priorytety skalowania: rozszerzenie pre-treningu, wzmocnienie post-trainingu poprzez SFT, RLHF i RLVR oraz rozszerzenie wnioskowania i wykonywania przez agentów na trudniejsze, dłuższe zadania.
Autor interpretuje kolejny kierunek jako dłużej działających autonomicznych agentów i rekurencyjne samodoskonalenie (RSI). To relacja społeczności z wystąpienia, a nie ogłoszenie wydania Z.ai. Nazwy wersji i twierdzenia rozwojowe pozostają przypisane do posta; nie ustanawiają daty premiery, finalnej architektury, liczby parametrów ani wykazanej zdolności samodoskonalenia dla GLM-5.4.
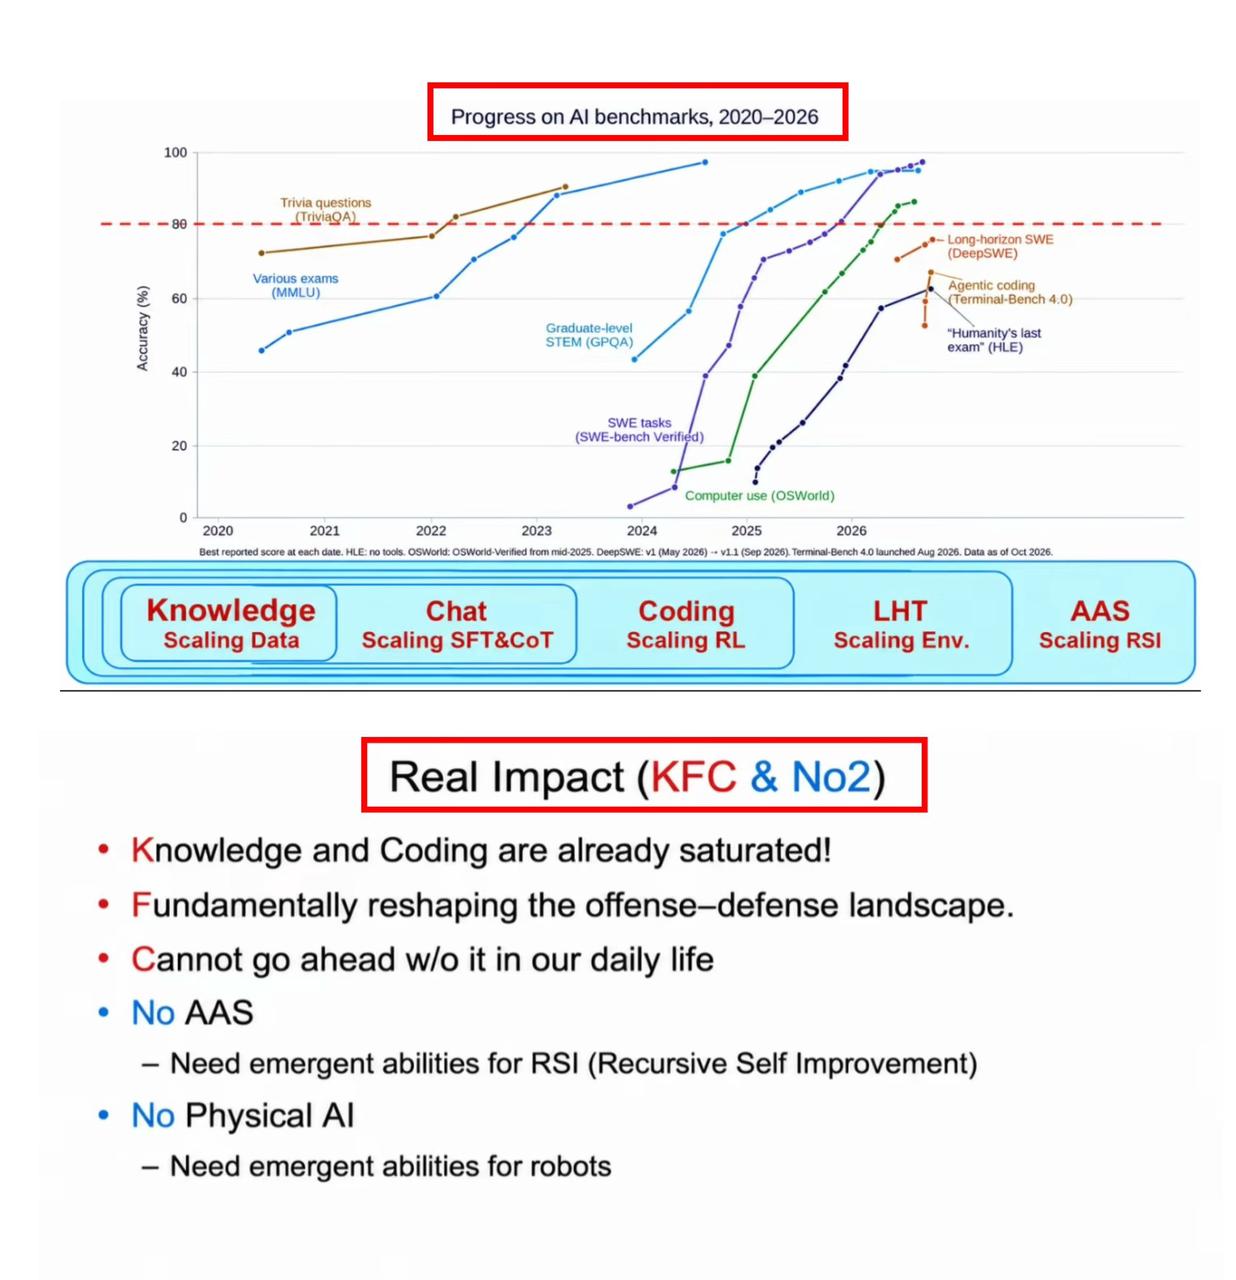
Obraz slajdu z prezentacji dołączony do oryginalnego posta @NFT_Chen na X, 8 października 2026 r. Omawia postępy w benchmarkach i RSI jako kierunek na przyszłość; nie jest to raport benchmarkowy GLM-5.4.
Zdjęcie z wystąpienia dołączone do oryginalnego posta @NFT_Chen na X, 8 października 2026 r.
Analiza
Użyteczna analiza plotek pyta, jaka obserwacja zmieniłaby wniosek. Oficjalny identyfikator modelu, ogłoszenie wydania lub ujawnione mapowanie z anonimowego aliasu istotnie wzmocniłoby sprawę. Podobny schemat nazewnictwa lub sam interwał wydań nie wystarczy. Starsze spekulacje o innych przyszłych numerach wersji GLM nie ustanawiają specyfikacji dla GLM-5.4.
Kiedy GLM 5.4 mógłby zostać wydany?
Oś czasu w notatkach wydawniczych Z.ai odnotowuje GLM-5 12 lutego, GLM-5.1 7 kwietnia, GLM-5.2 16 czerwca, GLM-5.3 18 sierpnia i GLM-5.3-Flash 26 sierpnia 2026 r. To daty zapisane w notatkach wydawniczych; nie należy ich utożsamiać z każdym ogłoszeniem badawczym lub datą dostępności u dostawcy.
Przybliżona dwumiesięczna progresja głównych wersji sprawia, że październik jest rozsądnym oknem analitycznym do obserwacji. Nie ustanawia to premiery w październiku, konkretnego dnia ani nawet następnej nazwy wersji. Bez źródła prognozy możliwego do prześledzenia i jego metodologii, dokładne przewidywanie 20 lub 23 października implikowałoby większą precyzję, niż uzasadniają dowody.
Możliwa jest późniejsza premiera, inna nazwa lub odrębny wariant produktu. Deweloperzy powinni planować w oparciu o aktualnie dostępne API, a nie szacunki kalendarzowe.
Jakie są oczekiwane specyfikacje GLM 5.4?
Brak wiarygodnej karty specyfikacji GLM-5.4. Zamiast przypisywać plotkowane parametry sprzętu i modelu niezapowiedzianemu produktowi, bardziej pouczające jest porównanie najnowszych udokumentowanych modeli GLM i wskazanie tego, co pozostaje nieznane.
| Specyfikacja | GLM-5.3 | GLM-5.3-Flash | GLM-5.4 |
|---|---|---|---|
| Wydanie | 18 sierpnia 2026 | 26 sierpnia 2026 | Nieogłoszony |
| Podstawa modelu | Baza GLM-5.2; dalszy post-training | Nowa baza multimodalna | Nieznane |
| Architektura | Podstawa MoE | MoE; hybrydowy mechanizm uwagi sparse-linear | Nieznane |
| Obsługa kontekstu | Udokumentowany kontekst API 1M | 1M | Nieznane |
| Natywna multimodalność | Wejście wyłącznie tekstowe | Wejścia tekstowe, obrazowe, wideo i plikowe | Nieznane |
| Główny nacisk | Kodowanie, agenci, cyberbezpieczeństwo | Efektywność, kodowanie, multimodalność | Nieznane |
| Opublikowane benchmarki | Dostępne | Dostępne | Niedostępne |
| Wagi modelu | Wydane | Wydane | Niedostępne |
Tabela przedstawia udokumentowane możliwości istniejących modeli. Pozycje GLM-5.4 pozostają nieznane, zamiast dziedziczyć wartości od któregokolwiek z poprzedników. Kontekst ewaluacji modelu, okno kontekstu API i maksymalna długość wyjścia to odrębne ograniczenia.
Przegląd architektury GLM-5.3-Flash raportuje 320B łącznej liczby parametrów, 18B aktywowanych parametrów i hybrydowy mechanizm uwagi sparse-linear. To ujawnione specyfikacje Flash i nie należy ich przypisywać GLM-5.4.
Agentowe kodowanie jako potencjalny kierunek ulepszeń
Agentowe kodowanie to jeden z najbardziej wiarygodnych obszarów do obserwacji. GLM-5.3 już pokazał, że skalowanie post-trainingu może znacząco poprawić wydajność w wieloetapowych zadaniach inżynieryjnych. Twórcy podkreślali złożoną pracę na repozytoriach, dłuższe horyzonty wykonywania i lepsze rozwiązywanie problemów oparte na narzędziach.
Przyszły model mógłby rozszerzyć te możliwości poprzez lepszą interakcję ze środowiskiem, bardziej niezawodne planowanie i mniej nieudanych wywołań narzędzi.
Najbardziej użyteczna ocena nie polegałaby jedynie na mierzeniu odsetka poprawnie udzielonych odpowiedzi na pytania dotyczące kodowania. Mierzyłaby, czy agent potrafi ukończyć złożone zadania od początku do końca, obejmując debugowanie, testy, poprawki i odzyskiwanie po błędach.
Wydajna architektura multimodalna jako możliwy kierunek
GLM-5.3-Flash stanowi punkt odniesienia architektonicznego dla przyszłego rozwoju, podczas gdy żadne przejrzane oficjalne źródło nie potwierdza jego użycia w GLM-5.4.
Z.ai opisuje multimodalny korpus pre-treningowy 30T tokenów jako część projektu GLM-5.3-Flash skoncentrowanego na efektywności. To opis skali danych treningowych istniejącego modelu, a nie zobowiązanie roadmapy dla GLM-5.4.
Oficjalny przegląd Flash raportuje 3.01× niższe obliczenia uwagi i 4.44× mniejsze wymagania cache KV względem GLM-5.3 w ramach wskazanego porównania. To wyniki efektywności na poziomie komponentów, a nie gwarantowane przyspieszenie w zastosowaniach czy obniżka cen API.
To znaczące ulepszenia inżynieryjne, ale nie ma potwierdzenia, że GLM-5.4 odziedziczy tę samą architekturę. Większy model nowej generacji mógłby priorytetyzować maksymalną wydajność wnioskowania, podczas gdy odrębny wariant Flash mógłby dalej optymalizować opóźnienie i koszt.
GLM 5.4 vs GLM-5.3 vs GLM-5.3-Flash
Benchmarkowy punkt odniesienia GLM-5.3
Dostępne dane benchmarkowe wspierają analizę trajektorii wydajności GLM-5.3, nie bezpośredni pomiar GLM-5.4. Poniższe wartości to raportowane przez Z.ai ewaluacje istniejących modeli. Nie zostały niezależnie odtworzone na potrzeby tego artykułu i nie mierzą GLM-5.4. Każdy benchmark używa własnego zestawu zadań i metody oceny; różnic punktowych nie należy interpretować jako równoważnych zysków w różnych zadaniach.
| Benchmark i metodologia | GLM-5.2 | GLM-5.3 | GLM-5.3-Flash | Różnica GLM-5.3 vs GLM-5.2 |
|---|---|---|---|---|
| Terminal Bench 3.0 | 4.6 | 28.3 | Nie zgłoszono w przytoczonym porównaniu Flash | +23.7 punktu |
| DeepSWE v1.1 | 46.2 | 66.9 | 63.4 | +20.7 punktu |
| AutomationBench v1.0.6 | 26.2 | 48.2 | 48.8 | +22.0 punktu |
| CyberGym | 77.2 | 84.5 | Nie zgłoszono w przytoczonym porównaniu Flash | +7.3 punktu |
| ExploitBench | 24.4 | 54.4 | Nie zgłoszono w przytoczonym porównaniu Flash | +30.0 punktu |
| HLE with Tools | 54.7 | 62.5 | 55.3 | +7.8 punktu |
| GDPval-AA v2 | 1508 | 1769 | Nie zgłoszono w przytoczonym porównaniu Flash | +261 Elo |
| Toolathlon Verified | 59.9 | Nie zgłoszono w przytoczonym porównaniu GLM-5.3 | 78.4 | Brak danych |
Połączona tabela zestawia obok siebie wyniki istniejących modeli; nie zawiera pomiarów GLM-5.4. Brak raportowanej wartości nie oznacza wyniku zero. Zachowaj w pamięci warunki oceny każdego benchmarku i traktuj różnice GDPval-AA jako Elo, a nie punkty procentowe.
Metodologia: DeepSWE v1.1 używa mini-swe-agent, temperature 0.95, top_p 1.0, limit czasu 6 godzin i kontekst 400K. AutomationBench używa v1.0.6. HLE with Tools używa temperature 1.0, top_p 0.95, limit generacji 163 840 tokenów i limit kontekstu 300K z zarządzaniem kontekstem. GDPval-AA v2 używa skali Elo, więc różnica to nie wzrost punktów procentowych.
Dla CyberGym i ExploitBench Z.ai raportuje Claude Code 2.1.207 z max reasoning effort, bez narzędzi webowych, temperature 1.0, top_p 1.0 i limitem wyjścia 128 000 tokenów. CyberGym raportuje pass@1 z jednego uruchomienia na 1507 zadaniach z nielimitowanym limitem czasu na zadanie. ExploitBench używa do 300 rund interakcji i uśrednia pokrycie 41 zadań w trzech rewizjach. Przypisy do karty modelu dostarczają szczegóły środowiskowe specyficzne dla benchmarków.
Metodyka Flash: DeepSWE używa mini-swe-agent, kontekst 400K i limit czasu 6 godzin; AutomationBench używa v1.0.6. Toolathlon Verified raportuje pass@1 uśrednione z trzech niezależnych uruchomień przez oficjalny serwis ewaluacyjny. HLE używa ustawień próbkowania i zarządzania kontekstem opisanych powyżej. Zobacz metodykę karty modelu Flash. Te wyniki benchmarków nie ustanawiają produkcyjnego opóźnienia ani kosztu.
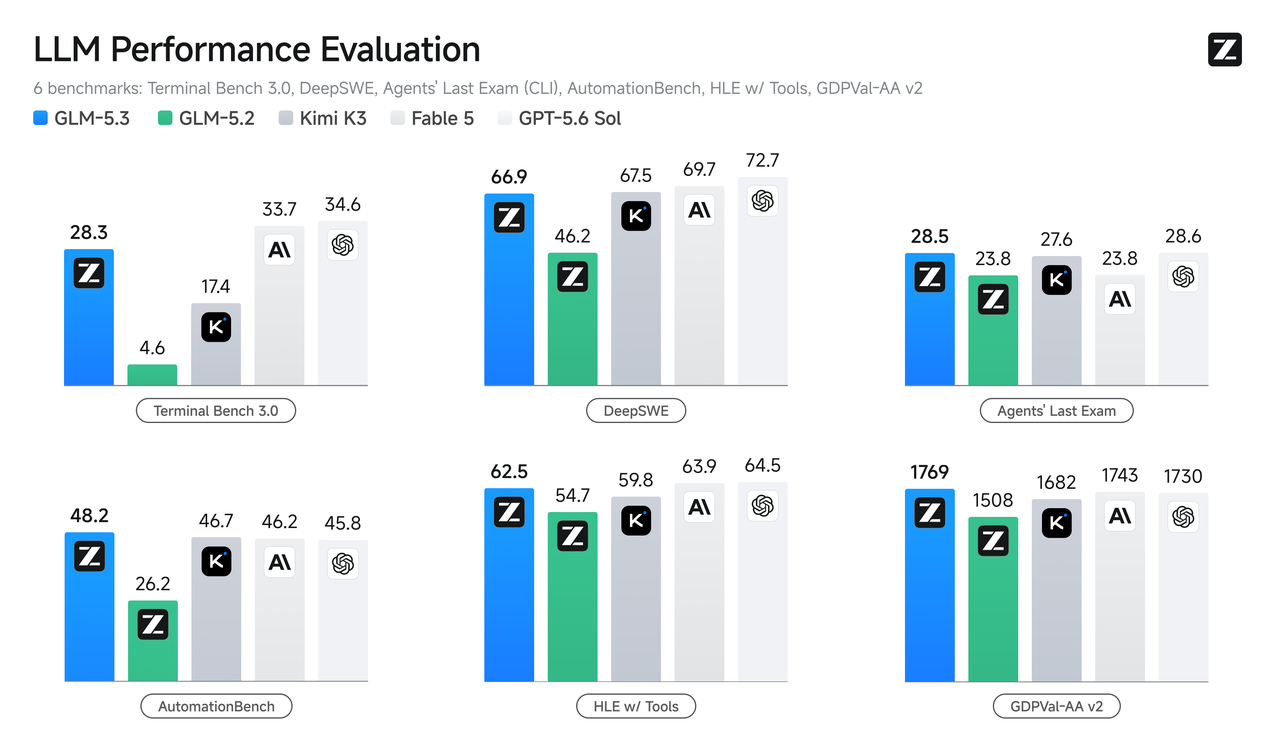
Oficjalna grafika wydajności GLM-5.3, zrekonstruowana z ogłoszenia benchmarków Z.ai. Obraz pokazuje ewaluacje modeli poprzednich; nie zawiera wyników GLM-5.4.
Największe ulepszenia pojawiają się w zadaniach wymagających długotrwałej interakcji ze środowiskiem. Terminal Bench 3.0 wzrósł z 4.6 do 28.3, podczas gdy ExploitBench poprawił się z 24.4 do 54.4.
Te zyski sugerują, że post-training i środowiska zorientowane na agentów mogą radykalnie zmienić wydajność modelu bez zmiany jego bazowej architektury. Nie należy jednak ekstrapolować ich do liczbowej prognozy dla GLM-5.4.
Zdolności i dopasowanie do produkcji
W zastosowaniach produkcyjnych GLM-5.3 jest silniejszym punktem odniesienia dla złożonego kodowania, inżynierii o długim horyzoncie i ewaluacji cyberbezpieczeństwa. GLM-5.3-Flash dodaje natywne wejścia wizualne i kładzie nacisk na wydajne użycie narzędzi. Istniejące oferty GLM-5.2, GLM-5.3 i Flash zapewniają baseline; równoważna zdolność lub dostępność GLM-5.4 nie została ustanowiona w źródłach przejrzanych na potrzeby tego artykułu.
Udokumentowane modele wspierają do 1M kontekstu, ale ten limit nie gwarantuje identycznego użytecznego kontekstu ani wydajności zadań na każdym endpointcie. Wybieraj między nimi używając reprezentatywnych obciążeń i kosztu na pomyślnie ukończone zadanie.
Przyszły GLM-5.4 musiałby zaoferować mierzalną poprawę, aby uzasadnić migrację. Poprawa dokładności w benchmarkach przy podwojeniu kosztu ukończenia zadań może być nieatrakcyjna w produkcji. Odwrotnie, umiarkowany wzrost dokładności i znacząco mniej wywołań narzędzi może być cenny w skali.
Porównuj sukces zadań, tokeny wejścia i wyjścia, opóźnienie, nieudane wywołania narzędzi i koszt na pomyślnie ukończone zadanie w tym samym harnessie ewaluacyjnym. Opisy jakościowe modelu nie są kontrolowanym testem head-to-head.
Jaki jest obecny status API GLM-5.4 na CometAPI?
CometAPI utworzyło dedykowaną stronę modelu GLM 5.4 ze stabilnym wpisem identyfikatora modelu. Strona wciąż jednak oznacza model jako „Coming soon” i opisuje go jako model przed premierą. Deweloperzy powinni zweryfikować rzeczywisty identyfikator modelu, dostęp do konta, dostępność endpointu, wspierane parametry, limity kontekstu i ceny przed próbą użycia w produkcji.
Dla aktualnie udokumentowanej integracji użyj dostępnego modelu GLM, takiego jak GLM-5.2 lub GLM-5.3. Stronę GLM-5.4 CometAPI należy na razie traktować jako wpis katalogowy przed premierą, dopóki nie zostaną potwierdzone identyfikator modelu i endpoint jako wywoływalne.
Przygotowanie do integracji API GLM 5.4
Najbardziej praktyczne przygotowanie to unikanie sprzęgania logiki aplikacji z jedną wersją modelu. Konfigurowalny identyfikator modelu ułatwia ewaluację aktualizacji bez przepisywania potoku żądań.
Utrzymuj identyfikator modelu konfigurowalny i użyj dostępnego modelu GLM, aby ustanowić działający baseline. Przed przejściem na GLM-5.4 potwierdź wywoływalny identyfikator modelu, dostęp do konta, wspierane parametry żądania, limity kontekstu i wyjścia, zachowanie streamingu oraz zgodność wywołań narzędzi. Utrzymuj gotową opcję wycofania.
Gdy GLM-5.4 stanie się oficjalnie dostępny, zweryfikuj identyfikator modelu, wspierane parametry, limity kontekstu i kompatybilność endpointu. Uruchom stary i nowy model na tym samym zbiorze ewaluacyjnym, śledząc wskaźniki sukcesu, opóźnienie, tokeny wyjściowe, awarie wywołań narzędzi i koszt na pomyślnie wykonane zadanie.
Jak może wyglądać cennik API GLM 5.4?
Nie ogłoszono oficjalnej ceny API GLM-5.4. Publikowanie konkretnej stawki za token wejściowy lub wyjściowy jako rzekomego przecieku byłoby wprowadzające w błąd.
Obecna rodzina GLM ilustruje, dlaczego sam rozmiar modelu nie wystarcza do przewidywania cen. GLM-5.3-Flash wprowadził optymalizacje architektoniczne zaprojektowane tak, by dostarczać konkurencyjną inteligencję przy znacząco niższym koszcie inferencji.
Porównanie Artificial Analysis Intelligence Index v4.1.1 Z.ai raportuje wynik 57 przy szacowanym obniżonym koszcie 0.045 USD za zadanie dla GLM-5.3-Flash. Ten koszt ewaluacji nie jest taryfą tokenów wejścia/wyjścia i nie przewiduje cen GLM-5.4.
Przyszłe ceny GLM-5.4 mogą zależeć od architektury, wysiłku wnioskowania, zniżek na tokeny z cache, infrastruktury hostingowej i wariantów. W planowaniu produkcyjnym koszt na pomyślnie ukończone zadanie bywa cenniejszy niż najniższa nagłówkowa stawka za token wejściowy.
Czy deweloperzy powinni czekać na GLM 5.4?
Dla większości deweloperów czekanie na niezapowiedziany model jest niepotrzebne. Istniejące modele GLM oferują udokumentowane możliwości kodowania i podejścia agentowego, które można testować w realnych aplikacjach.
Zespoły budujące asystentów kodowania lub wieloetapowych agentów inżynieryjnych mogą ustanowić baseline z GLM-5.3. Aplikacje kładące nacisk na rozumienie wizualne, długi kontekst i efektywne wielokrotne wywołania mogą ocenić GLM-5.3-Flash.
Zbuduj harness ewaluacyjny już teraz i zarezerwuj w nim miejsce na przyszłe porównanie z GLM-5.4. Kiedy będzie dostępny, jego wydanie będzie miało znaczenie, jeśli poprawi wyniki istotne dla danej aplikacji.
Badacze powinni obserwować nową architekturę bazową, zmiany w benchmarkach długiego horyzontu i niezawodność end-to-end. Firmy powinny priorytetyzować dostępność, koszt, opóźnienie, kompatybilność i jakość na reprezentatywnych danych produkcyjnych.
Wnioski
GLM 5.4 to prawdopodobny kolejny krok w szybko rozwijającej się rodzinie modeli Z.ai, ale obecna narracja pozostaje bardziej spekulacyjna niż potwierdzona.
Union Alpha to niezweryfikowana wskazówka tożsamości, a rytm wydań wspiera jedynie szeroką hipotezę czasową. Żadne z tych źródeł nie ustanawia daty premiery. Oficjalne źródła przejrzane 14 października 2026 r. dostarczają baseline dla istniejących modeli, a nie potwierdzony GLM-5.4.
Weryfikowalny jest postęp już dokonany przez GLM-5.3 i GLM-5.3-Flash. Znaczące zyski w agentowym kodowaniu, ewaluacji cyberbezpieczeństwa i efektywności inferencji ustanawiają wymagający punkt odniesienia dla każdego następcy.
Kluczowe pytanie brzmi, czy Z.ai potrafi dostarczyć niezawodne wykonanie autonomiczne, silniejsze wnioskowanie i konkurencyjny koszt na ukończone zadanie. Dopóki nie pojawią się oficjalne specyfikacje i benchmarki, GLM-5.4 należy traktować jako potencjalne wydanie, a nie dostępny produkt.
FAQ
Jak mogę zweryfikować listing API GLM 5.4?
Sprawdź, czy dostawca podaje wywoływalny identyfikator modelu, wspierany endpoint, warunki dostępu i aktualne ceny. Następnie porównaj tę tożsamość z oficjalnym ogłoszeniem lub dokumentacją Z.ai. Listing dostawcy może ustalać ofertę danego dostawcy, ale sam w sobie nie uwierzytelnia anonimowego modelu po stronie pierwotnego dewelopera.
Jakie testy kompatybilności są ważne przed migracją na GLM 5.4?
Zwaliduj parametry żądania, ustawienia wnioskowania, schemat wywołań narzędzi, wyjścia strukturalne, zachowanie streamingu, limity kontekstu i maksymalne wyjście na twoim rzeczywistym endpointcie. Uwzględnij testy negatywne dla niewspieranych parametrów i utrzymuj istniejący model dostępny na potrzeby wycofania. Zgodność z OpenAI opisuje interfejs; nie gwarantuje identycznego zachowania modelu.
Jak oceniać GLM 5.4 dla agentów kodujących?
Użyj stałego zestawu reprezentatywnych zadań repozytoryjnych z tymi samymi narzędziami, uprawnieniami, limitem czasu i harnessiem dla obu modeli. Zliczaj pomyślne przetestowane zmiany, odzyskiwanie po awariach narzędzi, użycie tokenów, opóźnienie i łączny koszt. Rejestruj każdy przebieg i powtarzaj zadania na tyle, by ujawnić zmienność, zamiast promować jeden korzystny przykład.
Co uzasadniałoby czekanie na GLM 5.4?
Czekanie jest rozsądne tylko wtedy, gdy udokumentowana, nadchodząca możliwość zaspokaja wymaganie, którego dostępne modele nie spełniają, a opóźnienie mieści się w harmonogramie dostaw. Mając jedynie plotkę, buduj na dostępnym modelu i utrzymuj wybór modelu konfigurowalny. Zdefiniuj progi możliwości i kosztu, które późniejsze wydanie musi spełnić, zanim zastąpi twój baseline.